

Python多行注释和文档字符串(Docstring)有什么区别
深入解析Python多行注释与文档字符串(Docstring)在底层机制、语法位置、运行时可见性及工程规范上的核心区别,帮助开发者正确编写规范的Python代码与接口文档。
__doc__ 属性中,常驻内存并支持 help() 等自省工具查询。
一、核心本质差异:从解释器生命周期看两者的去留
许多初学者容易将三引号包裹的文字统称为“多行注释”,这是 Python 学习中最常见的误解之一。从 Python 解释器的执行机制来看,两者经历的生命周期完全不同:
- 注释(Comments):以
#开头的单行或连续多行内容,在 Python 词法分析器(Lexer / Tokenizer)进行分词阶段就被直接过滤丢弃。它们既不会进入抽象语法树(AST),也不会生成任何字节码(Bytecode),对运行期的程序没有任何影响,占用内存为零。 - 文档字符串(Docstrings):如果一个三引号字符串字面量位于模块、函数或类的第一条非空语句位置,语法解析器会将其特殊识别为文档节点。在编译时,编译器会将该字符串存入该代码对象的常量表,并在对象加载时将其赋值给该对象的
__doc__属性。这意味着它在运行时会常驻内存供反射调用。 - 游离的三引号字符串:如果三引号字符串出现在函数内部的执行逻辑中间且未赋值给变量,它在语法上只是一条普通的表达式语句(Expression Statement)。虽然语法合法,但现代 Python 编译器在生成字节码时会将其作为无副作用的死代码直接优化丢弃,它既不会变成 Docstring,也不算规范的注释。
二、推导与编译流程:解释器如何处理两者
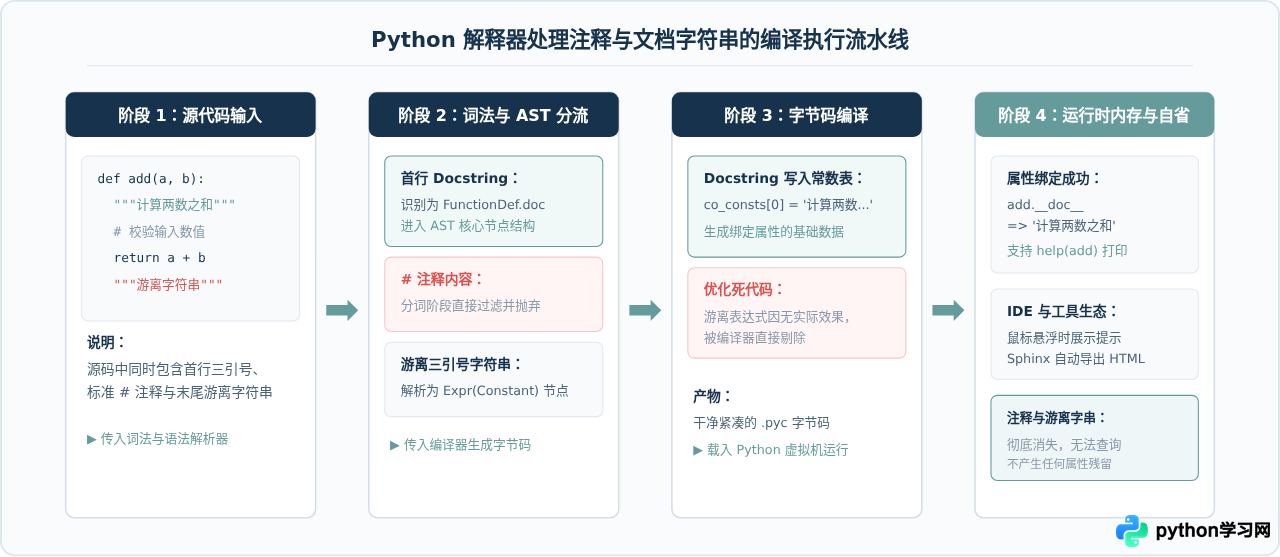
为了更直观地理解两者的技术原理,我们可以观察一段 Python 源码从文本输入到最终执行的完整流程。理解该流程有助于从根源上判断为什么“在函数体内写三引号不能算作有效注释”:
- 分词阶段(Tokenization):源代码被扫描为一个个词法单元。普通注释会被词法分析器直接忽略(COMMENT 类型通常不进入后续语法树分析)。
- 抽象语法树构建(AST Generation):解析器判断语法结构。如果函数/类/模块定义块的第一条语句是字符串常量,该节点会被记录为该作用域的 Docstring;如果是其他位置的纯字符串,则被记录为一般的
Expr(value=Constant(...))表达式。 - 字节码编译(Bytecode Compilation):AST 转换为代码对象(Code Object)。文档字符串会被明确写入常数表,并在创建对象时与
__doc__属性绑定;而出现在逻辑中间的游离三引号字符串,由于属于无赋值、无调用的纯常量表达式,优化器会直接忽略它,避免生成冗余的加载与弹出指令。 - 运行时自省(Runtime Introspection):程序运行期间,用户通过
obj.__doc__或help(obj)可以在内存中调取文档字符串,而任何注释都不会存在于内存中。
三、语法位置与属性绑定规则
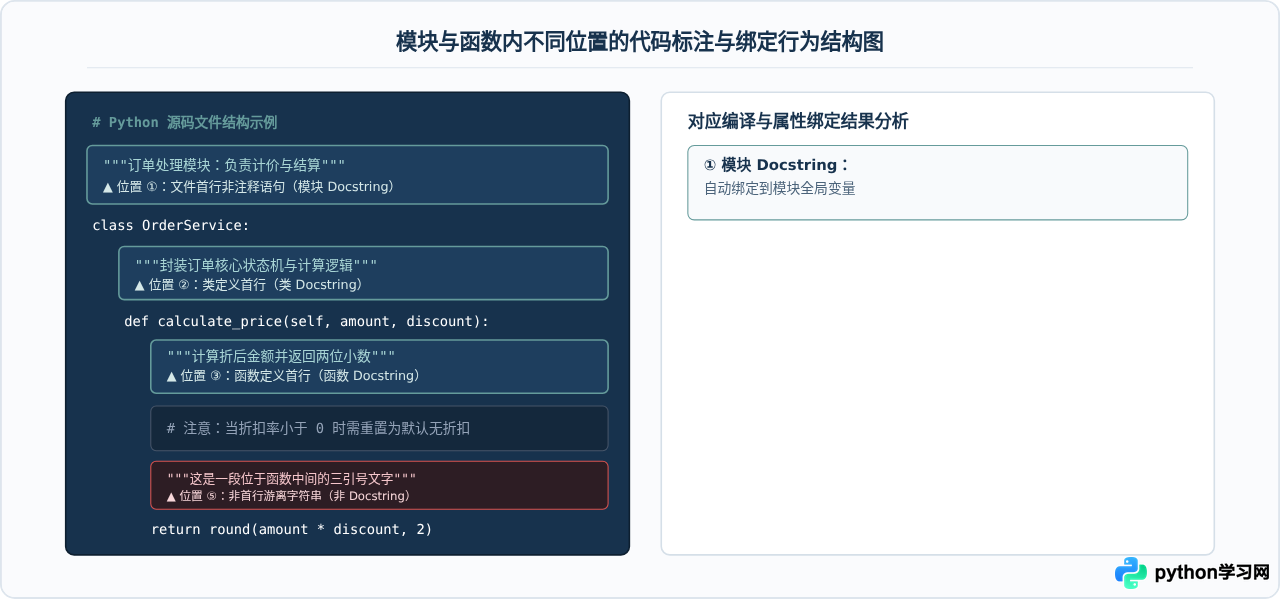
文档字符串之所以能成为“文档”,关键在于其物理位置的唯一性与不可替代性。Python 官方语法规定:只有当字符串字面量出现在模块、类、函数的第一行时,才会被赋予特殊地位。如果在其他任何地方书写三引号字符串,都只是普通字符串表达式。
四、代码实测:如何通过代码证明两者的差异
为了直观验证上述结论,我们可以编写一段简短的脚本,并在 Python 交互式环境或脚本中运行。下面的代码展示了 __doc__ 属性与 help() 函数对两者的不同反应:
import inspect

def demo_function(val):
    """这是合法的文档字符串 (Docstring)。

    参数:
        val: 输入的数值
    返回:
        计算后的倍数值
    """
    # 这是实现细节的多行注释
    # 解释器在编译后不会保留这一行
    # 任何属性都无法获取这段文字

    """这是函数体内部的三引号字面量
    它不是 Docstring,也不会附加到 __doc__
    """

    return val * 2

# 1. 打印函数的 __doc__ 属性
print("--- 访问 __doc__ 属性 ---")
print(demo_function.__doc__)

# 2. 使用 inspect 模块提取清理格式后的文档
print("--- 使用 inspect.getdoc() ---")
print(inspect.getdoc(demo_function))

# 3. 验证内部注释是否存在
print("--- 检查内部注释 ---")
print("注释是否在属性中:", "# 这是实现细节" in str(dir(demo_function)))
运行输出结果(示例):
--- 访问 __doc__ 属性 ---
这是合法的文档字符串 (Docstring)。

    参数:
        val: 输入的数值
    返回:
        计算后的倍数值

--- 使用 inspect.getdoc() ---
这是合法的文档字符串 (Docstring)。

参数:
    val: 输入的数值
返回:
    计算后的倍数值

--- 检查内部注释 ---
注释是否在属性中: False
从以上结果可以清晰看到:
demo_function.__doc__完整输出了第一行的三引号字符串。- 内部的
#注释和随后的未赋值三引号字符串,在反射检查中完全没有留下任何痕迹。
五、规范对比:PEP 8 与 PEP 257 的约束要求
Python 官方分别通过两个专门的增强提案规定了两者的编写规范:
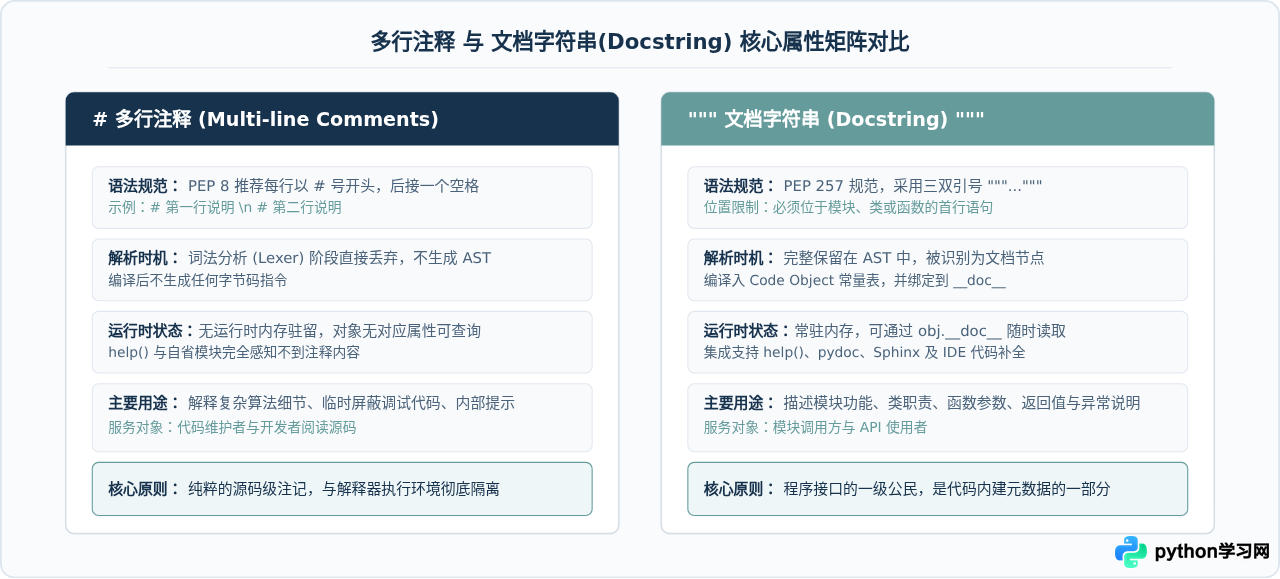
| 对比维度 | 多行注释 (Multi-line Comment) | 文档字符串 (Docstring) |
|---|---|---|
| 官方指导规范 | PEP 8(Python 代码样式指南) | PEP 257(Docstring 约定指南) |
| 推荐书写语法 | 多个连续的 # 行 |
三双引号 """...""" |
| 语法有效位置 | 代码任意行(行首或行尾) | 严格限定在模块、类、函数的第一行 |
| 运行时是否可访问 | 否,完全不可见 | 是,通过 obj.__doc__ 随时读取 |
| 第三方工具联动 | 无(仅版本控制与代码审查可见) | Sphinx、MkDocs、Pydoc、IDE 自动提示 |
| 典型内容构成 | “为什么这么写”、算法细节、临时 TODO | “这个函数做什么”、参数类型、返回值、异常说明 |
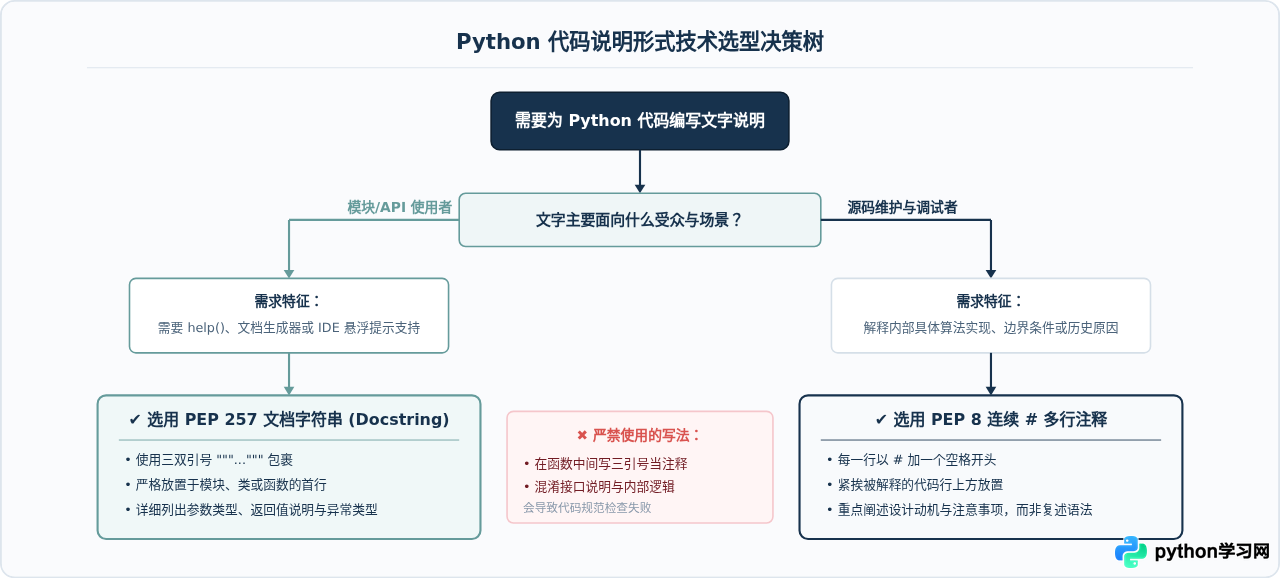
六、工程选型指南:什么时候用注释,什么时候用 Docstring
在日常开发中,选择使用多行注释还是 Docstring,核心依据是信息受众与使用场景:
- 使用 Docstring 的场景:
- 任何对外暴露或供其他模块调用的公共 API、类、函数和模块。
- 需要被 IDE 识别并提供代码悬浮参数提示的地方。
- 需要自动导出生成 HTML/Markdown 项目技术文档的接口。
- 使用多行注释的场景:
- 函数内部的一段复杂运算逻辑(如位运算、复杂正则、特定数学公式)。
- 解释为什么采用某种非显而易见的实现方案(“为什么这样解决”而非“做了什么”)。
- 临时屏蔽某段有问题的代码进行排查定位。
七、常见误区与避坑指南
Python 在语法设计上从未引入真正的块级注释符号。许多人使用三引号来做多行注释,只是利用了“未赋值的字符串字面量在运行时不会产生副作用”的语法特性,但它本质上仍然是表达式,不是官方认可的注释语法。PEP 8 明确规定:多行注释的标准做法必须是每一行都以 # 开头。
文档字符串的三引号必须与所定义的函数或类保持完全相同的缩进级别。如果三引号起始位置或闭合位置的缩进与函数体缩进不匹配,Python 解释器在编译阶段会直接抛出 IndentationError 导致程序无法运行。
虽然 Docstring 常驻内存,但如果在启动 Python 时使用了 python -OO 优化参数运行,Python 编译器会强制剥离所有的 Docstring,此时所有对象的 __doc__ 属性都会变为 None。因此,切勿在核心业务逻辑中依赖 __doc__ 中的文字内容来驱动程序运行分支。
八、总结
区分 Python 多行注释与文档字符串的本质,在于厘清**“谁在读这段文字”**:
- 如果你是在向阅读源码的同事解释某行代码的意图、避坑细节或临时禁用一段逻辑,请严格遵循 PEP 8,使用清晰的连续
#单行/多行注释。 - 如果你是在定义一个可供外界调用的模块、类或函数,需要向调用者阐明其职责、参数约定、返回值与异常,请严格遵循 PEP 257,在定义首行使用规范的三双引号文档字符串(Docstring)。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









