

Python多进程中全局变量是否共享
深入解析Python多进程中全局变量是否共享的核心问题,通过直观的内存模型对比、可运行的验证代码、底层Fork与Spawn机制剖析,以及跨进程通信的实用方案,帮助开发者彻底掌握多进程编程中的状态管理。
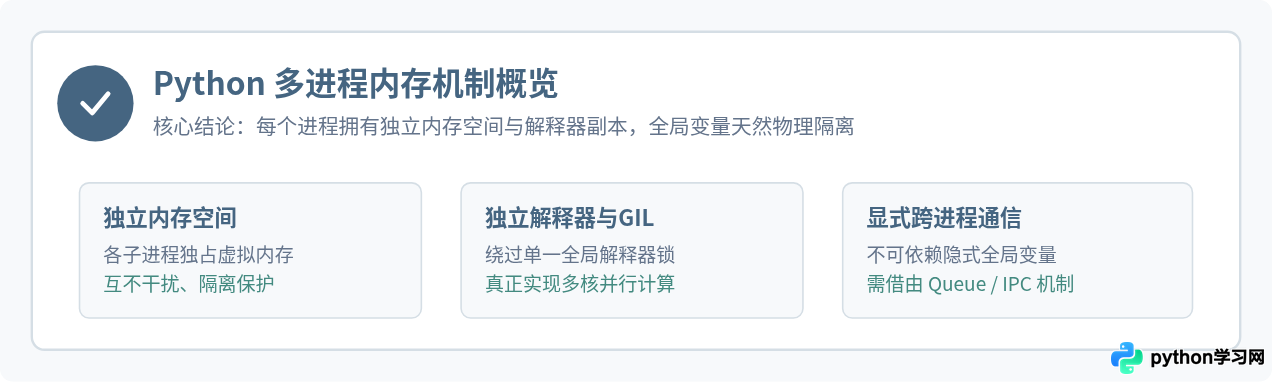
在 Python 多进程编程中,全局变量默认不会在多个进程间共享。每个子进程都会在操作系统分配的独立虚拟内存空间中运行,拥有独立的 Python 解释器实例及变量副本。子进程对全局变量的任何赋值和修改,都仅作用于其本地内存,主进程和其他子进程完全无法直接感知这一变化。
一、现象验证:子进程修改全局变量为什么无效?
很多刚从多线程(threading)转到多进程(multiprocessing)的开发者,会习惯性地定义一个全局列表或计数器,在子任务中更新它,期望主进程在执行结束后汇总结果。然而在多进程环境下,这种做法会直接失效。
我们来看下面这段典型的最小可复现代码:
import multiprocessing
import time

# 定义全局变量
global_list = []
global_counter = 0

def worker(item):
    global global_counter
    global_list.append(item)
    global_counter += 1
    print(f"[子进程 PID={multiprocessing.current_process().pid}] 内部更新: list={global_list}, counter={global_counter}")

if __name__ == '__main__':
    print(f"[主进程 PID={multiprocessing.current_process().pid}] 初始状态: list={global_list}, counter={global_counter}")

    # 创建并启动子进程
    p = multiprocessing.Process(target=worker, args=("数据A",))
    p.start()
    p.join()  # 等待子进程运行完毕

    # 主进程检查全局变量的值
    print(f"[主进程 PID={multiprocessing.current_process().pid}] 子进程结束后: list={global_list}, counter={global_counter}")
[子进程 PID=48211] 内部更新: list=['数据A'], counter=1
[主进程 PID=48210] 子进程结束后: list=[], counter=0
从输出中可以清晰地观察到:子进程确实成功执行了 append 和累加操作,在子进程自身打印时,列表包含元素且计数为 1;但当子进程执行完毕、主进程重新打印时,全局变量 global_list 仍然是空的,global_counter 也依旧是 0。
二、执行推导:多进程变量生命周期与调用步骤
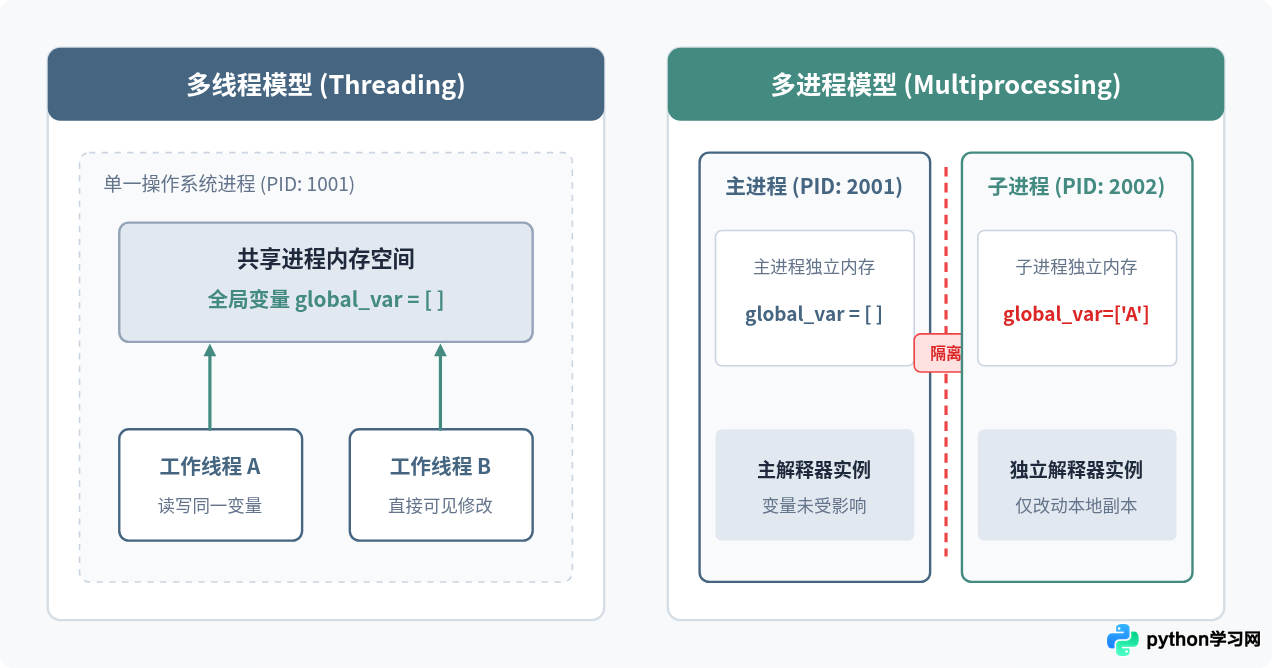
为了让理解更加具体,我们可以沿着操作系统调度与代码执行的时间线,观察变量副本的产生与消亡过程:
- 主进程加载模块并初始化:操作系统启动主 Python 进程,分配地址空间,初始化全局作用域,此时
global_counter = 0。 - 派生子进程:调用
p.start()时,操作系统创建新进程。子进程获得一份独立的地址空间镜像或全新环境。 - 副本修改:子进程调用目标函数执行
global_counter += 1,这仅修改了子进程自身虚拟地址中的数值。 - 子进程销毁:子进程工作结束退出,其对应的物理内存页被操作系统回收,子进程内存中的所有改动随之消失。
- 主进程读取原值:主进程从未开放过内存写入权限给外部进程,主进程的
global_counter始终为最初的 0。
三、深层机制:操作系统启动方式与写时复制(COW)
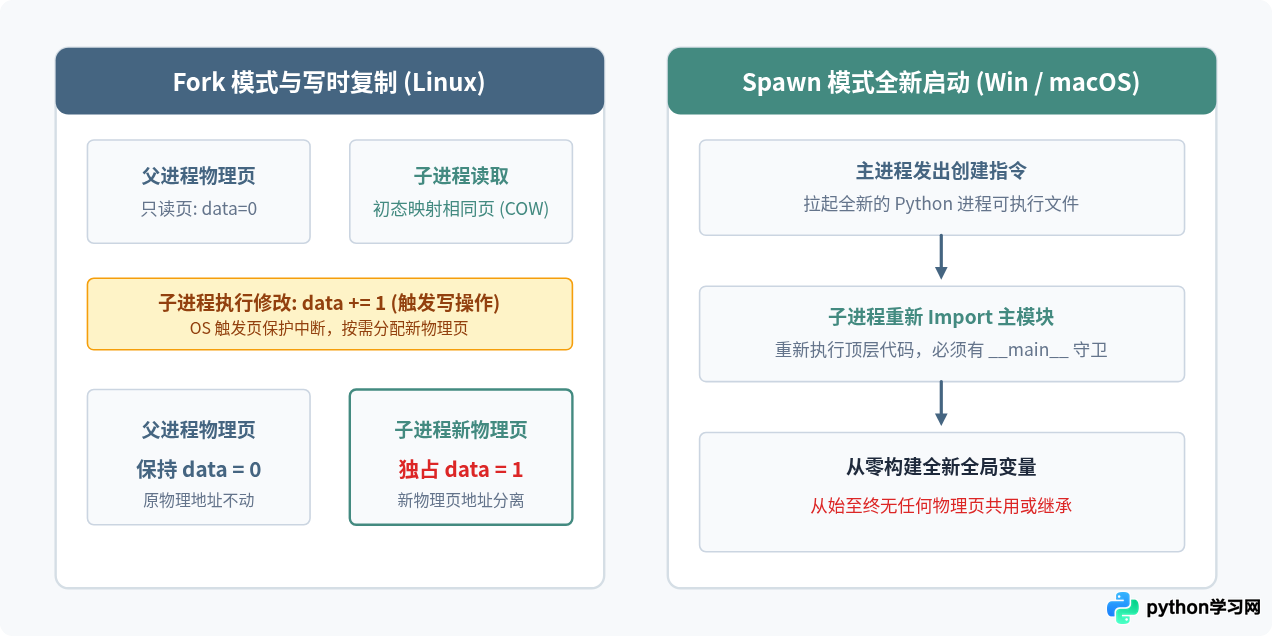
在 Linux/Unix 与 Windows/macOS 上,子进程的创建机制(Start Methods)存在明显差异,这也是造成部分开发者产生“有时好像读到了主进程变量”这一错觉的根本原因:
1. Fork 机制与写时复制 (Linux)
在 Linux 默认的 fork 启动模式下,子进程被创建瞬间并不会立即完整拷贝一份物理内存,而是利用操作系统的写时复制(Copy-on-Write, COW)技术:
- 只读共享:在子进程仅读取全局变量时,父子进程指向同一块只读物理内存页。
- 触发拷贝:一旦子进程尝试对全局变量赋值或修改容器,操作系统硬件层级立即触发“缺页中断”,系统自动为子进程分配独立的物理内存页并将数据写入新页。
- 结论:即使在 Linux 下,只要发生写入,变量就变成两份独立的物理内存,绝不存在隐式同步。
2. Spawn 机制 (Windows / macOS)
在 Windows 以及较新版本的 macOS(Python 3.8+ 默认)中,多进程采用 spawn 启动模式:
- 子进程完全是一个全新启动的干净 Python 解释器进程。
- 它会重新导入启动脚本(这也是为什么必须将主流程放在
if __name__ == '__main__':保护块内的原因,否则会导致无限递归创建子进程并崩溃)。 - 所有全局变量在子进程中都会被重新以初始代码执行一遍,没有任何内存继承。
四、如何在多进程间正确共享或传递数据?
既然普通的全局变量无法实现共享,在实际工程中,如果我们必须让多个子进程协同处理数据、累加数值或传递状态,应采用 Python 官方提供的标准跨进程通信(IPC)机制:
1. 首选方案:消息队列(multiprocessing.Queue)
这是最推荐的生产级架构。各子进程将计算结果放入队列,由主进程或其他消费者统一拉取,天生具有进程安全和无锁竞争的特点:
import multiprocessing

def worker(item, result_queue):
    # 子进程执行任务,将产生的数据推入队列
    processed = f"处理完成: {item}"
    result_queue.put(processed)

if __name__ == '__main__':
    q = multiprocessing.Queue()
    processes = []

    for i in range(3):
        p = multiprocessing.Process(target=worker, args=(f"任务-{i}", q))
        processes.append(p)
        p.start()

    for p in processes:
        p.join()

    # 从队列读取全部结果
    results = []
    while not q.empty():
        results.append(q.get())

    print("主进程汇总结果:", results)
2. 单值与数组共享:multiprocessing.Value 与 Array
当只需要共享一个基础类型数据(如计数器 int、标志位 float 或定长数组)时,可使用 Value 或 Array。它们基于共享物理内存实现,默认附带互斥锁(Lock):
import multiprocessing

def increment(shared_counter):
    # 互斥锁确保并发写操作原子性
    with shared_counter.get_lock():
        shared_counter.value += 1

if __name__ == '__main__':
    # 'i' 代表有符号整型,初始值为 0
    counter = multiprocessing.Value('i', 0)
    procs = [multiprocessing.Process(target=increment, args=(counter,)) for _ in range(5)]

    for p in procs: p.start()
    for p in procs: p.join()

    print(f"跨进程共享计数结果: {counter.value}")  # 准确输出 5
3. 复杂对象共享:multiprocessing.Manager
如果需要跨进程共享完整的 Python 字典(dict)或列表(list),可以使用 Manager()。它会在后台启动一个独立的服务进程,所有子进程通过代理对象(Proxy Object)进行远程方法调用:
import multiprocessing

def append_task(shared_dict, key, value):
    shared_dict[key] = value

if __name__ == '__main__':
    with multiprocessing.Manager() as manager:
        shared_map = manager.dict()
        procs = [
            multiprocessing.Process(target=append_task, args=(shared_map, f"worker_{i}", i * 10))
            for i in range(3)
        ]
        for p in procs: p.start()
        for p in procs: p.join()

        print("跨进程共享字典内容:", dict(shared_map))
五、各机制性能与特性对比
| 机制类型 | 是否共享内存 | 支持的数据类型 | 性能开销 | 并发安全性 |
|---|---|---|---|---|
| 全局变量(默认) | 否(各自独立副本) | 所有 Python 对象 | 无额外开销(但无法同步修改) | 天然进程级物理隔离 |
| multiprocessing.Queue | 否(基于管道+Socket通信) | 所有可 Pickle 序列化对象 | 中等(需序列化/反序列化) | 进程安全(内部加锁保护) |
| Value / Array | 是(基于 C 共享内存) | C 兼容的基本数据类型 | 极低(直接读写物理内存) | 需通过 Lock 保证原子性 |
| Manager 代理 | 否(独立服务进程托管) | dict, list, Namespace 等 | 较高(跨进程 IPC 调用代理) | 进程安全(服务端串行处理) |
| shared_memory (3.8+) | 是(系统原生共享内存) | 连续字节流、NumPy 数组 | 极低(零拷贝访问) | 需手动设计信号量或锁 |
六、总结与开发避坑清单
Python 多进程不共享全局变量,这不是语言的设计缺陷,而是操作系统进程隔离与安全性的核心原则。要实现进程间协作,请摒弃“读写同一个全局变量”的单进程思维,根据数据体量选择标准通信机制:通用场景用 Queue,简单计数用 Value,复杂数据用 Manager,矩阵数据用 shared_memory。
- 严防主模块重入:无论哪个操作系统,所有多进程主逻辑必须严格写在
if __name__ == '__main__':判定之后,确保代码在各平台行为一致。 - 只读配置可作为“伪共享”:如果全局变量仅在主进程启动前读取配置(如模型路径、只读字典),且子进程永远不进行写操作,在 Linux 系统的
fork下可利用写时复制节省内存,但切记一旦有写操作即自动分家。 - 注意死锁与缓冲区:使用
Queue传输大量数据时,务必在调用join()前消费完数据,避免管道缓冲区塞满导致子进程阻塞、主进程等待的死锁现象。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









