

系统运维常用Python脚本库:日志分析与服务器监控代码
本文详解系统运维中常用的Python脚本库与代码实现,涵盖基于psutil的服务器指标采集、正则表达式与多维度日志分析、自动化阈值告警以及脚本工程化部署规范。
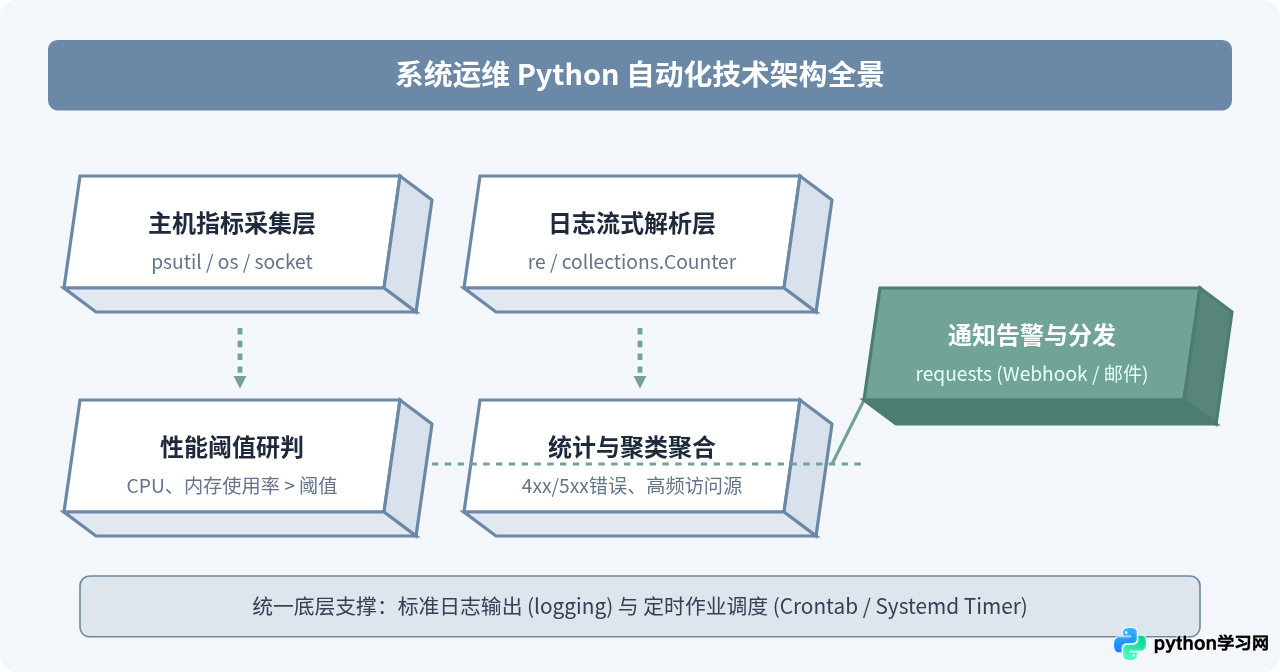
在日常运维工作中,面对多台主机的资源波动与业务服务产生的海量运行日志,依赖人工巡检或单纯执行临时命令不仅效率低下,而且容易遗漏隐患。使用 Python 编写自动化运维工具能够以极低的维护成本实现对 CPU、内存、磁盘等核心性能指标的持续采集,并对 Nginx、应用业务日志开展统计排查与异常告警。本文围绕运维中最核心的“日志分析”与“服务器监控”两大任务,系统梳理所涉及的常用 Python 库、核心架构流程与可直接运行落地的代码实现。
一、运维常用 Python 基础与第三方库选型
在编写运维脚本时,选择合适的库能够大幅减少重复造轮子的工作量。Python 自身携带的标准库功能健全,结合少量经过工业界充分验证的第三方库,就能满足绝大多数生产环境的需求:
- psutil (Process and System Utilities):跨平台的系统进程和系统硬件利用率监控库。支持获取 CPU 核心使用率、内存配额、磁盘读写速率、网络吞吐量以及单个进程的资源消耗,是编写主机监控脚本的首选。
- re (正则表达式标准库):用于结构化抽取文本日志中的 IP 地址、HTTP 状态码、请求耗时及错误堆栈。
- collections (尤其是 Counter 与 defaultdict):提供高效的计数与分组统计能力,在无需外部数据库的情况下快速完成日志 Top N 访问 IP 或高频错误码的汇总。
- requests / urllib.request:用于发送 HTTP 告警通知,将检测到的性能瓶颈或错误日志聚合结果推送到企业微信、钉钉机器人或监控网关。
- logging:规范化运维脚本自身的运行记录,支持日志等级划分、文件轮转及标准输出。
二、服务器性能监控脚本实现与实践
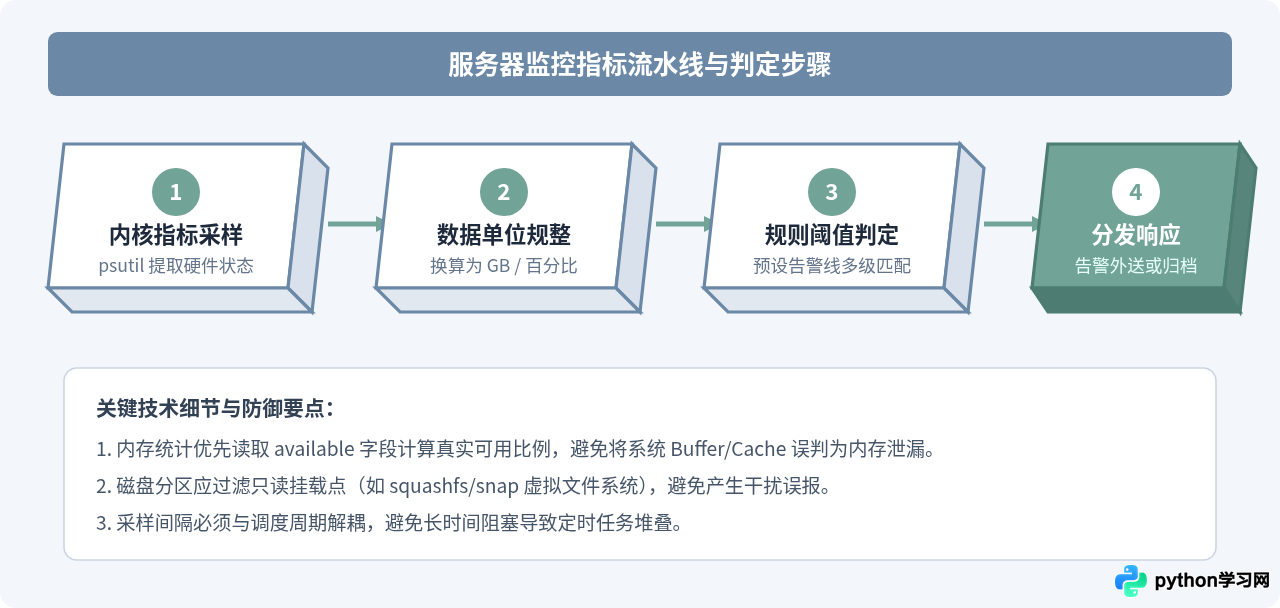
对服务器的核心硬件指标实施采集时,关键在于兼顾准确性与轻量化。监控脚本自身不能占用过多 CPU 或引发频繁的磁盘 IO。以下基于 psutil 构建完整的指标检测与健康研判脚本:
import psutil
import socket
import datetime

def get_server_metrics():
    # 采集 CPU 使用率(1秒采样间隔)
    cpu_percent = psutil.cpu_percent(interval=1)

    # 采集内存使用情况
    mem = psutil.virtual_memory()
    mem_total_gb = round(mem.total / (1024 ** 3), 2)
    mem_used_gb = round(mem.used / (1024 ** 3), 2)
    mem_percent = mem.percent

    # 采集根分区磁盘占用
    disk = psutil.disk_usage('/')
    disk_total_gb = round(disk.total / (1024 ** 3), 2)
    disk_used_gb = round(disk.used / (1024 ** 3), 2)
    disk_percent = disk.percent

    # 采集网络流量累计值
    net = psutil.net_io_counters()
    net_sent_mb = round(net.bytes_sent / (1024 ** 2), 2)
    net_recv_mb = round(net.bytes_recv / (1024 ** 2), 2)

    return {
        "hostname": socket.gethostname(),
        "timestamp": datetime.datetime.now().strftime("%Y-%m-%d %H:%M:%S"),
        "cpu_percent": cpu_percent,
        "memory": {"total_gb": mem_total_gb, "used_gb": mem_used_gb, "percent": mem_percent},
        "disk_root": {"total_gb": disk_total_gb, "used_gb": disk_used_gb, "percent": disk_percent},
        "network_mb": {"sent": net_sent_mb, "recv": net_recv_mb}
    }

def evaluate_health(metrics, cpu_thresh=85.0, mem_thresh=85.0, disk_thresh=90.0):
    alerts = []
    if metrics["cpu_percent"] >= cpu_thresh:
        alerts.append(f"【警告】CPU使用率过高: {metrics['cpu_percent']}% (阈值: {cpu_thresh}%)")
    if metrics["memory"]["percent"] >= mem_thresh:
        alerts.append(f"【警告】内存使用率过高: {metrics['memory']['percent']}% (阈值: {mem_thresh}%)")
    if metrics["disk_root"]["percent"] >= disk_thresh:
        alerts.append(f"【危险】根分区空间不足: {metrics['disk_root']['percent']}% (阈值: {disk_thresh}%)")

    return alerts

if __name__ == "__main__":
    report = get_server_metrics()
    print(f"主机: {report['hostname']} | 时间: {report['timestamp']}")
    print(f"CPU: {report['cpu_percent']}% | 内存: {report['memory']['percent']}% | 磁盘: {report['disk_root']['percent']}%")

    issues = evaluate_health(report)
    if issues:
        print("\n检测到以下异常项:")
        for item in issues:
            print(" -", item)
    else:
print("所有指标处于正常范围内。")psutil.cpu_percent(interval=1) 时会阻塞指定秒数以计算 CPU 时间片切片差值;若将其放入多任务循环中,请务必预估该调用对监控周期的影响。
三、自动化日志分析实战代码
服务日志通常以追加写方式保存在文件中。若直接使用 readlines() 一次性读取超大日志文件,极易造成服务器内存耗尽。合格的运维脚本必须采用流式逐行读取(Line-by-Line Streaming),配合高效的正则匹配与计数器。
以标准的 Nginx Combined 访问日志为例,其行结构通常为:IP - - [时间] "方法 路径 协议" 状态码 发送字节数 "Referer" "User-Agent"。以下代码实现对高频访问 IP 统计、HTTP 状态码分布以及 4xx/5xx 错误请求的即时提取:
import re
from collections import Counter

# 定义 Nginx combined 日志正则解析模式
LOG_PATTERN = re.compile(
    r'^(?P<ip>[\d\.]+)\s+-\s+-\s+\[(?P<time>[^\]]+)\]\s+'
    r'"(?P<method>\w+)\s+(?P<url>\S+)\s+(?P<proto>[^\"]+)"\s+'
    r'(?P<status>\d{3})\s+(?P<bytes>\d+)'
)

def analyze_nginx_log(file_path, top_n=5):
    ip_counter = Counter()
    status_counter = Counter()
    error_urls = Counter()
    total_lines = 0
    matched_lines = 0

    with open(file_path, 'r', encoding='utf-8', errors='ignore') as f:
        for line in f:
            total_lines += 1
            line = line.strip()
            if not line:
                continue

            match = LOG_PATTERN.match(line)
            if match:
                matched_lines += 1
                data = match.groupdict()
                ip = data["ip"]
                status = data["status"]
                url = data["url"]

                ip_counter[ip] += 1
                status_counter[status] += 1

                # 记录 4xx 与 5xx 异常请求路径
                if status.startswith(('4', '5')):
                    error_urls[f"[{status}] {url}"] += 1

    return {
        "total_lines": total_lines,
        "matched_lines": matched_lines,
        "top_ips": ip_counter.most_common(top_n),
        "status_distribution": status_counter.most_common(),
        "top_errors": error_urls.most_common(top_n)
    }

# 示例调用
if __name__ == "__main__":
    # 模拟日志路径,实际运行替换为目标路径例如 /var/log/nginx/access.log
    # result = analyze_nginx_log("/var/log/nginx/access.log")
    print("分析器就绪。输入文件后将输出 Top IP、状态码分布及高频异常 URL。")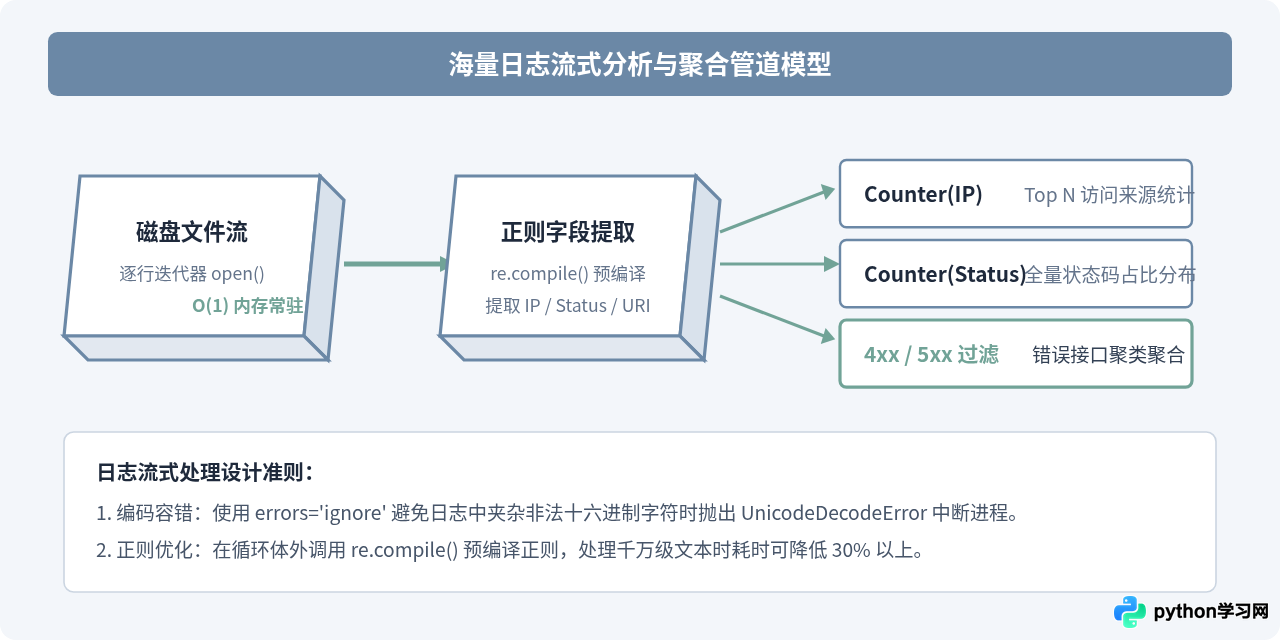
四、告警集成与定时调度规范
监控与日志分析脚本如果只在终端输出结果,依然需要人工登录检查。工程化落地的标准做法是“阈值触发告警”+“系统守护/定时任务”。
1. 自动化 Webhook 告警通知代码
利用 requests 库,可以在指标越限或错误日志激增时,将报警信息直接推送到群机器人:
import requests
import json

def send_alert_webhook(webhook_url, title, content_list):
    """
    发送企业群机器人 Markdown 格式告警消息
    """
    markdown_text = f"### 【运维告警】{title}\n\n"
    for item in content_list:
        markdown_text += f"- > {item}\n"

    payload = {
        "msgtype": "markdown",
        "markdown": {
            "title": title,
            "text": markdown_text
        }
    }
    headers = {"Content-Type": "application/json"}

    try:
        response = requests.post(webhook_url, data=json.dumps(payload), headers=headers, timeout=5)
        response.raise_for_status()
        return True
    except Exception as e:
        print(f"告警发送失败: {e}")
        return False
2. Linux 定时任务配置
使用系统的 crontab 能够保障监控与分析任务按既定周期执行。建议为脚本配置专用虚拟环境,并在 crontab 中指定 Python 绝对路径及日志输出重定向:
# 每天凌晨 00:05 执行前一日日志统计,并记录运行日志
5 0 * * * /usr/bin/python3 /opt/scripts/analyze_nginx.py >> /var/log/ops_cron.log 2>&1

# 每 5 分钟执行一次服务器健康状态检测
*/5 * * * * /usr/bin/python3 /opt/scripts/server_monitor.py >> /var/log/ops_cron.log 2>&1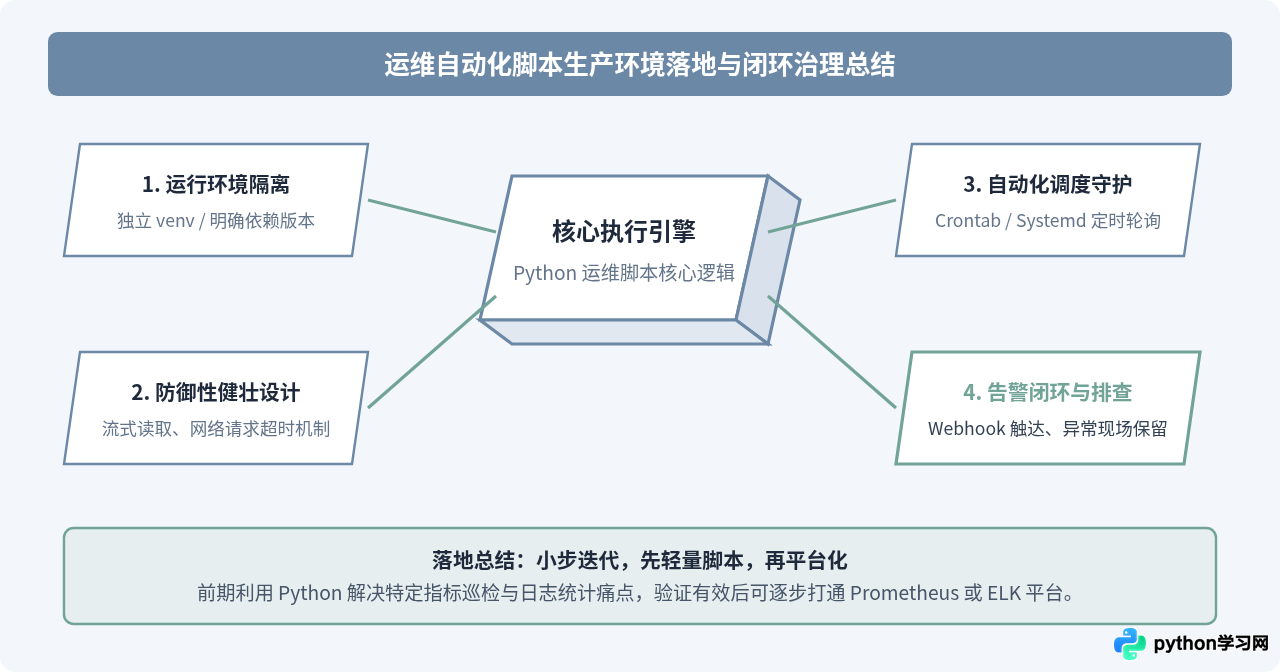
五、常见问题与注意事项
- 避免脚本自杀式消耗资源:在进行密集日志遍历或正则匹配时,若日志量达到数千万行,必须限制单次扫描行数或使用
head -n、split预处理;监控轮询中interval避免设置过短。 - 环境依赖锁定:生产机器应尽量减少对非必要第三方库的依赖。必要第三方库(如
psutil、requests)应通过requirements.txt锁定版本,避免不同机器间由于底层 C 扩展编译或接口变动导致运行失败。 - 网络调用超时设置:所有发送告警或外联 HTTP 请求的代码,务必显式指定
timeout参数,杜绝因外部网络故障导致运维脚本挂起并耗尽系统任务描述符。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









