

Python中chr()与ord()实现大写字母与编码互转
详细讲解在Python中使用ord()与chr()内置函数实现大写字母与ASCII/Unicode编码双向互转的底层机制、操作步骤、推导公式及边界校验防错方案。
在 Python 中,处理字符与数值编码转换的核心内置工具是 ord() 和 chr() 两个函数。其中,ord() 负责将单个字符转换为其对应的 Unicode/ASCII 整数编码,大写字母 'A' 到 'Z' 严格对应十进制数字 65 到 90;而 chr() 则执行逆向操作,将该数值范围内的整数重新还原为大写字母。理解这两个函数的映射规律与数学偏移,是掌握文本处理、字符序数计算及经典加解密算法的关键基础。
大写字母与编码的双向映射机制
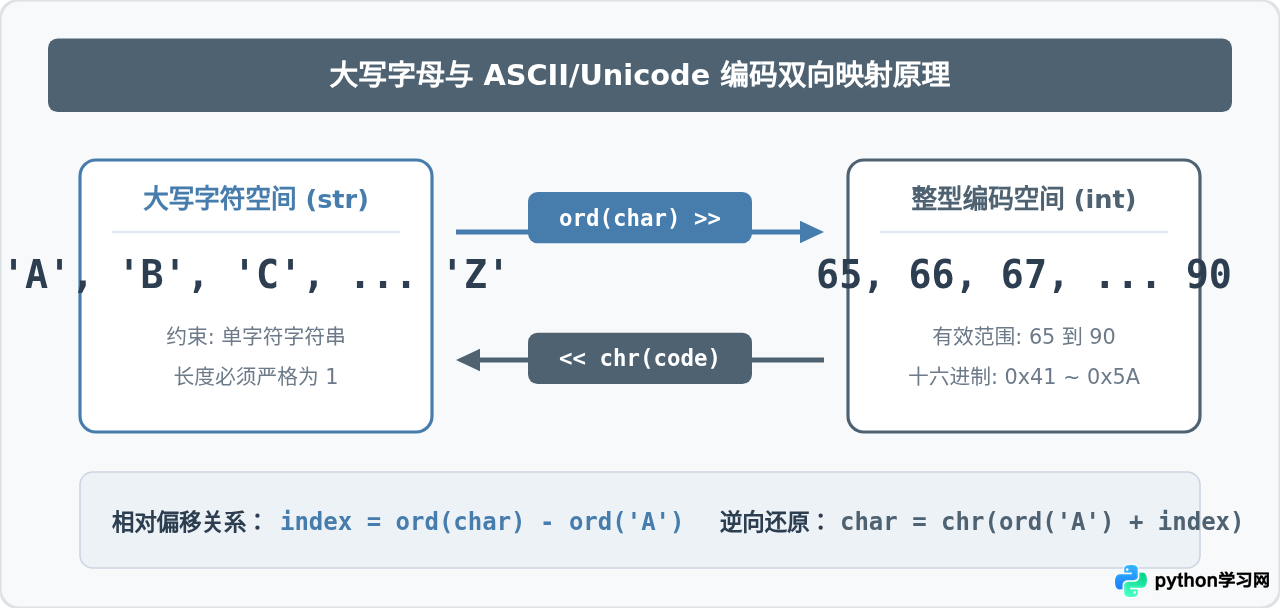
计算机底层并不直接存储字母形态,而是存储对应的数值码点。在 ASCII 编码系统及完全兼容 ASCII 基础字符集的 Unicode 规范中,26 个英文字母均占据连续的整数编号。大写字母 'A' 的编码值为 65,其后字母依次递增,直至 'Z' 的编码值 90。
Python 原生内置的 ord()(源自 ordinal,表示序数)接收长度为 1 的字符字符串,返回其整型数值;chr()(源自 character,表示字符)则接收一个整型数值,返回对应的单字符字符串。二者在数学与逻辑上构成一一对应的一对反函数:chr(ord('A')) == 'A' 且 ord(chr(65)) == 65。
单个大写字母与编码的互转实现
在交互式终端或脚本中,单个大写字母与数值编码的互转非常直接。调用 ord() 传入单字符,即可立即获取十进制整数;调用 chr() 传入 65 到 90 之间的整数,即可还原对应的大写字母。
# 1. 大写字母转换为 ASCII / Unicode 编码
ascii_a = ord('A')
ascii_m = ord('M')
ascii_z = ord('Z')

print(f"'A' 的编码为: {ascii_a}")  # 示例输出: 'A' 的编码为: 65
print(f"'M' 的编码为: {ascii_m}")  # 示例输出: 'M' 的编码为: 77
print(f"'Z' 的编码为: {ascii_z}")  # 示例输出: 'Z' 的编码为: 90

# 2. 编码转换为对应大写字母
char_65 = chr(65)
char_77 = chr(77)
char_90 = chr(90)

print(f"编码 65 对应字母: {char_65}")  # 示例输出: 编码 65 对应字母: A
print(f"编码 77 对应字母: {char_77}")  # 示例输出: 编码 77 对应字母: M
print(f"编码 90 对应字母: {char_90}")  # 示例输出: 编码 90 对应字母: Z
安全转换与边界防御流程
在实际生产开发中,用户输入或外部接口传递的数据不可预知。直接调用转换函数时,如果不加校验,容易引发两类常见运行时异常:
- TypeError: 传递给
ord()的字符串长度不为 1(例如空字符串""或多字符"AB"),或者传入了非字符串类型。 - ValueError 或范围越界: 传递给
chr()的数值虽然属于合法的 Unicode 范围,但脱离了[65, 90]区间,导致转换出来的结果不是大写英文字母(例如 97 会转为小写'a',32 会转为空格)。
因此,规范的操作顺序是先进行类型检查与区间判断,再调用核心函数,从而确保程序健壮性。
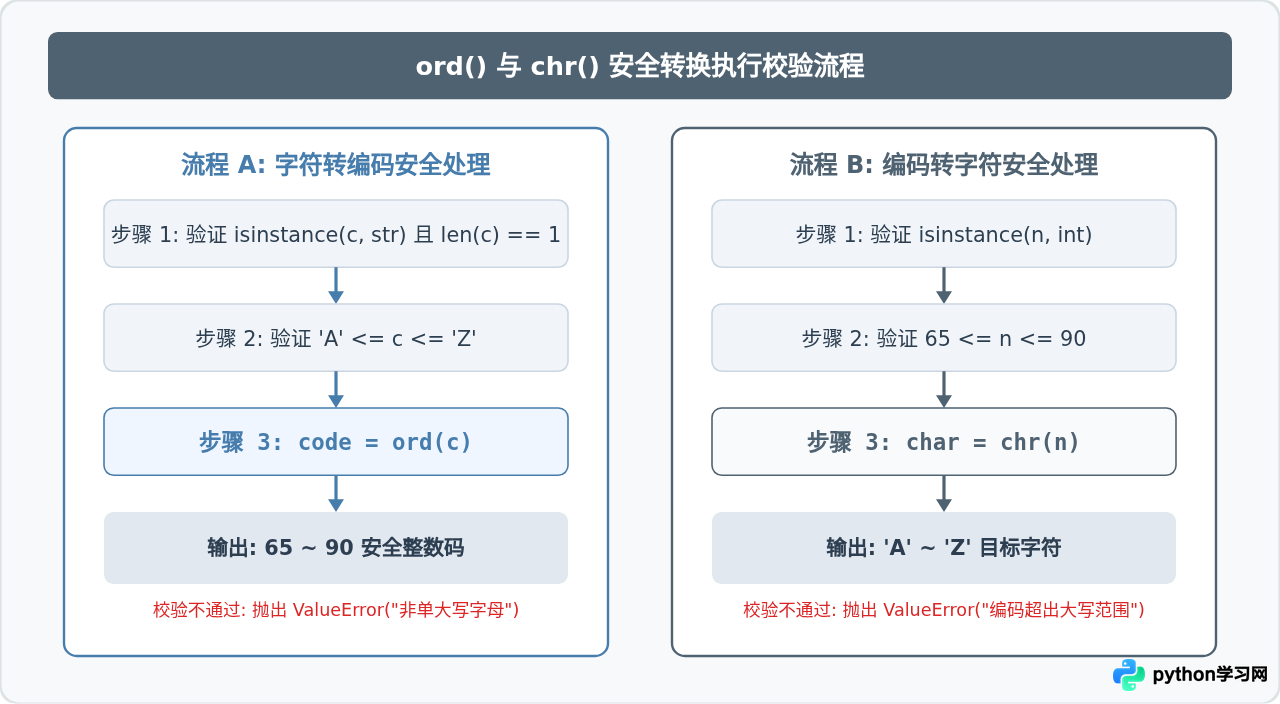
依据上述流程编写防御性转换函数,可以在逻辑入口处阻断不合规参数:
def safe_upper_to_ord(char: str) -> int:
    """安全将大写字母转换为其ASCII编码"""
    if not isinstance(char, str) or len(char) != 1:
        raise TypeError(f"输入参数必须为单字符字符串,实际收到: {repr(char)}")
    if not ('A' <= char <= 'Z'):
        raise ValueError(f"字符 '{char}' 不属于大写英文字母范围 (A-Z)")
    return ord(char)

def safe_ord_to_upper(code: int) -> str:
    """安全将ASCII编码还原为大写字母"""
    if not isinstance(code, int):
        raise TypeError(f"输入编码必须为整数,实际收到: {type(code).__name__}")
    if not (65 <= code <= 90):
        raise ValueError(f"编码值 {code} 超出大写字母有效区间 [65, 90]")
    return chr(code)

# 正常调用测试
print(safe_upper_to_ord('B'))  # 输出: 66
print(safe_ord_to_upper(66))   # 输出: B

# 异常拦截测试(取消注释可查看对应报错)
# safe_upper_to_ord('AB')      # 抛出 TypeError: 输入参数必须为单字符字符串
# safe_ord_to_upper(97)        # 抛出 ValueError: 编码值 97 超出大写字母有效区间 [65, 90]
三大典型应用场景与代码范式
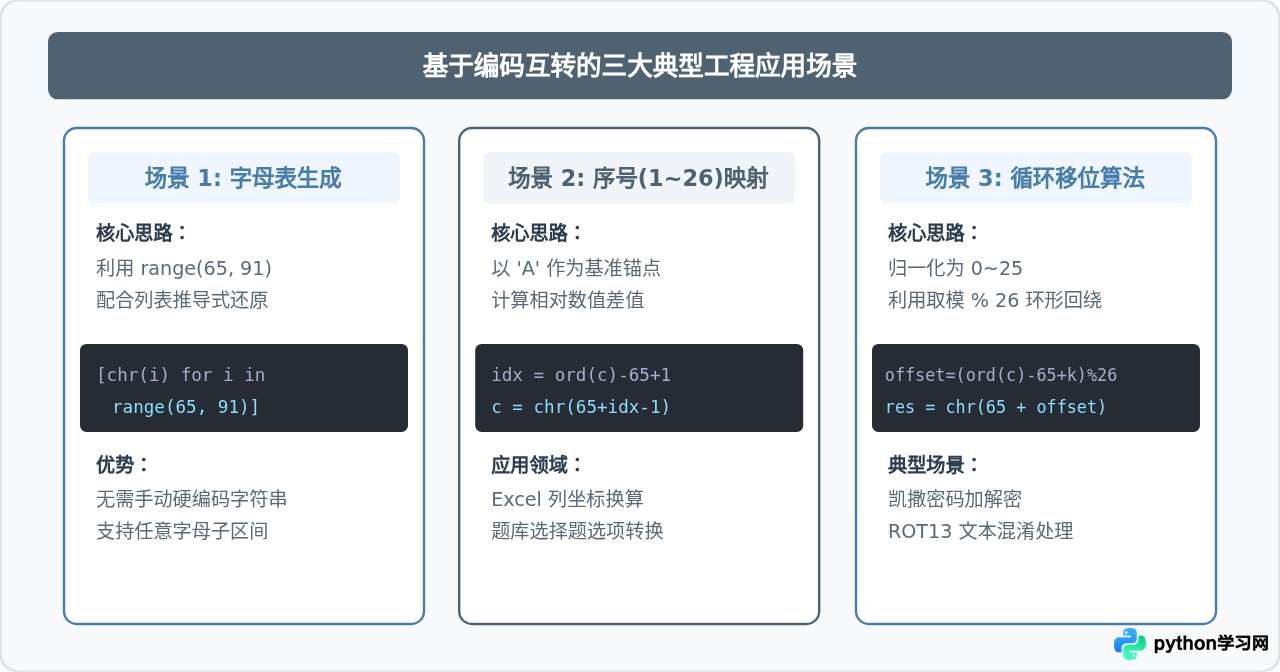
掌握了 ord() 与 chr() 的互转,我们可以利用连续递增的数值区间解决很多具体开发需求。以下是三个最常见的实战场景:
场景一:高效生成大写字母序列
很多初学者在需要大写字母列表时,会手动输入一个长字符串 "ABC...XYZ"。其实利用 range(ord('A'), ord('Z') + 1) 配合 chr(),可以以完全动态且不易出错的方式生成序列:
# 动态生成完整大写字母列表 ['A', 'B', ..., 'Z']
alphabet = [chr(code) for code in range(ord('A'), ord('Z') + 1)]
print(alphabet[:5])  # 示例输出: ['A', 'B', 'C', 'D', 'E']

# 也可以按指定步长生成,例如隔一个字母取一个
alternate_letters = [chr(code) for code in range(ord('A'), ord('Z') + 1, 2)]
print(alternate_letters[:5])  # 示例输出: ['A', 'C', 'E', 'G', 'I']
场景二:字母与自然序号(1~26)的双向映射
在 Excel 处理、考试选项分配或游戏棋盘坐标中,大写字母通常对应从 1 开始的序数(A=1, B=2, ..., Z=26)。通过将 ord('A') 作为基准偏移量,计算公式非常直观:
def letter_to_index(char: str) -> int:
    """A -> 1, B -> 2, ..., Z -> 26"""
    return ord(char) - ord('A') + 1

def index_to_letter(idx: int) -> str:
    """1 -> A, 2 -> B, ..., 26 -> Z"""
    if not (1 <= idx <= 26):
        raise ValueError("序号必须在 1 到 26 之间")
    return chr(ord('A') + idx - 1)

print(letter_to_index('A'))  # 示例输出: 1
print(letter_to_index('Z'))  # 示例输出: 26
print(index_to_letter(3))    # 示例输出: C
场景三:基于取模的字母环形移位(凯撒密码)
当对字母进行位移加密时,如果 'Z' 向后位移 1 位,应该循环回绕到 'A'。这种环形计算通常分三步完成:
- 将大写字母转换为以 0 为起点的偏移量:
ord(c) - 65(范围变为 0 到 25)。 - 加上位移步长并对 26 取模:
(offset + shift) % 26。 - 将模数结果重新加上 65 并调用
chr()还原。
def shift_uppercase(char: str, shift: int) -> str:
    """对大写字母进行环形位移"""
    if not ('A' <= char <= 'Z'):
        return char  # 非大写字母保持原样
    base = ord('A')
    # 归一化为 0~25 -> 模运算 -> 还原为 ASCII 码
    new_code = base + (ord(char) - base + shift) % 26
    return chr(new_code)

# 测试移位操作
print(shift_uppercase('A', 3))   # 示例输出: D
print(shift_uppercase('Z', 1))   # 示例输出: A (回绕到首位)
print(shift_uppercase('B', -1)) # 示例输出: A (逆向移位)32。例如大写 'A' 是 65,而小写 'a' 是 97。因此,在没有使用 .upper() 或 .lower() 的底层逻辑中,可以通过加减 32 或按位异或 32(即二进制的第 5 位)实现大小写转换:chr(ord('A') + 32) == 'a'。
常见疑问与避坑指南
在初学或实际使用这两个函数时,有几个容易混淆的细节需要特别注意:
-
不要混淆字符数字与纯数字:字符
'0'的 ASCII 编码是 48,而chr(0)返回的是空字符(Null character,'\x00')。同理,ord('9')返回的是 57,而非数值 9。 -
不可对非字符直接使用 ord():
ord(65)会直接抛出TypeError,因为ord()必须接收字符串类型参数。 -
多字节与特殊大写变体:在英文字符集外,德语的大写变音字母(如
'Ä'编码为 196)属于更广泛的 Unicode 字符,使用ord()可以正常读取其 Unicode 码点,但它不在基础 ASCII 码的[65, 90]区间内。在处理纯英文大写逻辑时,切记以65到90为明确边界。
核心知识与速查总结
掌握 ord() 与 chr() 的核心在于“锚点意识”:以 ord('A')(即 65)为零基准点,任何大写字母的处理都可以转化为整数运算,运算完毕后再通过 chr() 还原回文本。
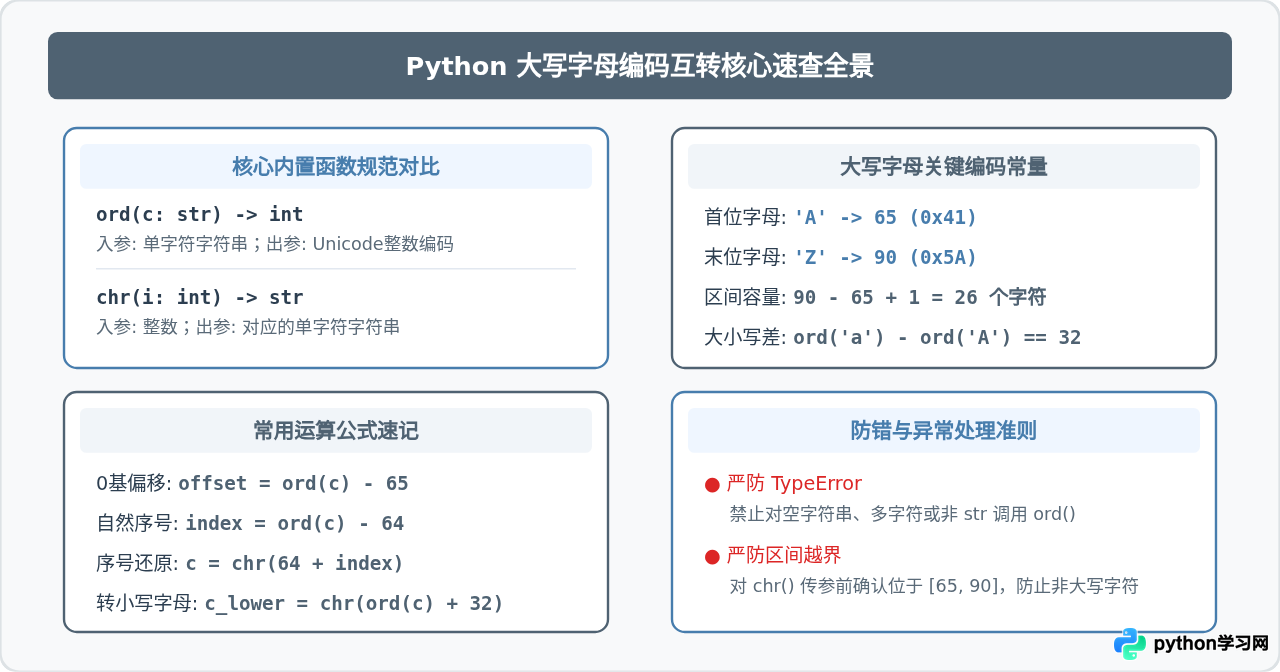
| 目标任务 | 核心实现表达式 | 典型示例输入与结果 |
|---|---|---|
| 大写字母转数值编码 | ord(char) |
'A' -> 65, 'Z' -> 90 |
| 数值编码转大写字母 | chr(code) |
65 -> 'A', 90 -> 'Z' |
| 计算字母在字母表中的顺位 | ord(char) - 64 |
'A' -> 1, 'B' -> 2 |
| 生成完整大写字母列表 | [chr(i) for i in range(65, 91)] |
返回 ['A', 'B', ..., 'Z'] |
| 大写字母环形向后位移 K 位 | chr(65 + (ord(char) - 65 + k) % 26) |
'Z' + 1 -> 'A' |
通过上述规律与标准写法,便能在日常脚本编写、算法题解及文本解析中,高效且精准地处理任何与大写字母相关的编码转换需求。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









