

Python使用elasticsearch-py向Elasticsearch写入单条数据
详细介绍如何使用Python官方客户端elasticsearch-py向Elasticsearch集群写入单条数据。内容涵盖客户端初始化、client.index与client.create方法、文档ID策略、返回值解析、8.x版本参数规范及异常处理。
elasticsearch-py 的 client.index() 或 client.create() 方法。开发者只需构造标准的 Python 字典作为文档数据,指定目标索引名称,即可通过同步调用将数据序列化并索引至集群中。
一、准备工作:依赖安装与客户端连接初始化
在执行写入操作前,需要在运行环境中安装官方客户端库 elasticsearch。该库全面封装了 Elasticsearch RESTful API,并提供了连接池管理、序列化以及自动异常映射等功能。
pip install elasticsearch安装完成后,首先需要建立与 Elasticsearch 集群的连接实例。在生产或测试环境中,通常会开启安全加密与身份认证。官方推荐在实例化客户端时明确指定主机地址、端口、通信协议以及认证信息。
from elasticsearch import Elasticsearch

# 连接本地区域未加密集群(开发测试环境)
client = Elasticsearch("http://localhost:9200")

# 如集群启用了安全认证(Elasticsearch 8.x 默认行为)
# client = Elasticsearch(
#     "https://localhost:9200",
#     basic_auth=("elastic", "your_password"),
#     verify_certs=False  # 若使用自签名证书需按实际情况指定 ca_certs
# )

# 验证客户端连通性
if client.ping():
    print("Elasticsearch 集群连接成功!")
else:
    print("无法连接到 Elasticsearch 集群,请检查服务状态与网络配置。")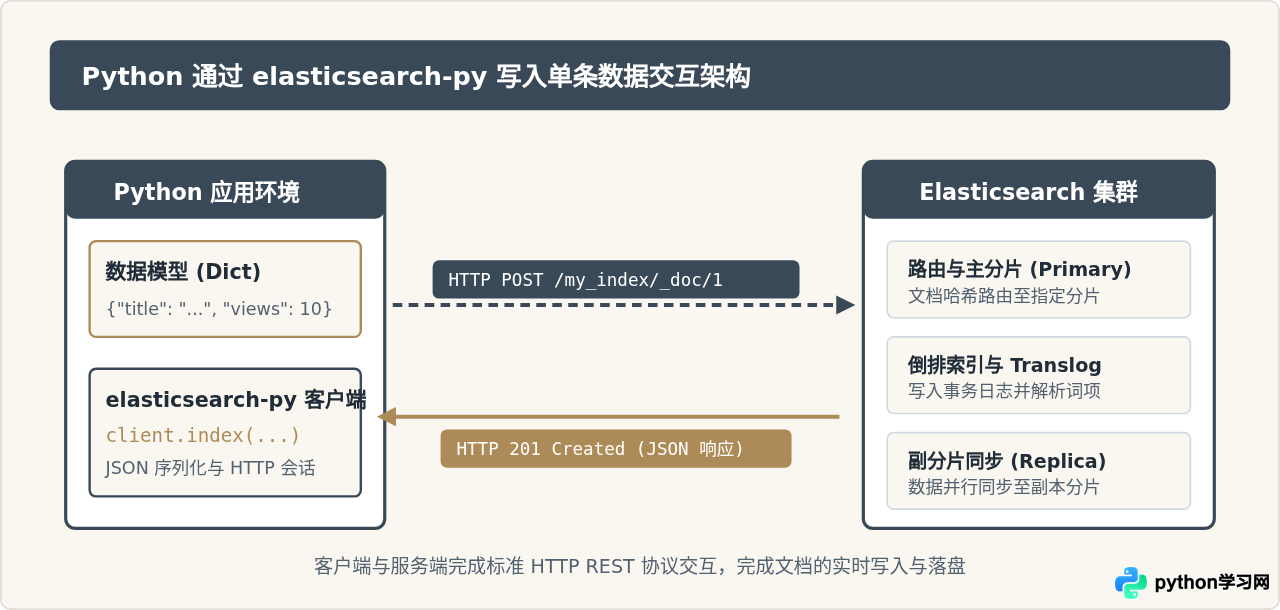
二、核心操作:向 Elasticsearch 写入单条数据
在 elasticsearch-py 8.x 版本中,向指定索引写入单条文档的标准方法是 client.index()。其核心入参包括:
index:目标索引的名称(若索引不存在,ES 默认会依据动态映射规则自动创建索引)。id(可选):文档的唯一主键标识符。若显式传入,则以此 ID 写入;若省略,Elasticsearch 将自动生成一个 20 位的随机唯一 ID。document:要存储的文档数据,在 Python 中直接传入标准dict字典即可。
1. 显式指定文档 ID 写入
当业务系统中已有唯一主键(例如用户 ID、订单号、文章编号)时,显式指定 id 可以保证写入的幂等性。如果该 ID 已存在,执行 index() 会进行全量覆盖并自增版本号(_version)。
from datetime import datetime
from elasticsearch import Elasticsearch

client = Elasticsearch("http://localhost:9200")

# 1. 准备要写入的单条文档数据
doc_data = {
    "title": "Python使用elasticsearch-py向Elasticsearch写入单条数据",
    "author": "技术专栏",
    "views": 1024,
    "tags": ["Python", "Elasticsearch", "数据库"],
    "is_published": True,
    "created_at": datetime.now().isoformat()
}

# 2. 调用 index 方法写入单条数据并指定 id
response = client.index(
    index="articles",
    id="article_1001",
    document=doc_data
)

# 3. 输出写入结果
print(f"写入状态: {response['result']}")  # 新建时通常为 'created',覆盖更新时为 'updated'
print(f"文档索引: {response['_index']}")
print(f"文档 ID: {response['_id']}")
print(f"当前版本: {response['_version']}")
2. 省略 ID 自动生成唯一标识
对于不需要指定业务主键的日志记录、监控指标或流水数据,可以不传递 id 参数。Elasticsearch 底层会自动生成一个全局唯一的 Base64 编码字符串。
# 自动生成文档 ID 写入
auto_id_response = client.index(
    index="access_logs",
    document={
        "ip": "192.168.1.50",
        "action": "login",
        "status": "success",
        "timestamp": datetime.now().isoformat()
    }
)

print(f"自动生成的文档 ID 为: {auto_id_response['_id']}")
print(f"写入结果: {auto_id_response['result']}")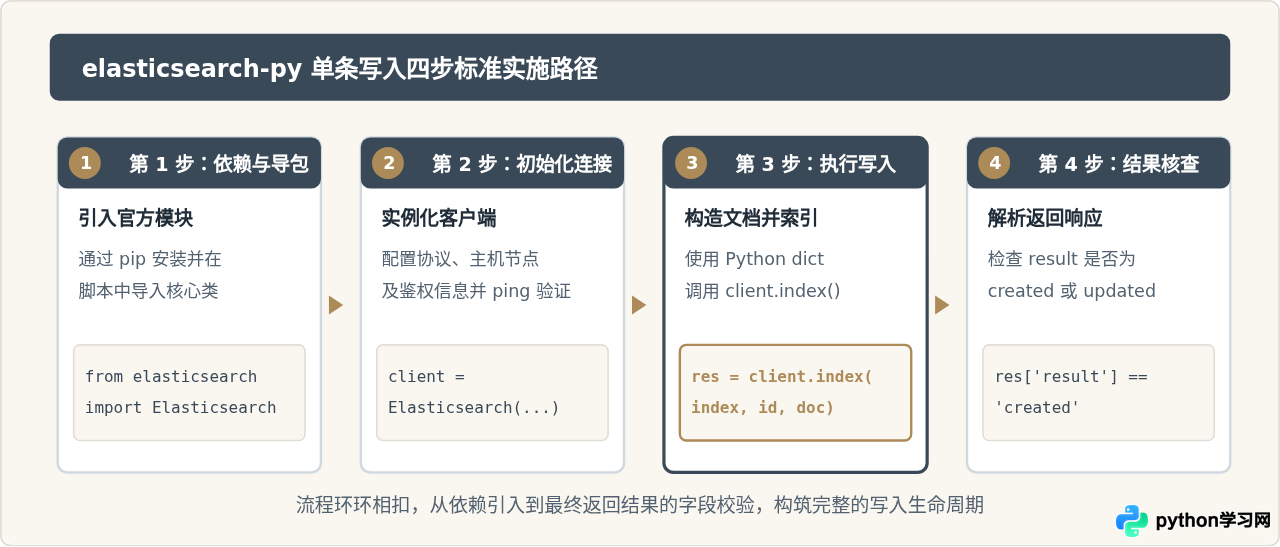
三、返回结果解析与写入验证
当调用 client.index() 成功后,Elasticsearch 会返回一个包含元数据的字典对象。理解这些字段对于确认写入状态和排查业务问题至关重要:
{
    "_index": "articles",
    "_id": "article_1001",
    "_version": 1,
    "result": "created",
    "_shards": {
        "total": 2,
        "successful": 1,
        "failed": 0
    },
    "_seq_no": 0,
    "_primary_term": 1
}result:写入动作的直接反映。首次创建时为"created";若传入相同 ID 进行全量覆盖,则为"updated"。_id:文档的主键。如果未指定 ID,此处即为 ES 分配的生成值。_version:文档版本号,每次成功修改或覆盖该文档时都会严格递增。_shards:分片写入状态。包含参与写入的总分片数(total)、成功写入的分片数(successful)及失败数(failed)。
在写入完成后,可以通过 client.get() API 立即进行点对点读取验证,确认文档内容是否准确存储于分片中:
# 校验写入数据是否可检索
try:
    doc = client.get(index="articles", id="article_1001")
    print("读取验证成功!存储的原始数据为:")
    print(doc["_source"])
except Exception as e:
    print(f"验证读取时发生异常: {e}")
四、写入模式对比:index() 与 create() 的选择边界
在单条数据写入场景中,业务常常有不同的防重复与并发控制要求。除了默认的 index() 方法外,官方客户端还提供了 create() 方法(或在 index() 中设置 op_type="create")。二者的行为差异直接关系到系统的数据安全性:
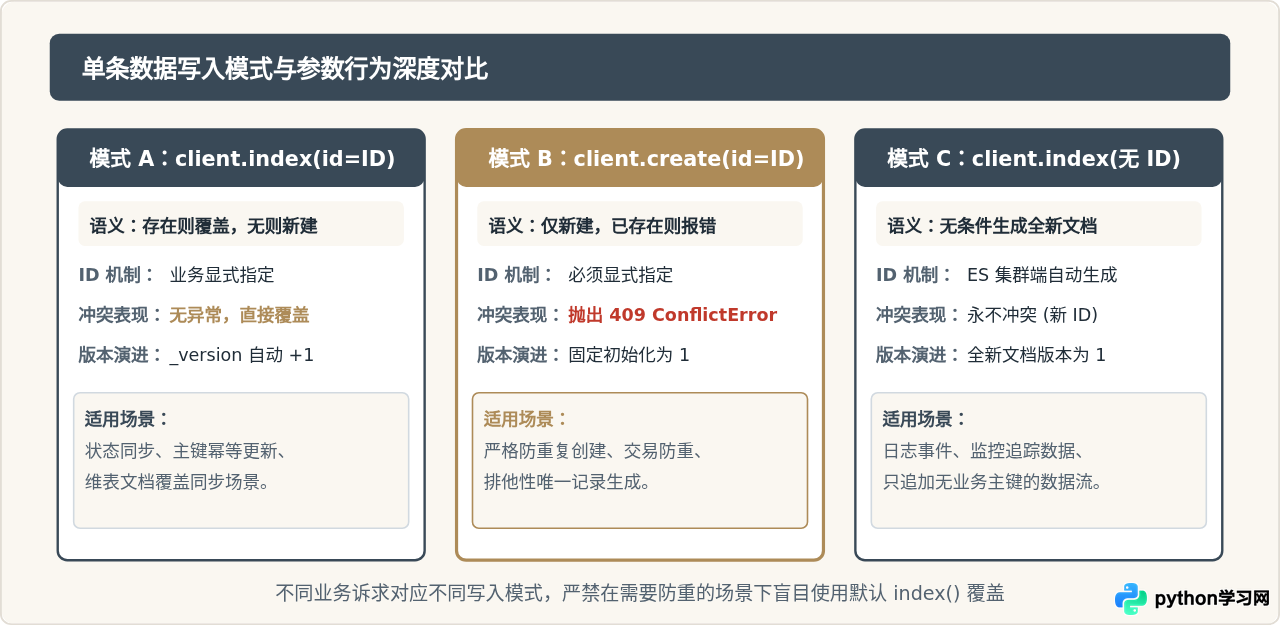
如果希望严格防止误覆盖已存在的数据,应显式采用 client.create()。当发现相同 ID 时,ES 将返回 HTTP 409 状态码,客户端会抛出 ConflictError 异常:
from elasticsearch.exceptions import ConflictError

try:
    client.create(
        index="articles",
        id="article_1001",
        document={"title": "冲突测试文档"}
    )
except ConflictError:
    print("错误提示: 该 ID 的文档已经存在,已阻止写入以防覆盖!")
五、版本兼容与异常处理规范
1. 8.x 与 7.x 版本的参数差异
elasticsearch-py 在升级到 8.x 后对参数签名进行了规范化调整:
- 8.x 版本推荐:使用
document参数传递文档内容,如client.index(index="...", id="...", document={...})。 - 7.x 版本及更早:历史上使用的是
body参数,如client.index(index="...", id="...", body={...})。在 8.x 中使用body参数仍可工作,但会触发弃用警告(DeprecationWarning),后续主要版本将彻底移除。
2. 健壮的异常捕获实践
向分布式集群写入单条数据时,可能会遇到网络超时、认证失效、Mapping 映射类型冲突等情况。生产环境中应针对官方异常类做针对性捕获:
from elasticsearch.exceptions import (
    ConnectionError,
    AuthenticationException,
    BadRequestError,
    ConflictError
)

try:
    res = client.index(
        index="sensor_data",
        id="device_sensor_01",
        document={
            "temperature": 25.4,
            "humidity": 60
        }
    )
    print(f"写入成功,结果: {res['result']}")
except ConnectionError as e:
    print(f"网络连接异常: 无法与 Elasticsearch 通信 -> {e}")
except AuthenticationException:
    print("认证失败: 用户名或密码错误")
except BadRequestError as e:
    print(f"请求参数或 Mapping 映射冲突 -> {e.message}")
except ConflictError:
    print("文档 ID 冲突,记录已存在")
except Exception as e:
    print(f"未知异常: {e}")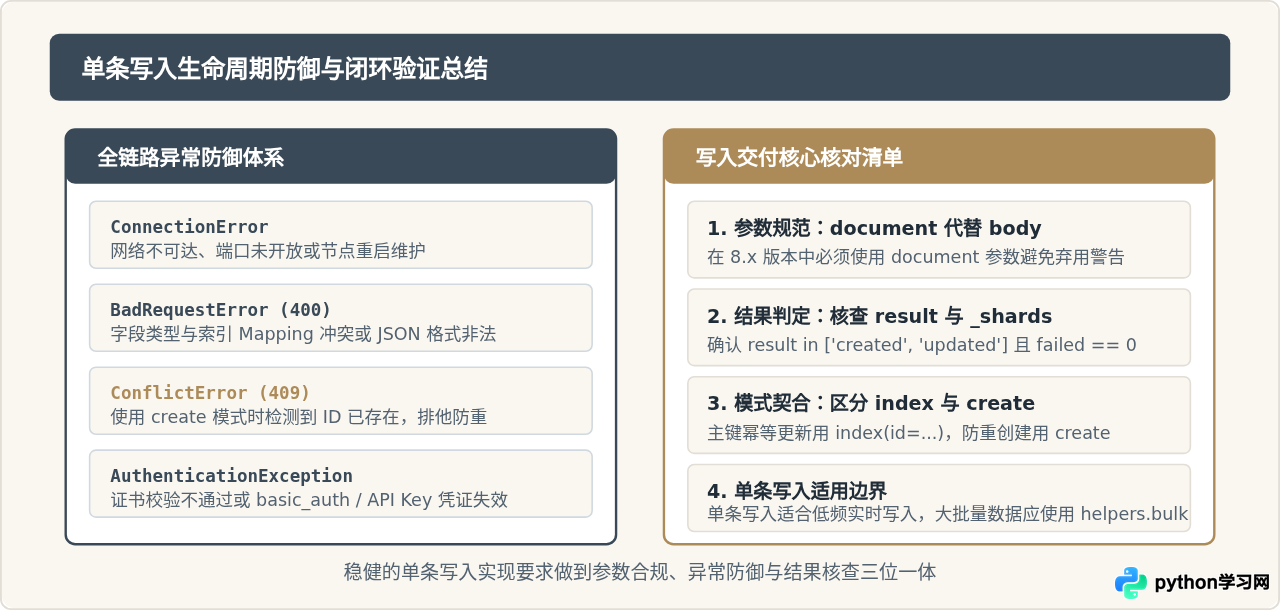
六、总结与实践建议
使用 elasticsearch-py 向 Elasticsearch 写入单条数据是与搜索集群交互的基础能力。在实际开发中,建议遵循以下原则:
- 明确 ID 策略:具备确定业务主键的数据必须显式传入
id;无主键的日志类数据留空由 ES 自动生成。 - 使用当前主流标准签名:在 Elasticsearch 8.x 环境下,统一使用
document传参,避免沿用旧版body参数。 - 关注单条写入的吞吐边界:
client.index()每次调用都会建立单独的 HTTP 请求与分片写入往返。若面对成百上千条的高吞吐写入需求,应改用elasticsearch.helpers.bulk()批量接口,以避免过多的网络 RTT 和集群内部负载。而在交互式更新、单个配置保存或低频实时接入场景中,单条写入方法则是最直接、最可靠的实现方式。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









