

Python字符串切片与split的区别:索引提取还是分隔符分割?
深入对比Python字符串切片与split方法的本质区别、适用场景与性能边界,帮助开发者准确选择基于固定索引提取还是基于动态分隔符拆分。
处理字符串时,提取子串是最频繁的操作之一。许多初学者常常在“切片(Slice)”与“split()方法”之间犹豫,甚至误以为两者可以完全互相替代。其实它们的核心机制截然不同:字符串切片是基于固定物理位置的索引截取,而 split() 是基于特定字符或模式的内容边界分割。清楚两者的工作原理与边界条件,是写出健壮、高效数据清洗代码的基础。
一、核心机制对比:索引寻址 vs 内容标记
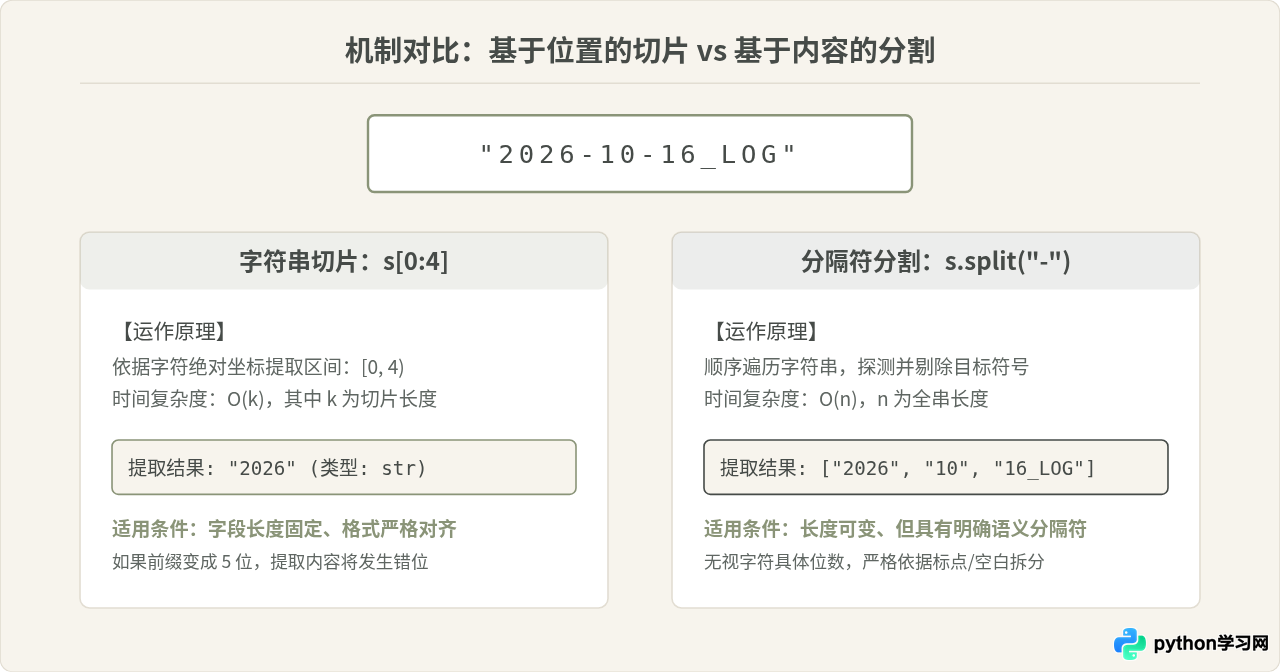
字符串在 Python 中是以不可变的连续字符序列存储的。每个字符都拥有固定的正向与逆向索引下标。理解切片与分割的根本差异,首先要理清底层的数据寻址模式:
- 切片(Slicing):利用位置坐标
[start:stop:step]直接计算内存偏移量。它不关心子串的具体内容是什么,只关心目标处于字符串的第几个位置。 - split() 方法:在字符串内部从前向后扫描匹配指定的分隔符(Delimiter)。它不依赖固定坐标,而是通过寻找内容标记来动态计算边界,并将结果组织成列表。
二、语法细节与使用规范
1. 字符串切片:左闭右开与步长规则
切片的基本语法结构为 string[start:stop:step]。其设计原则是“包含起始下标,不包含结束下标”(左闭右开),这种设计使得 stop - start 恰好等于所截取子串的长度。
# 示例代码:切片的基础与步长操作
text = "PYTHON-2026"

# 1. 基础区间提取
lang = text[0:6]        # 提取 'PYTHON',长度为 6 - 0 = 6
print(lang)             # 输出示例: PYTHON

# 2. 负索引与末尾提取
year = text[-4:]        # 提取末尾 4 位字符
print(year)             # 输出示例: 2026

# 3. 步长与反转
step_demo = text[::2]   # 间隔采样
print(step_demo)        # 输出示例: PTO-06
reversed_text = text[::-1]
print(reversed_text) # 输出示例: 6202-NOHTYP"abc"[0:100] 会安全地返回 "abc"。
2. split() 方法:分隔符与切分次数限制
split(sep=None, maxsplit=-1) 方法通过指定分隔符将字符串拆散。默认情况下(即 sep=None),Python 会将任意连续的空白字符(空格、换行 \n、制表符 \t 等)视作单一分隔符,并自动忽略字符串首尾的空白。
# 示例代码:split 的核心用法
log_line = "2026-10-16   INFO    System started successfully"

# 1. 默认参数:按连续空白分割
parts = log_line.split()
print(parts)
# 输出示例: ['2026-10-16', 'INFO', 'System', 'started', 'successfully']

# 2. 指定分隔符:严格匹配
date_parts = "2026-10-16".split("-")
print(date_parts)
# 输出示例: ['2026', '10', '16']

# 3. 控制最大切分次数:maxsplit
header, rest = log_line.split(maxsplit=1)
print("Header:", header)  # 输出示例: Header: 2026-10-16
print("Rest:", rest)      # 输出示例: Rest: INFO    System started successfully
三、关键执行流程:从输入到提取的步骤推导
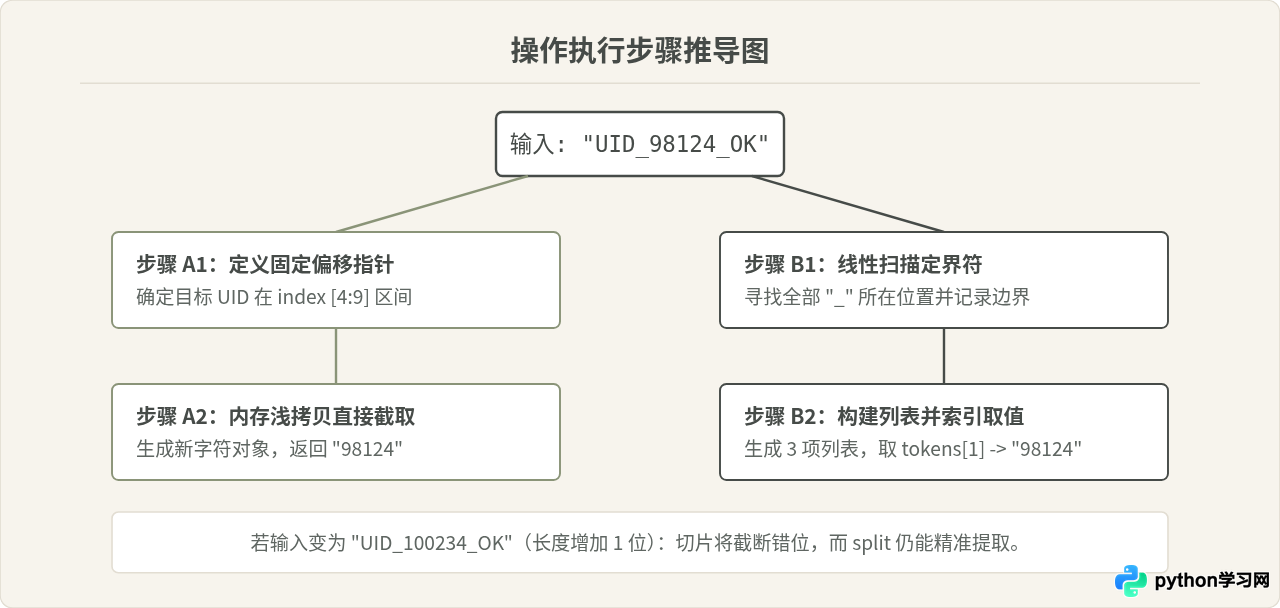
为了让读者直观理解在面对一段输入数据时,两种方法内部具体经历了哪些操作步骤,我们以提取形如 "UID_98124_ACTIVE" 的用户数据为例,梳理各自的数据流转与处理推导过程。
四、容易混淆的认知误区与辨析
在日常开发与代码审查中,常能见到关于切片和 split() 的典型偏见或错误假设。了解这些说法背后的合理成分与局限,能帮助我们在实际场景中做出稳妥决策:
误区 1:“切片性能远高于 split(),所以只要能切片就绝不用 split()”
为什么看似合理:切片是底层 C 语言级别的偏移计算,不需要分配列表(list)容器,也不需要遍历查找字符,微观基准测试下执行耗时的确更低。
哪里需要修正:性能优势的前提是“字符串规范完全固定”。现实业务中的数据(如电话号码、用户ID、日志等)往往存在补零差异、历史遗留格式或动态位数。盲目为了微秒级的性能追求切片,一旦数据长度变动,切片不会报错,而是静默产生错误数据,引发严重的业务隐患。在字段由明确分隔符隔开时,应首选 split()。
误区 2:“split() 切割得到的每一个元素,在内存中都比切片更占空间”
为什么看似合理:split() 返回一个包含所有片段的 list,如果只需要第一个片段,拆分全部字符看似极度浪费内存和 CPU。
哪里需要修正:该说法在不加限制地调用 s.split(",") 时的确成立。但 Python 提供了 maxsplit 参数!例如只需前缀时使用 s.split(",", 1)[0],引擎完成一次匹配就会立即停止扫描,内存开销立刻收敛。同时,结合 partition() 也是极佳的高效替代方案。
五、深度技术对比:特性与边界考量
为了在工程开发中能够快速查阅并建立清晰的技术心智,下表系统梳理了两者的核心属性与关键表现:
| 对比维度 | 字符串切片 (Slicing) | 分隔符分割 (split) |
|---|---|---|
| 寻址依据 | 整数索引(基于字符物理排列下标) | 符号匹配(基于分隔字符的内容边界) |
| 返回类型 | str(字符串本身) |
list[str](拆分后的字符串列表) |
| 越界行为 | 自动安全截断,不抛出异常 | 通过列表下标获取超出范围项会抛出 IndexError |
| 容错能力 | 对字符长度变动极度敏感,易静默错位 | 自适应可变长度,只要分隔符规律存在即可解析 |
| 多字符支持 | 支持步长(如隔位采样、反转逆序) | 原生仅支持固定子串,正则分割需借助 re.split |
六、如何做出稳健的技术选型?
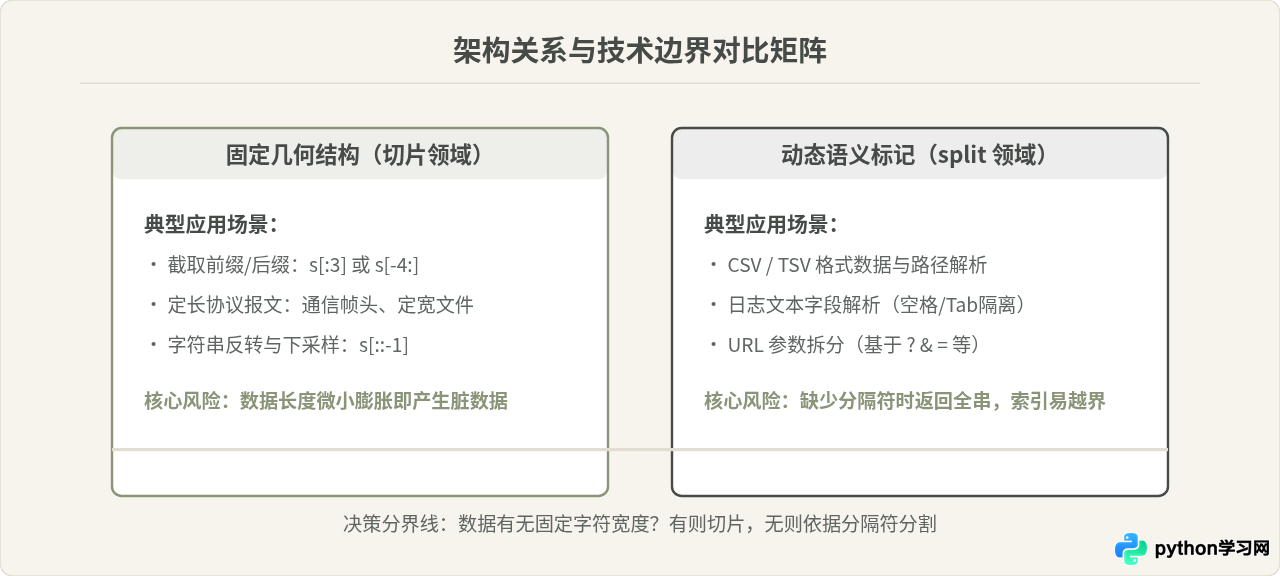
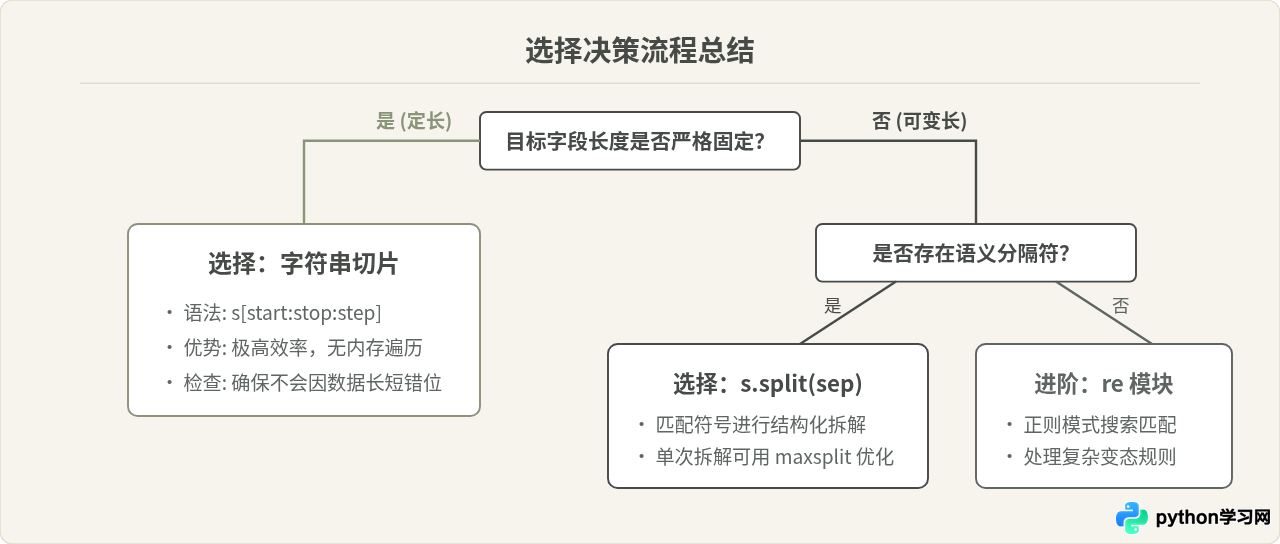
在编写实际程序时,可以按照以下三个判断依据进行选择:
- 看数据对齐规范:如果是标准定长格式(如身份证号提取出生年月、固定宽度的老旧银行对接接口),切片是最干净、最符合直觉的写法。
- 看分隔标记是否存在:如果子串长度动态不定(如邮箱地址中的用户名和域名、文件系统的多级路径),必须使用以
@或/为标志的split()提取。 - 混合运用场景:复杂字符串往往需要联合运用。例如先通过
split(":")提取出键值对,再通过切片value[1:-1]脱去外层的引号。
七、总结
回到文章标题提出的问题:是索引提取还是分隔符分割?
答案并非二选一的对立,而是取决于输入数据的本质形态。如果数据具有明确的空间位置规律(定长),索引切片以其轻量和精确提供了最佳答案;如果数据具有灵活的文本分隔符号(可变长),split() 则是避免业务错位的护城河。掌握两者的分工界限,才能在数据清洗与业务逻辑编写中兼顾代码的稳健与高效。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









