

Python requests、urllib和aiohttp下载文件有什么区别?
深入对比 Python 中 urllib、requests 与 aiohttp 三大工具在文件下载场景下的核心区别,涵盖并发模型、大文件流式传输、内存控制机制及工程选型指南。
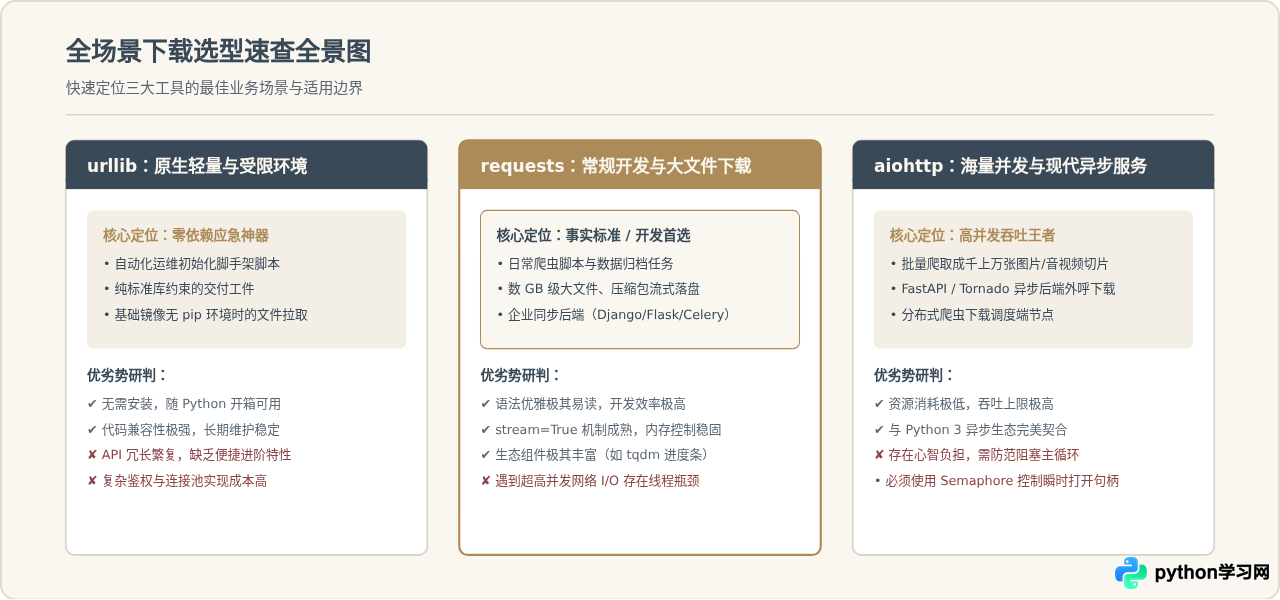
在 Python 中下载文件,urllib、requests 与 aiohttp 的核心区别集中在三个维度:依赖环境与内置程度、底层 I/O 并发模型(同步阻塞与异步事件循环),以及大文件流式传输的控制粒度与 API 易用性。简而言之,urllib 是 Python 标准库自带的原生组件,无需安装任何第三方依赖,适合系统运维脚本或受限环境中的轻量下载;requests 凭借直观的人性化接口和成熟的连接池管理,成为常规开发、大文件稳定流式落盘的首选同步工具;而 aiohttp 则运行在 asyncio 事件循环之上,依托非阻塞协程机制,在海量小文件批量并发下载时能以极低的内存和线程开销实现数十倍的吞吐效率。
一、核心并发模型:同步阻塞与异步事件循环的区别
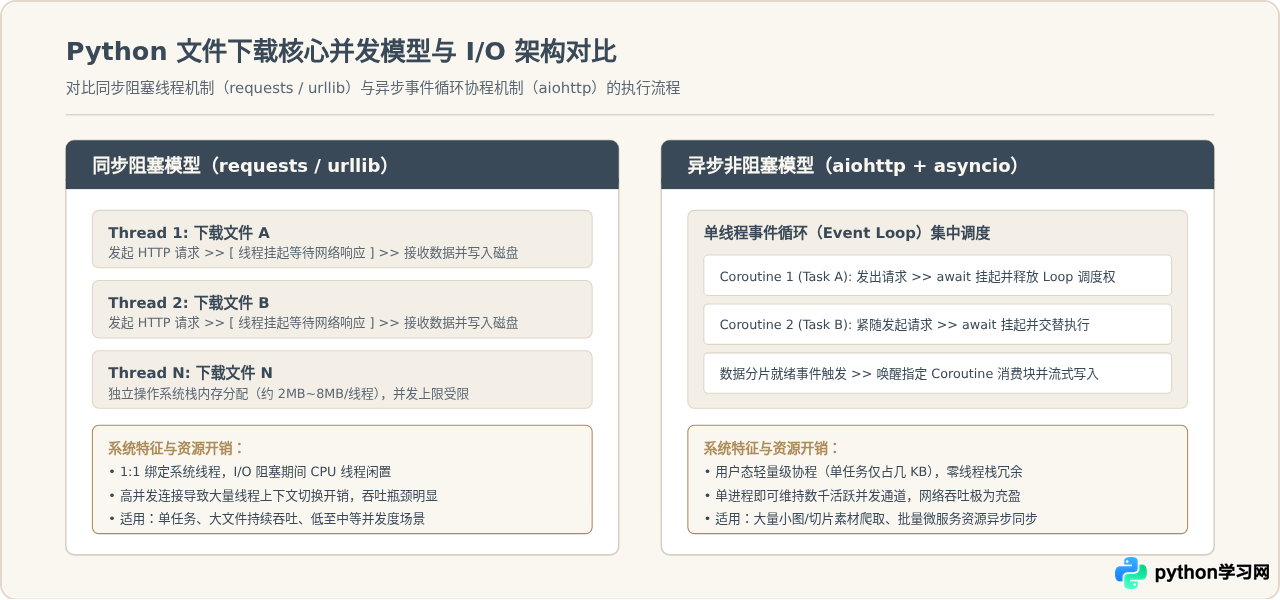
探讨这三个库的本质差异,首先必须回到操作系统层面的网络 I/O 调度方式。urllib 和 requests 均采用传统的同步阻塞(Synchronous Blocking)I/O 模型,而 aiohttp 则采用基于 asyncio 的异步非阻塞(Asynchronous Non-blocking)事件驱动模型。
在同步模型中,调用下载函数(例如 requests.get() 或 urllib.request.urlopen())后,当前线程会被操作系统完全挂起,直到远程服务器建立连接、传输完首批数据或抛出网络异常。若要同时下载 50 个文件,开发者通常必须依赖多线程(如 ThreadPoolExecutor)或多进程。然而,操作系统线程并不是无成本的:每个线程都分配有独立的调用栈内存(通常为数 MB),且成百上千个线程在网络等待与唤醒之间的上下文切换(Context Switching)会造成严重的 CPU 抖动与性能损耗。
aiohttp 则利用 Python 3 的原生协程(async/await)。在单进程单线程内,协程发起网络请求后立即将控制权归还给事件循环(Event Loop),CPU 可以继续去触发其他下载请求。只有当网卡接收到对应套接字的数据包时,事件循环才会唤醒等待该事件的协程继续执行。这种协作式多任务机制使得单个进程仅需维护轻量级的协程上下文(仅数 KB),能以极少的硬件资源轻松维持数百上千个并发下载通道。
二、大文件流式下载与内存控制机制
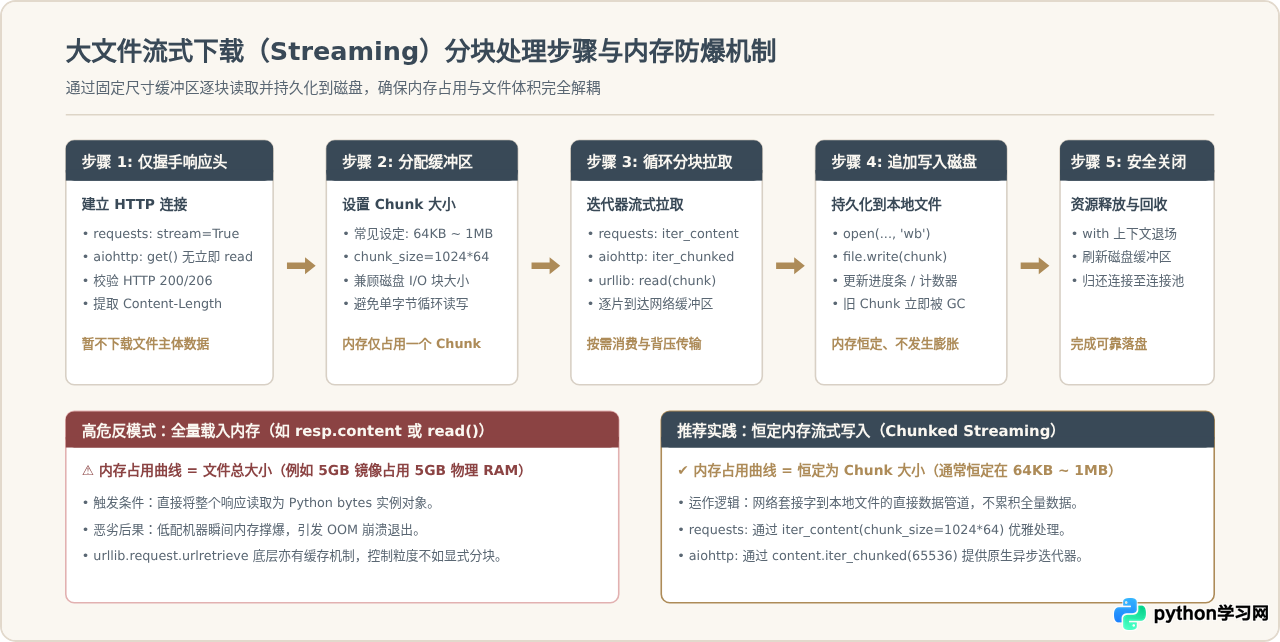
文件下载过程中最危险的错误就是一次性将远程文件全部载入内存。例如下载一个 4GB 的系统镜像或视频,如果直接使用 response.content 或 read(),程序会瞬间向系统申请 4GB 内存,轻则导致系统剧烈交换页面并降频卡顿,重则直接触发操作系统的 OOM Killer(内存溢出杀进程机制)。因此,评估下载库好坏的关键指标之一就是流式下载(Streaming Download)支持度。
1. urllib 的流式下载实现方式
urllib 提供了快捷方法 urllib.request.urlretrieve(url, filename),但该方法无法精准设置每次读取的缓冲区大小,遇到重定向、认证或需要添加自定义 Header 时缺乏灵活性,且在 Python 官方文档中早已不推荐在新代码中过度依赖。标准的稳妥做法是结合 urllib.request.urlopen 与 shutil.copyfileobj,或者手动循环读取:
import urllib.request
import shutil

url = "https://example.com/largefile.zip"
target_path = "largefile_urllib.zip"

req = urllib.request.Request(
    url,
    headers={"User-Agent": "Mozilla/5.0 (compatible; Python-urllib)"}
)

with urllib.request.urlopen(req, timeout=30) as response, open(target_path, "wb") as out_file:
    # 方式一:利用 shutil 内部的缓冲复制(默认 64KB 块)
    shutil.copyfileobj(response, out_file, length=64 * 1024)

    # 方式二:手动循环分块读取
    # while True:
    #     chunk = response.read(64 * 1024)
    #     if not chunk:
    #         break
    #     out_file.write(chunk)
2. requests 的流式下载实现方式
requests 在大文件下载场景中拥有最符合直觉的 API。其核心关键是显式设置 stream=True。如果不设置该参数,requests.get() 会在函数返回前预先将整个 Response Body 全部下载并载入内存。配合 iter_content(),可以极为平滑地实现进度跟踪与低内存写入:
import requests

url = "https://example.com/largefile.zip"
target_path = "largefile_requests.zip"

# stream=True 确保此时只下载了 HTTP Headers,未开始下载内容实体
with requests.get(url, stream=True, timeout=(5, 30)) as response:
    response.raise_for_status()  # 遇到 4xx/5xx 及时抛出异常
    total_size = int(response.headers.get("Content-Length", 0))
    downloaded = 0

    with open(target_path, "wb") as f:
        # 逐块获取 64KB 数据
        for chunk in response.iter_content(chunk_size=64 * 1024):
            if chunk:  # 过滤 keep-alive 保持帧
                f.write(chunk)
                downloaded += len(chunk)
3. aiohttp 的异步流式下载实现方式
aiohttp 下载大文件必须在异步上下文中配合 response.content.iter_chunked() 使用。在迭代每个数据块时,使用 async for 进行非阻塞消费:
import aiohttp
import asyncio

async def download_file(url: str, target_path: str):
    timeout = aiohttp.ClientTimeout(total=600, connect=10)
    async with aiohttp.ClientSession(timeout=timeout) as session:
        async with session.get(url) as response:
            if response.status != 200:
                raise RuntimeError(f"下载失败,状态码: {response.status}")

            with open(target_path, "wb") as f:
                # 异步流式分块读取
                async for chunk in response.content.iter_chunked(64 * 1024):
                    f.write(chunk)

# 在事件循环中运行
# asyncio.run(download_file("https://example.com/largefile.zip", "largefile_aio.zip"))
三、API 复杂度、连接池复用与工程维护成本
在工程项目中,代码不仅要能跑通,还要考虑外部依赖、会话长连接复用(Keep-Alive)以及错误重试等长期维护问题。
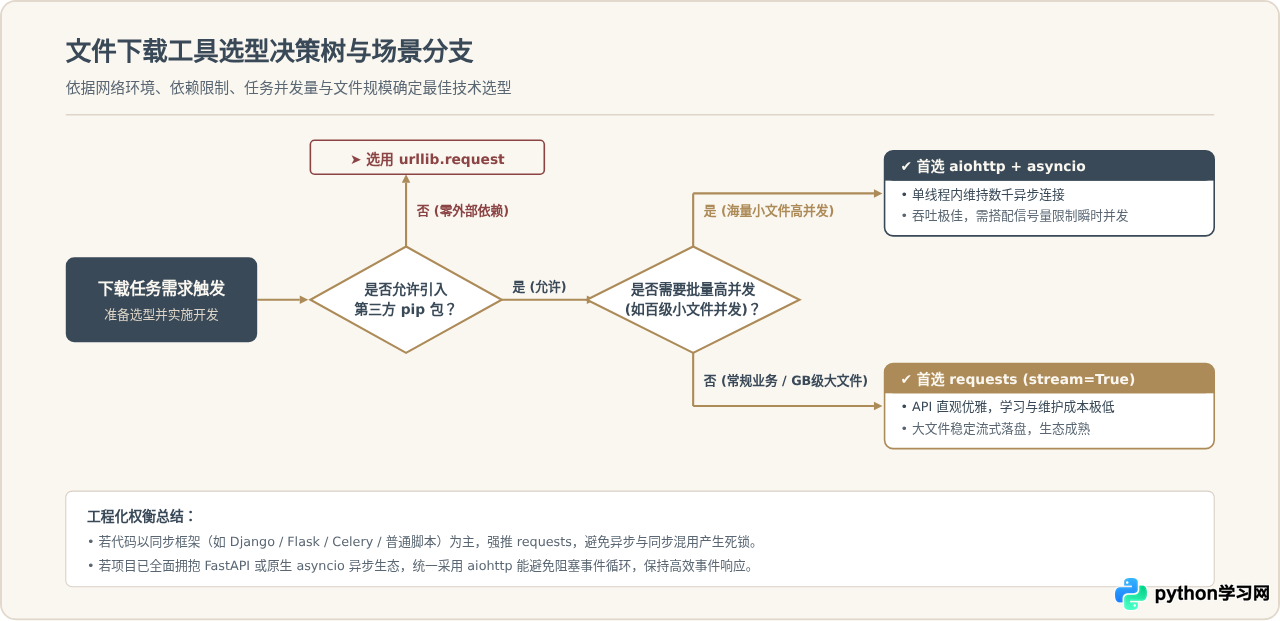
1. 第三方依赖与环境约束: urllib 随 Python 解释器分发,无需执行 pip install,也不存在包版本冲突或在受限内网环境中找不到 wheel 包的问题。如果你的脚本需要部署在数十台没有外网访问权限的离线服务器上,或者仅仅是嵌入在一段一次性的 Bash 初始化脚本中,urllib 是最安全的选择。相反,requests 和 aiohttp 均属于第三方生态,必须通过包管理器预先安装。
2. TCP 连接池与 Keep-Alive 会话复用: 下载多个文件时,反复进行 TCP 三次握手和 TLS 握手会带来高额的延迟开销。requests.Session() 底层基于 urllib3,默认自动维护针对同域名的连接池,同一个 Session 内发起的多个请求会自动复用已建立的 TCP 通道。aiohttp.ClientSession 同样内置了高性能连接池(默认并发连接上限限制为 100)。而标准库 urllib.request 虽然也可以通过自定义 HTTPHandler 实现一定程度的复用,但配置流程冗长且极其晦涩。
3. 超时机制(Timeout)差异: requests 和 urllib 允许为单次请求传入浮点数秒或元组形式的超时时间(连接超时与读取超时分开设置)。而 aiohttp 提供了更为结构化的 ClientTimeout 对象,允许分别限制从 DNS 解析、Socket 握手到全量数据接收的各个独立超时阈值,在复杂的微服务网络中控制粒度最细。
四、选型建议与典型场景实战对照
为了在实际项目中快速决断,下表汇总了三者在核心技术维度的详细能力对比:
| 对比维度 | urllib.request | requests | aiohttp |
|---|---|---|---|
| 依赖属性 | 内置标准库,零安装成本 | 第三方库(需 pip install requests) |
第三方库(需 pip install aiohttp) |
| I/O 模型 | 同步阻塞 | 同步阻塞 | 异步非阻塞(基于 asyncio) |
| 流式传输便利度 | 中等(需手动循环 read 或借助 shutil) |
极高(stream=True + iter_content) |
优秀(content.iter_chunked 异步迭代) |
| 连接池与会话 | 需手动编写 Handler/Opener,较繁琐 | 极其简单(requests.Session()) |
标准配置(aiohttp.ClientSession()) |
| 高并发表现 | 依赖系统线程池,资源开销高 | 依赖多线程/多进程,并发上限受限 | 协程调度,单进程轻松维持千级并发 |
| 代码可读性与上手难度 | API 较底层,异常处理相对分散 | 极佳,符合人类阅读习惯的事实标准 | 中等,需要理解 async/await 协程模型 |
五、生产环境高频陷阱与防坑建议
在默认情况下,requests.get() 和 urllib.request.urlopen() 如果不传 timeout,网络套接字将处于无超时无限等待状态。一旦远端服务器因为故障保持 TCP 连接但不再吐出任何字节,整个下载线程或主脚本将永久阻塞在此处,造成作业队列雪崩。务必养成显式指定超时的习惯,如 requests.get(url, timeout=(5, 60))(5 秒连接超时,60 秒读取超时)。
aiohttp 自身负责将网络数据包以异步方式拉取到内存,但标准文件操作 f.write(chunk) 是操作系统级的同步阻塞 I/O。如果下载的数据块很大且磁盘写操作出现卡顿,这行同步写入代码会直接阻塞当前的事件循环,导致其他所有正在排队等待的异步下载协程全部停滞。处理高吞吐异步下载时,建议将文件写入逻辑通过 asyncio.to_thread(f.write, chunk) 抛给辅助线程,或引入 aiofiles 库来完成真正的异步持久化。
新手在使用 aiohttp 下载 5000 个文件时,往往直接使用 asyncio.gather(*[download(url) for url in urls]) 一瞬间全部触发。这会导致程序在一秒钟内向操作系统申请打开数千个网络套接字和本地文件句柄,迅速触发操作系统的 Too many open files(errno 24)系统级崩溃,同时可能导致远端服务器触发防护机制封禁 IP。在编写 aiohttp 并发代码时,必须使用 asyncio.Semaphore(20) 将最大同时活跃连接数限制在合理范围。
总结
回顾 urllib、requests 与 aiohttp 的本质区别,可以归纳为一句话:“环境受限选 urllib,日常开发与大文件落盘选 requests,海量批量高并发选 aiohttp。” 充分理解三者在阻塞机制与内存流式控制上的差异,能够帮助我们在面对从 MB 到 TB 级别的不同规模下载任务时,编写出兼具高稳定性、低资源开销与良好扩展性的工业级 Python 代码。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









