

python必背源代码读写文本文件withopen代码
深入讲解Python必背源代码读写文本文件with open语法,涵盖只读、覆盖写、末尾追加、逐行流式读取与多文件处理,深度剖析上下文管理器生命周期与常见避坑指南。
在 Python 中读写文本文件,最安全、最符合工程标准的做法是使用 with open(...) as f: 语法。它借助 Python 内置的上下文管理器协议,无论文件操作是正常结束还是中途触发异常,都能确保底层系统文件句柄被即时、安全地关闭,从根本上杜绝内存句柄泄漏与写缓冲区数据丢失的风险。
一、核心两组必背源代码骨架
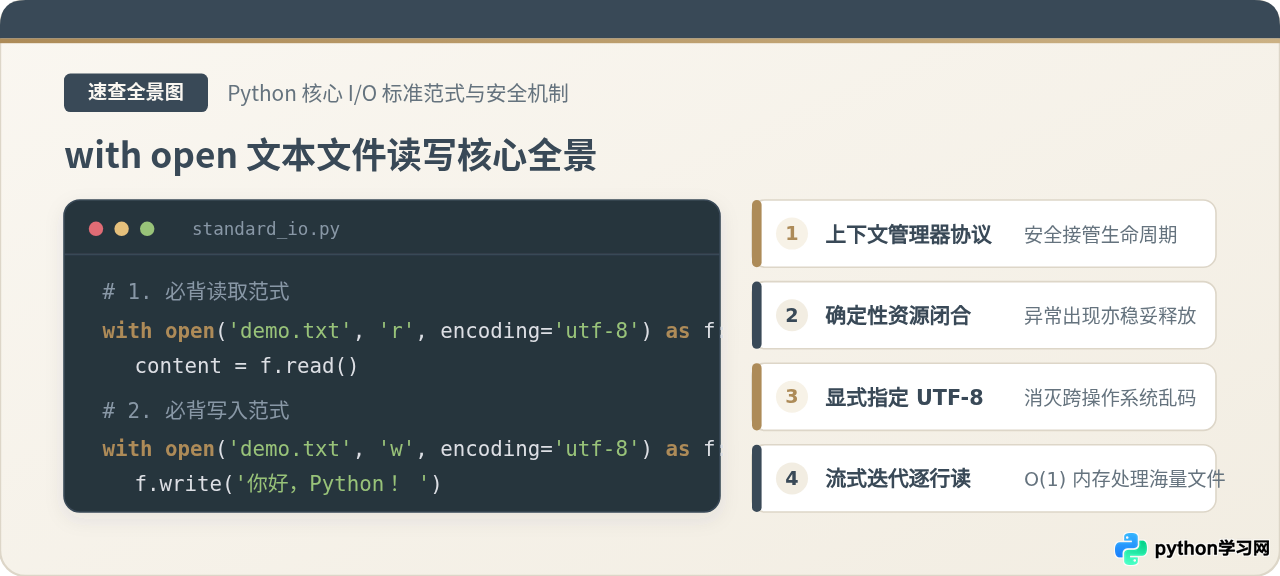
学习 Python 文件操作无需记忆冗余的冷门函数,熟练掌握以下两套标准模板,即可覆盖日常开发中 95% 以上的文本读写任务。无论在 Windows、macOS 还是 Linux 系统下,均要求显式指定 encoding='utf-8'。
1. 文本文件安全读取代码(按行流式处理)
# -*- coding: utf-8 -*-
# 必背模板 1:大文件低内存流式读取
file_path = 'data.txt'

with open(file_path, mode='r', encoding='utf-8') as f:
    for line in f:
        clean_line = line.strip()  # 去除行末换行符及两端空白
        if clean_line:
            print(clean_line)      # 执行具体的业务处理
2. 文本文件安全写入与追加代码
# 必背模板 2:覆盖写入('w')与增量追加('a')
out_path = 'output.txt'

# 模式 'w':若文件不存在则创建;若文件存在则直接清空重新写入
with open(out_path, mode='w', encoding='utf-8') as f:
    f.write('第一行:系统初始化记录
')
    f.writelines([
        '第二行:配置加载完成
',
        '第三行:任务准备就绪
'
    ])

# 模式 'a':若文件不存在则创建;若文件存在则在末尾继续追加
with open(out_path, mode='a', encoding='utf-8') as f:
    f.write('追加行:执行心跳检查成功
')
二、with open 语法解构与四步执行流程
为了透彻理解这段代码,必须看清 with open(...) as f: 内部的每个参数分工以及 Python 解释器在幕后完成的步骤转折。
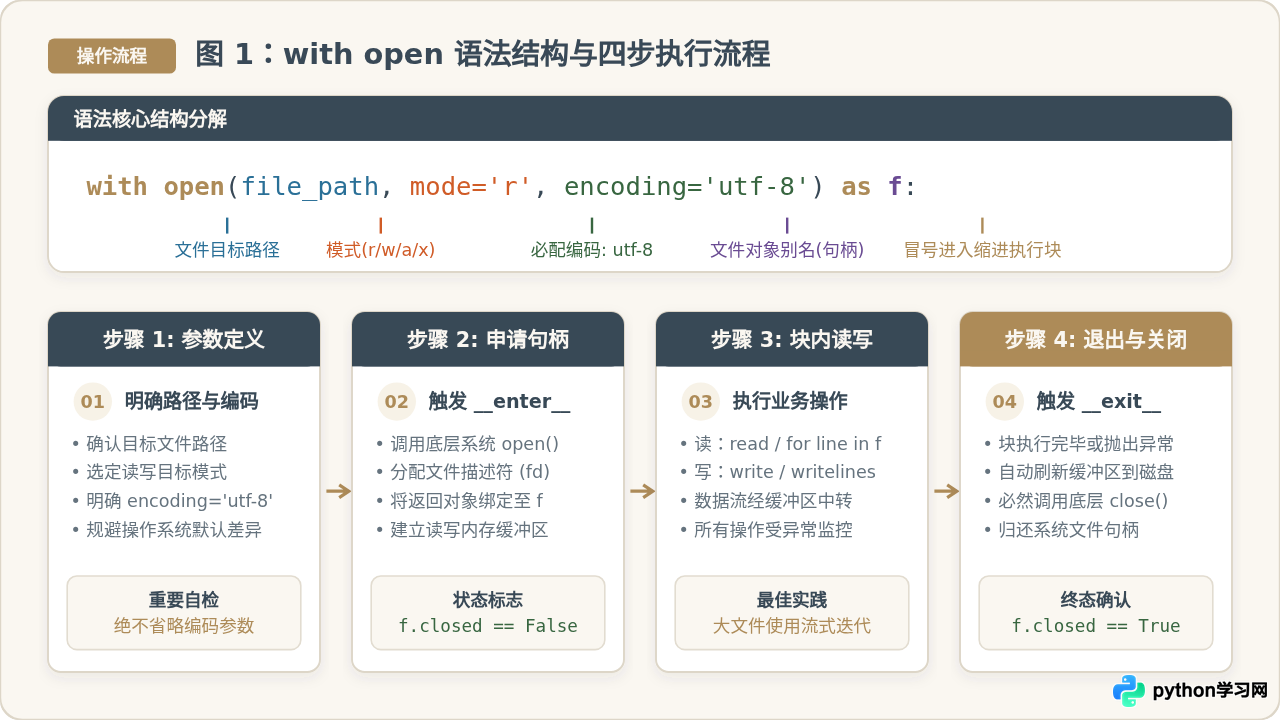
完整的语句结构由五个要素紧密构成:
- 目标路径 (
file_path):目标文本的绝对路径或相对于执行命令工作目录的相对路径。 - 访问模式 (
mode):指定当前操作是读取 ('r')、覆写 ('w') 还是追加 ('a')。 - 字符编码 (
encoding='utf-8'):告诉底层编解码器使用何种规则将二进制字节转为 Python 文本字符串。 - 别名句柄 (
as f):将open()返回的文本流对象 (TextIOWrapper) 赋给变量f,供后续语句调用。 - 缩进上下文块 (
:引导):冒号之后所有保持同一缩进等级的代码,均处于上下文管理器保护周期内部。
三、上下文管理器底层原理:为什么必须使用 with?
初学 Python 时,常见的做法是写成 f = open(...) 并在末尾手动写 f.close()。这种写法虽然看似直观,但在真实生产代码中存在致命的安全漏洞。
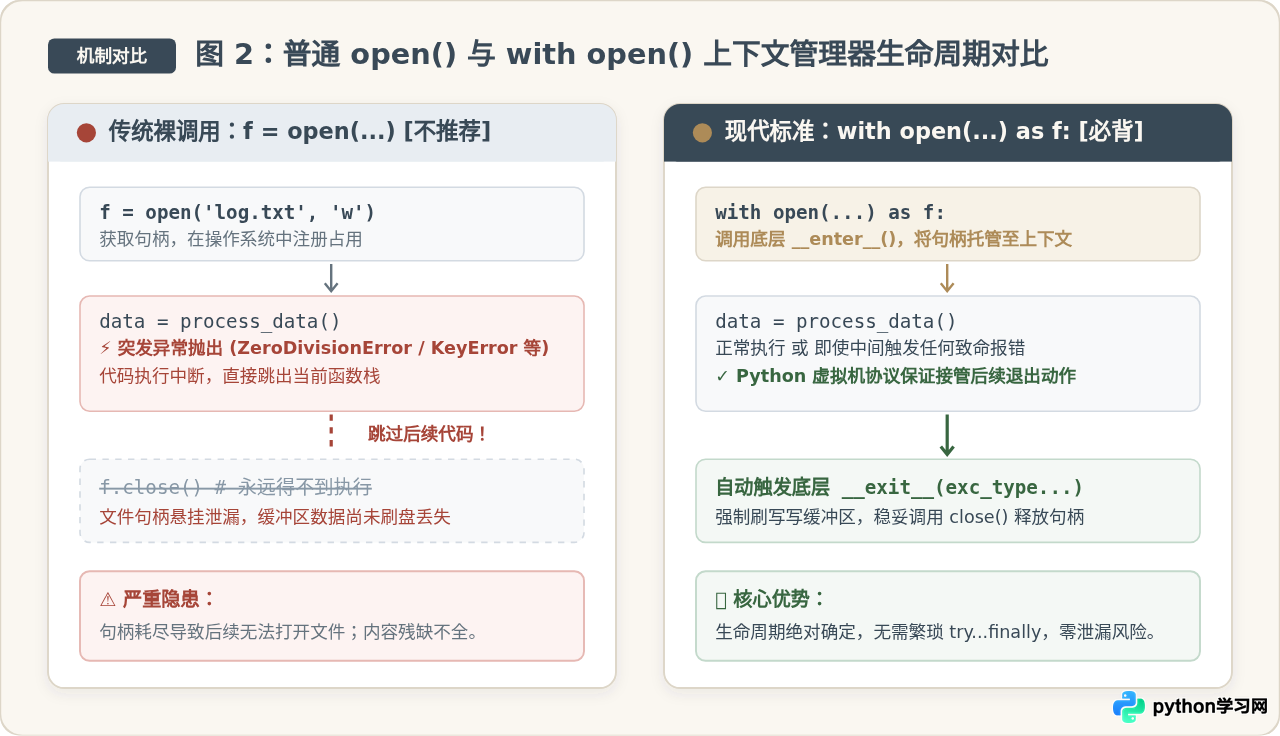
操作系统对单个进程能够同时开启的文件描述符数量(File Descriptor)存在上限限制(在典型 Linux 系统上默认通常为 1024)。如果使用裸 f = open(),当两行代码之间由于网络超时、除零错误或字段缺失抛出未捕获的异常时,执行栈会直接脱离当前代码块,导致后续的 f.close() 永远没有机会执行。
with 语句通过 Python 语言级的上下文管理器协议(Context Manager Protocol)解决了这一问题。其底层逻辑可以精准映射为如下机制:
- 进入
with块时,Python 自动调用被打开对象的__enter__()方法,并将返回值绑定到as后的变量f; - 离开
with块时——无论是代码自然执行到末尾、遇到了return语句、还是发生未预料的崩溃异常——Python 虚拟机保证调用其__exit__(exc_type, exc_val, exc_tb)方法; - 在
__exit__()内部,运行时会强制将内存缓冲区中尚未落盘的字符刷写(flush)至物理存储,随后调用操作系统的close()归还句柄。这使得资源管理具备严格的确定性。
四、核心打开模式与读写方法辨析
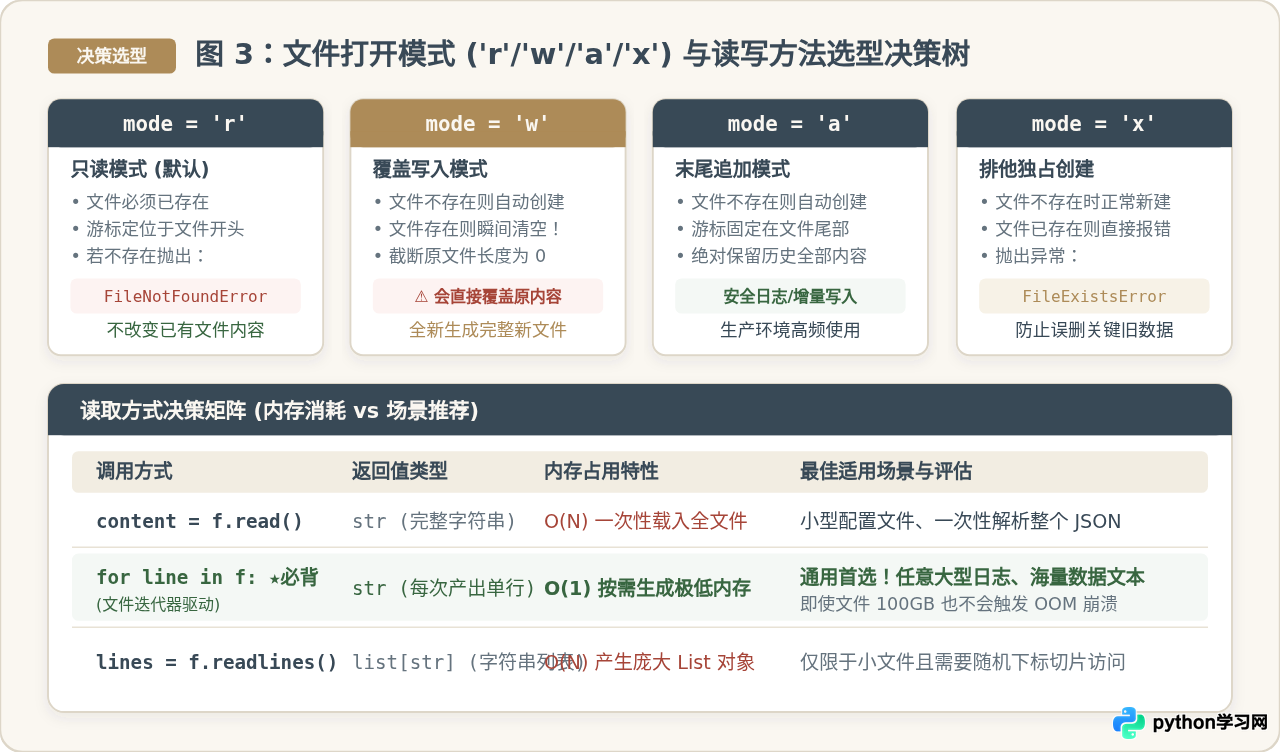
在调用 with open 时,模式参数 mode 与读取函数的搭配,直接决定了程序行为与服务器内存健康。
1. 四大核心文本模式对照
| 模式字符串 | 操作含义 | 文件已存在时的行为 | 文件不存在时的行为 |
|---|---|---|---|
'r' |
只读 (Read) | 正常打开,指针停在文件头部 | 立即抛出 FileNotFoundError |
'w' |
覆盖写入 (Write) | 瞬间截断文件为 0 字节,旧内容全部丢失 | 自动新建空文件并写入 |
'a' |
末尾追加 (Append) | 保留旧数据,指针定位于文件最末端 | 自动新建空文件并写入 |
'x' |
独占新建 (Exclusive) | 立即抛出 FileExistsError,防止覆盖 |
新建空文件并写入 |
2. 读取方法性能对比与选型原则
文本对象的读取接口有三种主要形式:f.read()、f.readlines() 和 for line in f:。
f.read():把整个文件全部读入内存拼成一个庞大的 Python 字符串。仅适合大小在几 KB 到数 MB 以内的小文件(如config.json)。如果对一个 10GB 的日志文件调用f.read(),进程会瞬间耗尽机器可用 RAM 并触发操作系统的 OOM Killer 强行终止程序。f.readlines():一次性读取全部行并封装为一个列表list[str]。同样需要一次性消耗等量级甚至更多的内存,通常不建议处理未知体量的生产文件。for line in f:(强烈推荐):Python 的文件句柄本身就是一个原生的迭代器(Iterator)。在底层,解释器利用小容量固定缓冲区按需分批载入数据,单次循环产出单行字符串。无论文件是 10MB 还是 200GB,其常驻内存占用(RSS)始终稳定在极低水位(空间复杂度 $O(1)$)。
五、实战进阶:多文件同时打开与管道清洗
在数据处理任务中,经常需要“一边读取源文件、一边清洗转换并写入目标文件”。with 语句原生支持同时管理多个上下文对象,代码简洁优雅,无需层层嵌套:
# 边读边写的双文件管道转换(无需多层嵌套)
src_file = 'raw_users.txt'
dst_file = 'clean_users.txt'

with open(src_file, 'r', encoding='utf-8') as f_in,      open(dst_file, 'w', encoding='utf-8') as f_out:

    for line in f_in:
        item = line.strip()
        # 过滤无效空行与系统注释行
        if item and not item.startswith('#'):
            formatted_data = item.upper() + '
'
            f_out.write(formatted_data)
在上述代码中,f_in 与 f_out 在退出 with 作用域时都会被依次确保关闭。如果写入目标磁盘中途发生空间满等 I/O 报错,f_in 句柄也会被立即闭合,不会发生资源遗留。
六、总结与 4 大高频踩坑避错清单
在掌握了标准语法后,可以通过以下避坑清单自查代码,确保文本处理逻辑在跨平台环境下万无一失。
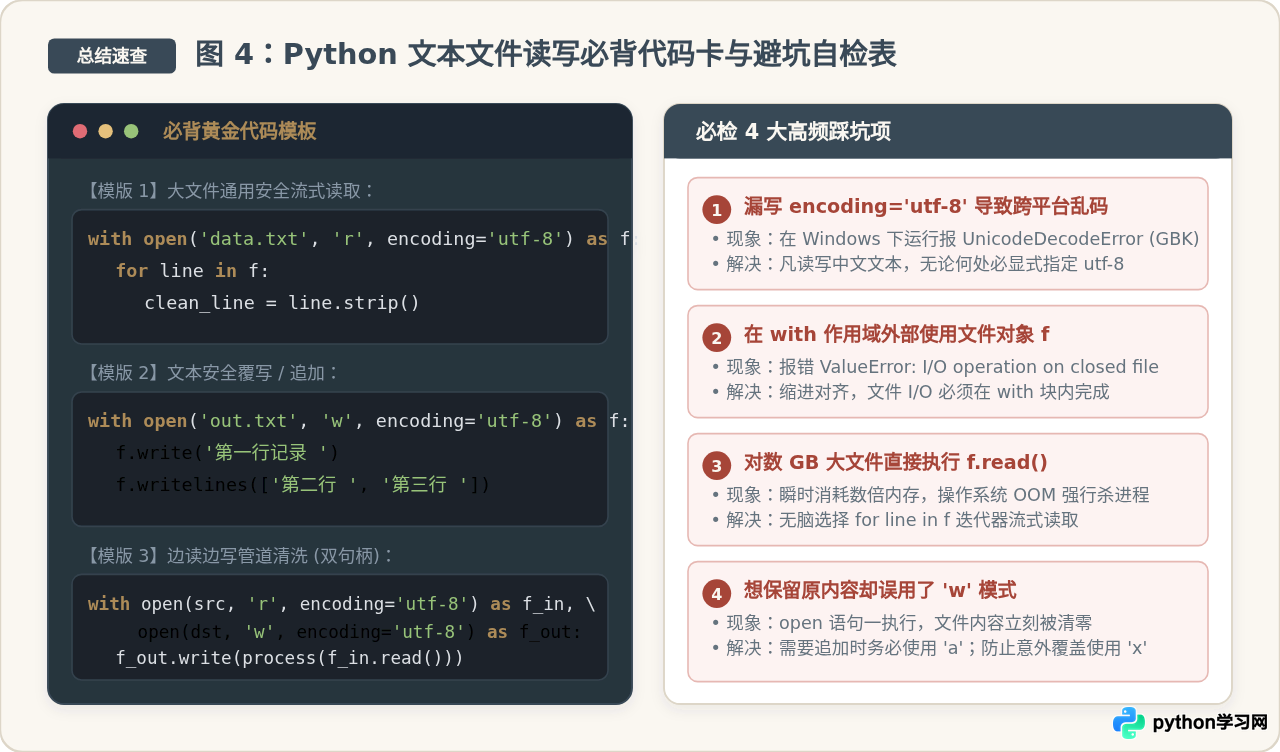
在 Linux 与 macOS 上,系统的默认编码通常是 UTF-8,因此即便漏写 encoding,开发测试往往能够通过。但一旦部署至中文版 Windows 环境,open() 默认采用操作系统本地代码页(如 cp936 / GBK)。当文本中包含特殊字符、Emoji 或中文 UTF-8 多字节序列时,程序会立即崩溃并抛出 UnicodeDecodeError: 'gbk' codec can't decode byte...。因此,将 encoding='utf-8' 刻入肌肉记忆是编写健壮 Python 代码的基本规范。
文件变量 f 在离开 with 缩进块后依然存在于局部命名空间中,但其内部属性 f.closed 已经变为 True。如果此时尝试执行 f.read() 或 f.write(),Python 会明确抛出 ValueError: I/O operation on closed file。所有针对文件内容的读取与写入操作,必须严格保持在 with 的缩进作用域内部完成。
读写文本文件看似基础,却是程序稳定性的第一道护城河。牢记 with open(...) as f: 的语法骨架、坚持使用 for line in f: 迭代处理大文件、时刻显式指定 encoding='utf-8',就能彻底规避绝大多数文件读写中的疑难杂症。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









