

Python列表求和:sum()函数基本用法与start参数详解
深入解析Python内置sum()函数的使用方法,包括列表求和、start参数详解、二维列表展平原理、字符串拼接避坑及浮点数精度处理。
在 Python 编程中,对数值列表或可迭代对象进行累加是最常见的数据聚合操作之一。Python 提供了内置函数 sum(),能够以清晰高效的语法完成这项工作。除了直接传入列表的基础用法,sum() 还包含一个关键的 start 参数,既可用于设置累加基数,也直接决定了累加的起点。本文将系统剖析 sum() 函数的内部执行逻辑、start 参数的运作细节,并说明实际开发中容易混淆的边界与替代方案。
一、sum() 函数的基本用法与运算规则
Python 的 sum() 是一个全局内置函数,其官方签名定义如下:
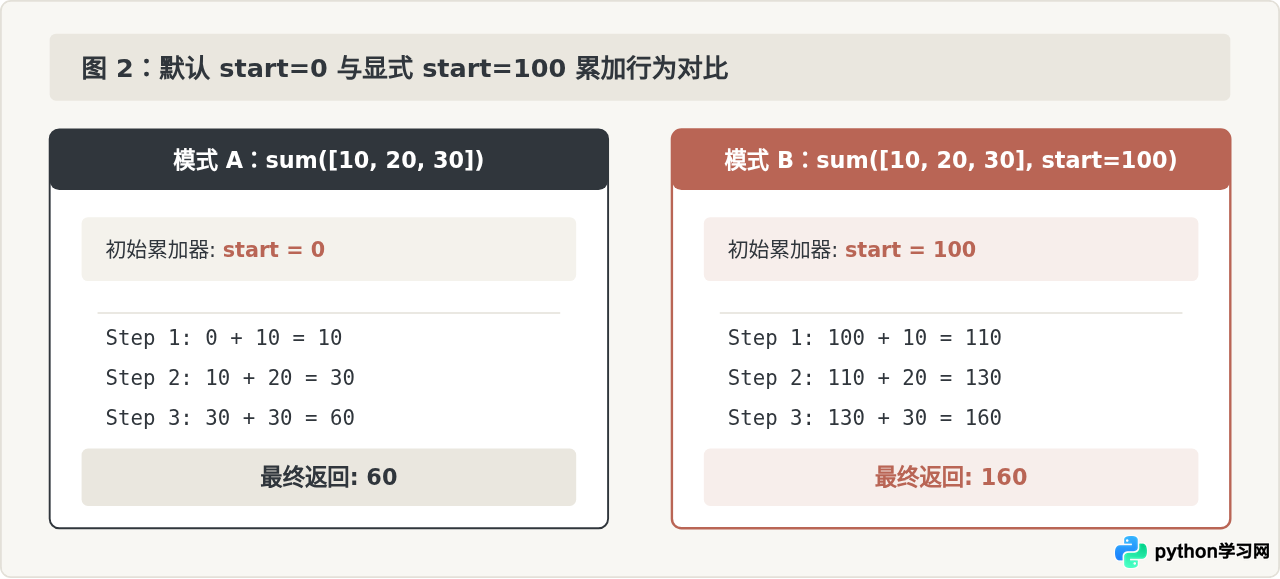
sum(iterable, /, start=0)该签名的核心含义是:第一个参数接收一个可迭代对象(如 list、tuple、set 或生成器),斜杠 / 表示 iterable 必须通过位置参数传递;第二个参数 start 是累加的初始值,默认为整型数值 0。
1. 整数与浮点数列表求和
处理整型和浮点型数值列表时,直接将列表作为参数传入即可:
# 示例:整数列表求和
numbers = [1, 2, 3, 4, 5]
total = sum(numbers)
print("整数求和结果:", total)
# 示例输出:整数求和结果: 15

# 示例:浮点数与负数混合求和
scores = [92.5, 88.0, 76.5, -5.0]
net_score = sum(scores)
print("综合得分:", net_score)
# 示例输出:综合得分: 252.0
2. 空列表与特殊边界
当传入的列表为空时,sum() 不会抛出异常,而是直接返回 start 参数的值(默认即为 0):
empty_list = []
print("空列表求和:", sum(empty_list))
# 示例输出:空列表求和: 0
这种机制保证了在列表长度动态变化时代码的鲁棒性,无需在求和前额外判断列表是否为空。
二、深入解析 start 参数
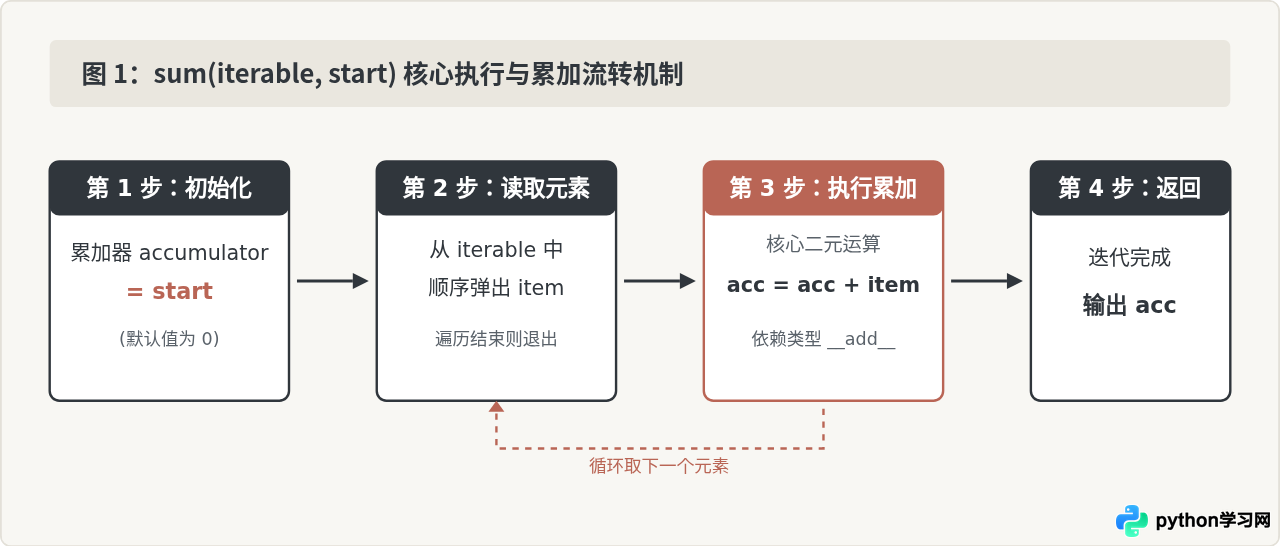
start 是 sum() 中最容易被忽略但功能极强的参数。从执行机制来看,sum() 并非先计算 iterable 内部元素之和再加 start,而是在迭代一开始就将累加器初始化为 start 的值,随后逐个与元素执行 + 操作。
1. 传参形式:位置参数与关键字参数
在 Python 3.8 引入位置参数语法(Positional-only parameters)后,iterable 只能以位置方式传入,而 start 既可以作为第二个位置参数,也可以作为显式关键字参数:
items = [10, 20, 30]

# 形式 1:作为位置参数传入
res1 = sum(items, 100)
print("位置参数结果:", res1)
# 示例输出:位置参数结果: 160

# 形式 2:作为关键字参数传入(Python 3.8+ 推荐,语义更清晰)
res2 = sum(items, start=100)
print("关键字参数结果:", res2)
# 示例输出:关键字参数结果: 160
2. 典型场景:带有基数的业务累计
在日常开发中,很多计算并非从零起算。例如根据基础余额计算账单期末结余、根据基准分统计加扣分项等,使用 start 参数能够在一行代码内保持语义连贯:
# 场景:账户原有底金 500 元,计算一整天的收支变动
initial_balance = 500
transactions = [-50, 200, -35, 120]

final_balance = sum(transactions, start=initial_balance)
print("期末账户总额:", final_balance)
# 示例输出:期末账户总额: 735如果列表为空,sum([], start=500) 将准确返回初始值 500,完全符合业务逻辑。
三、进阶应用:非数值累加与二维列表展平
由于 sum() 底层使用的是 + 操作符,只要列表元素与 start 支持加法,理论上就能执行。这也带来了一种常见的特殊用法:将 start 设为空列表 [] 来实现二维列表的一维展平。
1. 使用 sum(nested_list, []) 展平列表
默认情况下,如果直接对二维列表调用 sum([[1, 2], [3, 4]]),解释器会尝试计算 0 + [1, 2],由于整型与列表无法相加,会抛出 TypeError。若将 start 显式指定为 [],运算过程就变成了 [] + [1, 2] + [3, 4]:
nested = [[1, 2], [3, 4], [5]]
flattened = sum(nested, [])
print("展平后的列表:", flattened)
# 示例输出:展平后的列表: [1, 2, 3, 4, 5]sum(nested, []) 写法非常短小,但其时间复杂度为 O(N²)。每次相加都会重新分配内存并复制前一次合并后的全部元素。处理长列表或子列表极多的场景时,会造成严重性能衰减。对于生产级代码,推荐使用标准库 itertools.chain.from_iterable(),其具有 O(N) 的线性时间复杂度与流式处理能力。
2. 条件过滤与生成器表达式求和
sum() 的第一个参数只要是可迭代对象即可,因此它与生成器表达式(Generator Expression)配合极其契合。这种方式不仅内存开销极低(无需预先分配中间列表),而且代码具备极佳的可读性:
# 示例 1:只对偶数求和
data = [1, 2, 3, 4, 5, 6, 7, 8, 9, 10]
even_sum = sum(x for x in data if x % 2 == 0)
print("偶数之和:", even_sum)
# 示例输出:偶数之和: 30

# 示例 2:提取字典列表中的特定字段求和
orders = [
    {"product": "键盘", "price": 299},
    {"product": "鼠标", "price": 129},
    {"product": "显示器", "price": 1499}
]
total_amount = sum(item["price"] for item in orders)
print("订单总额:", total_amount)
# 示例输出:订单总额: 1927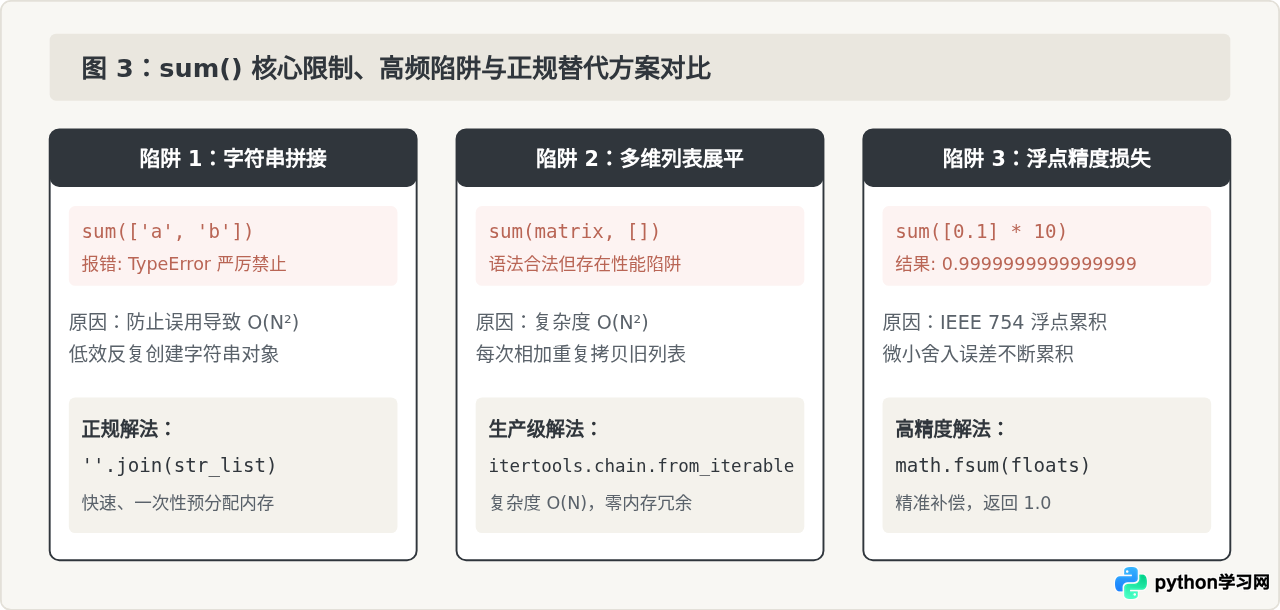
四、注意事项与避坑指南
为了保证代码的正确性与执行效率,在使用 sum() 时应牢记以下三项边界规则:
1. 为什么 sum() 严厉禁止拼接字符串?
很多初学者尝试通过 sum(["hello", " ", "world"], "") 来拼接字符串,但 Python 解释器会直接抛出明确的异常:
TypeError: sum() can't sum strings [use ''.join(seq) instead]这是 Python 语言设计层面的刻意限制。由于字符串在 Python 中是不可变对象(Immutable),若通过反复执行 + 进行累加拼接,每一次合并都会在内存中创建新的字符串对象并拷贝全部已有字符,导致整个拼接操作退化为平方级 O(N²) 耗时。Python 强制要求使用 str.join(),该方法在执行前会预先计算最终长度并一次性分配内存,性能可提升数十倍至数百倍。
2. 浮点数累加与 math.fsum()
对于大部分常规计算,sum() 已经足够可靠。但在金融计算、物理仿真或大量小数统计中,标准浮点数的累加可能会受到二进制舍入误差的影响:
# 标准 sum() 的浮点累加误差
values = [0.1] * 10
print("sum() 结果:", sum(values))
# 示例输出:sum() 结果: 0.9999999999999999

# 使用标准库 math.fsum() 进行全精度跟踪
import math
print("math.fsum() 结果:", math.fsum(values))
# 示例输出:math.fsum() 结果: 1.0
math.fsum() 在内部使用多个中间浮点数记录进位和舍入位,有效避免了精度漂移。
3. 大规模数据的内存考量
如果待求和的数据量达到数百万级别,切忌使用列表推导式构造庞大的内存列表后再传入 sum(),应始终使用生成器表达式:
# 不推荐:先创建包含千万级整数的真实列表,耗费数百MB内存
sum([x * 2 for x in range(10000000)])

# 推荐:流式迭代生成,内存占用接近常数 O(1)
sum(x * 2 for x in range(10000000))
五、总结与技术选型速查
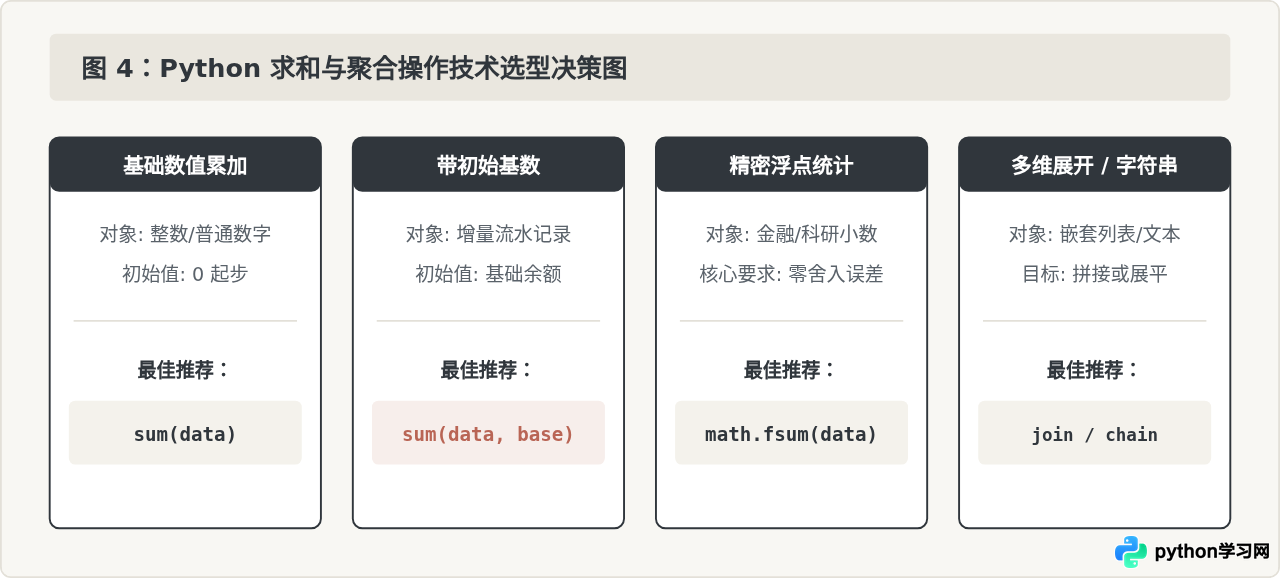
sum() 作为 Python 最经典的内置函数之一,在保持简洁语法的同时蕴含了灵活的设计。通过合理使用 start 参数,可以优雅处理各类带有基础底数或非零初始状态的聚合需求。在面对更复杂的业务时,应根据数据类型与规模选择合适的工具:
| 需求场景 | 首选方案 | 核心优势 / 为什么不选用 sum() |
|---|---|---|
| 常规整数/混合数值求和 | sum(iterable) |
内置 C 实现,简洁快速,开箱即用 |
| 带初始偏移量/基础账额 | sum(iterable, start=base) |
语义清晰,支持空列表容错返回 base |
| 高精度科学/金融浮点计算 | math.fsum(iterable) |
彻底消除二进制浮点舍入误差 |
| 文本/字符串列表拼接 | ''.join(strings) |
线性复杂度 O(N),sum() 原生强制禁止拼接字符串 |
| 二维列表扁平化展开 | itertools.chain.from_iterable() |
线性 O(N) 性能,避免 sum(lst, []) 的 O(N²) 内存拷贝瓶颈 |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









