

Python嵌套for循环处理多维数据的方法
深入讲解在Python中使用嵌套for循环遍历与处理二维及多维列表的核心方法,涵盖行列遍历逻辑、坐标索引定位、三维张量展开、数据过滤与展平技巧,并提供完整代码示例与结构推导图解。
在 Python 原生数据结构中,多维数据通常是以“列表中包含子列表”的形式存在的,例如矩阵(二维列表)或立体张量(三维列表)。要访问、检索或处理这些多层容器中的具体标量值,最直观且通用的方法就是使用嵌套 for 循环:外层循环逐项取出高维层级(如矩阵的一行),内层循环则下沉到具体层级内部逐个提取最终元素。本文将系统梳理二维与三维数据的行列循环逻辑、索引定位模式、原位修改与数据展平技巧,帮助你建立清晰的多维数据遍历直觉。
一、二维数据的基本结构与外内循环时序
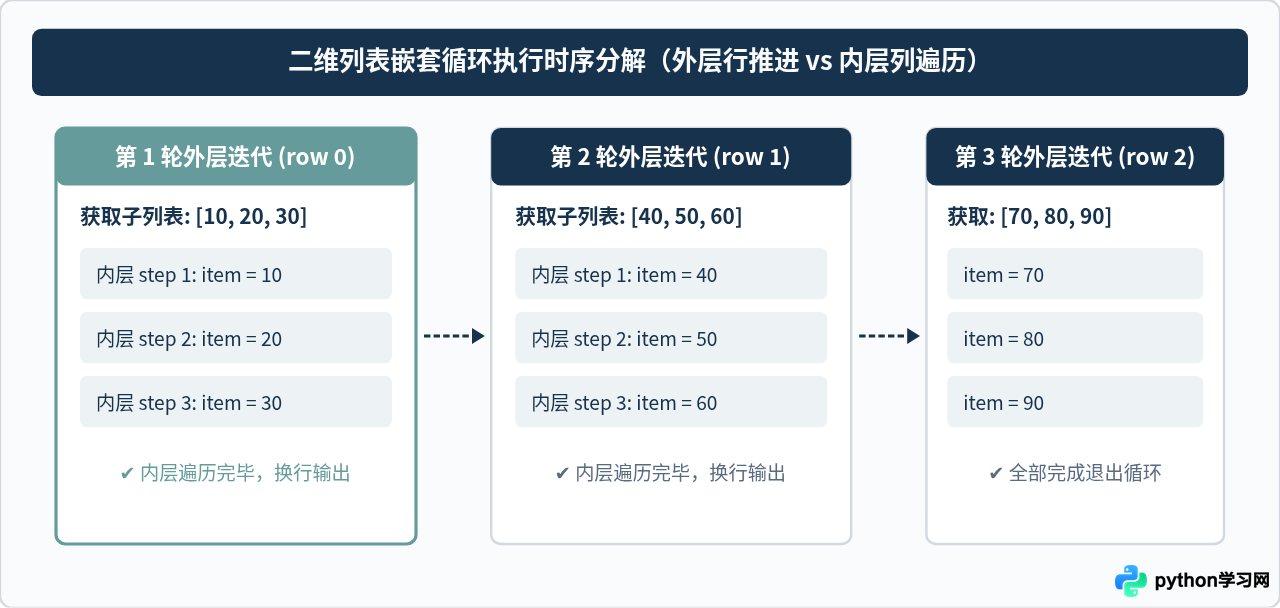
处理多维数据前,首先需要理解维度的解包顺序。以常见的 3×3 二维表格数据为例,最外层的列表包含了三个元素,每个元素本身又是一个具有三个数字的列表。当我们写下双层嵌套循环时,程序的实际执行顺序是:外层迭代一步,内层必须从头到尾完整执行一整轮,然后外层才会迈向下一项。
# 定义一个基础的 3x3 二维矩阵
matrix = [
    [10, 20, 30],
    [40, 50, 60],
    [70, 80, 90]
]

# 基础嵌套循环遍历每一个元素
for row in matrix:
    for item in row:
        print(item, end=" ")
    print()  # 每遍历完一行换行
示例输出:
10 20 30
40 50 60
70 80 90
为了让这一步进过程更易理解,下方流程图详细呈现了双层循环在时间轴上的执行步骤与变量状态流转:
二、通过索引精确定位:获取行列坐标
如果业务需求不仅需要读取数值,还需要记录该数值所在的行、列坐标,或者需要在遍历时关联相邻网格,直接遍历对象就不够用了。此时有两种常见做法:
- 使用
enumerate():在保留元素访问的同时优雅解包下标,是 Python 最推荐的标准写法。 - 使用
range(len(...)):纯数字下标模式,适合需要基于下标进行数学偏移计算(例如图像卷积邻域、网格寻路)的场景。
grid = [
    ["A", "B", "C"],
    ["D", "E", "F"],
    ["G", "H", "I"]
]

# 推荐写法:使用 enumerate 同时获取坐标与元素
for r_idx, row in enumerate(grid):
    for c_idx, val in enumerate(row):
print(f"坐标 ({r_idx}, {c_idx}) = {val}")Python 嵌套列表在内存中是按行连续存储引用的(行优先)。上述两层循环外层是行、内层是列。如果你需要“按列垂直读取”数据,外层循环应控制列下标,内层循环控制行下标:
for c in range(col_count): for r in range(row_count): print(grid[r][c])。注意列优先会导致频繁跳跃访问不同的子列表,在大数据量下缓存命中率低于行优先。
三、就地修改数据与内存机制避坑
许多初学者在使用嵌套循环修改二维列表时,常犯一个错误:试图通过 for item in row: item = item * 2 来翻倍矩阵里的数字。运行后却发现原列表毫无变化。这是因为 Python 中的整数是不可变对象,循环变量 item 只是指向该整数的临时本地标签,对 item 重新赋值只会改变这个标签的引用目标,并不能更新原列表在内存槽位中的指向。
若要就地修改(In-place mutation)多维数据,必须使用具体的下标路径:matrix[r][c] = new_value。
scores = [
    [55, 78, 62],
    [89, 45, 91]
]

# 错误写法演示:原列表不会有任何改变
# for row in scores:
#     for val in row:
#         if val < 60:
#             val = 60  # 无效!仅修改了临时变量 val 的引用

# 正确写法:通过行、列下标精准更新内存槽位
for r in range(len(scores)):
    for c in range(len(scores[r])):
        if scores[r][c] < 60:
            scores[r][c] = 60  # 原地修改及格线

print("调整后的分数矩阵:", scores)
# 示例输出:调整后的分数矩阵: [[60, 78, 62], [89, 60, 91]]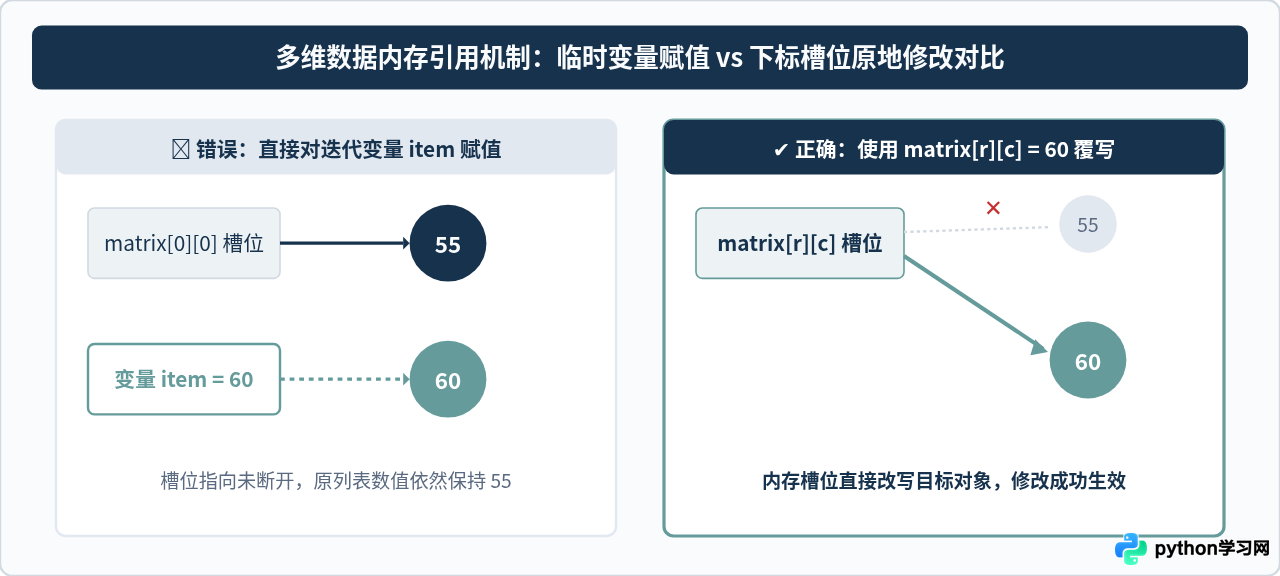
四、三维及更高维数据的处理模式
当维度增加到三维(例如多批次图像像素 RGB、三维空间体素、多周期多站点时序记录),数据的组织方式通常为:数据块(Blocks / Channels) → 行(Rows) → 列(Columns)。处理三维数据时,我们需要使用三重嵌套循环。
# 模拟一个 2x3x3 的三维数据(2个切片,每个切片3行3列)
volume_data = [
    # 切片 0
    [
        [1, 2, 3],
        [4, 5, 6],
        [7, 8, 9]
    ],
    # 切片 1
    [
        [10, 20, 30],
        [40, 50, 60],
        [70, 80, 90]
    ]
]

# 三重嵌套循环:逐层向下深潜
total_sum = 0
for slice_idx, slice_matrix in enumerate(volume_data):
    for r_idx, row in enumerate(slice_matrix):
        for c_idx, val in enumerate(row):
            total_sum += val
            # 仅打印大于 50 的异常强信号坐标
            if val > 50:
                print(f"切片 {slice_idx}, 行 {r_idx}, 列 {c_idx} 处检测到高值: {val}")

print(f"三维矩阵全元素总和为: {total_sum}")
示例输出:
切片 1, 行 1, 列 2 处检测到高值: 60
切片 1, 行 2, 列 0 处检测到高值: 70
切片 1, 行 2, 列 1 处检测到高值: 80
切片 1, 行 2, 列 2 处检测到高值: 90
三维矩阵全元素总和为: 495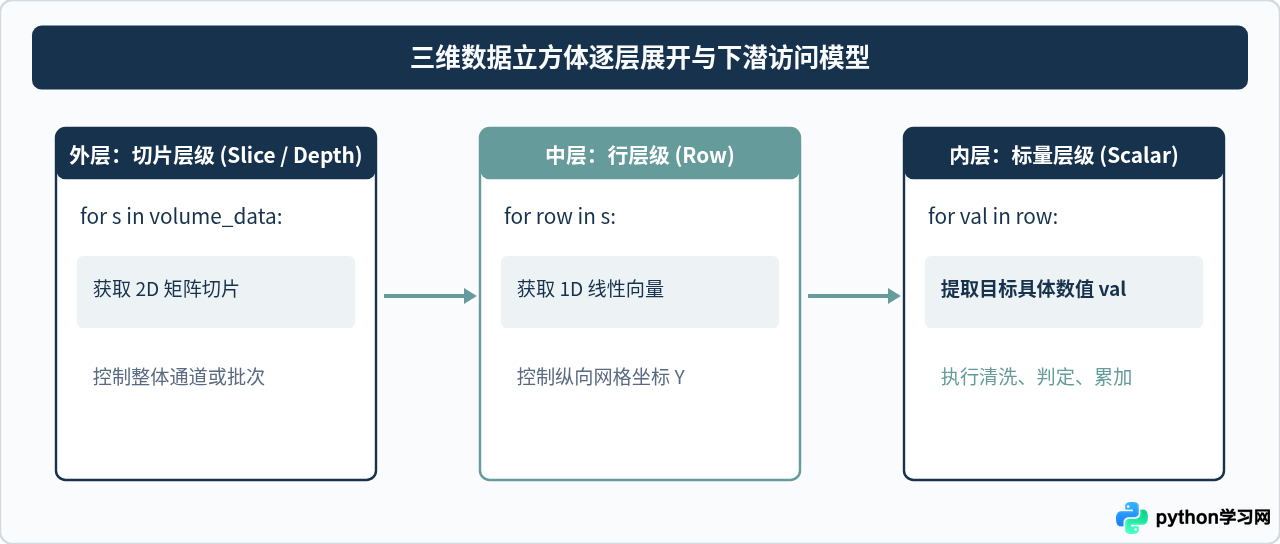
五、常见任务:数据过滤、展平与提取
掌握了基本遍历后,实际开发中最常见的两项任务是二维数组扁平化(Flatten)与条件筛选聚合。
1. 二维数组展平为一维列表
常规做法是在外层创建空列表,内层依次 append。同时,Python 提供了等价的双重列表推导式(List Comprehension),能够在一行内完成相同操作。注意推导式中两个 for 的书写顺序与常规循环完全相同:外层循环写在前面,内层循环写在后面。
nested = [[1, 2, 3], [4, 5], [6, 7, 8, 9]]

# 方式一:标准嵌套循环
flat_list_1 = []
for sublist in nested:
    for item in sublist:
        flat_list_1.append(item)

# 方式二:双重列表推导式(等价逻辑,表达更精简)
flat_list_2 = [item for sublist in nested for item in sublist]

print("展平结果:", flat_list_2)
# 示例输出:展平结果: [1, 2, 3, 4, 5, 6, 7, 8, 9]
2. 带条件的过滤提取
当需要从多维矩阵中筛选出符合业务条件的特殊元素(例如提取所有偶数)时,只需在内层循环中挂载 if 分支判断:
matrix_data = [
    [12, 17, 24],
    [33, 40, 51],
    [68, 79, 82]
]

# 提取所有偶数并记录
even_numbers = []
for row in matrix_data:
    for num in row:
        if num % 2 == 0:
            even_numbers.append(num)

print("矩阵中的偶数集:", even_numbers)
# 示例输出:矩阵中的偶数集: [12, 24, 40, 68, 82]
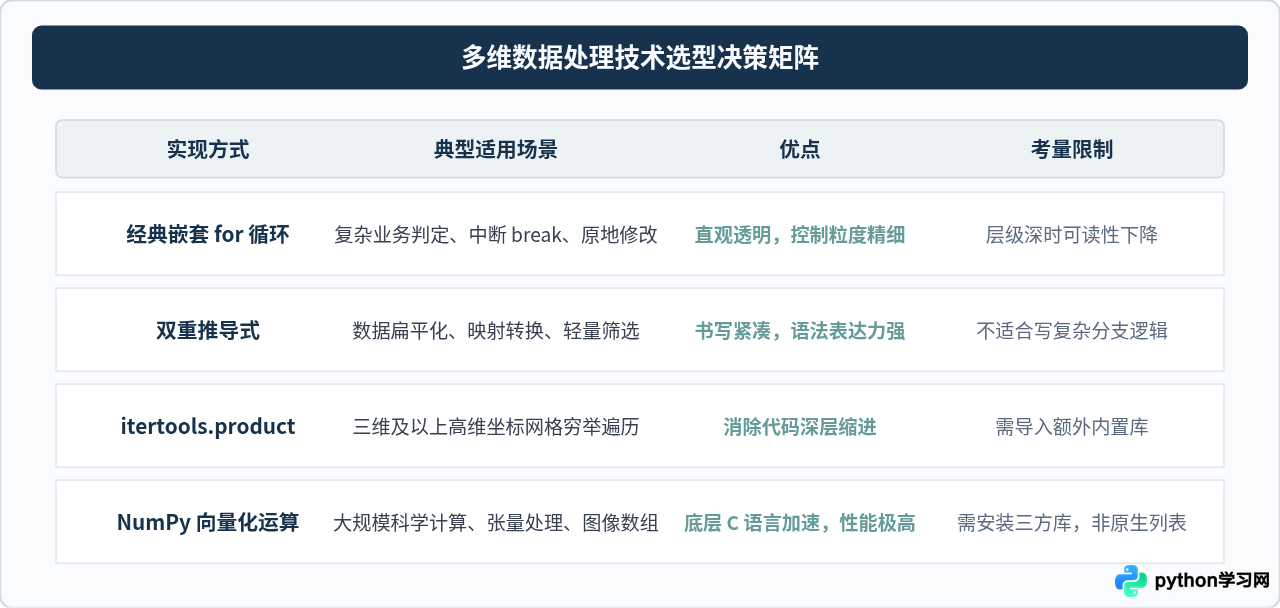
六、方案选型与性能权衡
虽然嵌套 for 循环简单易懂,但在面对更深维度或更大体量的数据时,代码的可维护性与运行效率需要被认真考量:
- 代码层级过深:当嵌套达到 3 层以上时,代码的缩进和认知负担急剧增加。此时可以使用标准库的
itertools.product()将多层循环扁平化为单一循环,接收笛卡尔积元组。 - 大规模数值运算性能:Python 原生列表存储的是指针引用,嵌套循环在解释器层面有较大的字节码调度开销。对于成千上万阶的矩阵运算,应果断迁移至
NumPy,利用其 C 底层的矢量化广播机制提升数十倍效率。
七、总结
在 Python 中使用嵌套 for 循环处理多维数据,本质是**维度的逐层解构过程**。外层循环负责推进宏观层级(如切片或整行),内层循环负责在微观容器内落实具体元素的访问与操作。在实际应用中:
- 纯读取数据时,优先使用
for row in matrix: for item in row:,简洁明了; - 需要坐标或需要就地修改数据时,配合
enumerate()或range(len(...))通过matrix[r][c]下标进行更新; - 轻量展平与转换优先采用嵌套列表推导式;
- 对于深层坐标穷举可借力
itertools.product避免阶梯式代码,而在遇到百万级以上重型数值计算时应平滑过渡到专用科学计算工具。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









