

Python可变对象在函数传参时怎么用copy避免污染
详细讲解Python在函数传参时由于对象引用机制导致的可变对象污染问题,并通过浅拷贝(copy)与深拷贝(deepcopy)的方法提供完整的防污染解决方案及最佳实践。
append()、pop() 或键赋值),调用端传入的原对象数据也会被同步篡改,产生非预期的副作用。本文将直接说明对象污染产生的根本机制,并系统讲解如何通过标准库 copy 模块的浅拷贝与深拷贝进行引用隔离与防御性编程。
一、传参机制与原址修改:为什么外部数据会被污染
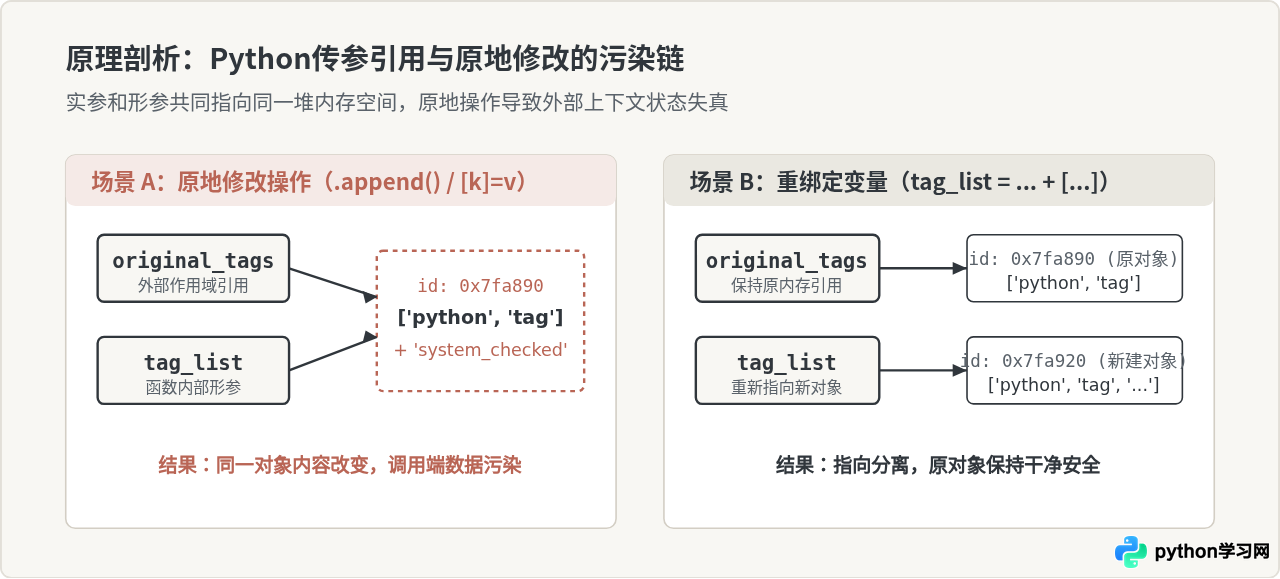
Python的参数传递机制常被称为“赋值传递”(Pass by assignment)或“对象引用传递”(Pass by object reference)。当调用一个函数并将变量作为实参传入时,形参和外部实参变量在初始时刻绑定到了同一块内存地址。
对于不可变对象(例如整数、浮点数、字符串、元组),任何对该变量的修改操作实际上都只能创建新对象并重新绑定引用,因此天然具备隔离性。但可变对象(如列表、字典、自定义类的实例)支持“原址修改”(In-place mutation)。若在函数内调用了修改内部结构的方法,形参并没有指向新地址,外部变量所观察到的对象状态便直接被修改了。
def add_default_tags(tag_list):
    # 原址修改操作:直接在原列表内存中追加元素
    tag_list.append("system_checked")
    return tag_list

original_tags = ["python", "backend"]
result = add_default_tags(original_tags)

print("返回值:", result)          # 输出: ['python', 'backend', 'system_checked']
print("原对象:", original_tags)   # 输出: ['python', 'backend', 'system_checked'](被污染)
在上面的示例中,original_tags 被函数内部的操作附带修改。在多人协作或大型工程中,这类隐式副作用往往会导致排查极其困难的逻辑缺陷。
二、浅拷贝与深拷贝:如何选择隔离深度
为了避免原地操作污染入参,必须在操作前对对象进行复制(Copy)。Python标准库提供了 copy 模块,主要包含两种拷贝机制:
- 浅拷贝(Shallow Copy,
copy.copy()或对象原生.copy()):构建一个新的顶层容器对象,但对于容器内部包含的子元素,浅拷贝仅复制子元素的引用地址。 - 深拷贝(Deep Copy,
copy.deepcopy()):构建一个新的顶层容器对象,并递归遍历其所有子元素,将子元素的所有层级全部复制一份全新的内存对象。
1. 浅拷贝适用场景与边界
当传入的对象只有单层结构(例如元素全为数字、字符串或不可变元组的一维列表)时,浅拷贝足以达到隔离目的。常见的浅拷贝实现方式包括:
- 调用
import copy; data_copy = copy.copy(data) - 列表或字典自带的方法:
new_list = old_list.copy()、new_dict = old_dict.copy() - 切片语法(针对序列):
new_list = old_list[:] - 类型构造器:
new_list = list(old_list)、new_dict = dict(old_dict)
import copy

def process_scores(scores):
    # 浅拷贝:创建单层隔离
    local_scores = copy.copy(scores)
    local_scores.append(100)
    return local_scores

base_scores = [85, 90, 78]
new_scores = process_scores(base_scores)

print("原列表:", base_scores)  # 输出: [85, 90, 78](未受污染)
print("新列表:", new_scores) # 输出: [85, 90, 78, 100][[1, 2], [3, 4]] 或嵌套字典),浅拷贝复制的新列表虽然有独立的顶层内存地址,但内部元素引用的仍然是同一个子列表。此时在函数内修改子列表(如 local_matrix[0].append(99)),依然会穿透并污染外部原数据。
2. 深拷贝的使用方式
对于存在嵌套结构、配置项字典、树形节点或复杂嵌套模型的数据,必须引入 copy.deepcopy() 才能彻底切断所有层级的共享引用:
import copy

def update_user_profile(user_dict):
    # 深拷贝:完全切断多层嵌套引用
    local_user = copy.deepcopy(user_dict)
    local_user["preferences"]["theme"] = "dark"
    local_user["roles"].append("auditor")
    return local_user

raw_profile = {
    "name": "Alex",
    "preferences": {"theme": "light"},
    "roles": ["developer"]
}

result_profile = update_user_profile(raw_profile)

# 验证外部原数据是否被隔离
print("原配置主题:", raw_profile["preferences"]["theme"])  # 仍为 light
print("原配置角色:", raw_profile["roles"])                # 仍为 ['developer']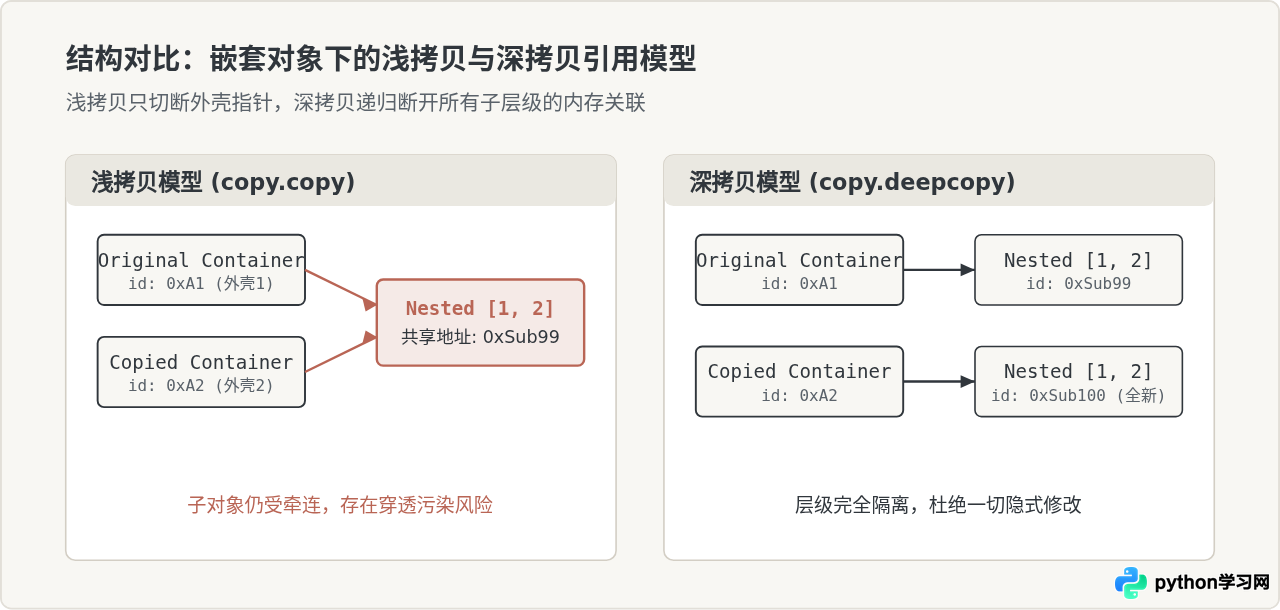
三、避免参数污染的操作流程与实现步骤
在实际编写业务逻辑或基础库时,避免参数污染应遵循一套明确的操作步骤,确保代码既具备安全性,又不会产生不必要的内存冗余。
步骤 1:分析入参类型与函数职责
首先明确函数的设计定位:
- 纯计算/查询型函数:只读取入参属性或进行遍历,严禁在函数内调用任何原地修改方法(如
.sort()、.extend()、键赋值等)。 - 转换/清洗型函数:需要对入参进行裁剪、过滤或追加字段,并输出处理后的新对象。这类函数必须在函数体第一行进行防御性复制。
步骤 2:在函数入口处实施防御性拷贝(Defensive Copying)
遵循“谁修改,谁复制”的契约原则。如果函数需要修改参数,应当由函数本身承担隔离责任,而不是寄希望于每个调用方都记得先做拷贝:
import copy

def sanitize_user_input(payload):
    # 步骤2:函数体入口立即创建独立作用域副本
    if not isinstance(payload, dict):
        raise TypeError("payload必须为字典类型")

    # 评估内部是否存在嵌套字典或列表
    data = copy.deepcopy(payload)

    # 后续操作全部基于副本 data 进行,绝不触碰原始形参 payload
    data.pop("password", None)
    data["sanitized_at"] = "2026-10-17"
    return data
步骤 3:防范经典变种——可变默认参数陷阱
除了常规传参,函数定义时的“默认参数”也是由函数对象在定义阶段一次性绑定的。如果默认值为可变对象,多次调用同一函数会共用同一个对象:
# 错误示例:默认参数污染
def collect_metrics(metric_name, container=[]):
    container.append(metric_name)
    return container

# 正确做法:使用 None 并在函数体内按需初始化
def collect_metrics_safe(metric_name, container=None):
    if container is None:
        container = []  # 每次调用都是新列表
    else:
        # 如果外部传入了已有容器,且需要修改,则进行安全拷贝
        container = list(container)

    container.append(metric_name)
    return container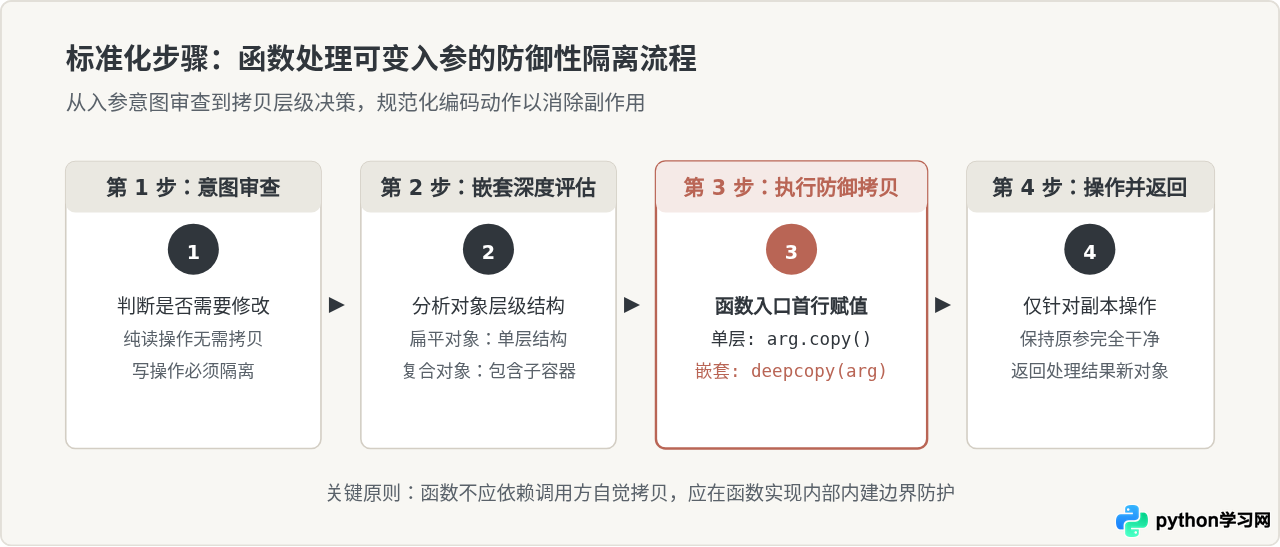
四、拷贝方式选型与性能权衡
虽然 copy.deepcopy() 可以一劳永逸地解决所有嵌套污染问题,但它的执行开销远高于原生操作和浅拷贝。深拷贝需要递归遍历对象属性,并使用字典维护备忘录(memo)以防止循环引用,这会带来显著的 CPU 和内存分配开销。在高性能计算或高频循环调用中无节制使用深拷贝,往往会成为程序的性能瓶颈。
| 方案 | 常用实现语法 | 是否支持嵌套隔离 | 性能开销 | 最佳适用场景 |
|---|---|---|---|---|
| 切片 / 原生拷贝 | data[:], dict.copy() |
否(仅顶层) | 极低(C层面内存块复制) | 一维基础数据列表、单层配置字典 |
| copy.copy() | copy.copy(obj) |
否(仅顶层) | 低(通用对象协议分发) | 通用自定义类的浅层复制、单层通用集合 |
| copy.deepcopy() | copy.deepcopy(obj) |
是(全层级递归) | 较高(递归及去重字典检索) | 多层嵌套字典、JSON配置树、复杂对象图 |
| 不可变数据替代 | tuple, MappingProxyType |
天然免疫污染 | 极低(无需复制) | 只读枚举配置、常量池、函数参数契约强化 |
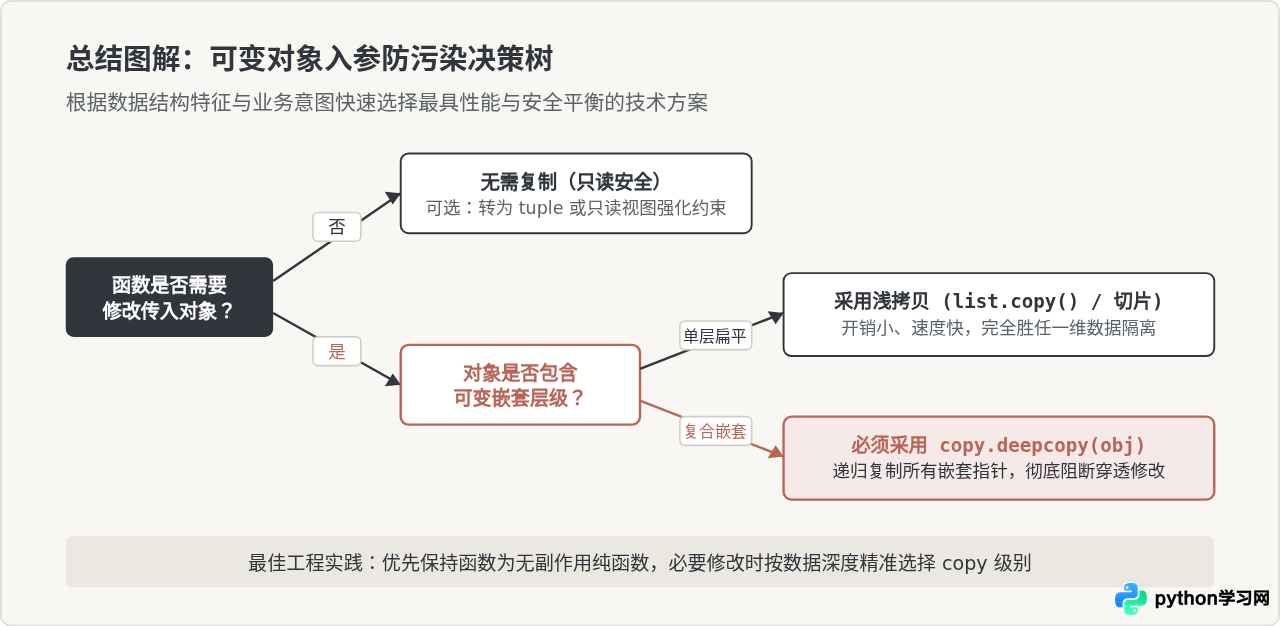
对于不需要修改参数的高频调用函数,更好的做法是从架构层面使用不可变类型约束(例如将传入列表改为元组 tuple,或通过 types.MappingProxyType 将字典包装为只读映射),在编译器或运行时抛出修改异常,从根源上杜绝污染可能。
五、结语
Python中可变对象由于共享内存引用而容易被函数内部的原址操作污染。解决这一问题的关键在于树立明确的防御性编程意识:在函数需要修改入参结构时,于函数体开头使用 copy.copy() 或原生方法对扁平数据建立浅拷贝;对于多层嵌套或字典树等复合对象,使用 copy.deepcopy() 进行全量递归复制。结合纯函数设计与对默认参数陷阱的防范,能够从根本上保障程序数据流的可预测性与稳定性。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









