

Python中配对样本t检验与独立样本t检验怎么选
深入对比Python中配对样本t检验与独立样本t检验的核心区别、数据结构要求、选型决策路径与SciPy代码实战,帮助数据分析人员精准选型避免检验偏差。
在日常数据分析和A/B测试复盘中,一个经常被忽视却又影响深远的细节是:面对两组数字,很多人不假思索地直接调用 scipy.stats.ttest_ind,结果发现 p 值为 0.18,便草率得出“策略无显著效果”的结论。然而,如果这批数据记录的是同一批用户改版前后的留存时长,换用处理成对数据的 scipy.stats.ttest_rel 后,p 值往往会直接收敛到 0.003。这种断崖式的差异并非统计学游戏,而是因为两种检验对于“方差来源”的归因机制存在根本分野。
一、数据结构与统计原理的本质差异
从数据形态上看,独立样本与配对样本表现出截然不同的排布特征。理解这两种检验的第一步,是看清它们的输入假定与待检验假设。
独立样本t检验(Independent Samples t-test)用于比较两个完全独立的群体均值。例如随机抽取的甲组与乙组用户、不同班级的考试成绩、或者网页端与移动端两个独立客群的转化率。此时,甲组中第 1 个样本与乙组中第 1 个样本没有任何内在绑定关系,两组的样本量甚至可以不相等($n_1 \neq n_2$)。其统计模型关注的是两组各自总体的均值差异 $(\mu_1 - \mu_2)$,分母中的标准误差综合了两组各自独立的组内方差。
配对样本t检验(Paired Samples t-test)则要求两组数据之间存在严密的一对一绑定。最典型的场景是“同一受试对象的重复测量”,例如同一批患者用药前与用药后的血压指标,或者同一批学生在培训前后的测验得分;另一种场景则是“匹配配对”,例如根据年龄、性别、病程严格 1:1 配对的两组受试者。此时两组数据的样本量必须严格相等($n_1 = n_2 = n$),且索引位置必须精准对应。
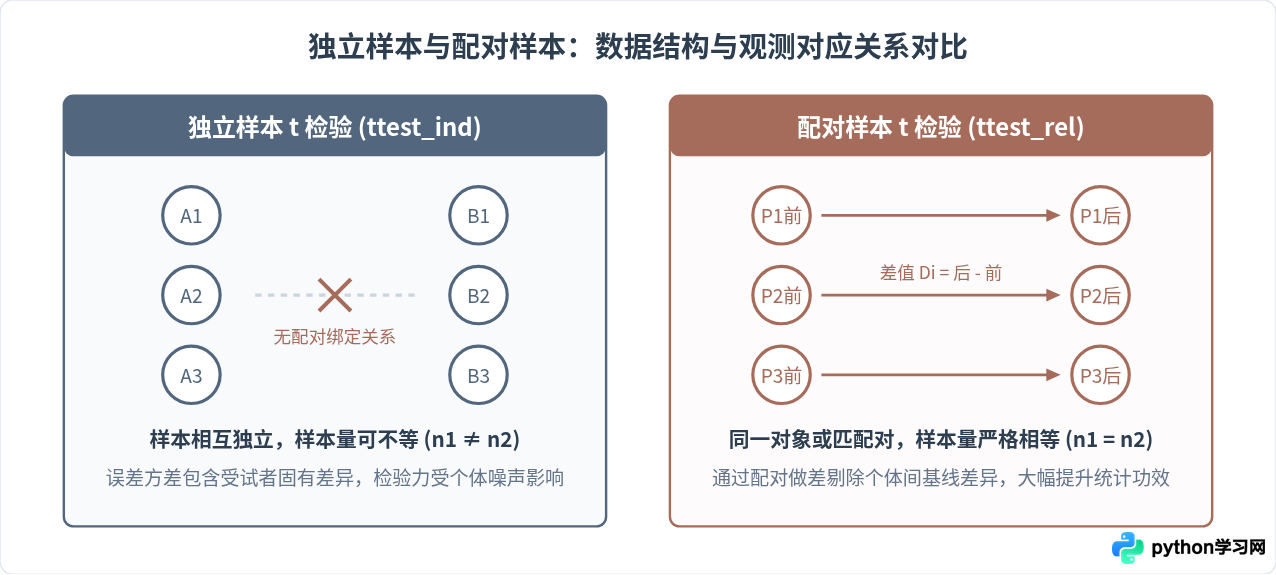
配对检验在数学本质上,其实是一个“单样本t检验”。它首先将每对数据逐项相减得到差值序列 $D_i = X_{1i} - X_{2i}$,随后检验该差值序列的总体均值 $\mu_D$ 是否与 0 存在显著偏离。因为每对数据都来自同一个体(或同质个体),受试者自身的基准高低(如某人体质天生偏胖、某些基线指标先天偏高)在相减过程中被彻底抵消。这就是配对检验能用更小的样本量检出微小处理效应的根本原因。
二、选型决策流程与前置统计假设
在 Python 中做 t 检验前,不能仅仅依靠“名字像”来选择 API。科学的选型路径需要依次厘清数据关联性、分布形态以及方差特征三个维度。
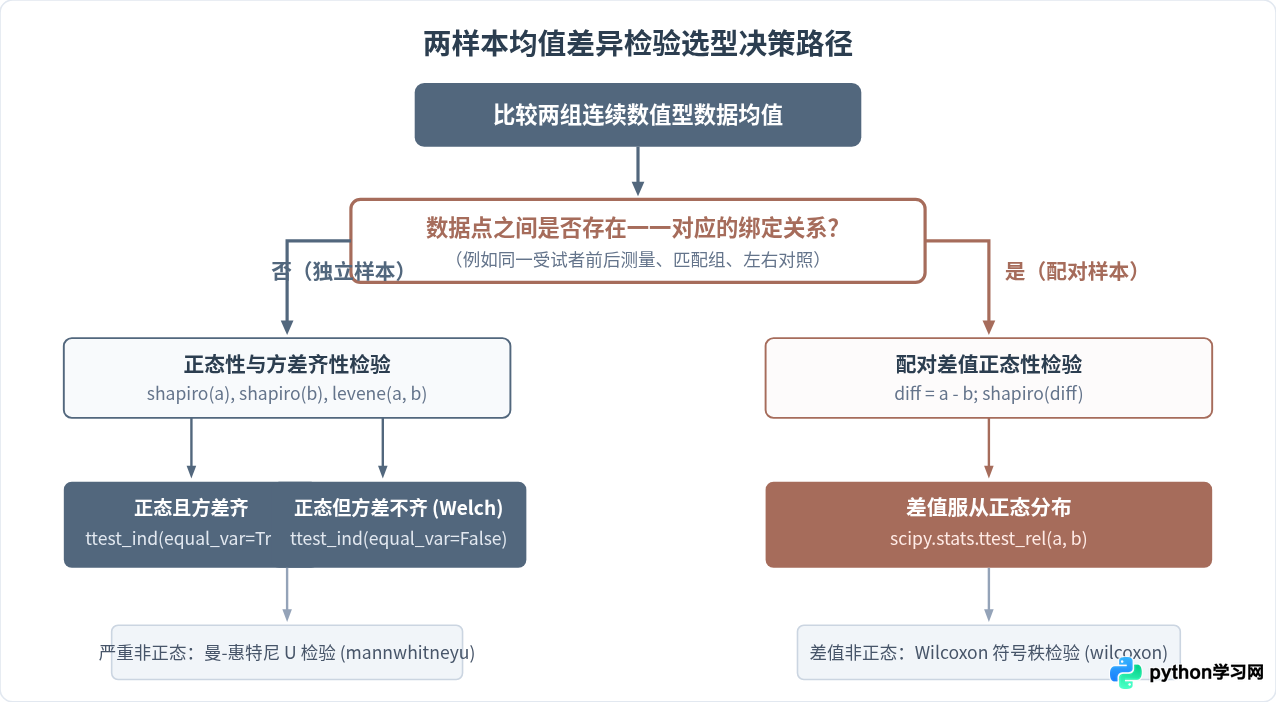
在正态性验证环节,有一个极其关键的认知门槛:配对样本t检验并不要求原变量 a 和 b 分别服从正态分布,它唯一关心的只有差值序列 diff = a - b 是否满足正态分布。很多初学者因为 a 偏态或 b 偏态就直接放弃配对 t 检验,这是不正确的;实际生产中,即使两组原始分布都有一定偏度,只要个体配对后相减的差值呈现对称的钟形分布,就可以安全使用配对检验。
相反,对于独立样本t检验,要求两组数据各自接近正态。在此基础上,还必须关注两组方差是否齐性(Homogeneity of Variance)。SciPy 的 ttest_ind 默认参数是 equal_var=True,但这在很多现实场景中过于理想化。现代统计学实践推荐在方差不齐或样本量不平衡时,明确指定 equal_var=False,使用更稳健的韦尔奇 t 检验(Welch's t-test)。
三、Python (SciPy) 完整实战与参数详解
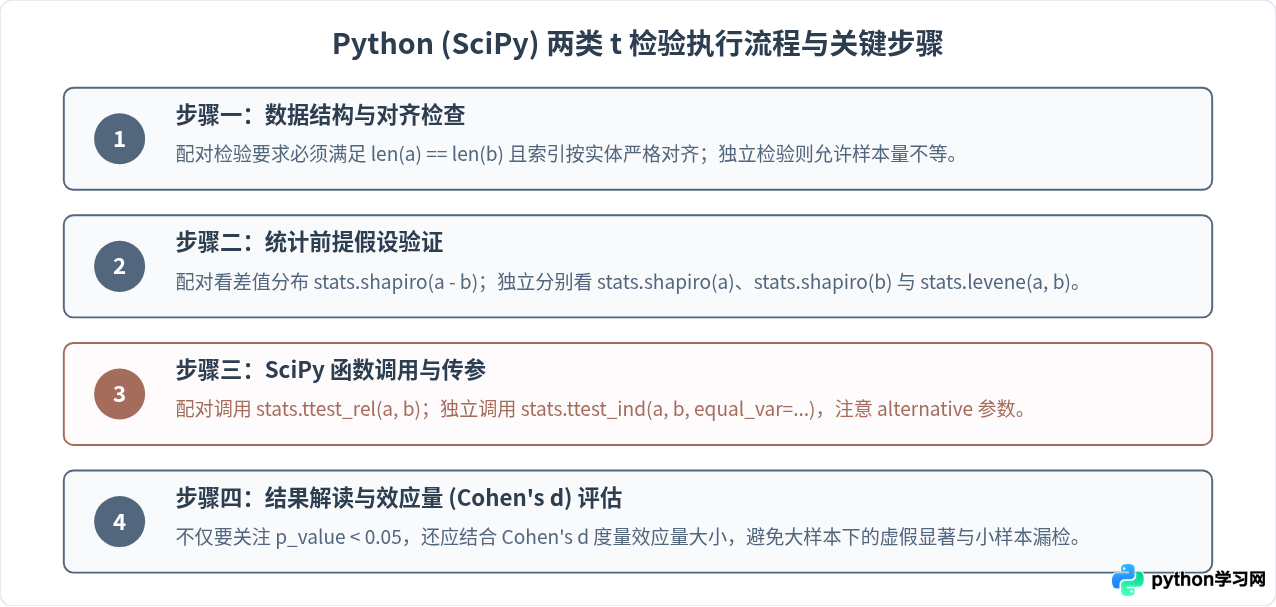
在 Python 的科学计算生态中,所有主流参数检验都收录在 scipy.stats 模块中。完整的分析实施通常拆解为四个具体步骤:数据对齐校验、前提假设探测、函数调用与输出指标评估。
1. 独立样本 t 检验实现(对比两个独立实验组)
下面的示例演示两组独立抽取的用户在产品上的交互时长差异检验。代码首先执行假设检验前置检查,再根据方差齐性结果动态决定 equal_var 参数。
import numpy as np
from scipy import stats

# 准备测试数据(两组样本量不同的独立用户停留时长,单位:秒)
np.random.seed(42)
group_control = np.random.normal(loc=120, scale=25, size=40)
group_variant = np.random.normal(loc=132, scale=30, size=35)

# 前置步骤 1:正态性检验(Shapiro-Wilk 检验,p > 0.05 视为服从正态)
stat_c, p_norm_c = stats.shapiro(group_control)
stat_v, p_norm_v = stats.shapiro(group_variant)
print(f"正态性检验 p 值: 对照组 = {p_norm_c:.4f}, 实验组 = {p_norm_v:.4f}")

# 前置步骤 2:方差齐性检验(Levene 检验,p > 0.05 视为方差齐)
stat_lev, p_levene = stats.levene(group_control, group_variant)
is_equal_var = p_levene > 0.05
print(f"方差齐性检验 p 值: {p_levene:.4f} (equal_var 设置为: {is_equal_var})")

# 步骤 3:执行独立样本 t 检验
res_ind = stats.ttest_ind(group_control, group_variant, equal_var=is_equal_var)
print(f"t 统计量: {res_ind.statistic:.4f}, p 值: {res_ind.pvalue:.4f}")
方差齐性检验 p 值: 0.3812 (equal_var 设置为: True)
t 统计量: -1.8924, p 值: 0.0624
2. 配对样本 t 检验实现(同一批用户改版前后测量)
在配对样本场景下,每个受试者在“干预前”和“干预后”各有一条记录,必须保证数组元素按人一一对齐:
import numpy as np
from scipy import stats

# 准备配对数据:同一批 30 名员工在专业培训前后的考试成绩
np.random.seed(42)
score_before = np.random.normal(loc=72, scale=10, size=30)
# 培训带来平均 4 分的提升,同时叠加个体测验噪声
score_after = score_before + np.random.normal(loc=4.2, scale=3.5, size=30)

# 前置步骤:检查【成对差值】的正态性,而非原始两组的正态性
score_diff = score_after - score_before
stat_diff, p_norm_diff = stats.shapiro(score_diff)
print(f"差值正态性检验 p 值: {p_norm_diff:.4f}")

# 执行配对样本 t 检验
# alternative 可选 'two-sided' (双尾), 'greater' (后测均值大于前测), 'less' (小于)
res_rel = stats.ttest_rel(score_after, score_before, alternative='greater')
print(f"配对 t 统计量: {res_rel.statistic:.4f}, 单尾 p 值: {res_rel.pvalue:.6f}")

# 计算配对样本的效应量 Cohen's d
cohens_d = np.mean(score_diff) / np.std(score_diff, ddof=1)
print(f"效应量 Cohen's d: {cohens_d:.4f}")
配对 t 统计量: 7.2148, 单尾 p 值: 0.000000
效应量 Cohen's d: 1.3172
在上述结果中,配对检验直接算出了极其显著的 p 值(小于 0.000001),且效应量 Cohen's d 达到了 1.31(通常 d > 0.8 即为强效应)。如果误将这段配对数据直接丢进 stats.ttest_ind,由于员工原本的能力水平基准方差高达 10,这部分天然的个体离散度会直接涌入独立样本检验的分母,导致 t 统计量骤降至 1.6 左右,p 值瞬间越过 0.05 的红线,从而扼杀真实有效的干预成果。
四、常见误区与避坑指南
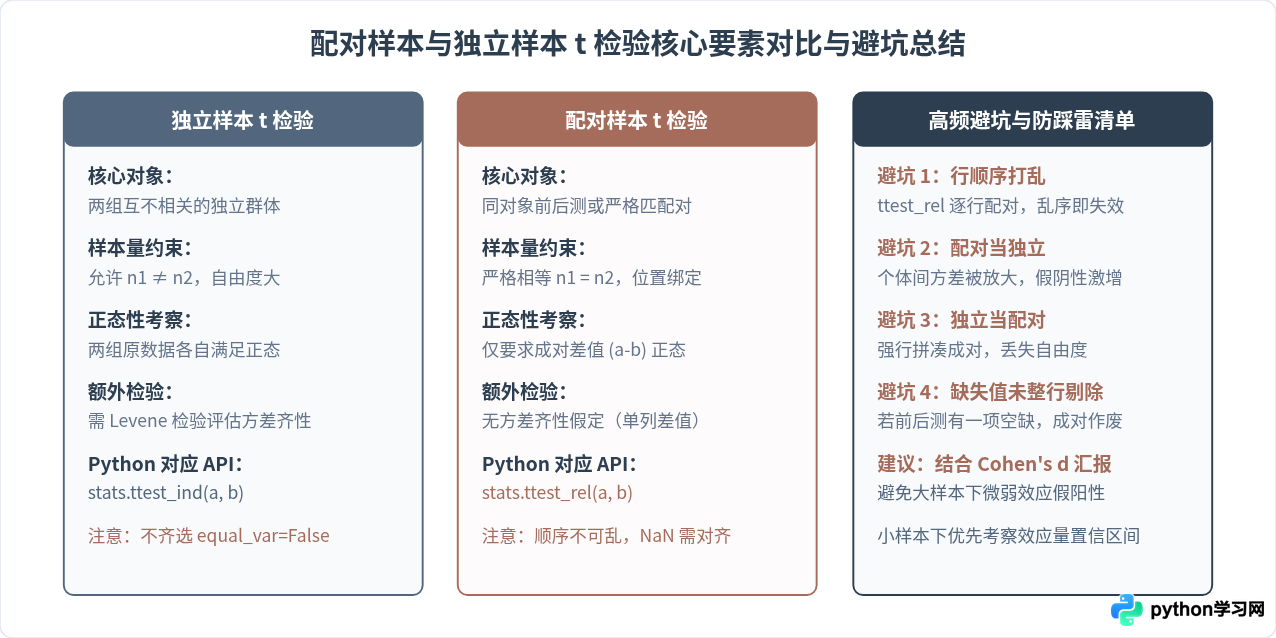
在工程化落地和实际写代码时,最容易栽跟头的细节往往不是算法公式,而是数据管道的处理细节:
ttest_rel(a, b) 底层直接使用数组下标 a[i] - b[i] 做差。如果原始数据存放在 Pandas DataFrame 中,并在清洗过程中分别对前测与后测切片执行了不同的 sort_values 或带有缺失值的过滤,导致传入函数的两个 Series 下标没有对齐,那么检验结果将彻底变为无意义的随机噪声。在调用 ttest_rel 之前,必须显式通过主键(例如 user_id)进行关联合并,保证数据行对应一致。
为了便于随时核对,下表系统总结了两种检验在工程场景下的对照矩阵:
| 对比维度 | 独立样本 t 检验 (Independent) | 配对样本 t 检验 (Paired) |
|---|---|---|
| 核心设计 | 组间设计(Between-subjects),两组完全不同 | 组内设计(Within-subjects),同一批人前后测或匹配 |
| 样本量要求 | 可不相等 ($n_1$ 可以不等于 $n_2$) | 必须严格相等 ($n_1 = n_2 = n$) |
| 虚无假设 $H_0$ | 两总体均值无差异 ($\mu_1 = \mu_2$) | 成对差值的均值为 0 ($\mu_D = 0$) |
| 自由度计算 | $df = n_1 + n_2 - 2$(方差齐)或 Welch 校正自由度 | $df = n - 1$($n$ 为配对对数) |
| 正态性检查对象 | 两个样本组各自的数据分布 | 成对差值列的单列分布 |
| 方差齐性检查 | 必需(通过 Levene 检验决定 equal_var) |
不涉及(本质转化为单样本检验) |
| 非参数替代方案 | 曼-惠特尼 U 检验 (mannwhitneyu) |
Wilcoxon 符号秩检验 (wilcoxon) |
| SciPy API | scipy.stats.ttest_ind |
scipy.stats.ttest_rel |
五、总结
在 Python 中选对 t 检验并不复杂。遇到均值对比问题时,先停下两秒钟确认实验设计:如果数据点来自彼此毫无牵连的两群人,那么毫无疑问走独立样本路线,并配合 Levene 检验谨慎选择是否开启 Welch 校正;如果数据记录的是同一批实体在不同时间阶段或不同交互条件下的成对响应,则坚决选用配对检验,通过差值化处理过滤掉个体间天然的噪声方差。遵循这一逻辑路径,即可确保推断结论既严谨又具备应有的统计灵敏度。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









