

为什么Python中用\t对齐不准确?制表位原理与format替代方案

在编写控制台脚本或输出数据报表时,许多开发者习惯在字段间插入制表符 \t 来实现表格对齐,但实际输出往往参差不齐。根本原因在于制表符并不是“插入固定数量的空格”,而是指令光标移动到下一个固定的“制表位(Tab Stop)”;一旦字段长度发生波动或包含中文字符,跳跃步长就会发生突变,导致排版彻底崩溃。解决这一问题的根本方案是摒弃 \t,改用 Python 内置的 str.format() 方法或 f-string 格式说明符进行显式列宽与对齐约束,并在涉及中英文混排时通过计算字符实际物理显示宽度进行动态补偿。
一、现场还原:制表符排版的“翻车”现象
设想一个非常普遍的业务场景:我们需要从数据库中读取一组员工基本信息,并在终端控制台打印出整齐的名单,包含工号、姓名和部门三列数据。开发者自然写出了如下代码:
# Python 3.8+ 示例脚本
employees = [
    ("101", "Tom", "HR"),
    ("102", "Alexander", "Engineering"),
    ("103", "Bob", "Sales"),
    ("104", "张三", "Operations"),
]

print("工号\t姓名\t部门")
for emp_id, name, dept in employees:
    print(f"{emp_id}\t{name}\t{dept}")
运行上述代码后,终端实际打印出来的示例输出如下:
示例输出:
工号	姓名	部门
101	Tom	HR
102	Alexander	Engineering
103	Bob	Sales
104	张三	Operations
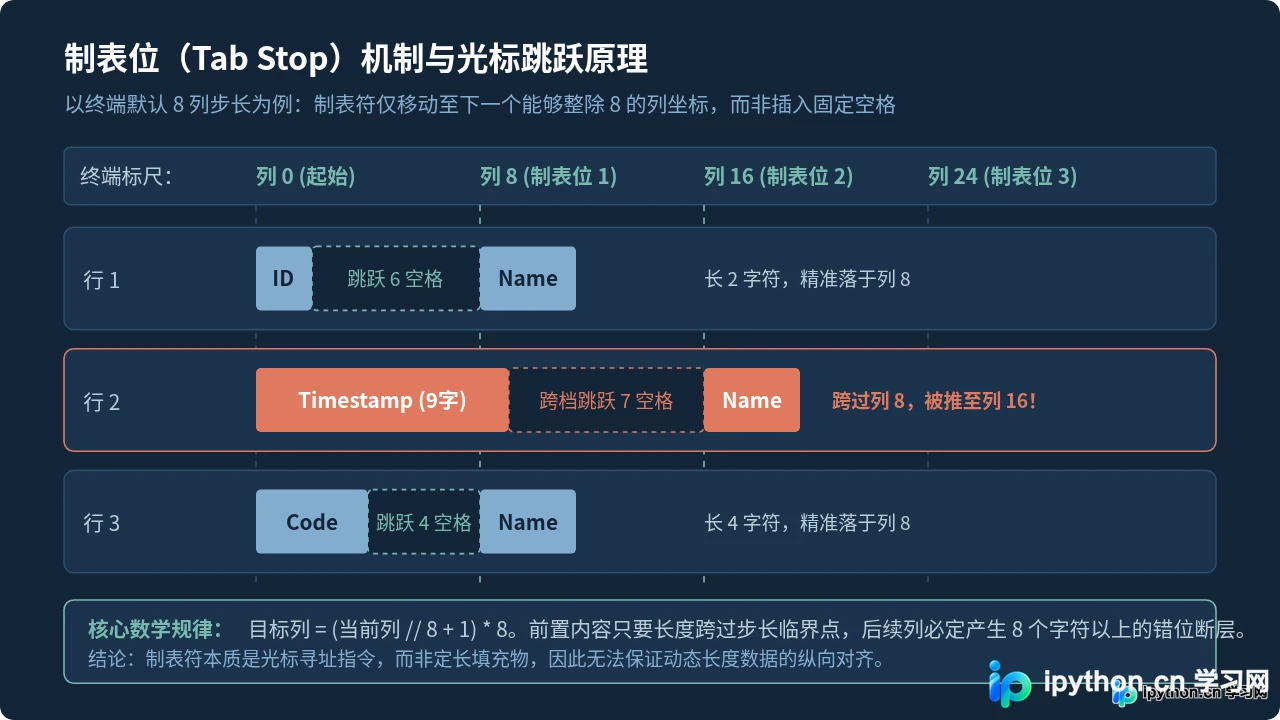
在默认 8 字符制表位的终端中,观察上述结果会发现两个严重的错位现象:第一,当名字为 Alexander 时,由于英文字符串长度达到了 9,直接跨过了第 8 列的制表位,导致其后的部门 Engineering 被迫推到了第 16 列制表位,破坏了整张表格的垂直线;第二,在中文 张三 后面,由于中文字符在终端显示中占据两个半角字符宽度,视觉上的间距同样出现了微妙的偏移。这表明简单的 \t 无法承担结构化表格的对齐任务。
二、底层机理:制表位(Tab Stop)定位与跳跃原理
要理解错位的本质,必须追溯制表符 \t(ASCII 编码 9)的运作机制。制表符起源于机械打字机时代,当时打字员按下 Tab 键后,滑架会向前滑动直到卡在预设的金属卡扣位置,这个预设的停靠点就被称为制表位(Tab Stop)。
现代计算机终端与文本编辑器继承了这一机制。终端窗口的横向坐标被划分为一系列等距的制表位标尺,默认步长通常为 8 列(即第 0、8、16、24、32 列……)。当程序输出一个 \t 字符时,终端并不是向屏幕输出 8 个空格,而是将当前光标移动到下一个大于当前列坐标且能被步长整除的制表位上。
其数学计算公式如下:设当前光标所在的列坐标为 col(从 0 开始计数),制表位步长为 W(默认为 8),则按下 \t 后的目标列坐标 target_col 与跳跃距离 delta 分别为:
- 目标列坐标:
target_col = (col // W + 1) * W - 跳跃空格距离:
delta = W - (col % W)
当字段长度在 0 到 7 之间时,光标跳跃到列 8;但只要字段长度达到或超过 8(例如长为 9 的 Alexander),当前光标就已经处于第 9 列,下一个制表位直接变成了列 16。这种由于字段长度变动带来的跨档跳跃,使得后续字段的起始位置产生了整整一个步长的断层。
三、深度溯源:为什么制表符难以胜任 Python 输出对齐?
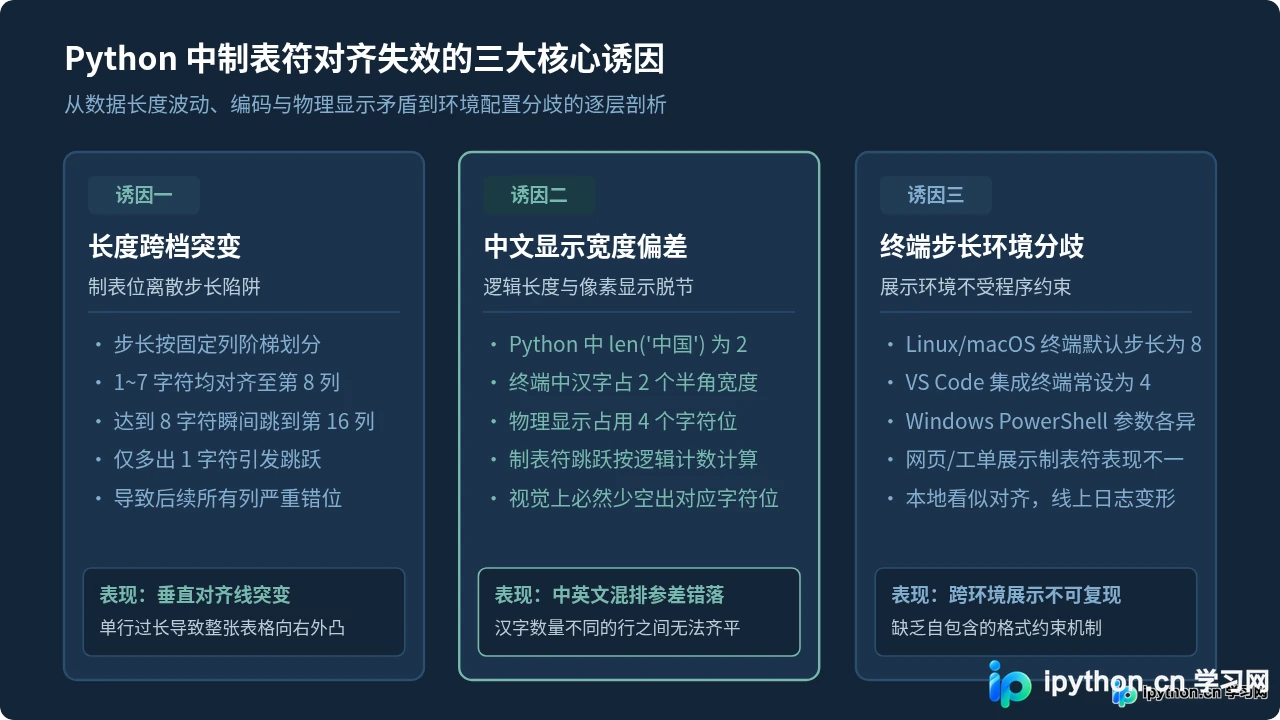
在实际开发中,使用 \t 进行表格排版面临三大难以克服的客观障碍:
1. 字段长度波动引发的阈值效应
业务数据中的字符串长度往往是不可控的。只要某一行的字段长度超过了制表位步长(例如从 7 个字符变为 8 个字符),光标的跳转位置就会由列 8 突变至列 16。这一突变不仅破坏当前行,还会让所有后续列的排版发生剧烈扭曲。
2. 逻辑字符与东亚宽字符(East Asian Width)的冲突
在 Python 内部,len("张三") 的返回值是 2,因为 Python 统计的是 Unicode 字符数量。然而在等宽字体终端中,一个汉字占据的物理显示宽度是两个西文字符的宽度(即 2 列)。当输出 张三\t 时,终端内部将逻辑光标计为向前推进了 2 个单位,并计算出跳跃到列 8 需要补 6 个单位;但在屏幕像素上,两个汉字已经霸占了 4 个字符的位置,再加上跳跃的距离,最终总显示宽度超出了预期,导致整列数据出现锯齿状错落。
3. 终端与运行环境的制表步长不一致
制表符的具体表现高度依赖终端宿主环境的配置。在标准的 Linux Bash 或 macOS Terminal 中,默认制表步长通常是 8;但在 VS Code 的内置终端中,默认往往被设置为 4;在 Windows 命令提示符(CMD)或不同的日志收集系统(如 Kibana、ELK 报表)中,制表符的展开方式各不相同。这意味着即便在本地调试时通过巧合凑齐了对齐效果,代码推送到生产环境后依然会严重变形。
四、标准替代方案:format 与 f-string 的精绝对齐实操
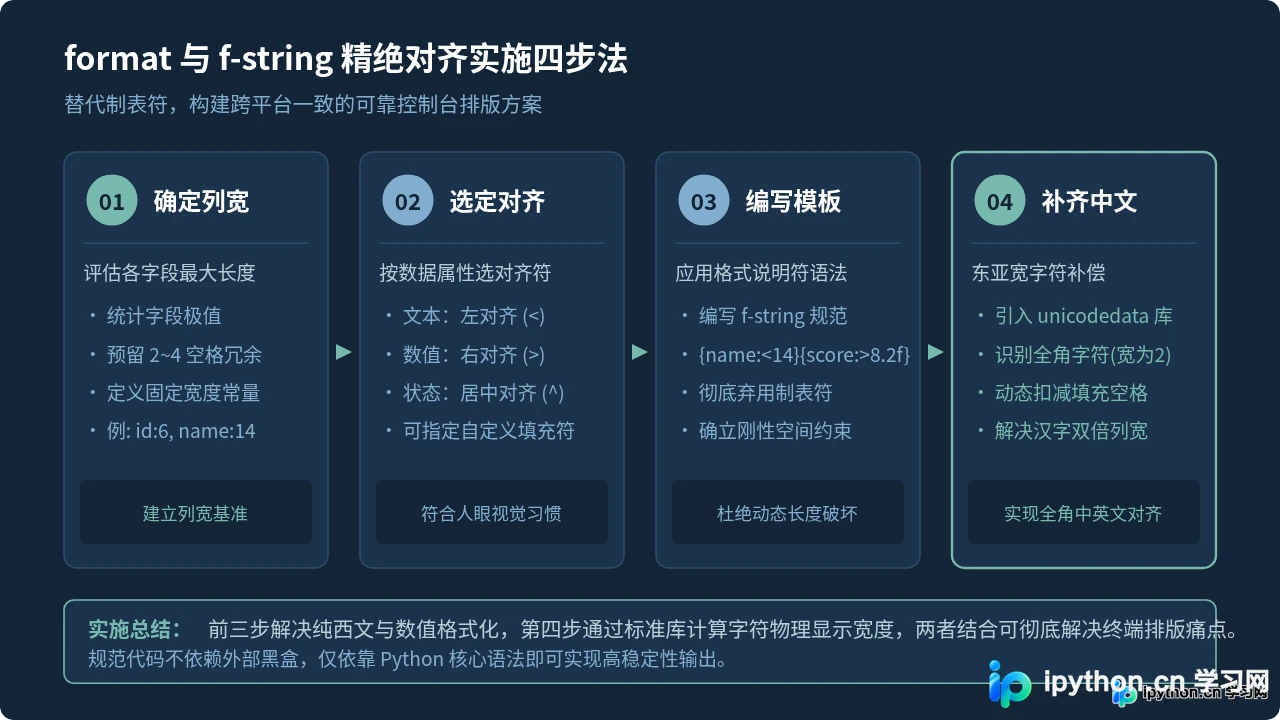
要获得不依赖外部终端设置且高度可靠的对齐效果,必须放弃制表符,转为使用 Python 内置的字符串格式化机制。无论是 str.format() 还是 Python 3.6 引入的 f-string,都支持格式规范微语言(Format Specification Mini-Language)。
1. 格式说明符核心语法
格式说明符的一般结构为:{[字段名]:[填充符][对齐符][宽度][.精度][类型]}。其中最核心的三个对齐控制符为:
<:左对齐(文本字段的标准对齐方式,多余空间在右侧填充)。>:右对齐(数值、金额等需要按位对齐的数据标准方式)。^:居中对齐(常用于表格表头或状态标签)。
2. 实操代码与对比示例
以下代码演示了如何使用 f-string 对纯西文与数值数据进行刚性列宽格式化:
# 纯西文与数值格式化示例
records = [
    ("101", "Tom", 92.5),
    ("102", "Alexander", 88.0),
    ("103", "Bob", 100.0),
]

# 分配列宽:ID 占用 6 位居中,姓名占用 14 位左对齐,分数占用 8 位右对齐并保留两位小数
print(f"{'ID':^6} | {'Name':<14} | {'Score':>8}")
print("-" * 34)
for rec_id, name, score in records:
    print(f"{rec_id:^6} | {name:<14} | {score:>8.2f}")
运行上述代码后,输出结果完全不受字段长度差异的影响:
示例输出:
  ID   | Name           |    Score
----------------------------------
 101   | Tom            |    92.50
 102   | Alexander      |    88.00
 103   | Bob            |   100.00
通过为每个字段指定具体的字符宽度(如 name:<14),Python 解释器会自动计算当前字符串的长度并补充相应数量的空格。不论字符串长短,整个字段占用的总字符数始终固定为 14,从而在根本上保障了整列数据的纵向对齐线绝对垂直。
五、进阶方案:破解中英文混排对齐难题
虽然标准的 f-string 能完美解决西文字符与数值的对齐,但在处理包含汉字、日文假名或全角标点的数据时,依旧会出现右侧边界不齐的问题。例如执行 f"{'张三':<10}" 时,Python 认为 "张三" 的长度是 2,因此会在其右侧追加 8 个半角空格;但在终端显示时,两个汉字实际上占用了 4 个半角列宽,加上 8 个空格后总宽度变成了 12,导致整列向右凸出 2 个位置。
1. 使用 unicodedata 精确计算物理宽度
Python 标准库中的 unicodedata 模块提供了 east_asian_width() 函数,能够根据 Unicode 标淮规范判定字符的东亚宽度属性。常见的返回值包括:
'W'(Wide,宽字符,如汉字、全角假名):终端占 2 个半角宽度。'F'(Fullwidth,全角字符,如全角英文字母、中文标点):终端占 2 个半角宽度。'Na'、'N'、'H'(Narrow / Neutral / Halfwidth,窄字符/半角字符):终端占 1 个半角宽度。
2. 封装自适应对齐函数
我们可以编写一个零外部依赖的轻量辅助函数,先计算字符串的实际物理显示宽度,再动态计算需要填充的半角空格数:
import unicodedata

def get_display_width(text: str) -> int:
    """计算字符串在终端等宽字体下的实际物理显示宽度"""
    width = 0
    for char in str(text):
        status = unicodedata.east_asian_width(char)
        width += 2 if status in ('F', 'W') else 1
    return width

def pad_to_width(text: str, target_width: int, align: str = 'left', fill_char: str = ' ') -> str:
    """基于物理显示宽度进行对齐填充"""
    cur_width = get_display_width(text)
    padding_needed = max(0, target_width - cur_width)

    if align == 'right':
        return (fill_char * padding_needed) + str(text)
    elif align == 'center':
        left_pad = padding_needed // 2
        right_pad = padding_needed - left_pad
        return (fill_char * left_pad) + str(text) + (fill_char * right_pad)
    else:  # 默认左对齐
        return str(text) + (fill_char * padding_needed)

# 测试中英文混排数据
mixed_data = [
    ("101", "Tom", "技术部"),
    ("102", "欧阳六六", "人力资源部"),
    ("103", "Alexander", "财务审计"),
    ("104", "王五", "运营部"),
]

print(f"{pad_to_width('工号', 8, 'center')} | {pad_to_width('姓名', 14, 'left')} | {pad_to_width('所属部门', 16, 'left')}")
print("-" * 44)
for emp_id, name, dept in mixed_data:
    col1 = pad_to_width(emp_id, 8, 'center')
    col2 = pad_to_width(name, 14, 'left')
    col3 = pad_to_width(dept, 16, 'left')
    print(f"{col1} | {col2} | {col3}")
运行上述脚本后,终端输出将达到绝对的像素级垂直对齐:
示例输出:
  工号   | 姓名           | 所属部门
--------------------------------------------
  101    | Tom            | 技术部
  102    | 欧阳六六       | 人力资源部
  103    | Alexander      | 财务审计
  104    | 王五           | 运营部
在此实现中,pad_to_width 严格扣除了汉字所占用的双倍物理宽度,使得输出的每一行在不同长度的中英文混排场景下都能保持严格一致的物理边界。
六、技术选型与工程最佳实践
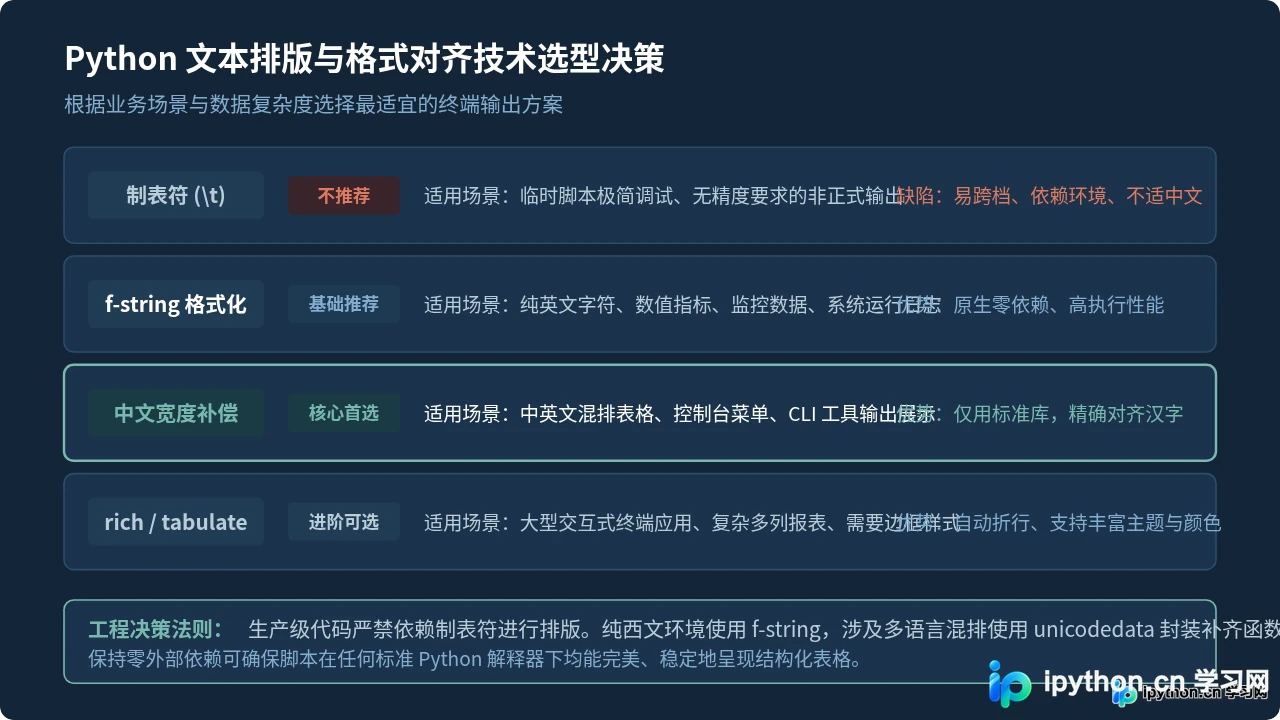
在日常 Python 工程开发中,面对不同的业务输出需求,应当根据场景选用恰当的格式化手段:
| 技术方案 | 适用场景 | 核心优势 | 潜在局限 |
|---|---|---|---|
\t 制表符 |
极简一次性调试脚本、TSV 数据文件输出 | 编写最快,无需计算宽度 | 完全依赖终端设置,极易跨档错乱,不支持中英文混排 |
f-string / format |
纯西文控制台输出、数值日志、系统监控指标 | 原生语法零开销,格式化灵活,支持数值精度控制 | 未考虑东亚字符宽度,遇汉字仍会出现偏移 |
unicodedata 补偿函数 |
含有中文字符的控制台工具、CLI 交互菜单、本地数据报表 | 仅用 Python 标准库,无外部依赖,中英文完美对齐 | 需封装辅助函数,不支持长文本自动折行 |
第三方表格库 (rich / tabulate) |
复杂 CLI 应用程序、生产级运维交互工具、多列自适应报表 | 功能完备,支持边框、彩色高亮、自动折行与样式定制 | 需引入外部第三方依赖包,轻量脚本中可能偏重 |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









