

Python if条件中误用&导致TypeError或逻辑错误的修正方法
深入解析在Python条件判断中误将逻辑与(and)写成按位与(&)导致TypeError报错或逻辑判断失真原因,提供完整的排查、修复步骤与Pandas/NumPy边界对比。
假设你正在编写一段范围校验或对象检测逻辑,写下了类似 if score >= 60 & score <= 100: 或者 if user is not None & user.is_active: 的代码。运行后,程序并没有按照预想分支执行,要么直接抛出 TypeError: unsupported operand type(s) for &,要么在完全不符合预期的数值下静默进入了错误分支。在 Python 中,解决这一问题的核心动作极其简单:将条件判断中的 & 替换为布尔逻辑运算符 and。产生此类缺陷的本质原因是 Python 中的 & 是“按位与(Bitwise AND)”运算符,不仅拥有高于比较运算符的执行优先级,还不具备短路求值(Short-circuit evaluation)特性,与业务逻辑中期望的条件并联完全不同。
一、问题复现:误用 & 时的典型异常表现
在条件判断语句中误用 & 通常会引发两种截然不同的故障表象:第一种是显式的程序崩溃(TypeError),第二种则是更为隐蔽的逻辑判断漂移(静默逻辑错误)。
1. 异常崩溃:TypeError 报错场景
当条件涉及非整数标量(例如浮点数、字符串、自定义对象)时,按位与运算符 & 往往会直接报错崩溃。考虑以下检查浮点数范围的代码:
# 错误示例:浮点数范围判断
temperature = 36.5
if temperature > 36.0 & temperature < 37.5:
    print("体温正常")
执行该代码不会输出“体温正常”,而是直接中断抛出异常:
# 终端报错信息(示例)
TypeError: unsupported operand type(s) for &: 'float' and 'float'
初学者常常困惑:两边明明都是比较表达式,为什么会出现对两个浮点数做 & 运算的报错?这正是因为运算符优先级错乱造成的。
2. 静默失真:不报错但分支判定错误
如果参与比较的是整数,由于整数完全支持位运算,代码不会报出任何语法或类型错误,但判断结果会彻底脱离控制:
# 错误示例:整数范围检查
val = 25
if val > 10 & val < 30:
    print("条件成立")
else:
    print("条件不成立")
以数学直觉来看,25 明显处于 10 到 30 之间,屏幕上应该输出“条件成立”。但实际运行后控制台却打印出:
# 终端实际输出(示例)
条件不成立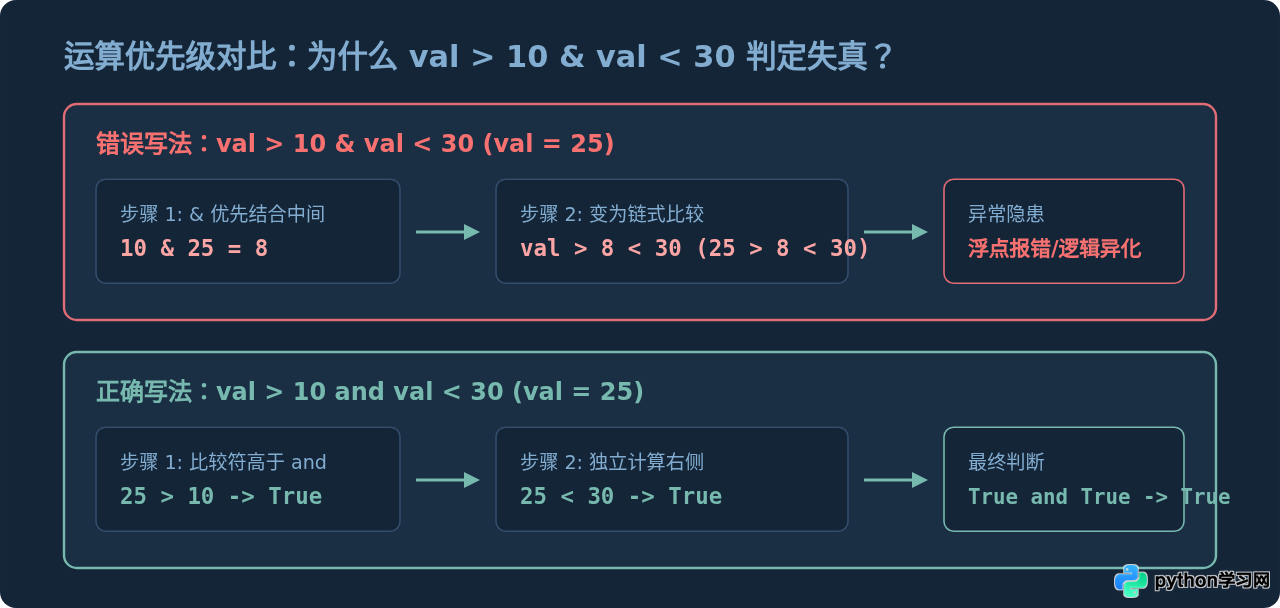
二、深层根因:按位与(&)与逻辑与(and)的本质鸿沟
导致上述现象的根源在于 Python 语言规范中对 & 与 and 的设计定位完全不同,主要体现在以下三个维度:
1. 运算符优先级的倒置
在 Python 的运算符优先级矩阵中,位运算符(包含 &、|、^)的优先级明显高于比较运算符(>、<、==、>=、<=、!=);而真正的布尔逻辑运算符(not、and、or)的优先级则处于几乎所有运算的底端。
当你输入 a > 36.0 & b < 37.5 时,解释器优先结合的是位于中间的 36.0 & b。如果 b 是浮点数,解释器立刻尝试将两个浮点数做二进制位与操作,Python 的浮点对象并没有实现 __and__ 特殊方法,因此当场抛出 TypeError: unsupported operand type(s) for &: 'float' and 'float'。
如果 a 和 b 是整数,表达式会变成 a > (36 & b) < 37,这被解释器解读为了 Python 的“链式比较”(Chained Comparison),即 (a > (36 & b)) and ((36 & b) < 37),原本意图考察 b 的大小,却变成了考察 36 & b 计算结果的大小,判断彻底偏离预期。
2. 短路求值机制(Short-circuiting)的缺失
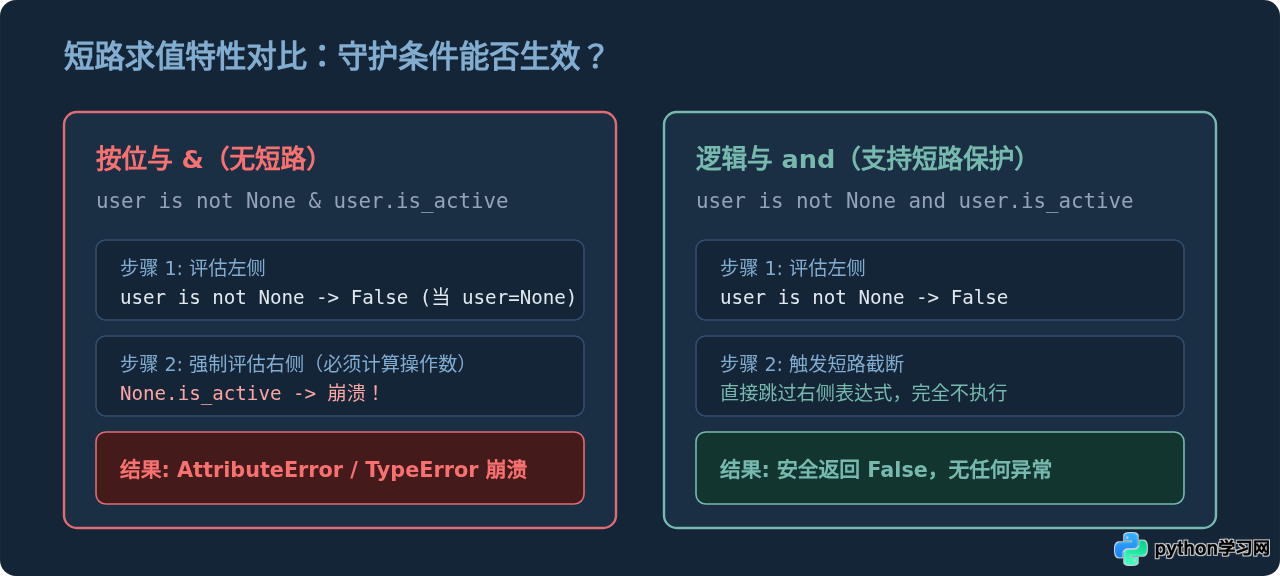
布尔运算符 and 是带有短路求值保证的:如果左侧表达式结果为 False,右侧表达式将完全不会被计算或执行。这一特性经常被用作安全守护条件(Guard Clause),例如检查对象非空后再访问其内部属性。
相反,按位与 & 只是一个普通的操作符函数调用(等价于调用 a.__and__(b)),它必须在运算前把左右两边的操作数都求值完毕。如果右侧依赖左侧的非空或有效性前提,使用 & 就会直接导致右侧空指针或属性缺失崩溃。
三、排查与修复步骤:将误用规范重构
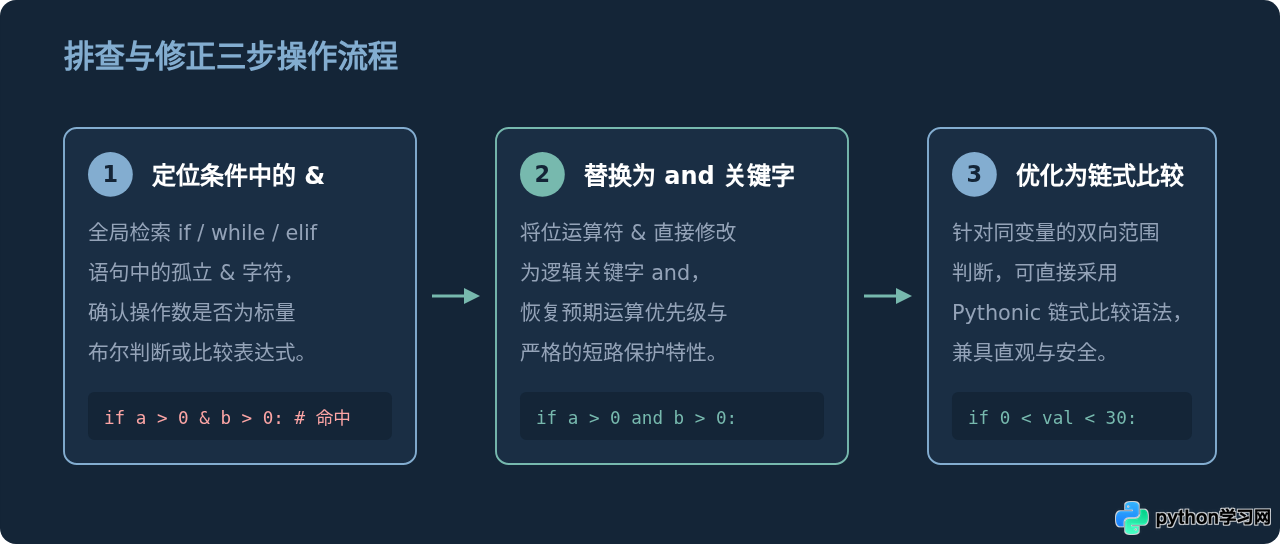
解决此类问题遵循标准化排查三步法,从定位隐患、语义替换到语法精简。
步骤 1:定位条件分支代码中的裸 &
在编辑器中利用正则表达式 \bif\b.*& 或静态代码检查工具(如 Flake8、Pylint、Ruff)扫描工程。重点关注出现在 if、elif、while 之后的比较判断。如果发现形如 x > 0 & y > 0 的写法,立即列为隐患项。
步骤 2:直接将 & 替换为 and
对于两个独立的布尔判断,修改操作非常清晰:
# 修复前(错误写法)
if score >= 60 & score <= 100:
    pass

# 修复后(标准写法)
if score >= 60 and score <= 100:
    pass
替换为 and 后,score >= 60 会先被求值为布尔值 True 或 False,随后根据逻辑与规则结合右侧判断,彻底消除了优先级异常。
步骤 3:在范围判断中采用 Python 链式比较(Pythonic 优化)
如果是对同一个变量做区间上下界校验,Python 原生支持优雅的“链式比较”(Chained Comparison)。这种写法不仅完全符合数学直觉,而且底层自动包含了短路逻辑:
# 推荐做法:使用链式比较代替 and
score = 85
if 60 <= score <= 100:
    print("成绩合格并在有效范围内")
解释器会将 60 <= score <= 100 自动展开为 (60 <= score) and (score <= 100),且保证 score 变量只会被求值一次,既安全又简洁。
四、关键边界:为什么 Pandas 和 NumPy 中必须用 &?
许多从数据分析转入 Python 基础开发的工程师容易误用 &,很大程度上是因为在 Pandas 和 NumPy 中过滤数据时,官方文档明确要求使用 &,这常常造成认知混淆。
and;而向量化容器(Pandas Series、NumPy ndarray)过滤中必须使用 &,且每个子条件必须用圆括号包裹!
1. 为什么 Pandas 中不能用 and?
在 Pandas 中,df['age'] > 18 返回的不是单个布尔值 True 或 False,而是一个包含上万行布尔值的 pandas.Series。Python 语言规定:and 操作符试图将两边的对象转换为单一的真值(通过 __bool__() 方法)。一个含有多个值的 Series 无法明确代表“单个真”还是“单个假”,因此执行 s1 and s2 会立刻抛出错误:
# Pandas 中使用 and 导致的报错(示例)
ValueError: The truth value of a Series is ambiguous. Use a.empty, a.bool(), a.item(), a.any() or a.all().
2. Pandas 中使用 & 为什么必须加圆括号?
Pandas 重载了 & 运算符(通过 Series.__and__),实现了逐行元素间的向量化“按位与”操作。但正因为前面提到的优先级机制:& 优先级高于 >、< 等比较运算符,如果不加圆括号,依然会报出相同的优先级错误!
# 错误写法:未加括号,引发 TypeError
# 解释器会试图先计算 18 & df['score']
result = df[df['age'] > 18 & df['score'] > 80]  # 报错!

# 正确写法:使用括号强制指定比较优先,再进行向量位与
result = df[(df['age'] > 18) & (df['score'] > 80)]  # 正确通过
五、规范对比与决策矩阵
为了在日常开发中准确选择运算符,避免陷入 TypeError 或逻辑判断漂移,可参照如下决策对照体系:
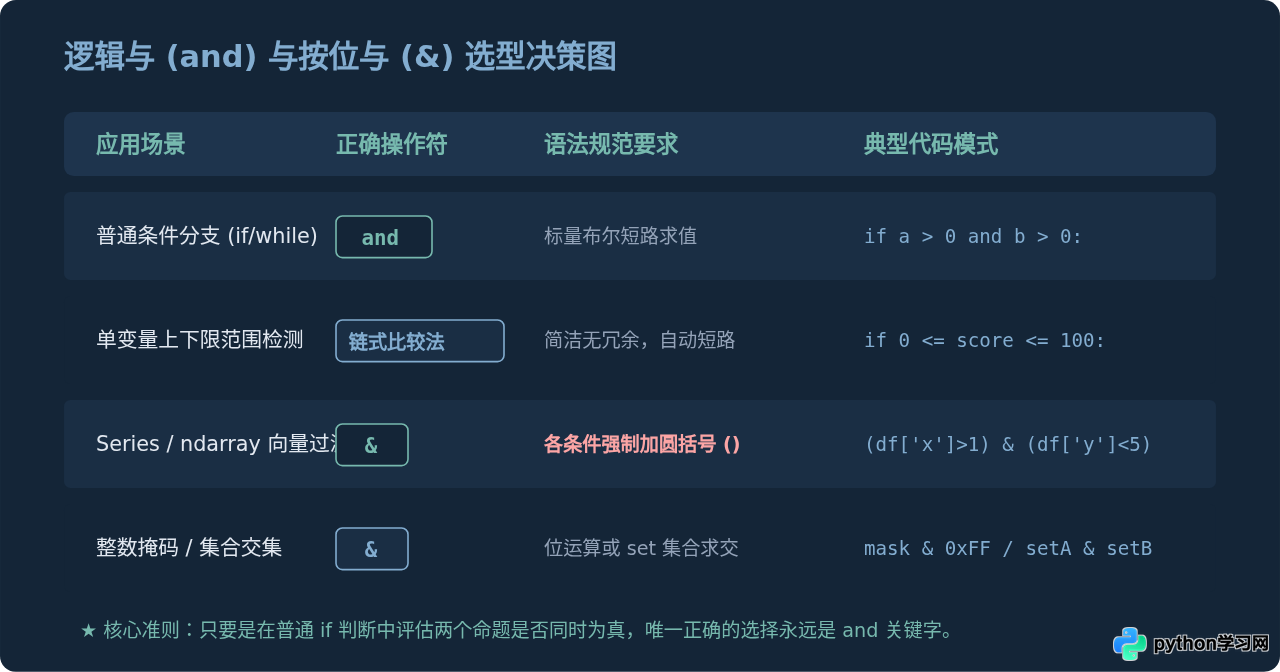
| 特性维度 | 逻辑与 (and) |
按位与 (&) |
|---|---|---|
| 本质功能 | 标量布尔真值逻辑联结 | 二进制位运算 / 容器重载运算 |
| 优先级高低 | 低于比较运算符(最后求值) | 高于比较运算符(优先结合相邻项) |
| 短路特性 | 支持(左侧为 False 时立即截断) | 不支持(两边操作数必须强制求值) |
| 非法类型表现 | 安全转换布尔值(调用 __bool__) |
不支持类型直接报错 TypeError |
| 主要适用场景 | if / while 分支条件控制 |
状态位掩码、集合交集、Pandas 多列筛选 |
TypeError: unsupported operand type(s) for & 或发现范围判断完全失效时,请立刻检查代码是否把 and 误敲成了 &。通过将 & 修正为 and,或者将单变量范围改写为 min_val <= x <= max_val 链式比较,即可从语法和逻辑底层彻底杜绝此类缺陷。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









