

Python常用数据结构:列表、字典与集合操作指南
深入解析Python中列表、字典与集合的核心特性、操作方法、底层原理与选型策略,帮助开发者掌握高效的数据处理与性能优化技巧。
一、核心对象与底层机制对比
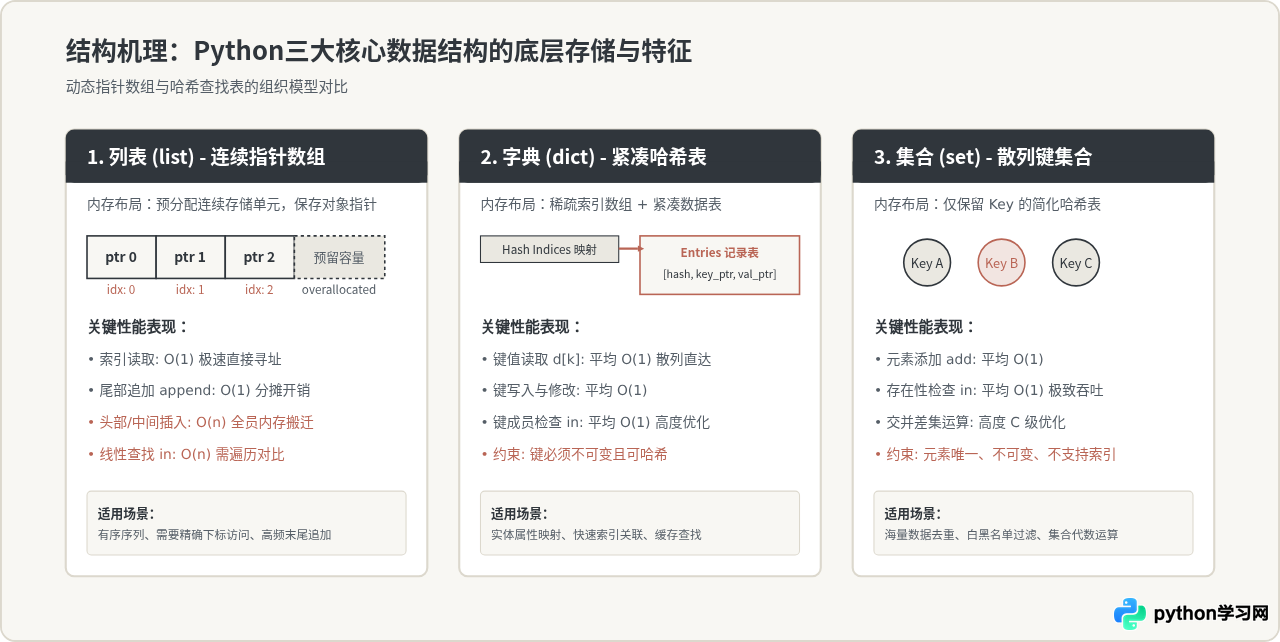
Python内置的列表、字典和集合虽然在使用时都可以容纳多个元素,但底层实现机制有着本质差异。列表是有序的动态数组(Dynamic Array),支持通过物理连续位置进行极速索引;字典和集合则基于哈希表(Hash Table)实现,通过散列函数计算元素在散列表中的桶位,从而实现接近常数级的查找与增删。
因为底层结构的差异,它们对外表现出的可变性、有序性与元素约束各不相同:
- 列表(list):元素有序排列,允许重复,支持任意对象,通过自增或自减连续内存块来容纳数据。
- 字典(dict):以键值对(key-value)形式存储,键必须为可哈希(hashable)对象且不可重复,自Python 3.7起官方保证键值对插入顺序。
- 集合(set):仅存储唯一的键,元素必须可哈希,无序(不保证特定遍历顺序),专门用于数学集合运算与极速去重。
二、列表(list)的高频操作与工程实践
列表是日常编码中最常用的线性数据结构。通过方括号 [] 或内置函数 list() 即可初始化。列表具备动态扩容机制,能够按需追加和修改。
1. 元素增删与切片
向列表添加元素有 append()、extend() 和 insert() 三种主要方式:
append(x):将元素作为整体追加到末尾,时间复杂度为分摊 O(1)。extend(iterable):逐一迭代可迭代对象中的元素并依次追加至末尾。insert(i, x):在指定索引i处插入元素,会导致后续所有元素向后平移,复杂度为 O(n)。
# 列表增删操作示例
numbers = [10, 20, 30]

# 1. 末尾追加
numbers.append(40)          # 结果: [10, 20, 30, 40]

# 2. 批量合并
numbers.extend([50, 60])    # 结果: [10, 20, 30, 40, 50, 60]

# 3. 指定位置插入(注意性能开销)
numbers.insert(0, 5)        # 结果: [5, 10, 20, 30, 40, 50, 60]

# 4. 删除指定值的第一个匹配项
numbers.remove(30)          # 结果: [5, 10, 20, 40, 50, 60]

# 5. 弹出末尾元素(O(1))或弹出指定索引(O(n))
tail_val = numbers.pop()    # 弹出 60,列表剩余 [5, 10, 20, 40, 50]
head_val = numbers.pop(0) # 弹出 5,列表剩余 [10, 20, 40, 50]2. 切片技巧与浅拷贝陷阱
切片语法 list[start:stop:step] 是列表处理的利器。通过切片可以进行区间读取、逆序输出以及批量替换。
data = [0, 1, 2, 3, 4, 5, 6, 7, 8, 9]

# 提取子序列(左闭右开)
sub_data = data[2:6]        # [2, 3, 4, 5]

# 步长提取
evens = data[::2]           # [0, 2, 4, 6, 8]

# 列表翻转
reversed_data = data[::-1]  # [9, 8, 7, 6, 5, 4, 3, 2, 1, 0]

# 原地切片浅拷贝
copy_data = data[:]data[:] 或 data.copy() 创建的都是浅拷贝(Shallow Copy)。如果列表中嵌套了字典或其他列表,内部对象依然共享引用。若需要完全隔离,必须使用 copy.deepcopy()。
3. 列表推导式的高效运用
列表推导式(List Comprehension)比传统的 for 循环显式 append() 更精炼,且由于字节码优化,其运行速度通常更快:
# 传统循环方式
squares = []
for x in range(10):
    if x % 2 == 0:
        squares.append(x ** 2)

# 列表推导式方式(更清晰且高效)
squares_comp = [x ** 2 for x in range(10) if x % 2 == 0]三、字典(dict)的键值映射与查询优化
字典是Python中最重要的关联容器。自Python 3.6开始(3.7正式成为语言标准),字典保证了元素按照插入顺序存放,并在底层重构为紧凑哈希表,显著降低了内存消耗。
1. 安全读取与默认值
直接使用方括号 d[key] 读取不存在的键会触发 KeyError。在生产代码中,推荐使用 get() 或 setdefault() 来防范异常:
user_profile = {"name": "Alex", "role": "admin"}

# 方式一:get 提供安全回退默认值
department = user_profile.get("department", "Engineering")

# 方式二:setdefault 若不存在则写入并返回
user_profile.setdefault("status", "active")
user_profile.setdefault("role", "guest")  # 已存在,不覆盖

# 方式三:使用 collections.defaultdict 简化聚合
from collections import defaultdict

counter = defaultdict(int)
for word in ["apple", "banana", "apple", "cherry"]:
counter[word] += 12. 字典合并与解构
在Python 3.9及以上版本中,引入了合并且更新运算符 | 和 |=,替代了旧版本中较为冗长的解包语法:
defaults = {"timeout": 30, "retry": 3, "debug": False}
custom = {"timeout": 60, "debug": True}

# 使用管道符合并(右侧配置覆盖左侧)
config = defaults | custom

# 原地更新
defaults |= custom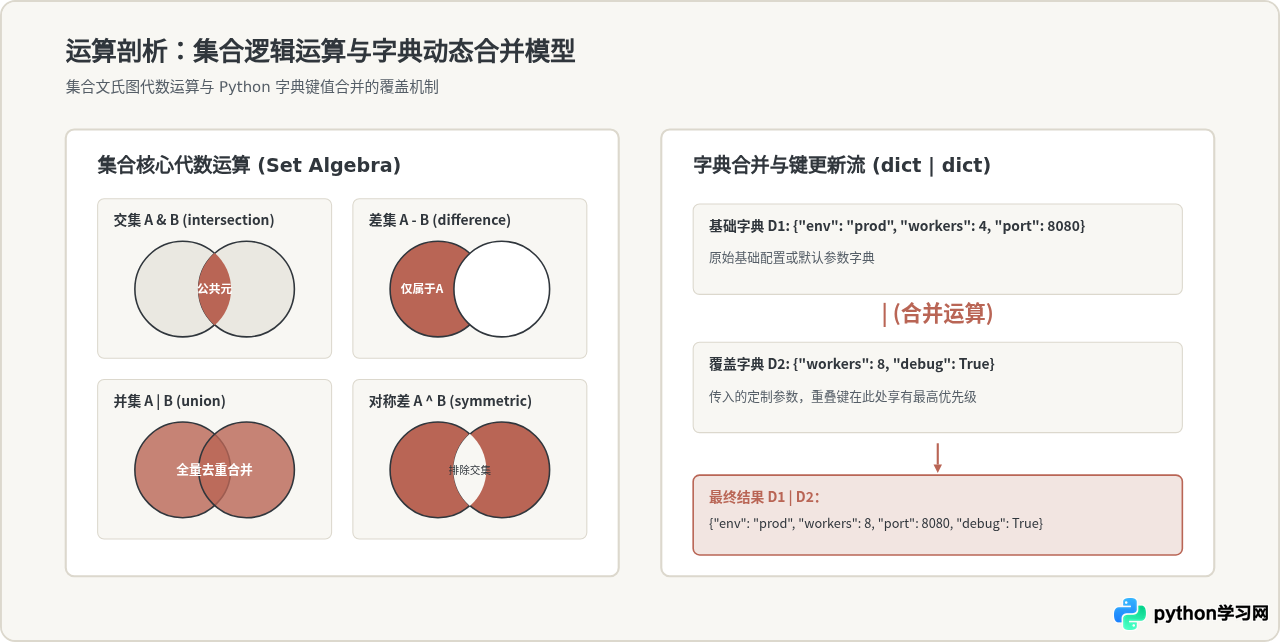
四、集合(set)的数学运算与极致去重
集合是一个无序且元素互不相同的容器。使用花括号 {1, 2, 3} 或 set() 进行创建。需要特别注意:空的 {} 产生的是一个空字典,空集合必须使用 set() 初始化。
1. 集合核心去重与成员判断
当需要去除序列中的重复项,或者频繁测试一个值是否存在时,集合是首选方案。在拥有100万个元素的列表中执行 x in my_list 需要依次遍历对比,最坏情况耗时与规模呈正比;而在 my_set 中执行查找,平均耗时为固定的几十纳秒。
raw_tags = ["python", "code", "dev", "python", "backend", "code"]

# 快速去重(注意:会打乱原始顺序)
unique_tags = list(set(raw_tags))

# 高性能白名单拦截
ALLOWED_IPS = {"192.168.1.10", "192.168.1.11", "10.0.0.1"}
client_ip = "192.168.1.10"

if client_ip in ALLOWED_IPS:  # O(1) 平均查找性能
    access_granted = True
2. 集合代数方法与运算符对比
Python为集合操作同时提供了运算符和方法两种书写方式。两者的核心区别在于:运算符两端必须都是集合,而方法可以接收任意可迭代对象(如列表、元组)。
| 运算类型 | 符号运算(要求同为set) | 方法调用(允许任意Iterable) | 语义描述 |
|---|---|---|---|
| 并集 | s1 | s2 |
s1.union(s2) |
包含两个集合中的全部去重元素 |
| 交集 | s1 & s2 |
s1.intersection(s2) |
仅包含同时存在于两者的公共元素 |
| 差集 | s1 - s2 |
s1.difference(s2) |
存在于s1但不存在于s2的独立元素 |
| 对称差集 | s1 ^ s2 |
s1.symmetric_difference(s2) |
仅属于s1或s2,排除二者共同部分 |
五、工程选型:如何做出正确的容器决策
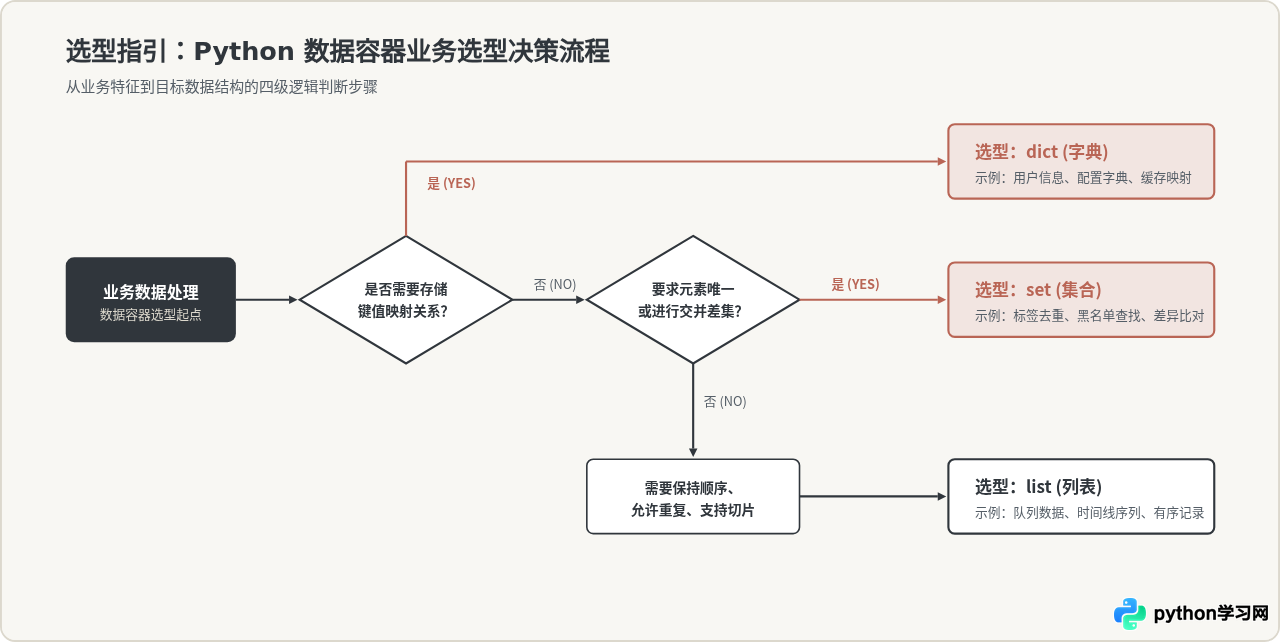
面对具体业务场景,究竟该选择列表、字典还是集合?我们可以依据四个判定维度建立决策树:
- 是否需要键值映射关联?如果需要通过唯一标识绑定属性,直选字典(
dict)。 - 元素是否必须唯一?如果需要强制去除重复项,直选集合(
set)。 - 是否强依赖元素物理位置与顺序?如果需要索引、切片、排序保持,直选列表(
list)。 - 高频操作是按下标读取还是检索判定?下标访问选列表,条件匹配/成员检测选集合或字典。
六、高频避坑指南
1. 陷阱一:可变对象作为函数默认参数
Python在定义函数时就会对默认参数求值,且只求值一次。如果将 list 或 dict 作为默认参数,所有未传入该参数的调用将共享同一个实例:
# 错误写法(多处调用共享同一个列表)
def append_item(val, container=[]):
    container.append(val)
    return container

print(append_item(1))  # 输出 [1]
print(append_item(2))  # 意外输出 [1, 2],而非预期的 [2]!

# 正确写法:使用 None 作为占位符
def safe_append_item(val, container=None):
    if container is None:
        container = []
    container.append(val)
    return container
2. 陷阱二:在遍历容器的同时修改其大小
在遍历 dict 或 set 时直接增加或删除元素,Python会抛出 RuntimeError: dictionary changed size during iteration。而在遍历 list 时删除元素会导致下标错位漏判。
# 错误示例:遍历字典中途删除
data_dict = {"a": 1, "b": 2, "c": 3}
# for k in data_dict:
#     if data_dict[k] % 2 == 0:
#         del data_dict[k]  # 触发 RuntimeError

# 健壮解决方式:转换为列表切片或新建容器
# 方案 A: 复制键集合遍历
for k in list(data_dict.keys()):
    if data_dict[k] % 2 == 0:
        del data_dict[k]

# 方案 B: 使用字典推导式重新生成(推荐)
filtered_dict = {k: v for k, v in data_dict.items() if v % 2 != 0}
3. 陷阱三:试图把不可哈希对象作为字典的键或集合的元素
字典的键与集合的元素必须是可哈希的(Hashable),即对象生命周期内哈希值固定且可比对。列表 list、字典 dict 和集合 set 自身是可变对象,属于不可哈希类型;而数字、字符串、元组(其内部子项也必须均可哈希)是可哈希的。
# 错误示例
# bad_set = {[1, 2], [3, 4]}  # 触发 TypeError: unhashable type: 'list'

# 正确做法:使用不可变容器 tuple 替代 list
good_set = {(1, 2), (3, 4)}
frozen_key_dict = {(1, 2): "coordinate"}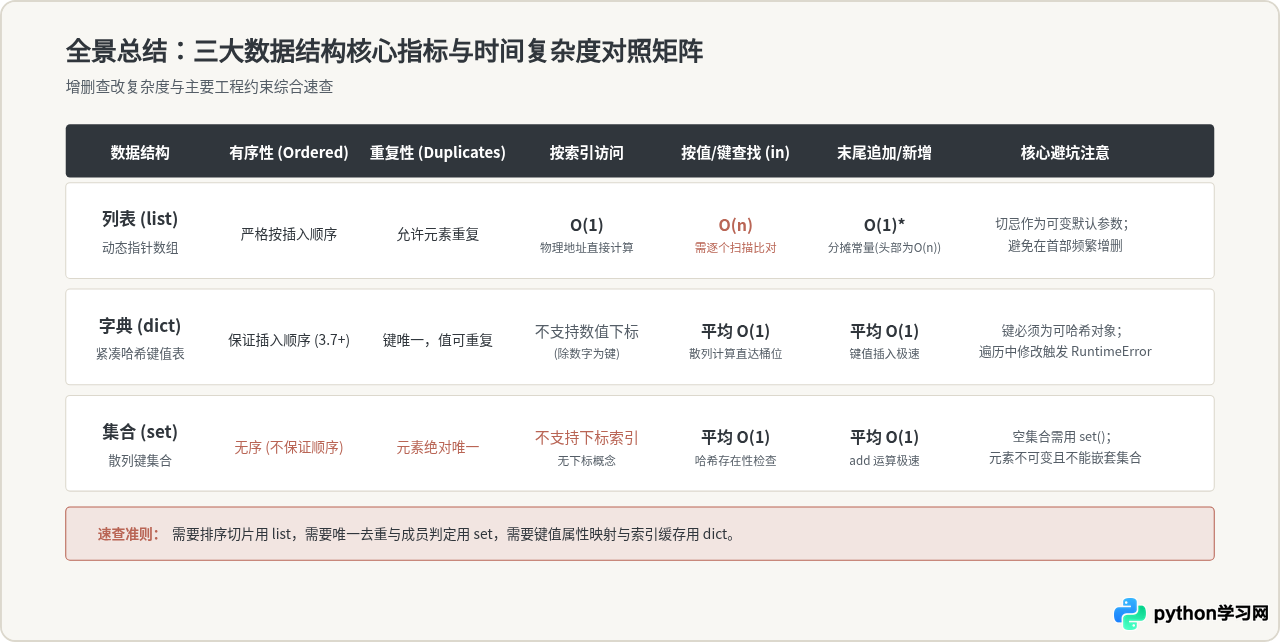
七、总结
列表、字典和集合构成了Python绝大多数数据流转的基石。在实际开发中:
- 利用列表维护具有时序性或依赖物理位置的数据,但在有高频查找诉求时尽早转换为字典或集合;
- 充分发挥字典的哈希检索优势与
get、defaultdict防御性读取能力,组织结构化配置与关联数据; - 善用集合的交并差集进行权限比对、去重过滤与差异化计算。
深入理解每种结构的内存代价与算法复杂度,能让写出的代码兼具优雅表达与卓越性能。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









