

避坑指南:为什么Python CPU密集型任务不建议用多线程
深入剖析为什么在标准 CPython 下 CPU 密集型任务不建议使用多线程,详解 GIL 机制、上下文切换开销与性能反降原因,并给出多进程与向量化等高效替代方案。
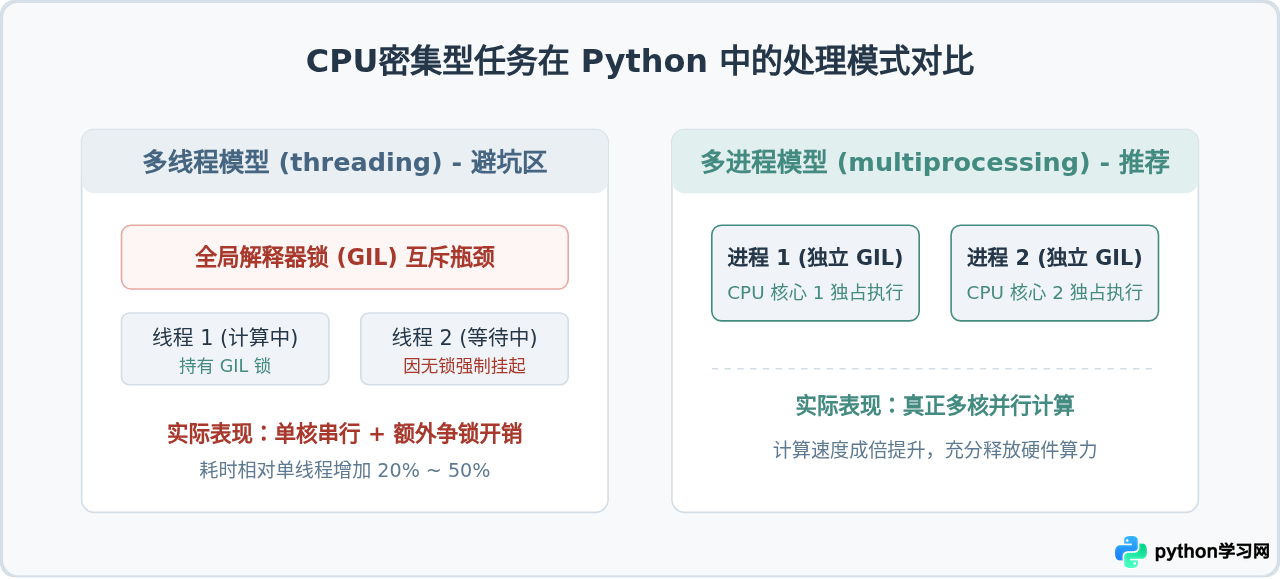
一、认识前提:CPU 密集型与 I/O 密集型的本质差异
在讨论 Python 的多线程特性之前,首先需要明确任务类型的划分。不同性质的代码对计算机底层硬件资源的需求截然不同:
- CPU 密集型任务(Compute-Bound):代码的主要开销集中在中央处理器运算上。典型场景包括大整数分解、图像像素滤镜处理、矩阵乘法、加密解密、压缩算法以及大量的循环数学运算。这类任务执行期间,CPU 核心使用率始终处于饱和状态(100%)。
- I/O 密集型任务(I/O-Bound):代码的大部分时间在等待输入输出设备响应。典型场景包括网络请求(HTTP 调用、爬虫)、文件读写、数据库 SQL 查询以及套接字通信。在这类任务中,CPU 大部分时间处于空闲等待状态,瓶颈在于网络延迟或磁盘读写吞吐。
许多初学者误以为“只要开启多线程,程序就能自动在多核 CPU 上并行跑起来”。在 Java、C++ 或 Go 语言中,操作系统级线程确实可以映射到不同 CPU 核心上实现真正的指令级并行。但在 Python 官方主流实现 CPython 中,这一设想被一个根本性的底层机制所阻断——那就是 GIL。
二、根本原因:CPython 的 GIL 与线程争锁风暴
CPython 是用 C 语言实现的 Python 官方解释器。为了管理内存中的 Python 对象,CPython 内部采用了引用计数(Reference Counting)作为基础垃圾回收机制。如果允许两个操作系统线程在不同的 CPU 核心上同时运行并修改同一个 Python 对象,引用计数就会发生竞态条件(Race Condition),进而引发内存损坏或内存泄漏。
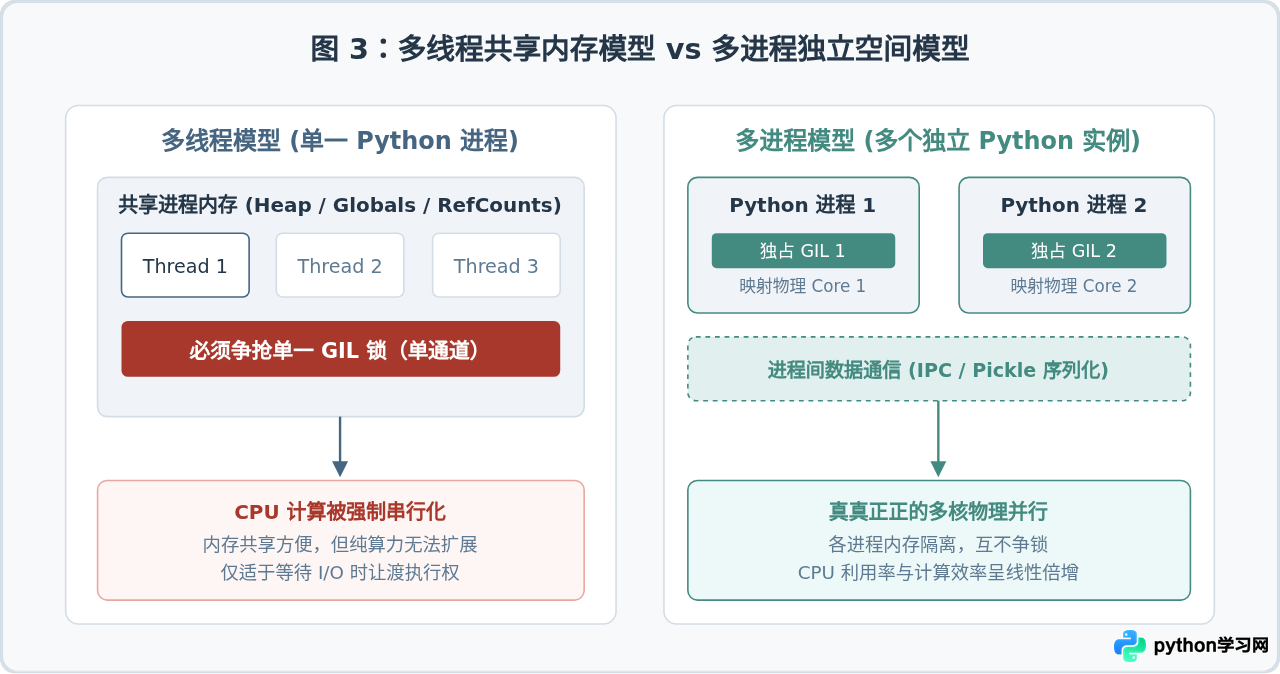
为了保证内存管理的安全性和 C 扩展库编写的简便性,CPython 引入了 全局解释器锁(GIL)。GIL 是一把互斥锁(Mutex),其核心规则极为刚性:无论物理宿主机拥有多少个 CPU 核心,任何一个 CPython 进程在任意微秒内,只允许恰好一个线程持有该锁并执行字节码。
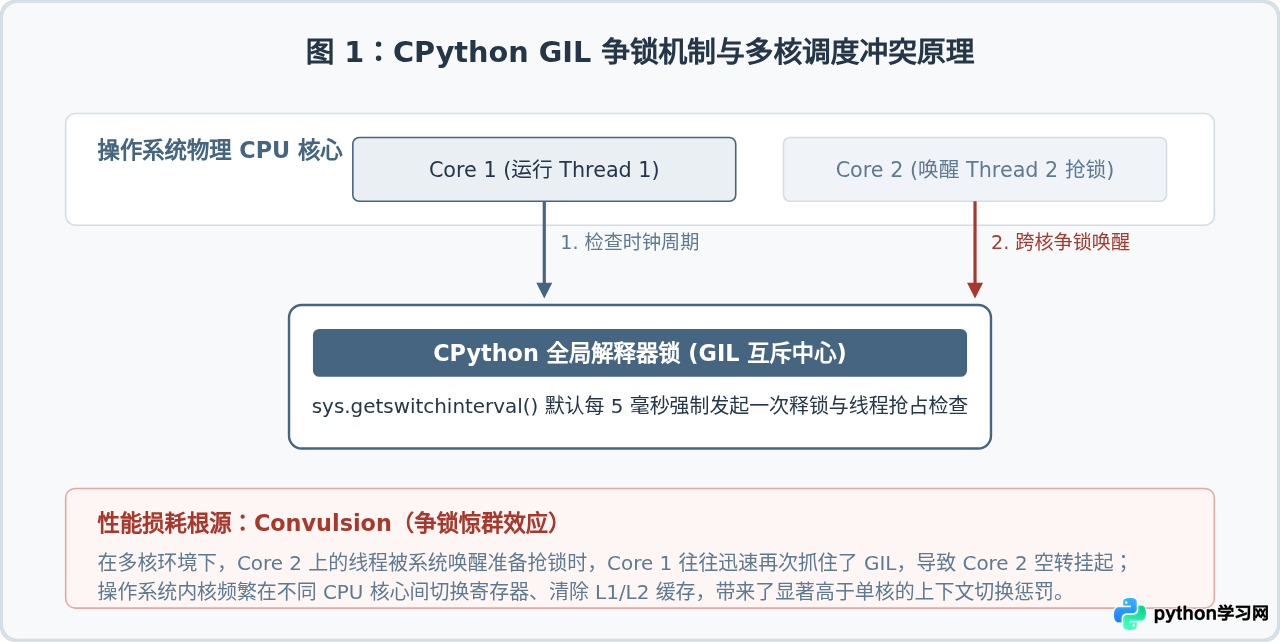
在 Python 3 中,解释器通过 sys.getswitchinterval() 设定线程切换间隔(默认值为 5 毫秒)。当一个 CPU 密集型线程持续运行时,解释器会在 5 毫秒后尝试释放 GIL,并向系统通知其他挂起的线程。
但这里存在一个严重的冲突:
- 伪并行本质:只要所有线程都在执行纯 Python 运算,无论给程序分配 4 个还是 8 个线程,它们都必须排队在同一个 GIL 漏斗前等待。计算总量丝毫没有减少。
- 惊群效应与锁争夺(GIL Convulsion):操作系统看到多个线程就绪,会把线程 2 分配到 Core 2 上去唤醒。然而刚刚释放锁的线程 1 仍然在 Core 1 上活跃,线程 1 极有可能在线程 2 真正拿到锁之前重新获取了 GIL。结果线程 2 白白醒来一次又重新进入睡眠状态。
- 高速缓存失效:多核系统在频繁的线程切换中,CPU 一级与二级高速缓存(L1/L2 Cache)被不断冲刷、重新加载,造成极大的机器指令空耗。
三、代码实测:单线程、多线程与多进程基准对比
口说无凭,我们通过一段标准的 CPU 密集型任务代码来验证上述理论。该测试执行一个高强度数学计算函数:计算大量连续整数的阶乘余数求和。
1. 测试任务定义与单线程基准
import time
import threading
from concurrent.futures import ProcessPoolExecutor

# 定义纯 CPU 密集型计算任务
def cpu_bound_task(n: int) -> int:
    total = 0
    for i in range(1, n):
        total += (i * i) % 1234567
    return total

TOTAL_WORK = 12000000  # 总计算量
SPLITS = 4             # 拆分为 4 个子任务
chunk_size = TOTAL_WORK // SPLITS

# --- 实验 1:单线程串行执行 ---
start_time = time.perf_counter()
results_single = [cpu_bound_task(chunk_size) for _ in range(SPLITS)]
single_duration = time.perf_counter() - start_time
print(f"单线程串行耗时: {single_duration:.3f} 秒")
2. 多线程测试代码(避坑验证)
# --- 实验 2:多线程执行 (4 个线程) ---
start_time = time.perf_counter()
threads = []
for _ in range(SPLITS):
    t = threading.Thread(target=cpu_bound_task, args=(chunk_size,))
    threads.append(t)
    t.start()

for t in threads:
    t.join()

thread_duration = time.perf_counter() - start_time
print(f"4 线程并行耗时: {thread_duration:.3f} 秒")
3. 多进程测试代码(正确方案)
# --- 实验 3:多进程并行执行 (4 个独立进程) ---
if __name__ == '__main__':
    start_time = time.perf_counter()
    with ProcessPoolExecutor(max_workers=SPLITS) as executor:
        results_process = list(executor.map(cpu_bound_task, [chunk_size] * SPLITS))
    process_duration = time.perf_counter() - start_time
    print(f"4 进程并行耗时: {process_duration:.3f} 秒")
4. 测试数据与耗时拆解
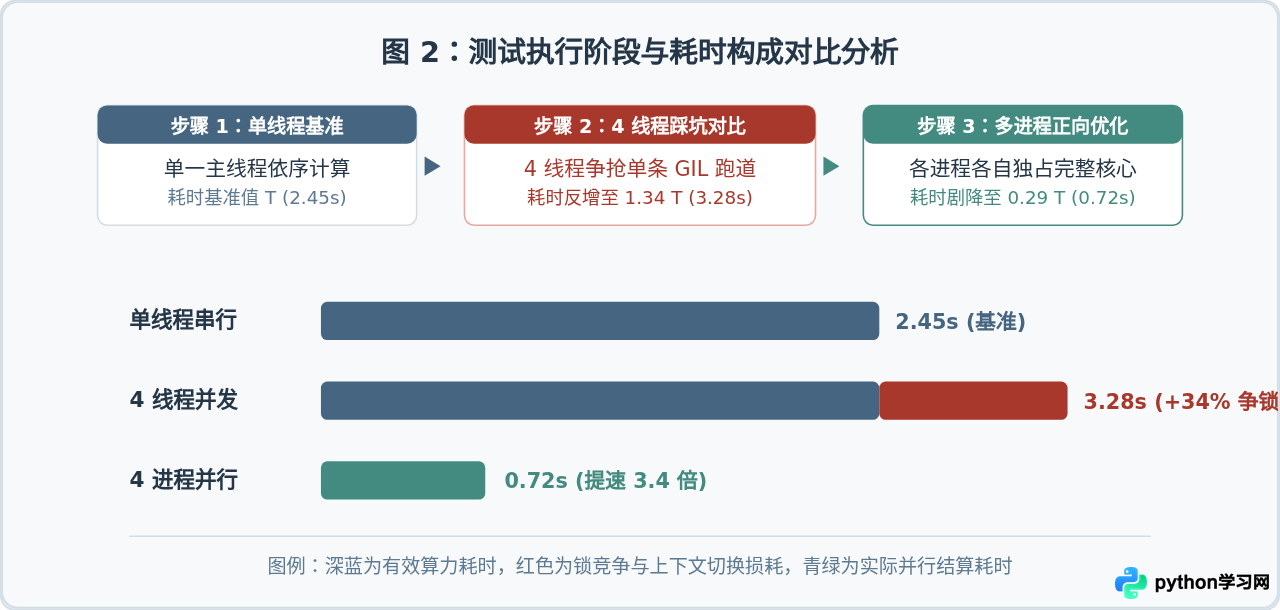
在 4 核心(或以上)的现代硬件配置上运行上述代码,会获得如下典型数据表现:
| 执行模式 | 工作线程/进程数 | 实际耗时(示例) | 相对单线程加速比 | CPU 整体利用率 |
|---|---|---|---|---|
| 单线程串行 | 1 线程 | 2.45 秒 | 1.00x(基准) | 单核 100%(总 25%) |
| 多线程(threading) | 4 线程 | 3.28 秒 | 0.75x(性能下降 34%) | 跨核抖动,单核等效 100% |
| 多进程(multiprocessing) | 4 进程 | 0.72 秒 | 3.40x(接近线性加速) | 四核满载 100%(总 100%) |
四、对比解析:为什么 I/O 密集型适合多线程,而 CPU 密集型不行?
一个常见的困惑是:“如果 GIL 会锁住一切,为什么网络爬虫、文件读取等任务大家都在大量使用多线程?”
关键差异在于:CPython 对 I/O 操作有专门的锁释放优化。
当 Python 线程执行底层 I/O 阻塞调用(如 socket.recv()、time.sleep()、文件读取 read() 或数据库驱动与网络套接字通信)时,CPython 内部会立即主动释放 GIL(调用宏 Py_BEGIN_ALLOW_THREADS)。直到底层系统调用返回数据后,该线程才会重新请求获取 GIL(Py_END_ALLOW_THREADS)。
因此在 I/O 等待期间,CPU 完全可以交出执行权给其他线程。这种交替运行极大地利用了等待网络或磁盘的时间差,带来显著的并发吞吐提升。相反,CPU 密集型任务完全在执行 Python 语法指令,根本不会触发这种主动释放,只能在固定的时钟周期内发生粗暴的“抢锁中断”。
五、破局之道:CPU 密集型任务的正确解决方案
理解了为什么多线程不适用后,在 Python 中处理 CPU 密集型任务时,我们应当如何根据具体工程需求选择正确解法?以下是经过生产检验的主流路径:
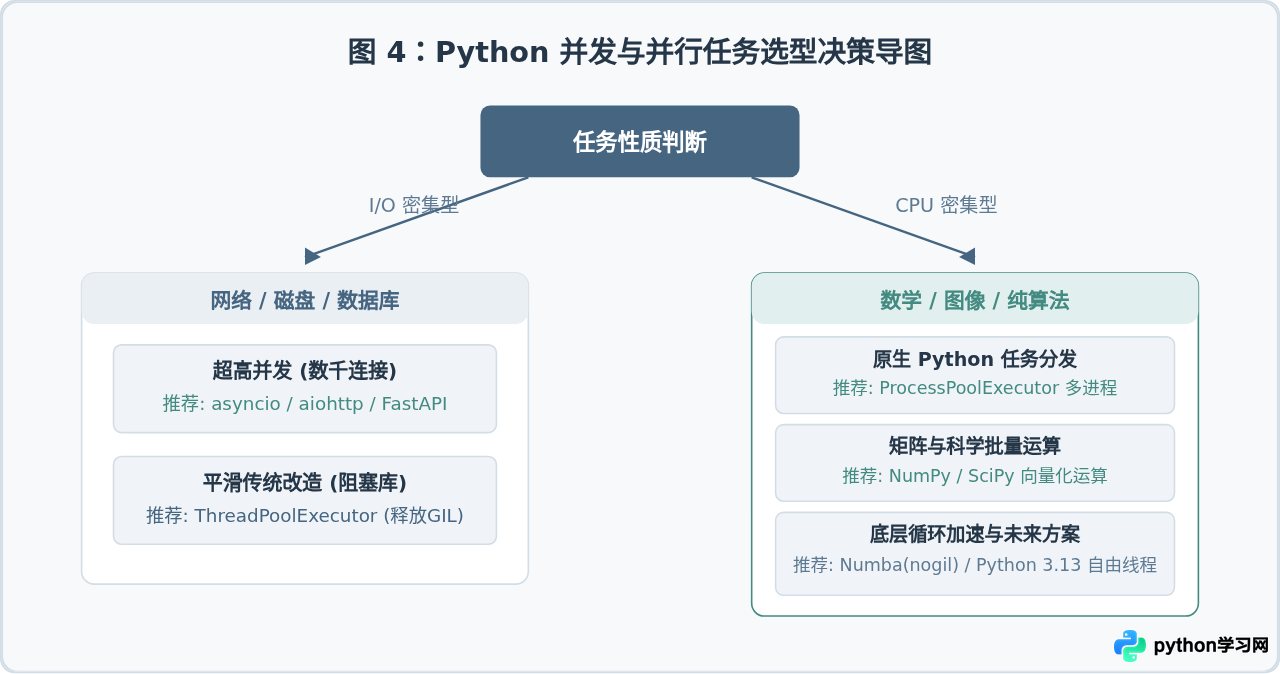
1. 使用标准库 ProcessPoolExecutor(首选标准方案)
Python 3 提供的 concurrent.futures.ProcessPoolExecutor 是替代多线程的最直观方案。它封装了 multiprocessing 模块,提供友好的上下文管理器和面向未来的 map/submit API:
from concurrent.futures import ProcessPoolExecutor
import os

def heavy_computation(data_item):
    # 处理单个数据项,无 GIL 跨进程干扰
    return data_item ** 2

if __name__ == '__main__':
    data = list(range(1000000))
    # 根据 CPU 物理核心数自动分配进程池
    workers = os.cpu_count() or 4
    with ProcessPoolExecutor(max_workers=workers) as executor:
results = list(executor.map(heavy_computation, data, chunksize=10000))注意要点:进程间传递数据需要经过 pickle 序列化与反序列化,因此避免在主进程与子进程之间高频传递巨大的 Python 原生数据结构。最好一次性传入切片批次(如合理设置 chunksize),或者利用共享内存(multiprocessing.shared_memory)。
2. 采用科学计算库与底层 C/C++ 扩展(释放 GIL)
如果任务主要由矩阵运算、向量统计、信号分析或图像处理组成,应当优先采用如 NumPy、SciPy、PyTorch 或 OpenCV 等底层库。
这些第三方专业库的底层核心代码大多由 C/C++ 或 Fortran 编写。在进入密集数学计算阶段时,它们会在 C 语言层面调用 Py_BEGIN_ALLOW_THREADS 显式释放 GIL,并在多线程下调用 OpenMP 或 Intel MKL/BLAS 库直接利用硬件多核并行。此时即使在 Python 层面使用多线程,也不会受到 GIL 锁的牵制。
3. 使用 Cython 或 Numba 进行 JIT 编译加速
对于无法轻易向量化的复杂算法逻辑:
- Numba:通过添加
@numba.jit(nopython=True, nogil=True)装饰器,不仅能将 Python 函数即时编译为机器码,还能直接声明释放 GIL,实现多线程物理并发。 - Cython:在
.pyx代码中使用with nogil:代码块编写纯 C 级别循环运算,彻底摆脱解释器锁开销。
4. Python 3.13+ 的自由线程模式(Free-threaded CPython)
自 Python 3.13 起,社区正式引入了 PEP 703(Making the Global Interpreter Lock Optional in CPython)。官方提供了无 GIL 构建版本(通过编译参数 --disable-gil 安装)。在自由线程模式下,多线程确实可以真正同时在多核上运行 Python 字节码。不过,目前该特性仍属于实验性质阶段,许多第三方 C 扩展尚未完全完成无锁适配,在生产环境中大规模应用仍需一定过渡期。
六、总结与技术选型决策导图
在面对 Python 性能调优与并发设计时,可以通过下面的选型决策树,快速判定最合适的技术路径:
核心要点速查
- 为什么不能用:由于 CPython 的 GIL 限制,多线程处理 CPU 密集型任务不仅不能并行,反会因内核跨核心争锁和上下文切换带来净性能损耗。
- 何时能用多线程:仅推荐用于网络请求、磁盘读写等 I/O 密集型任务,这些任务阻塞时会主动出让 GIL。
- 最轻量的替换方案:将
ThreadPoolExecutor替换为ProcessPoolExecutor,用多进程完全绕开 GIL 限制。 - 极限性能首选:使用
NumPy向量化计算,或者借助Cython、Numba在 C 级别主动释放 GIL,获得极致的多核硬件利用率。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









