

python必背源代码字典按值排序代码
详解Python中字典按值排序的核心源代码与实现原理,涵盖sorted函数、lambda表达式、itemgetter用法、升序降序及复合排序,附完整步骤、图解与代码示例。
一、核心解决方案:两行必须熟记的代码
在面对“字典按值排序”的需求时,不需要手动编写冒泡或快速排序算法。以下是直接可用的标准一行式代码模板:
# 原始字典数据示例
scores = {"数学": 88, "英语": 95, "语文": 72, "物理": 88}

# 1. 按值升序排序(从小到大)
sorted_asc = dict(sorted(scores.items(), key=lambda item: item[1]))

# 2. 按值降序排序(从大到小)
sorted_desc = dict(sorted(scores.items(), key=lambda item: item[1], reverse=True))

# 打印验证结果
print("升序结果:", sorted_asc)
# 输出: {'语文': 72, '数学': 88, '物理': 88, '英语': 95}

print("降序结果:", sorted_desc)
# 输出: {'英语': 95, '数学': 88, '物理': 88, '语文': 72}
从输出可以看出,排序不仅改变了键值对的相对前后顺序,而且完整保留了字典的数据类型。自 Python 3.7 起,字典能够按照插入顺序维护内部元素的排列,因此将排序好的元组列表直接传给 dict() 即可稳定保持排好序的输出。
二、深入底层:字典按值排序的数据流动机制
很多初学者容易直接写出 sorted(d),结果发现输出的仅仅是排好序的字典键列表(['数学', '物理', '英语', '语文']),值不仅没有参与比较,甚至在输出中彻底丢失。
之所以产生这种现象,是因为 Python 在直接对字典迭代时,默认只产出 key。为了按值排序,必须先用 d.items() 导出包含 (键, 值) 的动态视图,将数据送入底层基于 Timsort 算法的 sorted() 引擎,提取元组索引为 1 的数值进行权衡,最终再把排好序的元组序列送入 dict() 构造器中完成重建。
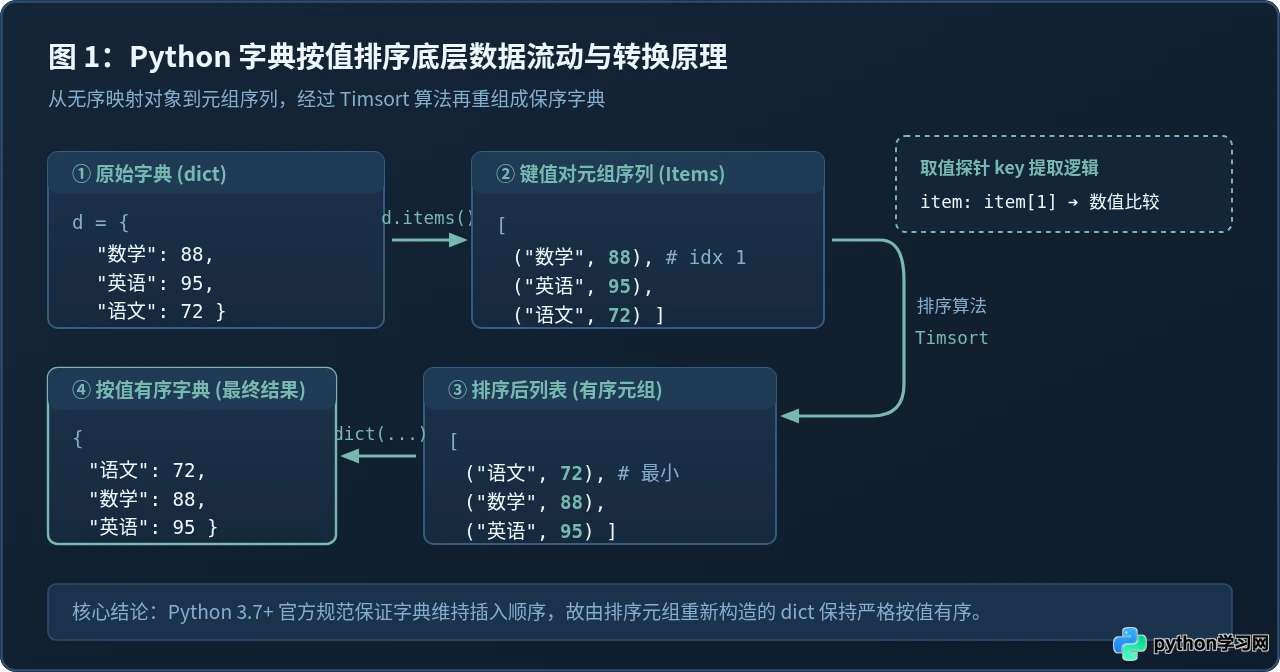
如上图所示,整个流程包含清晰的数据形态演变:
- 字典映射形态:原始哈希字典以键为索引,无序或保持既有插入顺序。
- 键值对序列形态:通过
.items()展平成由元组构成的集合视图。 - Timsort 排序执行:内置
sorted()提取元组中位于下标 1 的 Value 进行对比排序,输出新的有序元组列表。 - 新字典重建形态:
dict()逐一消费有序元组,构建出键值对应且保序的新字典对象。
三、逐步拆解:四步实操与语法结构分析
将一行代码拆解为具体的执行步骤,可以更透彻地理解各个参数所承担的角色:
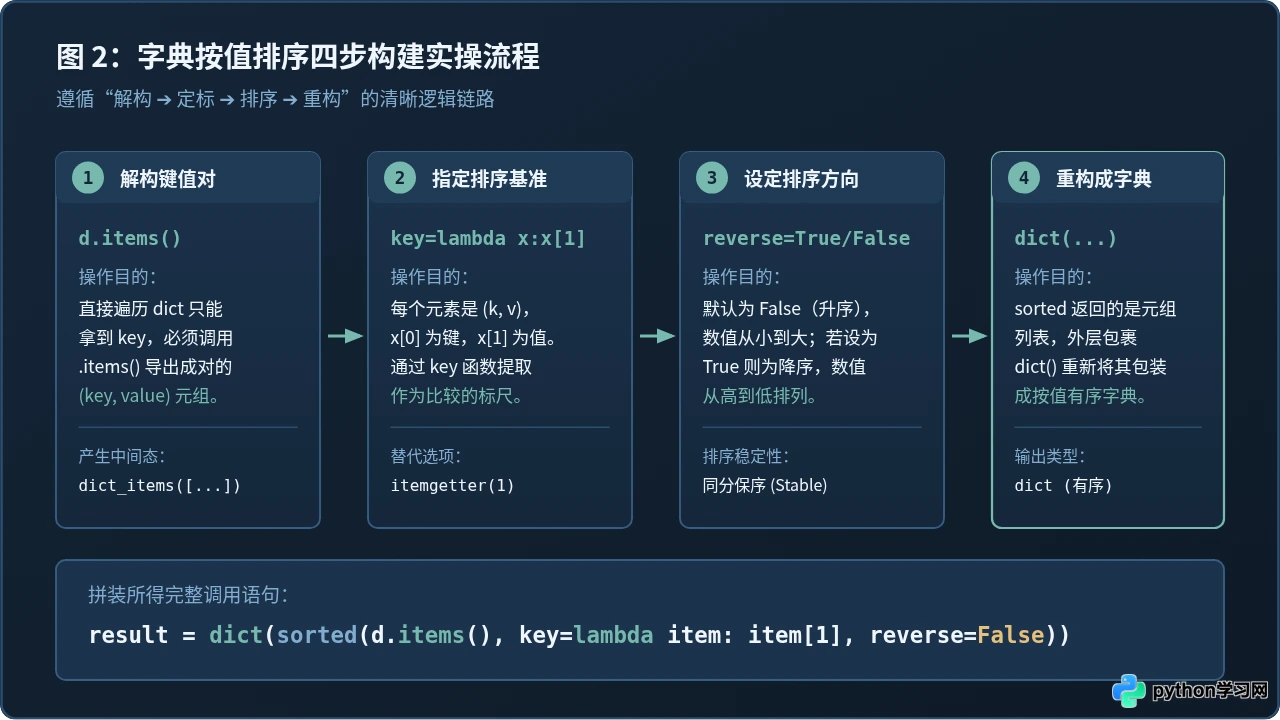
步骤 1:调用 items() 导出键值元组
scores.items() 返回一个只读的视图对象。当遍历这个对象时,每个元素都是长度为 2 的独立元组:(key, value)。例如 ("数学", 88)。
步骤 2:使用 key 参数与 lambda 绑定排序标尺
sorted() 函数接收可迭代对象,并为其中的每一个元素执行 key 所指定的函数。这里的匿名函数 lambda item: item[1] 接收一个元组 item,返回其第二个分量 item[1](即实际的值)。比较器在运转时便只拿返回值作为比对依据。
步骤 3:配置 reverse 控制正序与倒序
参数 reverse 默认为 False,表示升序;若设置为 reverse=True,Timsort 算法会从大到小排列元素。Python 的排序算法是稳定的(Stable Sort),在分值相同的情况下,会保持原始字典中出现的先后相对次序。
步骤 4:外层包裹 dict() 还原字典
sorted() 本身永远返回一个标准列表 list。为了在后续业务逻辑中继续享受字典的根据键查询性能(O(1) 复杂度),使用 dict() 重新转换即可。
四、进阶方案:operator.itemgetter 与复合双键排序
掌握基础写法后,根据不同的生产场景,还可以选用更具针对性的进阶写法。
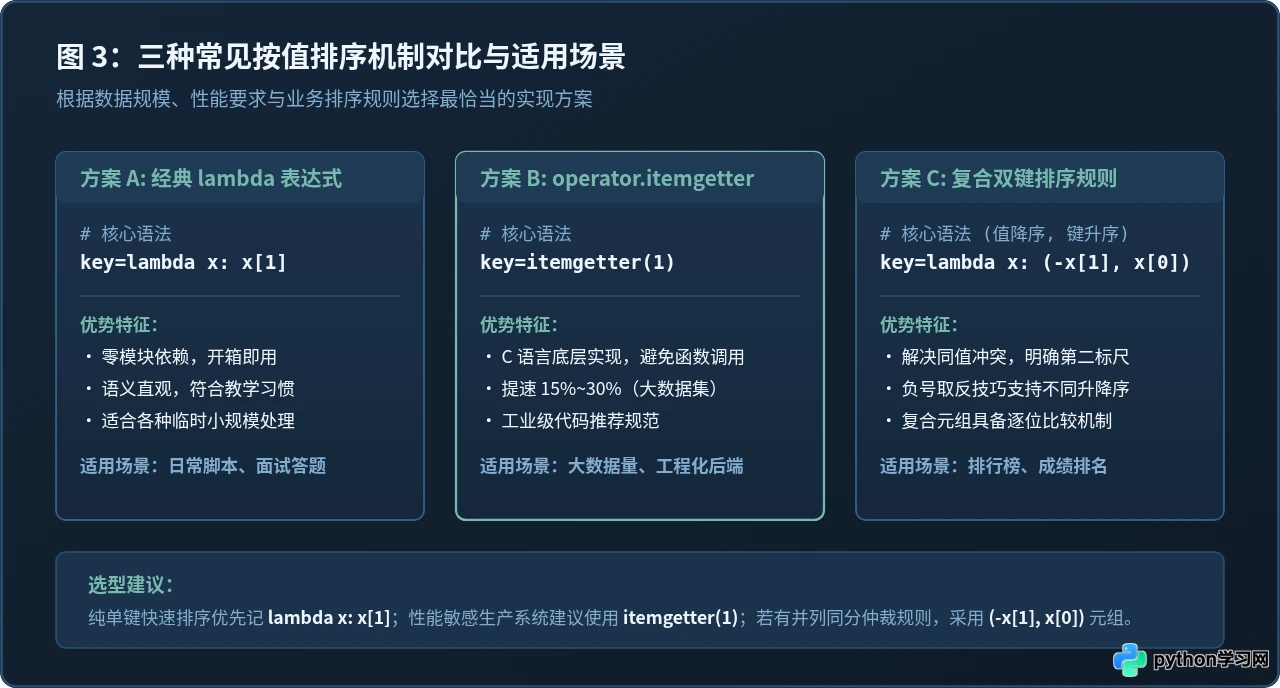
1. 性能更优的工业级写法:operator.itemgetter
在处理数万至数百万级键值对的高性能场景下,lambda item: item[1] 每次循环都需要经过 Python 解释器的函数调用栈,存在一定的开销。标准库 operator 模块提供的 itemgetter 是在 C 语言层面实现的,执行效率通常比 lambda 高出 15% 到 30%:
from operator import itemgetter

scores = {"数学": 88, "英语": 95, "语文": 72, "物理": 88}

# 使用 itemgetter(1) 替代 lambda item: item[1]
sorted_dict = dict(sorted(scores.items(), key=itemgetter(1), reverse=True))
print(sorted_dict)
# 输出: {'英语': 95, '数学': 88, '物理': 88, '语文': 72}
2. 复合双键排序(值相同按键字母升序)
在实际业务中经常遇到并列情况:例如两门学科得分相同(数学 88、物理 88),业务规定分数相同时必须按照学科名称的拼音或字母顺序升序排列。此时可以利用元组逐项比较的天然特性,让 key 函数返回一个二元组:
data = {"bob": 85, "alice": 92, "charlie": 85, "david": 92}

# 要求:分数降序(负号取反);当分数相同时,姓名按字母升序
sorted_complex = dict(sorted(
    data.items(),
    key=lambda item: (-item[1], item[0])
))

print(sorted_complex)
# 输出: {'alice': 92, 'david': 92, 'bob': 85, 'charlie': 85}
在上述代码中,-item[1] 将数值取反,从而使外层维持默认升序遍历时呈现出数值降序的效果;而第二个元素 item[0] 未取反,依然按默认升序比对字符串,完美达成了多维度的业务排序需求。
3. 极值提取场景:无需全量排序的 Top-K 优化
如果字典中有一万个条目,但实际只需要得分最高的前 3 个,做全量排序(复杂度 O(N log N))是不必要的性能浪费。此时可以使用 heapq.nlargest,在 O(N log K) 时间内完成:
import heapq

huge_dict = {"user_" + str(i): i for i in range(10000)}

# 仅获取前 3 名最大值
top_3 = dict(heapq.nlargest(3, huge_dict.items(), key=lambda x: x[1]))
print(top_3)
# 输出: {'user_9999': 9999, 'user_9998': 9998, 'user_9997': 9997}
五、常见错误与避坑清单
直接对字典调用 d.sort() 会抛出 AttributeError: 'dict' object has no attribute 'sort'。列表 list 有原地 .sort(),而字典仅能借助内置的全局 sorted() 函数生成新对象。
若写成 sorted(d, key=...),由于直接对 d 迭代只产生 key,如果 key 函数里还尝试用 x[1] 取值,若 key 是字符串就会取到字符串的第二个字符,或者若 key 是整数则抛出 TypeError: 'int' object is not subscriptable。务必保证传入的是 d.items()。
Python 3 中移除了不同数据类型之间的隐式比较规则。如果字典的值中混杂了数值与字符串(例如 {"a": 10, "b": "20"}),或者包含了 None,在调用 sorted() 时会触发 TypeError: '<' not supported between instances of 'str' and 'int'。进行排序前应先清洗数据或统一转换类型。
六、必背源代码总结速查
在日常开发与算法面试中,字典按值排序属于高频考点。将常用的场景代码归纳如下,建议直接记忆并套用:
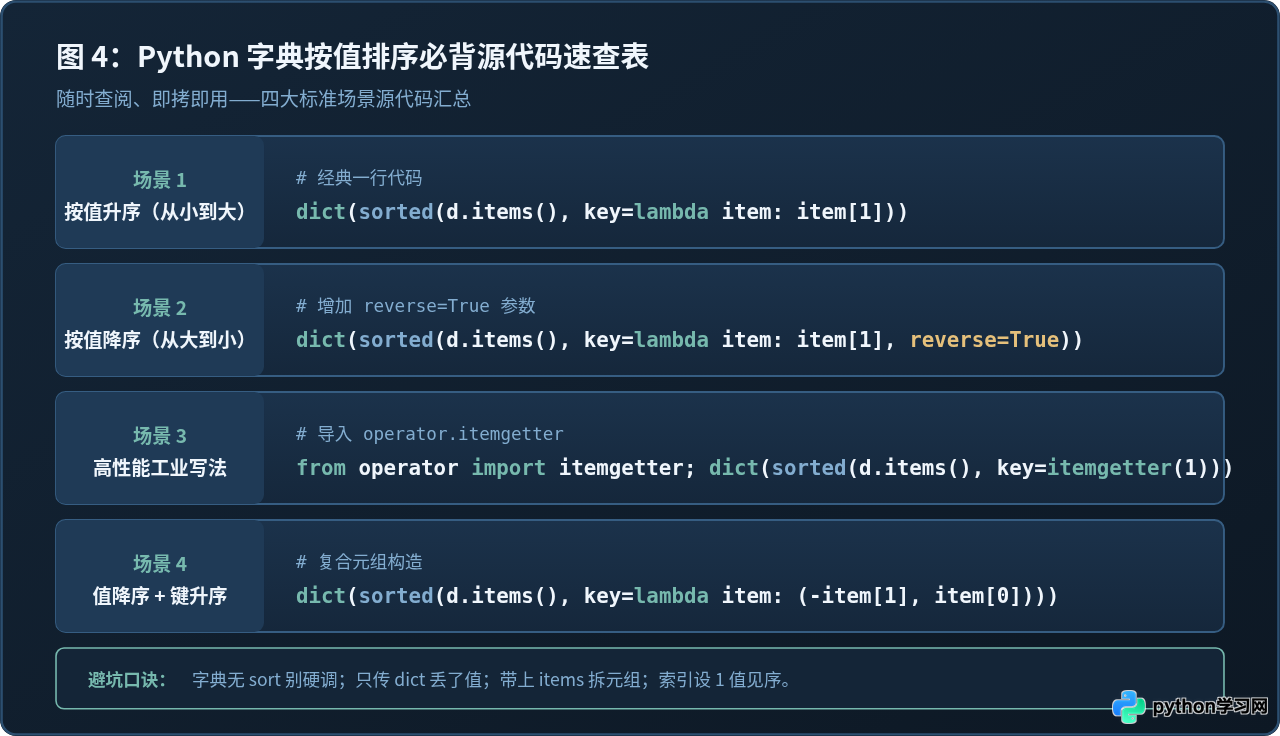
| 排序目标 | 核心必背源代码 | 依赖说明 |
|---|---|---|
| 按值升序(标准) | dict(sorted(d.items(), key=lambda x: x[1])) |
无需导入任何外部模块 |
| 按值降序(标准) | dict(sorted(d.items(), key=lambda x: x[1], reverse=True)) |
增加 reverse=True |
| 工业级性能优化 | from operator import itemgetter |
内置标准库 operator,C层提速 |
| 复合排序(值降序,键升序) | dict(sorted(d.items(), key=lambda x: (-x[1], x[0]))) |
利用元组逐项比较机制 |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









