

怎么判断自己的Python水平是否达到就业标准
本文提供一套客观、可落地的Python就业水平自测方法,从核心技术维度、工程交付标准、实战验证流程到常见认知误区,帮助求职者准确判断自身技术能力是否达到岗位用人要求。
许多初学者在学完Python基础语法、看完整套视频教程并跟着敲完几段示例代码后,往往会陷入“自我感觉学会了,但打开招聘软件却发现岗位要求一条也对不上”的困惑。这种断层并非源自学习不够用功,而是因为学习阶段的知识考核往往停留在单点语法和局部函数,而企业用人单位考察的则是端到端的需求实现、团队协作与代码维护能力。
一、能力定位:从语法学习者到工程交付者的跨越
企业招聘初级Python工程师(无论是Web后端开发、数据分析与自动化处理、还是测试开发与运维自动化),本质上是在购买“能够稳定交付可用代码”的生产力。衡量自身是否迈过就业门槛,首先需要对自己的能力层级建立清晰的参照。
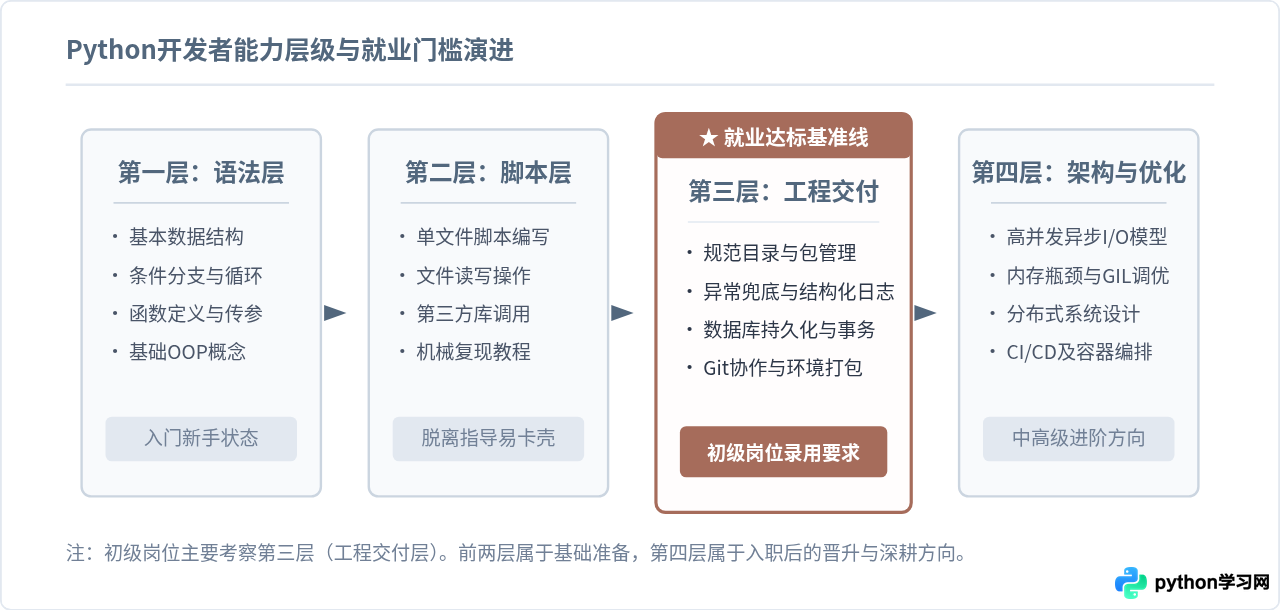
处于第一层和第二层的求职者,代码通常具有明显的“单脚本”特征:所有逻辑挤在一个 main.py 中,配置信息直接硬编码在代码里,没有虚拟环境管理,遇到报错只能把错误信息复制到搜索引擎。而第三层(工程交付层)要求你能够理解整个项目的骨架,遵循工业界标准规范完成开发。
二、核心维度自测:四大硬性技术指标
不同企业对岗位的具体职责划分虽有差异,但任何一个接纳初级开发者的团队,都会从以下四个基础维度来检验应聘者的专业深度。
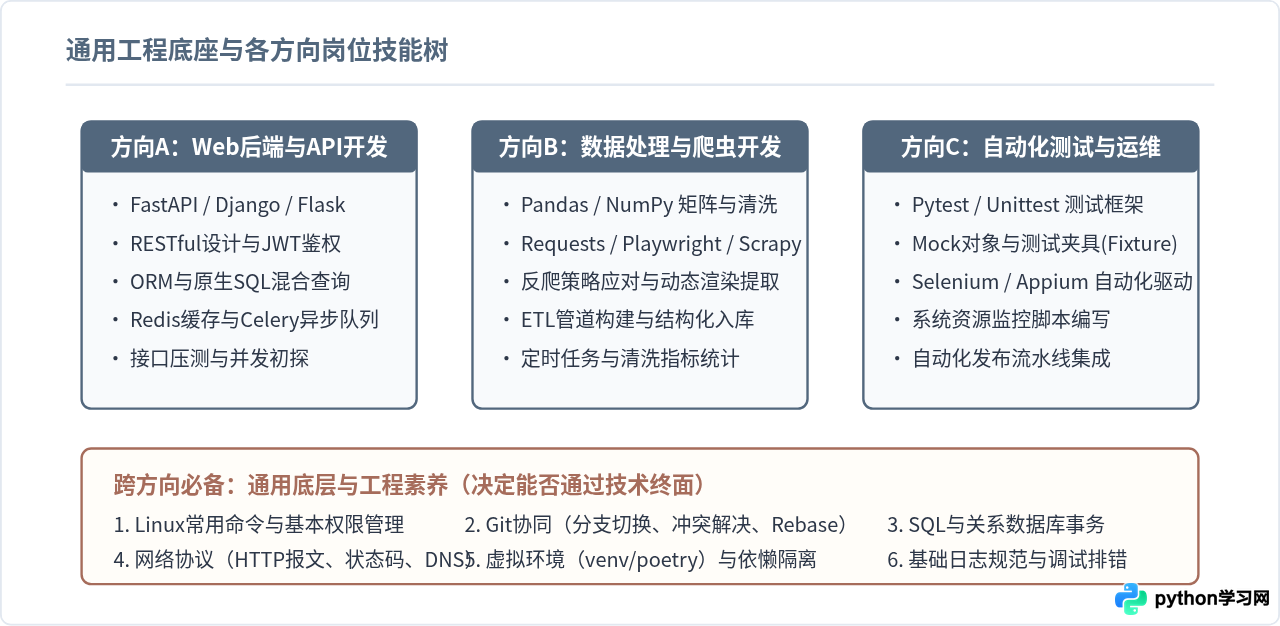
1. 语言核心机制与标准库熟练度
能够熟练使用并不等同于真正理解运行原理。你需要自测以下问题能否清晰阐述:
- 对象模型与引用机制:清楚可变对象(list, dict, set)与不可变对象(int, str, tuple)在函数传参时的行为差异,避免使用可变对象作为函数默认参数。
- 迭代器与生成器:理解
yield的运行机制与内存节约原理,能在处理大容量文本或数据库游标时优先选用生成器模式。 - 装饰器与闭包:不仅能读懂
@login_required,还能自己写出带参数的性能统计或鉴权装饰器,并保留原有函数的元数据(functools.wraps)。 - 上下文管理器:明白
with语句背后的__enter__与__exit__协议,能够为非标准网络连接或自定义临时文件编写上下文管理器。
2. 异常处理与工程健壮性
初学者代码最明显的破绽就是滥用裸 try...except Exception: pass。在企业项目中,这种写法会彻底吞噬关键报错,导致线上故障难以定位。
达标的代码风格应具备精细化捕获、现场记录与合理转译。例如在处理外部网络请求和数据库写入时:
import logging
import requests
from requests.exceptions import RequestException

logger = logging.getLogger(__name__)

def fetch_upstream_account(user_id: int) -> dict:
    url = f"https://api.internal.service/users/{user_id}"
    try:
        response = requests.get(url, timeout=3.0)
        response.raise_for_status()
        return response.json()
    except requests.Timeout:
        logger.warning("上游服务响应超时, user_id=%s", user_id)
        raise ServiceUnavailableError("上游用户中心响应超时")
    except RequestException as err:
        logger.error("请求上游服务失败, user_id=%s, err=%s", user_id, err, exc_info=True)
        raise UpstreamServiceError("系统通信异常") from err
达标要求:不吞噬未知异常、对已知边界进行显式处理、记录带上下文的日志,并向调用端返回具有明确语义的状态。
3. 关系型数据库与SQL能力
几乎所有Python业务岗位都会与数据库打交道。许多自学者完全依赖 Django ORM 或 SQLAlchemy 的自动迁移,一旦遇到以下实际场景便束手无策:
- 能否直接手写基础的
JOIN、GROUP BY与多表聚合查询? - 是否清楚数据库索引的最左前缀原则,知道为什么对
WHERE date(created_at) = '2026-01-01'查询会导致索引失效? - 在执行批量写入或扣减余额等操作时,是否知道如何开启事务,并在发生异常时确保
rollback?
4. 模块化工程目录与配置隔离
能否按照生产规范组织项目结构?一个达到商业级交付标准的Python项目,目录绝不会把业务逻辑、测试用例和环境配置混杂在一起:
my_project/
├── app/
│   ├── __init__.py
│   ├── api/             # 路由与控制器
│   ├── core/            # 配置文件与全局设置
│   ├── models/          # 数据库实体映射
│   ├── schemas/         # 数据校验与序列化规范
│   └── services/        # 核心业务逻辑实现
├── tests/               # 自动化单元测试与集成测试
├── .env.example         # 环境变量模板(密码/密钥禁止进仓库)
├── .gitignore           # 过滤虚拟环境与缓存文件
├── Dockerfile           # 生产部署容器定义
├── README.md            # 项目启动与接口文档说明
└── pyproject.toml       # 项目依赖规范与版本锁定
三、实战验证:4步闭环自测法
判断自身技术是否达标,最客观的手段是进行一次脱离参考答案的“模拟实战自测”。按照以下4个步骤对自己的综合编码能力进行压力测试:
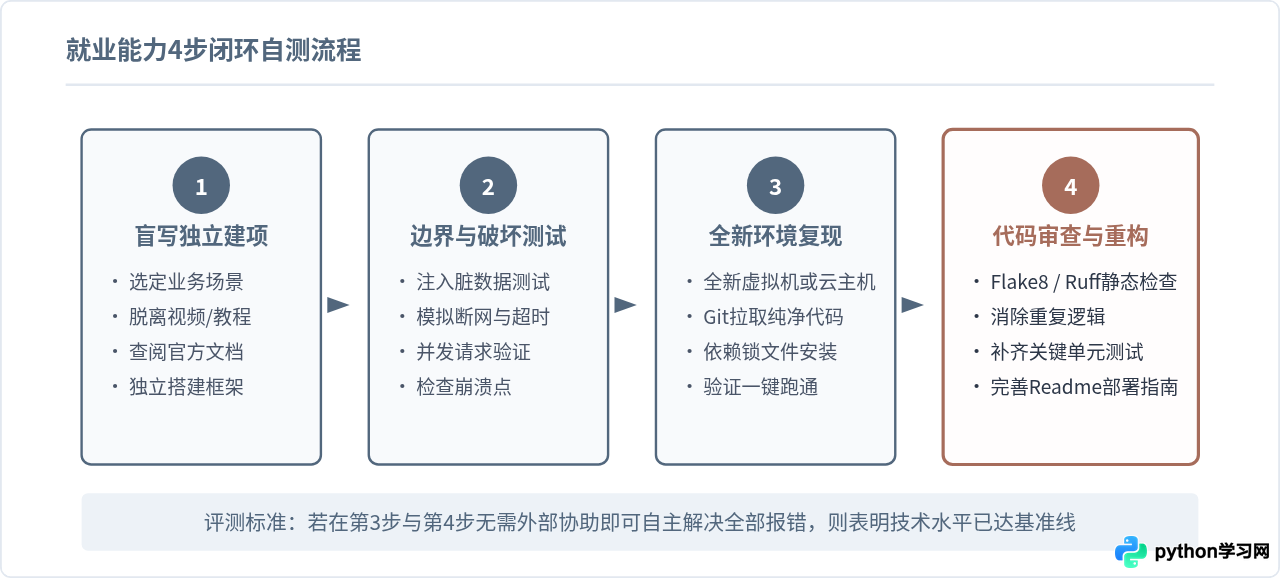
步骤一:盲写独立建项(耗时验证:1-2天)
给自己拟定一个不大的需求,比如“一个支持按标签分类的个人任务管理API”或“抓取指定公开资讯并清洗入库的后台服务”。要求:
- 禁止打开任何现成的“教学视频”或“手把手博文”。
- 只允许查看 Python 官方文档以及所用第三方库的官方 API 文档(如 FastAPI 官方文档、Pandas 官方手册)。
- 自行从新建虚拟环境(
python -m venv .venv)开始,逐步安装依赖并创建项目目录结构。
步骤二:边界注入与压力自测
写完正常流程后,主动向程序输入恶意或异常数据:
- 向接口传入缺失字段的 JSON、超长字符串、非法格式的手机号或日期。
- 人为切断数据库连接,或给外部网络请求设置极短超时(如
timeout=0.01),观察程序是否优雅报错还是直接抛出 500 异常瘫痪。 - 观察系统日志是否能清楚展示“在哪个模块、因为什么原因失败”,而不是仅仅打印一行没有堆栈的简单文本。
步骤三:纯净环境迁移验证
找一台全新的 Linux 云服务器,或者在本地使用纯净的 Docker 容器环境:
- 仅通过
git clone将代码从 GitHub / Gitee 仓库拉取下来。 - 通过环境依赖文件(
requirements.txt或poetry.lock)执行一键安装。 - 配置环境变量后直接启动运行。如果此时提示缺少某些依赖、某些路径写死了本地绝对路径(如
C:\Users\admin\...),说明代码的工程封装未达标。
步骤四:静态检查与规范重构
在本地终端执行代码风格与静态类型检查:
# 检查 PEP8 规范与常见语法漏洞
ruff check .

# 检查类型注解一致性
mypy app/
如果能在没有警告的前提下通过检查,并写好 3-5 个覆盖核心逻辑的 pytest 用例,这套代码已经具备了作为求职代表作的资格。
四、避开三大常见认知误区
在评估自身水平时,求职者常常受到网络言论的影响,产生不切实际的焦虑或盲目的自信:
误区一:误以为“算法刷满300题才能找工作”
很多初学者花费数月时间在 LeetCode 上刷中高难度动态规划题,却连怎么连接 MySQL 都不会。现实情况是:除了极少数头部一线大厂在校招中对算法有极高权重外,绝大多数中小企业和常规科技公司,面试更看重的是你的业务实现能力、SQL熟练度、框架理解与故障排查经验。基本的常用数据结构(字典、哈希集、队列、二分查找)必须掌握,但不必过度沉迷偏题怪题。
误区二:过度依赖 AI 代码补全而丧失独立排错能力
现代开发工具中 AI 辅助编码非常普及。但如果你只会在聊天窗口中输入“帮我写一个爬虫”,遇到报错就把报错贴回去盲目尝试,一旦进入面试现场手撕代码或遇到复杂的生产网络故障,就会彻底原形毕露。你可以使用工具提高输入效率,但每一行代码的逻辑、可能出现的副作用以及底层调用的时序,必须自己能讲得清清楚楚。
误区三:项目数量堆砌但全部都是千篇一律的课后Demo
简历上写满“图书管理系统”“学生选课系统”“电商单体商城”,但三个项目的代码结构、技术栈、处理逻辑完全一致,且没有上线、没有测试、没有监控。企业用人部门宁可看到一个真正解决具体问题、部署在公网、处理过数据校验与并发冲突的小工具,也不想看十个毫无真实思考的抄书项目。
五、达标对照清单:全方位综合评分
在投递简历前,可通过下表逐项核对自身的知识储备与实操能力:
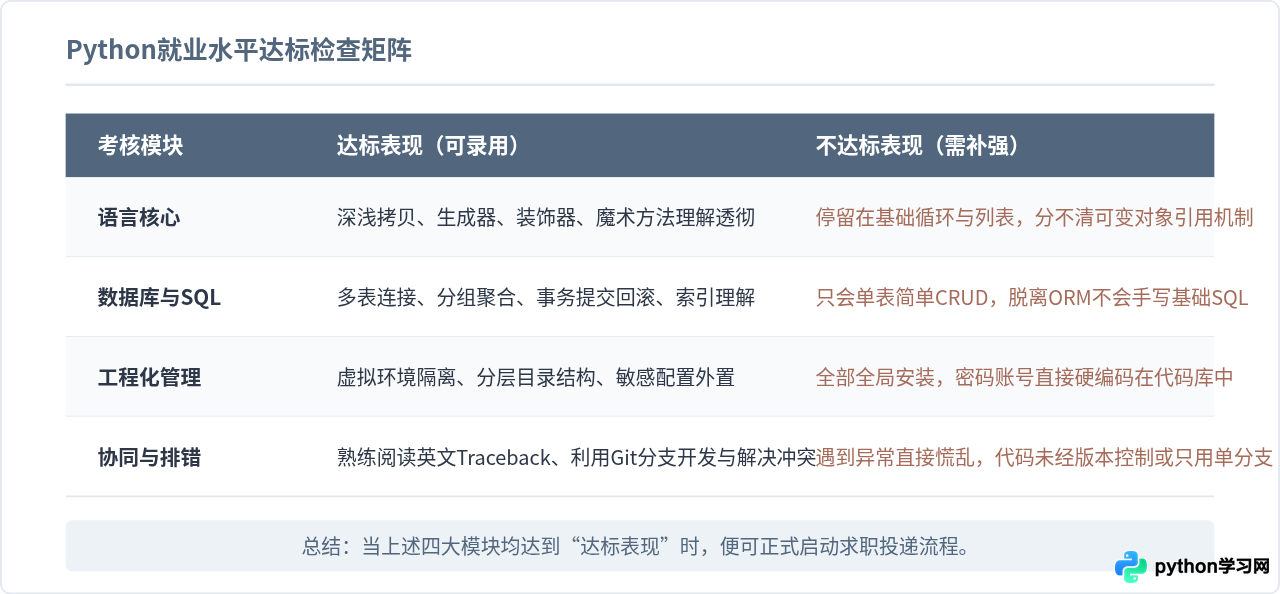
| 评测领域 | 及格自测问题 | 达标行动验收 |
|---|---|---|
| 语言机制 | 是否能清楚讲出列表(List)与生成器(Generator)处理1000万条数据的内存占用差异? | 手写包含 yield 的文本批量处理脚本,并通过 sys.getsizeof() 验证内存变化。 |
| 数据交互 | 当数据库在写入一半发生中断时,如何确保数据不产生脏乱或孤立记录? | 在代码中编写显式数据库连接上下文,触发手动异常并验证数据库回滚成功。 |
| 接口与协议 | 如何防范接口收到恶意非法参数?HTTP状态码 400、401、403、404、500 各代表什么? | 使用 Pydantic 或自定义校验函数处理入参,在返回中规范给出标准状态码与错误信息。 |
| 部署上线 | 是否能在无桌面的远程 Linux 环境中安装依赖、启动服务并使其常驻后台? | 使用 systemd 或 Docker 将自己的应用打包,并在后台稳定运行。 |
六、总结与落地建议
判断自己的 Python 水平是否达到就业标准,最靠谱的尺子从来不是学习时长,也不是看完了几千分钟的视频课程,而是你的“独立排障与业务交付半径”。
如果你当前发现自己仍在很多环节依赖教程,不要盲目大量投递简历造成挫败感。建议采取针对性的冲刺策略:挑选一个自己感兴趣的具体问题,不要贪大求全,用两周时间按照工业界规范,从目录搭建、数据库设计、异常捕获到自动化测试完整实现一遍,并成功部署到云服务器上。当你能够自信地向他人演示这个作品,并详细解释每一处技术决策与错误处理时,你就已经跨过了 Python 初级开发的就业门槛。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









