

Python列表切片语法详解:start、stop与step参数规则
深入详解Python列表切片语法及start、stop、step参数规则,解析正负索引、双向步长移动机制、缺省边界推导逻辑与越界容错机制,附完整代码与SVG图解。
sequence[start:stop:step] 语法从序列中按指定规则提取部分元素并生成新列表的核心操作。很多开发者在初学时容易混淆区间开闭关系、正负步长的移动方向以及省略参数时的默认取值。本文围绕 start、stop、step 三个参数展开,系统拆解其底层求值顺序、双向索引映射、边界截断机制与切片赋值行为,帮助读者建立清晰、可靠的切片心智模型。
一、切片基本结构与左闭右开区间
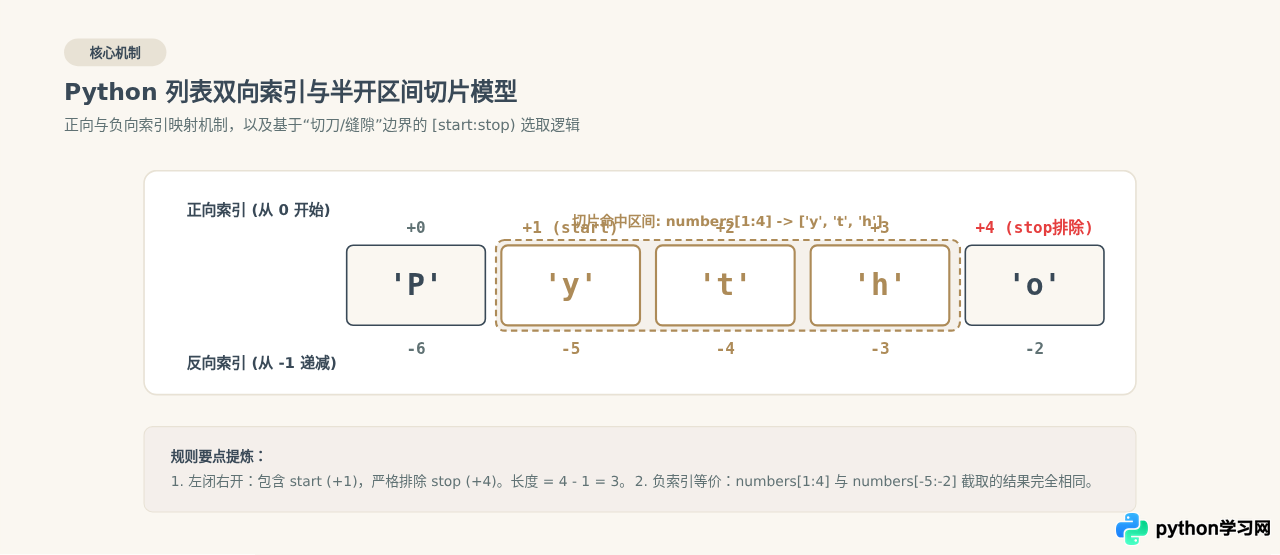
Python 列表切片最基础的形式为 list[start:stop],当省略 step 时,步长默认值为 1。切片操作不会修改原始列表,而是根据计算得到的索引范围浅拷贝对应元素,返回一个全新的列表对象。
在切片语法中,最关键的原则是“左闭右开”:取出的元素包含索引 start 对应的项,但严格排除索引 stop 对应的项,用数学区间表示即为 [start, stop)。
# 示例:基础切片取值
numbers = ['P', 'y', 't', 'h', 'o', 'n']

# 提取索引 1 到 4(包含 1, 2, 3,不包含 4)
subset = numbers[1:4]
print("numbers[1:4]:", subset)
# 输出: numbers[1:4]: ['y', 't', 'h']
为什么 Python 采用左闭右开设计?这种设计有三个显著优势:第一,当 start 与 stop 均为非负数且 step=1 时,切片返回的元素个数恰好等于 stop - start(例如 4 - 1 = 3);第二,相邻切片可以无缝拼接且不重不漏,例如 numbers[:2] + numbers[2:] 完美还原原列表;第三,空切片边界明确,只要 start >= stop(在正步长下),切片直接返回空列表 []。
二、step 参数:移动方向与步长步进规则
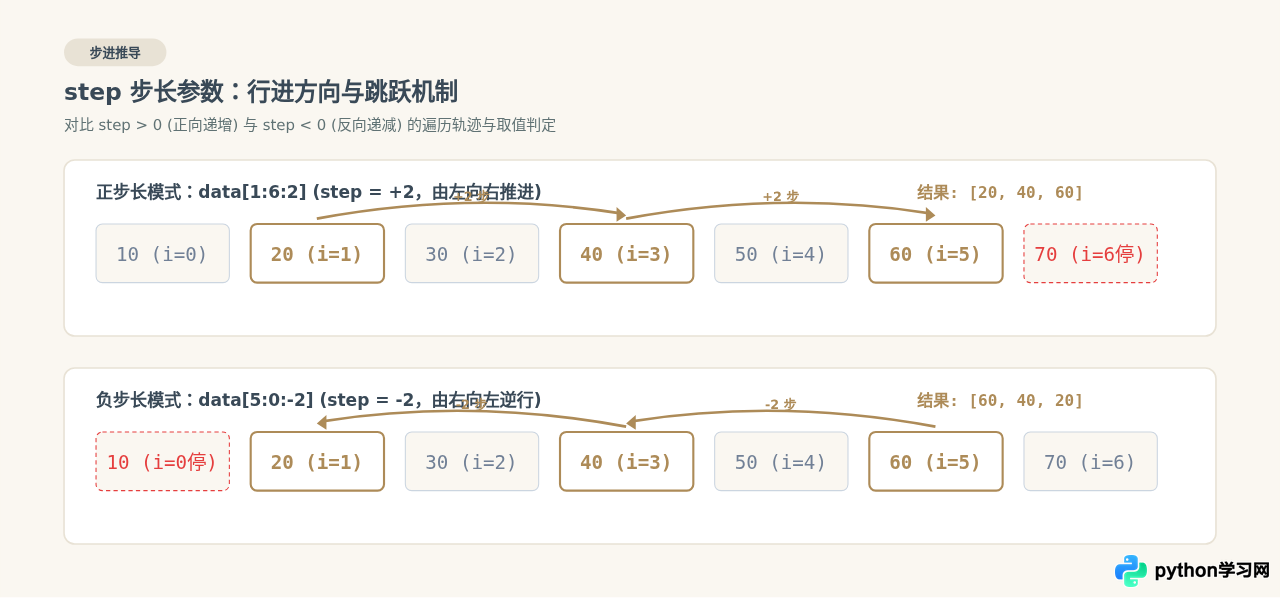
完整切片语法支持第三个参数 step,形式为 list[start:stop:step]。step 参数同时承担两个职责:
- 符号决定行进方向:当
step > 0时,索引由左向右递增;当step < 0时,索引由右向左递减。 - 绝对值决定跳跃幅度:每次提取元素后,下一个候选索引计算公式为
current_index + step。
需要格外注意的是,step 绝对不能为 0。如果传入 step=0,Python 解释器会立即抛出 ValueError: slice step cannot be zero。
# 示例:正负步长取值对比
data = [10, 20, 30, 40, 50, 60, 70]

# 正步长:从索引 1 开始向右,步长为 2,到索引 6 截止
pos_step = data[1:6:2]
print("data[1:6:2]:", pos_step)
# 输出: data[1:6:2]: [20, 40, 60]

# 负步长:从索引 5 开始向左,步长为 -2,到索引 0 截止(不含 0)
neg_step = data[5:0:-2]
print("data[5:0:-2]:", neg_step)
# 输出: data[5:0:-2]: [60, 40, 20]
当使用负步长时,方向发生了根本性翻转。此时 start 必须位于 stop 的右侧(即索引在数值上通常满足 start > stop),才能在逆向递减过程中遇到元素。如果在使用负步长时错误地写成 data[1:5:-1],由于向左移动永远无法到达右侧的边界 5,Python 会直接返回空列表 []。
三、start 与 stop 的缺省推导逻辑
切片中最常见的表达形式往往包含省略参数,例如 nums[:]、nums[2:]、nums[:4] 以及反转操作 nums[::-1]。
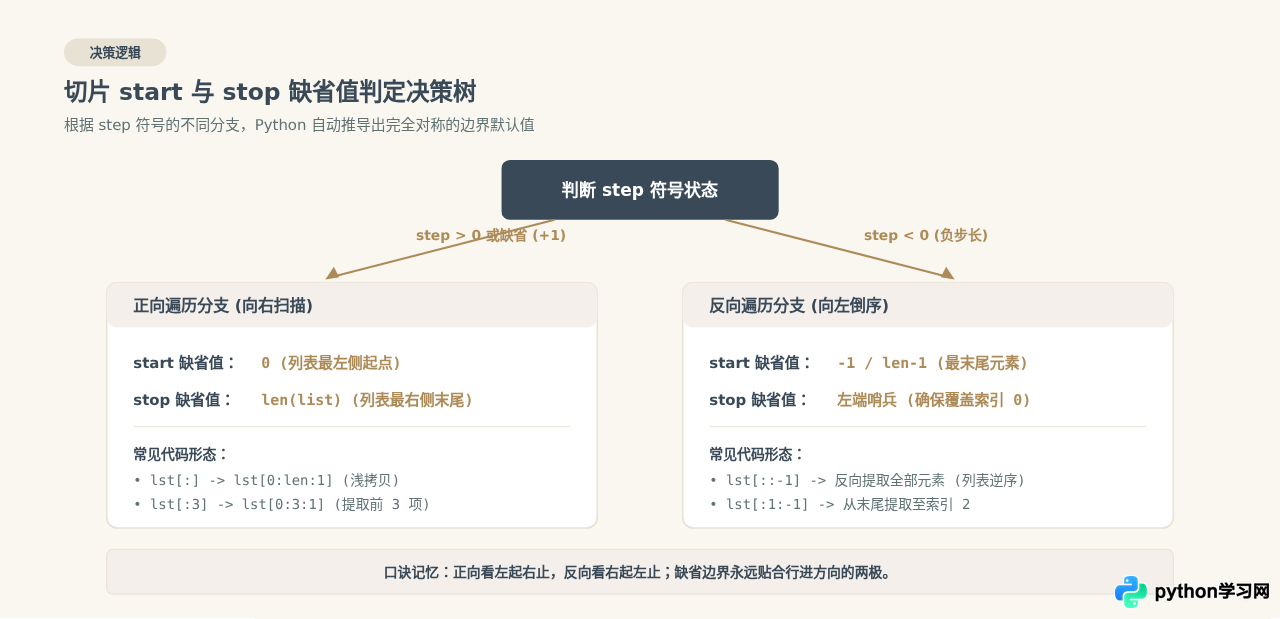
很多初学者误以为“省略 start 就等于 0,省略 stop 就等于列表长度”。这种理解在正步长下成立,但在负步长下完全错误。
Python 对缺省值的推导严格依赖于 step 的符号:
| 参数条件 | 未指定 start 时的默认取值 | 未指定 stop 时的默认取值 | 逻辑边界语义 |
|---|---|---|---|
| step > 0(含省略 step) | 0 |
len(sequence) |
从序列最左侧元素开始,向右一直截取到最右侧末尾。 |
| step < 0 | len(sequence) - 1(即 -1) |
开头的左侧哨兵位置(逻辑 -len - 1) |
从序列最右侧末尾元素开始,向左一直截取到索引 0 的元素。 |
根据这一规则,我们可以彻底看清 nums[::-1] 的运作原理:由于 step = -1,省略的 start 自动推导为末尾索引 -1,省略的 stop 自动推导为越过索引 0 的左端哨兵。因此它完整反向遍历了每一个元素,实现了优雅的列表反转。
items = ['a', 'b', 'c', 'd', 'e']

# 1. 完整浅拷贝:step 缺省为 +1,start 默认为 0,stop 默认为 5
clone = items[:]         # 等价于 items[0:5:1]
print("items[:]:", clone)

# 2. 列表翻转:step 为 -1,start 默认为 4,stop 包含到索引 0
reverse = items[::-1]    # 等价于从最末尾向左提取至最前端
print("items[::-1]:", reverse)
# 输出: items[::-1]: ['e', 'd', 'c', 'b', 'a']

# 3. 负步长带指定边界:从末尾反向提取至索引 2(不包含索引 2 处的 'c')
part_rev = items[:1:-1]  # 等价于 items[4:1:-1]
print("items[:1:-1]:", part_rev)
# 输出: items[:1:-1]: ['e', 'd']
四、切片的边界保护与越界容错机制
在 Python 中,单元素索引取值与切片操作在对待越界问题时有着截然不同的策略:
- 单索引访问:当执行
lst[100]时,若索引超出len(lst) - 1,解释器会抛出IndexError: list index out of range。 - 切片访问:切片永远不会抛出
IndexError。无论输入的start或stop处于何种极端数值,Python 都会自动将其约束截断在有效边界范围内(Clamp 操作)。
chars = ['A', 'B', 'C', 'D']

# 1. 远超长度的 stop 会被自动收缩至 len(chars)
print("chars[1:999]:", chars[1:999])
# 输出: chars[1:999]: ['B', 'C', 'D']

# 2. start 和 stop 均在列表右侧外,安全返回空列表
print("chars[10:20]:", chars[10:20])
# 输出: chars[10:20]: []

# 3. 负索引超出左侧边界,自动收缩至 0
print("chars[-999:2]:", chars[-999:2])
# 输出: chars[-999:2]: ['A', 'B']
Python 内置的 slice 类型提供了一个公开方法 slice.indices(length)。它模拟了切片在指定序列长度下的真实计算过程,自动完成负索引转换与越界截断,最终输出标准化的 (safe_start, safe_stop, step) 三元组,保证遍历永远在合法内存范围内进行。
五、slice 内置对象与切片赋值的高级用法
在 Python 内部,lst[1:5:2] 实际上是 lst[slice(1, 5, 2)] 的语法糖。我们可以直接使用 slice 构造函数定义可复用的切片对象:
# 显式构造 slice 对象提升代码可读性
FIRST_THREE = slice(0, 3)
EVERY_OTHER = slice(None, None, 2)

sample = [1, 2, 3, 4, 5, 6]
print("sample[FIRST_THREE]:", sample[FIRST_THREE])  # [1, 2, 3]
print("sample[EVERY_OTHER]:", sample[EVERY_OTHER])  # [1, 3, 5]
切片作为赋值目标(左值修改)
列表作为可变对象,支持对切片区域进行直接赋值,这在批量更新、插入与删除元素时非常高效:
- 单步长切片赋值:右侧可迭代对象的长度可以与切片范围不一致,列表会自动伸缩调整。
- 扩展步长切片赋值(step != 1):右侧元素的数量必须严格等于切片选中的槽位数,否则会抛出
ValueError: attempt to assign sequence of size X to extended slice of size Y。
# 1. 单步长赋值(长度无需相等)
seq = [1, 2, 3, 4, 5]
seq[1:3] = [88, 99, 100]  # 替换 2 项为 3 项
print("单步长赋值后:", seq)
# 输出: 单步长赋值后: [1, 88, 99, 100, 4, 5]

# 2. 扩展步长赋值(长度必须严格一致)
grid = [0, 0, 0, 0, 0, 0]
grid[::2] = [1, 1, 1]     # 刚好匹配索引 0, 2, 4 共 3 个槽位
print("扩展步长赋值后:", grid)
# 输出: 扩展步长赋值后: [1, 0, 1, 0, 1, 0]
六、总结
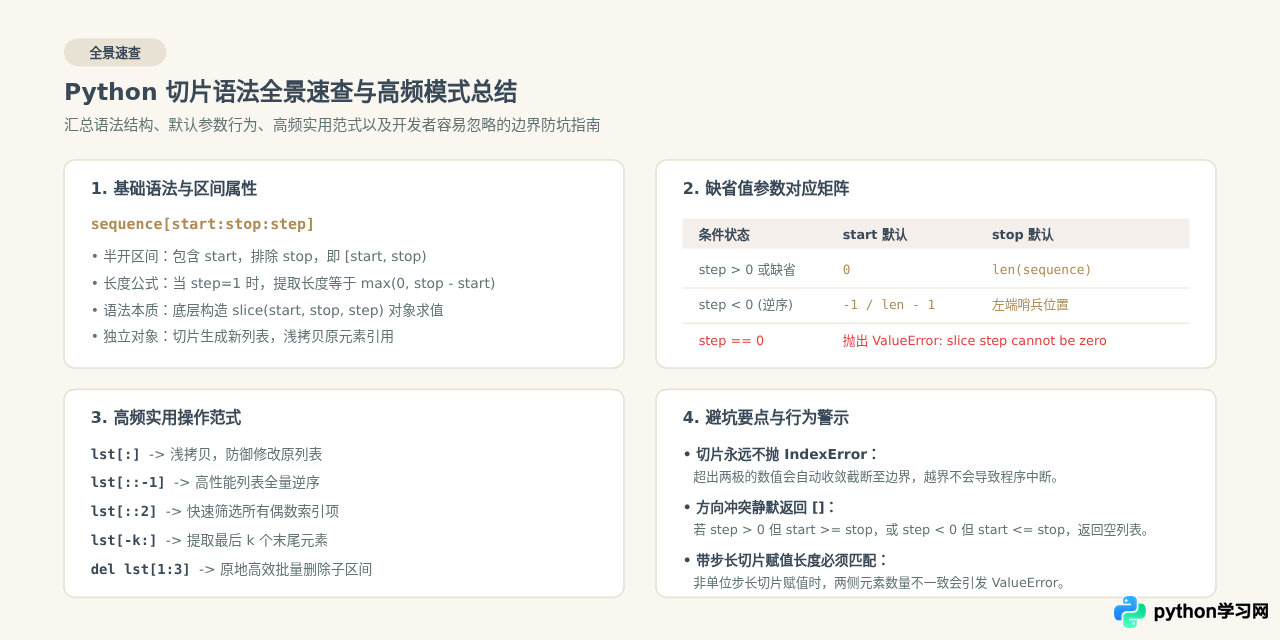
掌握 Python 列表切片的核心在于理顺以下四条基准线:
- 看区间:切片永远遵循左闭右开
[start, stop),stop是停止边界而非提取对象。 - 看步长符号:
step > 0向右行进,step < 0向左行进;行进方向必须与start到stop的几何方向一致,否则返回空列表。 - 看缺省推导:正向缺省自
0至末尾;反向缺省自末尾至0之前。理解反向哨兵机制即可彻底搞懂[::-1]。 - 利用容错特性:切片会自动裁剪越界值,在编写算法时无需额外编写多余的上下界检查代码,既安全又地道。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









