

阅读Python英文文档时怎么识别数据类型相关术语
解析查阅Python官方英文文档时识别数据类型术语的核心方法,系统梳理具象类型、抽象协议、类型标注修饰语的判定逻辑与实际传参指南。
阅读 Python 官方英文文档时,识别数据类型术语的核心在于分清三类词汇:具象内置类(Concrete Types)、抽象行为协议(Protocols/ABCs)以及泛型与类型修饰符(Type Qualifiers)。掌握这套分类框架,就能迅速将文档中的抽象英文名词与实际代码中的传参对象精准对应。
假设你正在查阅 Python 官方文档中的标准库函数,比如 random.choice(seq) 或者 json.dump(obj, fp)。在函数参数说明中,你常常不会看到直白的 list 或 file,而是遇到 sequence、iterable、mapping、hashable、file-like object 或 path-like object 等术语。很多初学者往往会困惑:这到底是要求传入某种特定类型,还是可以传多种数据结构?为什么传了 set 会报错,而传 tuple 就可以?
Python 是一门深度贯彻“鸭子类型(Duck Typing)”和“协议驱动设计”的语言。在官方文档中,参数往往使用能够表达最小行为要求的术语来描述,而不是写死某个具体类。本文将系统拆解阅读官方英文文档时识别、理解并验证这些数据类型术语的完整路径。
一、四步识别法:从官方文档签名定位术语分类
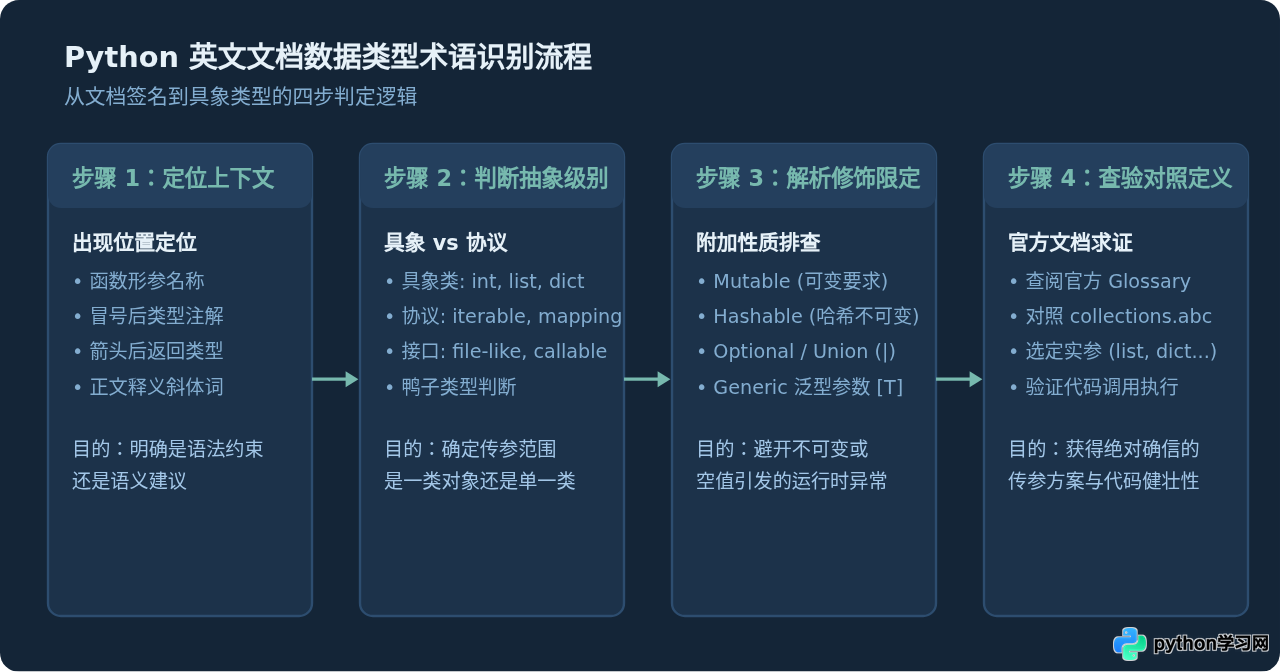
在 Python 官方文档中,函数和类的方法签名是获取类型信息最权威的入口。识别一个术语的具体内涵,可以按照以下四个步骤逐步定位:
- 步骤一:定位上下文位置。观察术语出现在函数参数列表、类型注解(
: Type)、返回值标注(-> ReturnType),还是在后续正文的文字说明段落。正文段落中的斜体词往往是特定术语。 - 步骤二:判断抽象级别。区分该词是小写的具象类型(如
int、str、float、dict、list),还是代表抽象行为的协议类名词(如sequence、iterable、mapping、callable)。 - 步骤三:解析修饰与限定词。检查术语前后是否存在
mutable(可变)、immutable(不可变)、optional(可选空值)、union(多类型联合)等限定性修饰。 - 步骤四:查验官方术语表(Glossary)。如果术语带有下划线超链接,直接点击进入 Python 官方文档的 Glossary 页面,对照其官方标准定义与接口要求。
二、破解核心抽象术语:协议(Protocols)与抽象基类(ABCs)
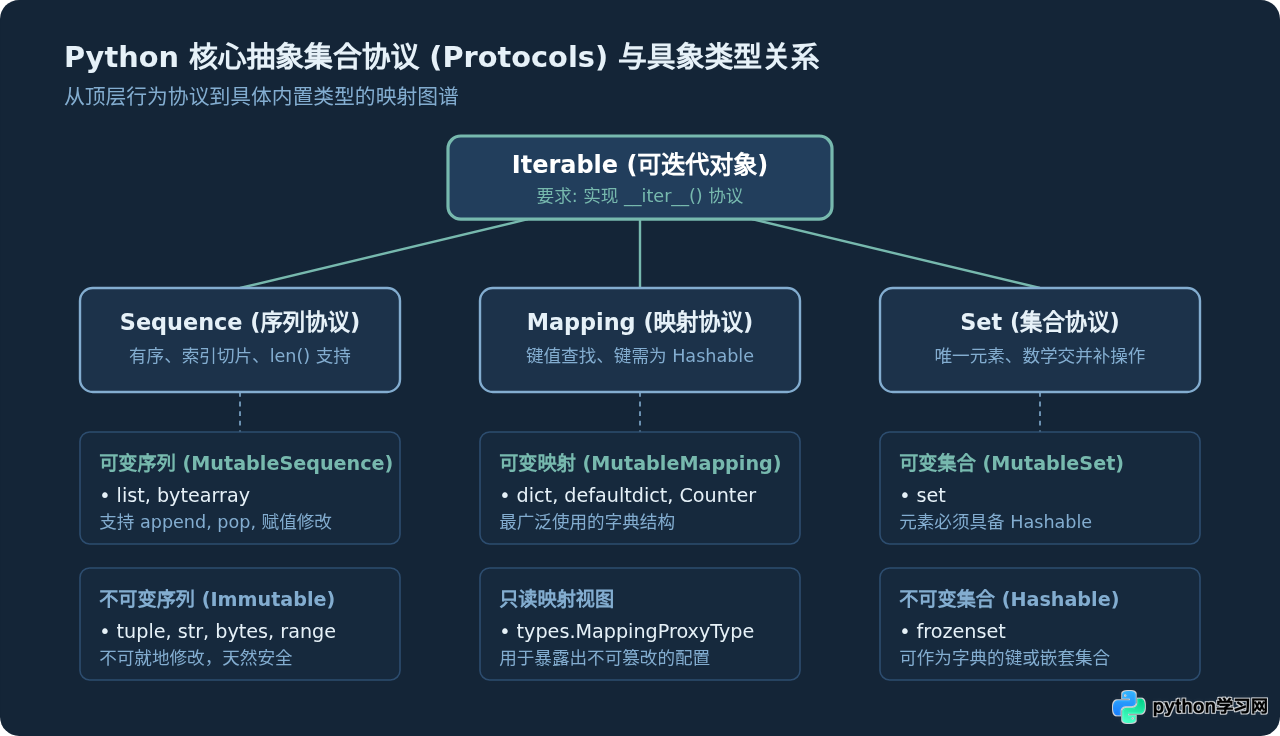
英文文档中最令初学者困惑的不是 float 或 str 这样的具象内置类,而是代表某种协议能力的抽象术语。Python 标准库的 collections.abc 模块对这些协议提供了形式化定义。
1. iterable 与 iterator 的区别
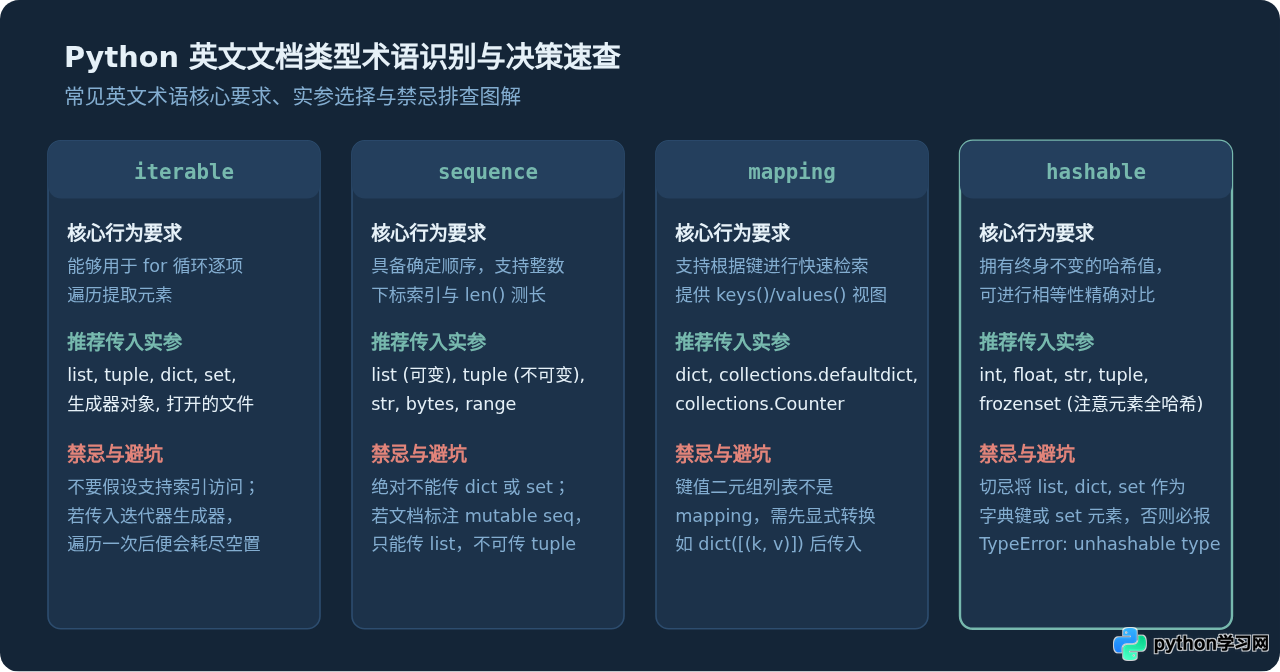
文档中若写明参数是 iterable(可迭代对象),意味着该对象实现了 __iter__() 方法,或者实现了支持从 0 开始连续整数索引的 __getitem__() 方法。你可以在任何支持 for item in obj: 的地方使用它。常见的 list、tuple、dict、set、str、生成器表达式均属于 iterable。
而 iterator(迭代器)则是 iterable 的一个子集,它不仅支持迭代,还必须实现 __next__() 方法。迭代器通常是“一次性消费”的,遍历一次后即耗尽状态。文档中若特别指明需要 iterator,直接传入 list 是不行的,必须先通过 iter(my_list) 获取其迭代器。
2. sequence 与 mapping 的边界
sequence(序列)要求对象支持通过整数下标(0、1、2...)和负数索引进行随机访问,并且支持 len() 操作求取长度。list、tuple、str、bytes、range 都是典型的序列。需要特别注意的是:set 和 dict 不是 sequence。例如 random.choice(seq) 明确要求实参必须是序列,如果传入 set 会直接抛出 KeyError 或 TypeError。
mapping(映射)则要求对象支持键值对查找,实现 __getitem__() 并支持 keys()、values()、items() 等接口,其最典型的代表就是内置的 dict 和 collections.defaultdict。
3. hashable 与可变性(Mutability)约束
在字典和集合的文档中,经常出现 hashable(可哈希的)。一个对象是 hashable 的前提是:它的哈希值在生命周期内永不改变(实现了 __hash__()),且可以与其他对象比较相等性(实现了 __eq__())。在 Python 中:
- 数值类型(
int、float)、字符串(str)、元组(tuple,且其包含的所有元素也必须是可哈希的)、frozenset属于hashable。 - 列表(
list)、字典(dict)、可变集合(set)属于不可哈希对象,绝对不能作为字典的键或加入到集合中。
三、现代文档中的类型标注术语(Type Hints)解构
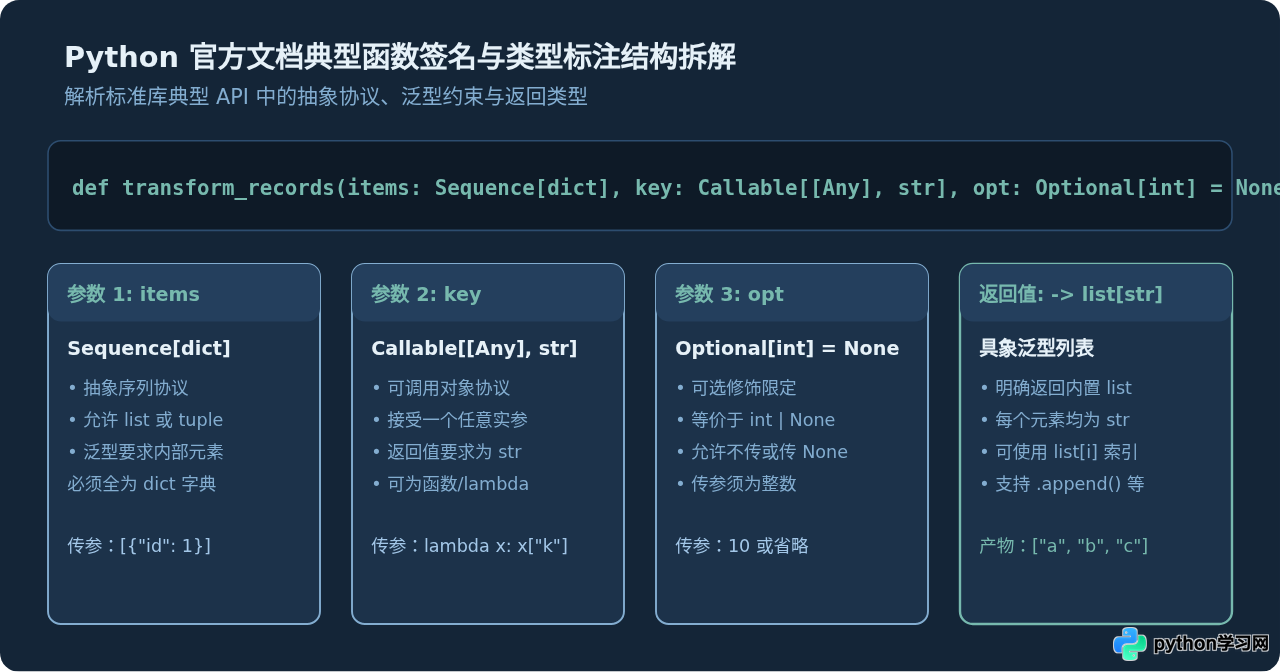
自 Python 3.5 引入 PEP 484 并在 Python 3.9+ 全面支持内置泛型语法以来,官方文档和现代开源库的 API 签名普遍采用了标准化类型提示(Type Hints)。读懂这类签名需要理解几个标志性术语和符号:
Optional[T]或T | None:表示该参数既可以传入类型为T的值,也允许传入None。例如timeout: Optional[float] = None,说明你可以传浮点数或者None(通常表示无超时限制)。Union[X, Y]或X | Y:表示参数属于多种可能类型之一。文档中若写path: str | bytes | os.PathLike,说明这里既可以传字符串路径,也可以传二进制路径或pathlib.Path对象。Callable[[Arg1, Arg2], ReturnType]:表示参数必须是一个可调用的函数、类或方法。例如key: Callable[[Any], Hashable],意味着该参数要求传入一个函数,接收任意参数并返回一个可哈希的键值(如内置len或str.lower)。Any与object:Any表示类型检查器对该值不做任何限制,允许任意操作;而object是 Python 所有类的基类,当文档标记为object时,通常只暗示其可以接收任何值,但内部只使用对象通用的最小能力。
四、标准库文档中的“协议类(-like)”复合术语
在 Python 标准库英文文档中,还有一类带有连字符 -like 的专业习惯用语,它们通常指代实现了一组特定协议方法的对象:
| 英文文档术语 | 协议接口要求 | 典型满足对象 | 典型使用场景 |
|---|---|---|---|
file-like object (或 stream) |
实现 .read() 或 .write() 方法 |
open() 句柄、io.StringIO、io.BytesIO |
json.load(fp), tarfile.open(fileobj=...) |
path-like object |
实现 __fspath__() 方法 |
str, bytes, pathlib.Path |
os.remove(path), shutil.copy(src, dst) |
bytes-like object |
支持底层缓冲区协议(Buffer Protocol) | bytes, bytearray, memoryview |
hashlib.sha256(), socket.send() |
array-like (NumPy/SciPy 文档) |
可转换为 n 维数组的对象 | 嵌套 list, tuple, numpy.ndarray |
科学计算库函数入参 |
bytes-like object 时,直接传入普通 str 字符串会触发 TypeError: a bytes-like object is required, not 'str'。必须先使用 "hello".encode("utf-8") 显式转换成 bytes 类型。
五、文档核心术语识别与决策对照指南
为了在查阅英文文档时能够迅速决定传什么参数、规避哪些传参陷阱,下表对高频术语给出了明确的判断准则与决策图谱:
总结
阅读 Python 英文文档不是死记硬背英文单词,而是理解 Python 语言背后的对象协议体系。当你再次在官方文档中看到 iterable、sequence、mapping 或 hashable 时,先判断它所要求的最小行为接口是什么,再从内置的 list、dict、tuple、set 或标准库工具类中匹配对应的具象实现。善用官方 Glossary 和 collections.abc 模块,便能在阅读英文技术文档与编写工程代码之间建立畅通无阻的对应桥梁。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









