

TensorFold 1.2.9怎么配置推理服务并理解Ollama兼容范围
TensorFold 1.2.9可以通过serve --config读取TOML启动参数,同时提供/api/chat等Ollama兼容端点。迁移时需要分别确认服务启动配置、所用模型及客户端具体接口,不能把接口兼容等同于完整替代Ollama。
Ollama兼容覆盖哪些端点
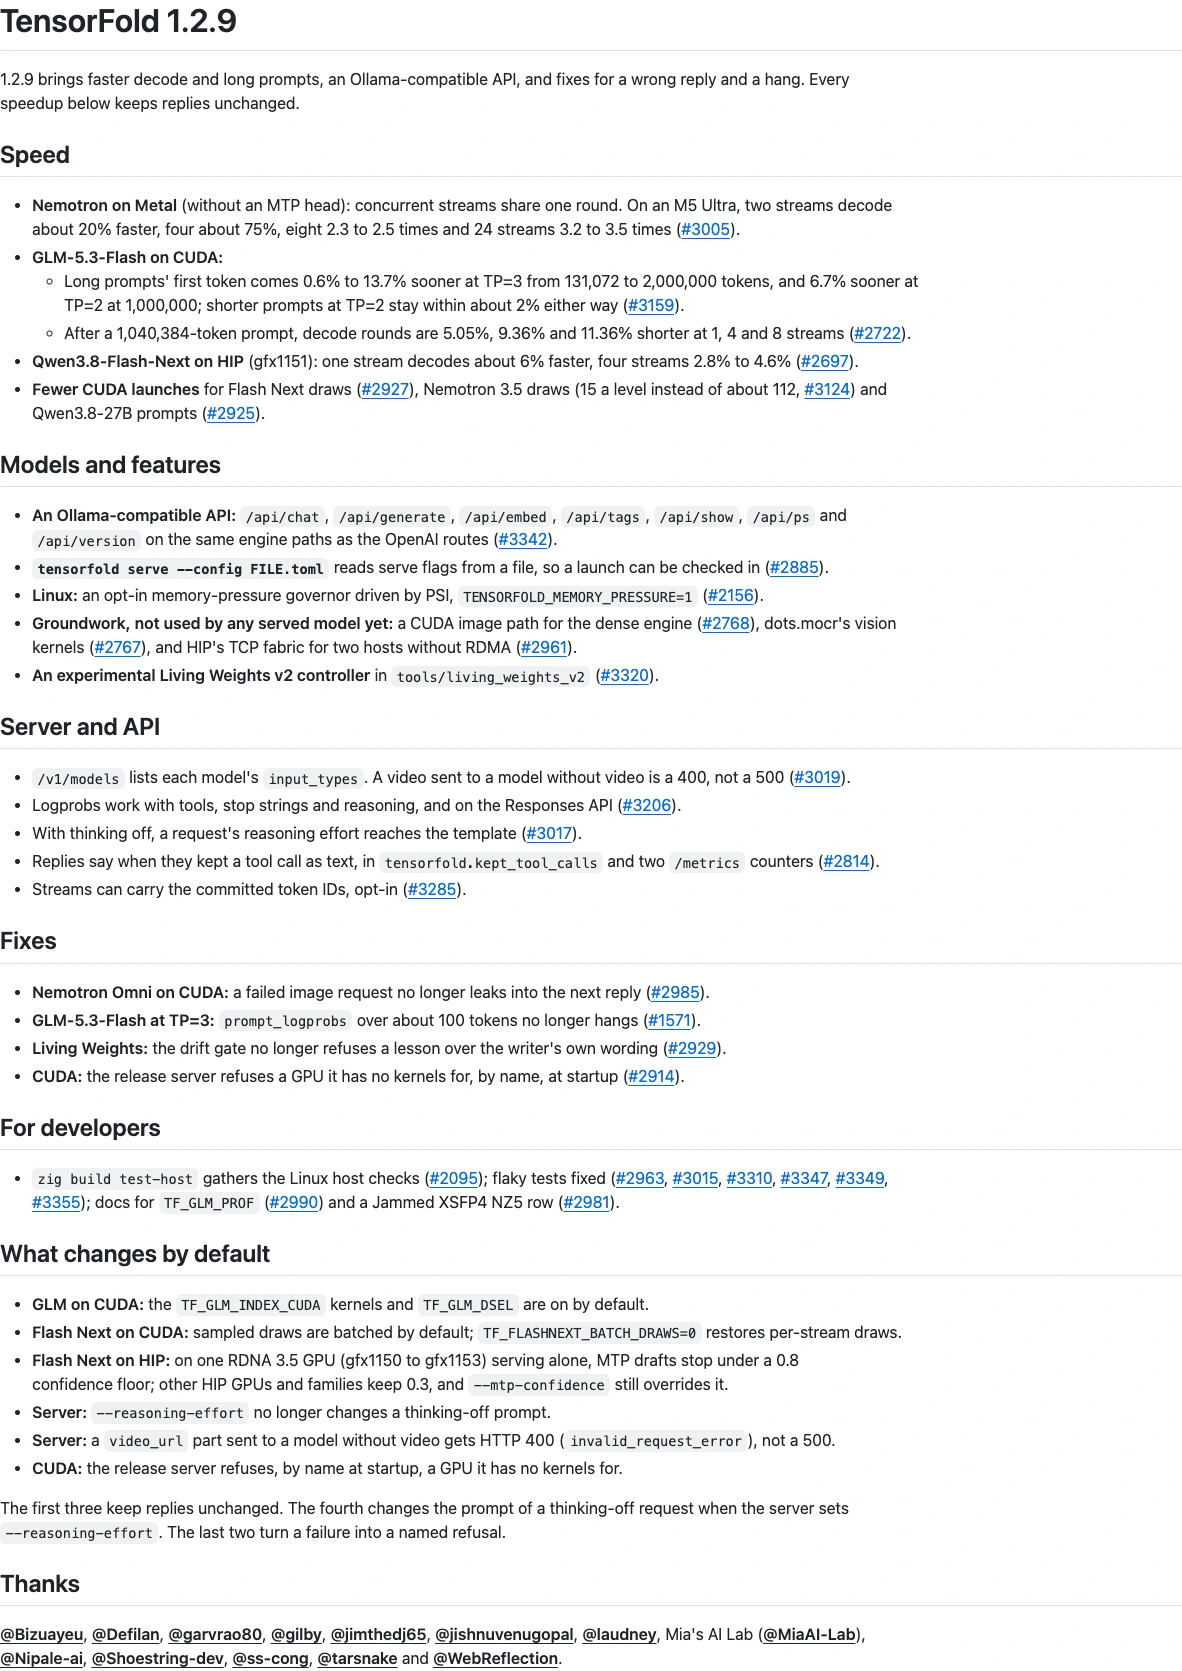
1.2.9列出的端点为/api/chat、/api/generate、/api/embed、/api/tags、/api/show、/api/ps和/api/version,走与OpenAI路由相同的引擎路径。这说明接口层增加了兼容入口,并不表示所有Ollama扩展参数、模型管理行为及客户端版本都已经逐项验证。
已有客户端如果只使用这些端点,可以围绕实际请求与响应评估接入。模型能否运行仍取决于TensorFold支持的架构、权重形式及本机硬件;接口名称相同不能替代模型与后端检查。
怎样把启动参数保存为TOML
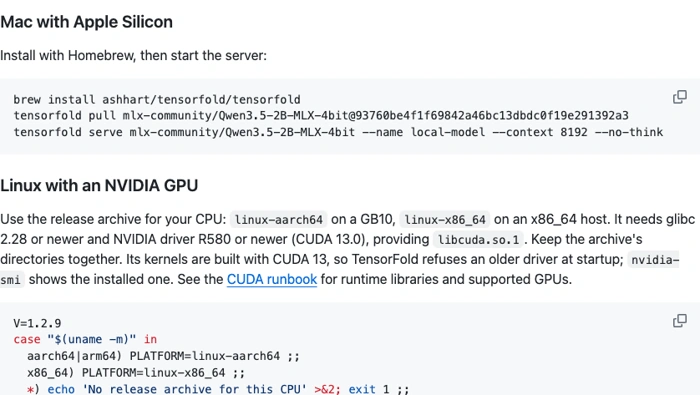
以下示例适用于已安装TensorFold 1.2.9、具备相应模型运行环境的终端。保存为serve.toml;示例采用官方README中的模型和服务别名,运行前需确保模型权重可获取且本机资源足够。配置中的127.0.0.1只在本机监听,8080是示例端口;不包含真实密钥。
# serve.toml
model = "mlx-community/Qwen3.5-2B-MLX-4bit"
host = "127.0.0.1"
port = 8080
name = "local-model"
context = 8192
thinking = false
配置键对应去掉--的serve参数,全部位于顶层。thinking = false对应--no-thinking;不能把no-thinking直接作为此开关的配置键。文件不支持任意完整TOML语法,例如表、点分键和嵌套数组会被拒绝,而不是默默忽略。
如何启动并临时覆盖端口
在保存配置的目录运行下面的命令。macOS和Linux会拒绝可由组或其他用户写入的配置,因此先移除这两类写权限。第二个启动命令是替代第一个的示例,用来说明临时改端口,不是要求同时启动两个实例。
chmod go-w serve.toml
tensorfold serve --config serve.toml

# 需要9000端口时,改用这一条启动命令
tensorfold serve --config serve.toml --port 9000
预期服务按配置加载模型并监听所选端口;命令行优先于文件,文件优先于内置默认值。若参数不支持、模型无法运行或配置不合法,启动可能失败,不能把命令存在当作已实测成功。
文件内相对路径以配置文件目录为起点,命令行路径仍以启动时工作目录为起点。路径参数不经过shell展开,文件中的~/不会自动变成用户主目录。重复参数列表在命令行出现时,会替换文件里的整组列表,而不是追加。
哪些修复值得纳入回归检查
在CUDA的Nemotron Omni场景,失败的图像请求不再污染下一次回复;GLM-5.3-Flash在TP=3且prompt_logprobs超过约100个token时的挂起得到修复。这些是具体场景修复,不能概括为所有错误或长提示故障都已消失。
/v1/models增加每个模型的input_types,不支持视频的模型收到视频请求时返回HTTP 400而不是500。CUDA发行服务也会在没有对应GPU内核时明确拒绝启动;遇到拒绝应先看硬件与构建支持,而不是把它当成随机挂起。
官方性能数字分别来自指定模型、GPU、并发数和提示长度,不能把一个场景的提升比例套到所有部署。Linux内存压力调节需要显式启用;CUDA图像路径和部分视觉内核仍属于尚未被已服务模型使用的基础工作,也不应当作已经开放的模型功能。1.2.9是这里讨论的准确版本,不代表始终为最新发行版。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









