

Windows/Mac用Ollama一键本地部署DeepSeek教程

每次看到网上那些需要配置Python环境、安装CUDA驱动、还要手动下载几十GB权重文件的AI部署教程,是不是头都大了?其实对于只想在本地跑个DeepSeek聊聊天、写写代码的用户来说,完全不需要这么折腾。
现在最省心的方案就是Ollama。它就像是一个AI模型的“应用商店”,把复杂的底层依赖都打包好了。你只需要点几下鼠标或敲一行命令,就能让DeepSeek在你的电脑里跑起来,而且完全离线,隐私安全更有保障。
1. 下载安装Ollama客户端
不管你是Windows还是Mac用户,第一步都是去Ollama官网下载对应的安装包。这是整个过程中唯一需要打开浏览器的步骤。
对于Mac用户,直接下载pkg安装包,双击运行后按照提示点击“继续”即可。Ollama对Apple Silicon芯片(M1/M2/M3)优化得很好,安装过程非常丝滑。
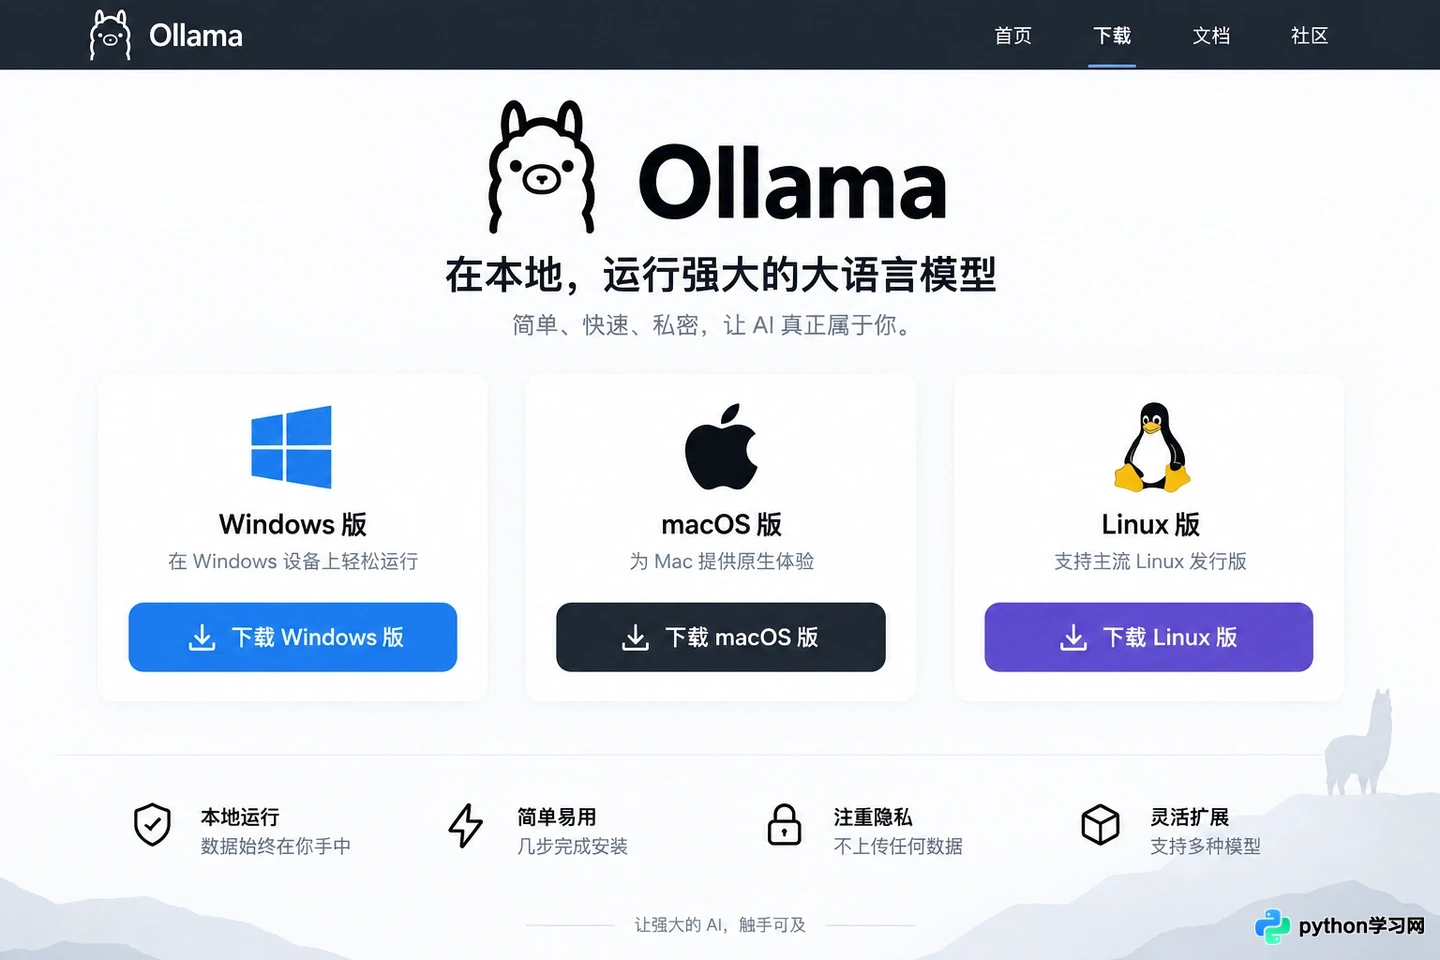
Ollama官网提供Windows、macOS和Linux版本的安装包下载
Windows用户同样下载exe安装包。安装时注意看一眼安装路径,默认通常在C盘,如果你的系统盘空间紧张,可以在安装初期留意是否有更改路径的选项,或者确保C盘至少有10GB以上的剩余空间用于后续缓存模型。
安装完成后,Windows用户会在任务栏右下角看到一个羊驼图标,Mac用户则在菜单栏顶部能看到它。这意味着Ollama后台服务已经启动,随时待命。
2. 一键拉取DeepSeek模型
接下来是核心步骤:获取DeepSeek模型。Ollama支持多种尺寸的DeepSeek模型,对于大多数个人电脑,推荐从7B或8B版本开始尝试,它们在性能和速度之间取得了很好的平衡。
打开你的终端工具。Mac用户直接搜索并打开“终端”(Terminal),Windows用户推荐使用PowerShell或者CMD,当然如果你安装了Git Bash也可以。
在命令行中输入以下指令并回车:
ollama run deepseek-r1:7b
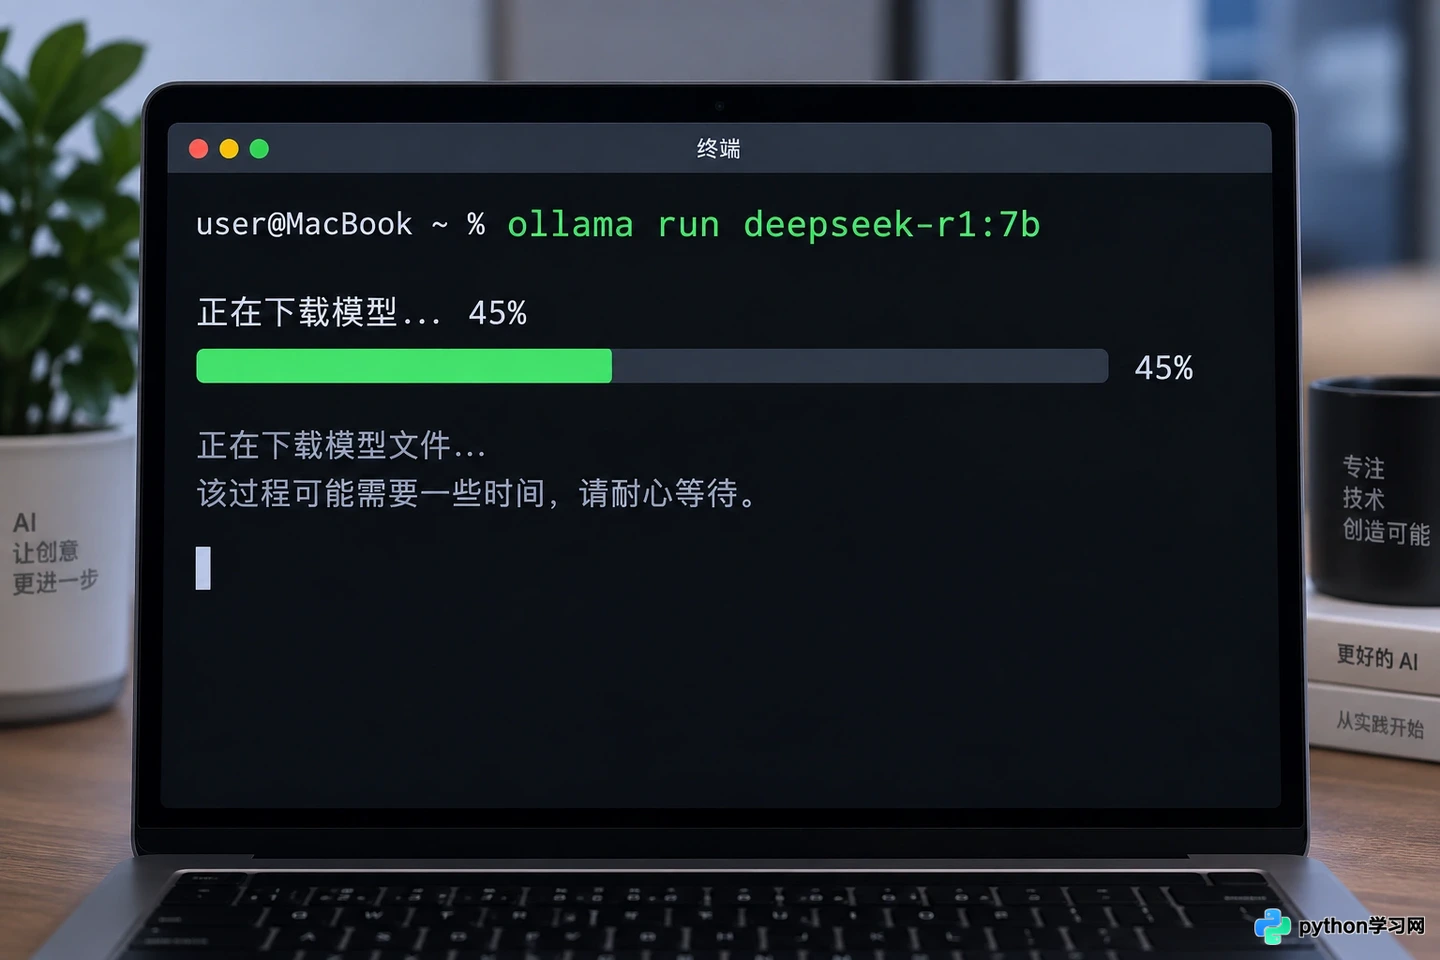
在终端输入命令后,系统自动开始下载模型文件
如果是第一次运行,系统会自动检查本地是否有该模型。如果没有,它会开始从服务器下载。这时候你会看到进度条在走,速度取决于你的网络状况。7B版本的模型大小通常在4GB-5GB左右,宽带环境下几分钟就能搞定。
这里有个小细节:deepseek-r1是DeepSeek的最新推理系列模型,逻辑能力更强。如果你想要更轻量的体验,也可以尝试deepseek-coder:6.7b,专门针对代码生成优化。
3. 调整显存与性能设置
模型下载完成后,Ollama会自动加载并进入对话界面。但有时候你会发现回复速度有点慢,或者风扇狂转。这通常是因为模型占用了过多的系统资源。
Ollama默认会根据你的硬件自动分配显存(GPU)或内存(CPU)。如果你使用的是配备独立显卡的Windows电脑,确保NVIDIA驱动已更新,Ollama通常能自动识别并调用GPU加速。
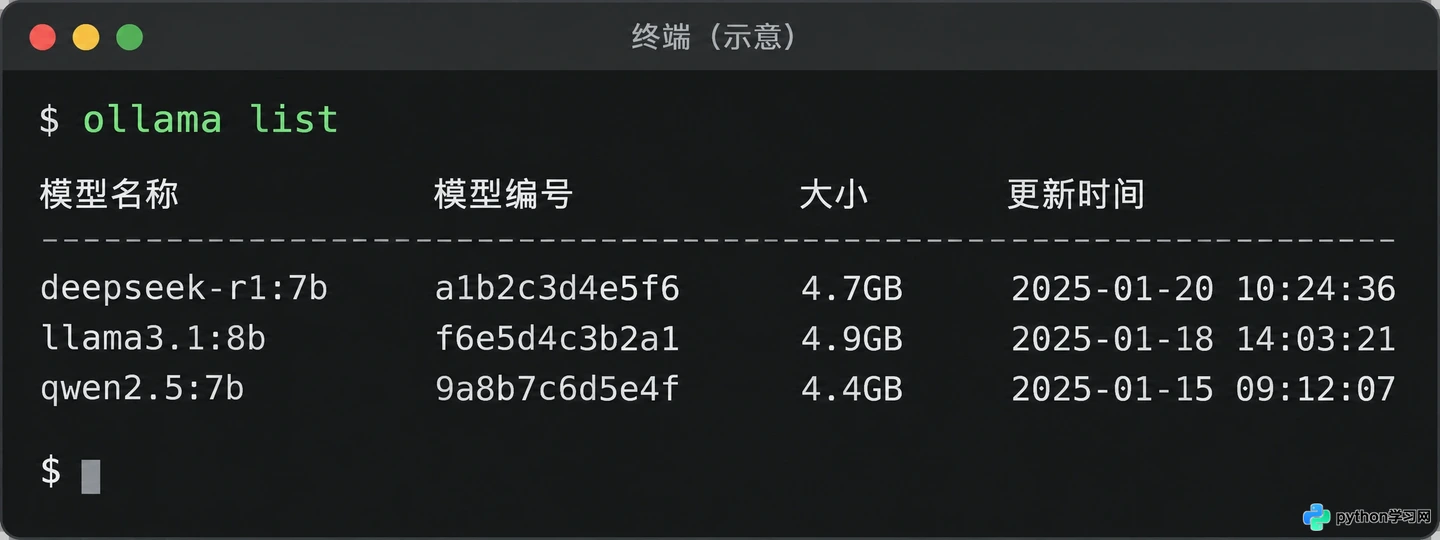
使用ollama list命令查看本地已安装的模型
对于Mac用户,统一内存架构让一切变得简单,但如果同时开着Chrome几十个标签页,可能会感到卡顿。此时可以在命令行中按Ctrl+C退出当前对话,然后通过设置环境变量来限制并发数,或者干脆关闭一些后台应用释放内存。
如果想查看当前正在运行的模型状态,可以新开一个终端窗口,输入:
ollama list
这会列出你本地已下载的所有模型及其大小,方便你管理存储空间。
4. 基础对话与测试
现在,你可以直接在终端里和DeepSeek聊天了。界面虽然朴素,只有黑白文字,但响应速度非常快。
试着问它一个具体问题,比如:“请用Python写一个冒泡排序算法,并添加注释。” 或者 “帮我润色这段邮件,语气要专业且客气。”
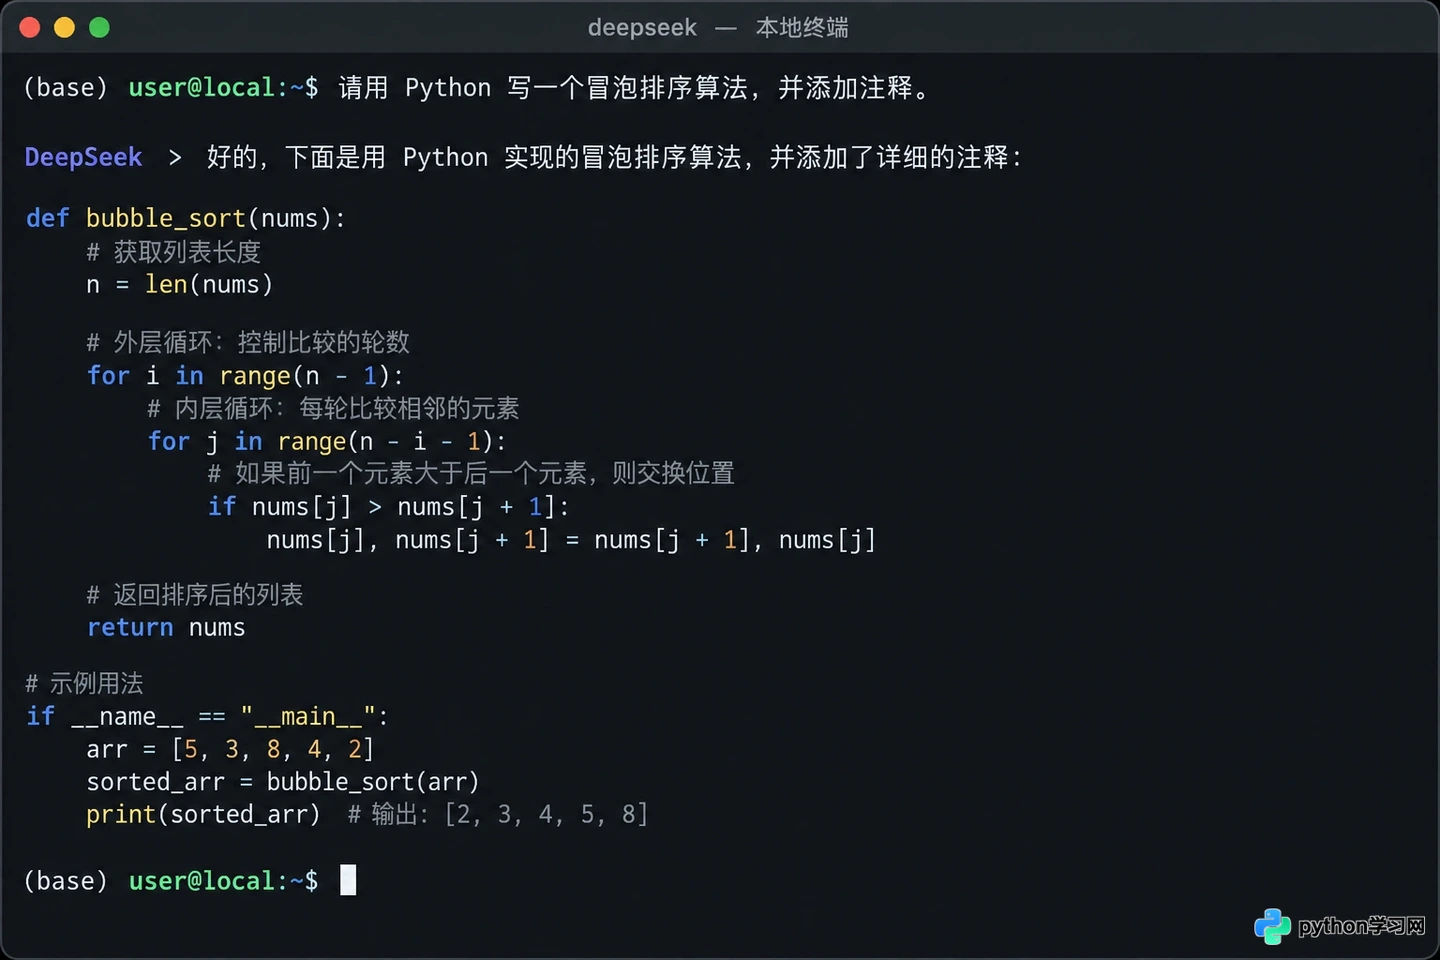
在原生终端界面中直接向DeepSeek提问并获得回复
你会看到文字逐个蹦出,这就是典型的流式输出。如果中途想停止生成,直接按Ctrl+C即可。如果想结束当前会话并返回命令行,输入/bye或者直接关闭终端窗口。
需要注意的是,终端界面的交互功能比较基础,不支持图片上传或多轮上下文的可视化管理。如果你希望有更友好的聊天界面,可以考虑搭配Open WebUI等前端工具,但那属于进阶玩法,对于初次体验本地部署来说,原生的终端交互已经足够验证模型能力。
5. 常见问题与清理
使用过程中,你可能会遇到下载中断的情况。别担心,Ollama支持断点续传。只要网络恢复,重新运行同样的ollama run命令,它会接着上次的位置继续下载,不会从头开始。
如果你想删除某个模型以释放空间,可以使用以下命令:
ollama rm deepseek-r1:7b
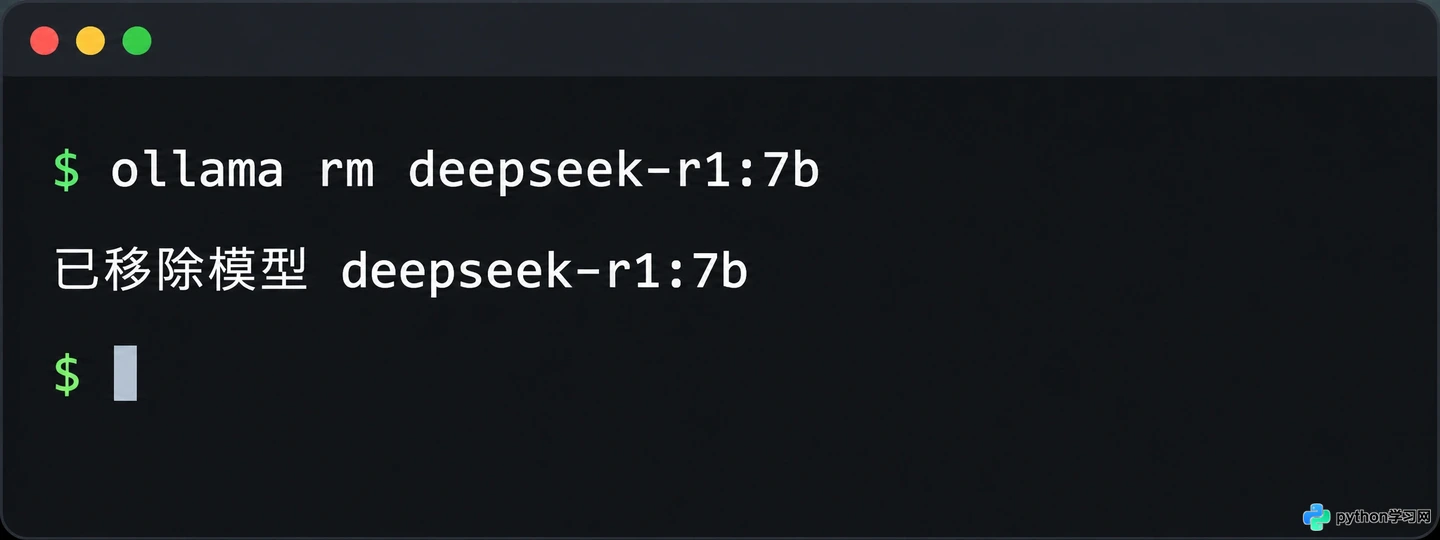
通过简单命令即可移除不再需要的模型以释放空间
最后提醒一点,本地部署虽然隐私性好,但模型的能力受限于其参数量和本地硬件。7B或8B模型在处理极其复杂的逻辑推理或长文本时,可能不如云端超大模型那样完美,但在日常辅助写作、代码补全和简单问答上,表现已经相当惊艳。
现在,你的电脑里已经住进了一个随叫随到的AI助手,没有月费,没有联网焦虑,随时随地都能开工。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









