

DeepSeek-R1本地部署指南:思维链模型的环境配置与推理加速

在本地运行大语言模型,过去往往意味着要在“能跑”和“好用”之间做妥协。尤其是当模型开始具备复杂的推理能力时,这种妥协变得更加微妙。DeepSeek-R1 的出现,将这种矛盾推向了新的高度:它不再只是简单地吐出答案,而是通过显式的“思维链”(Chain of Thought)展示推导过程。这意味着,本地部署不仅要考虑生成速度,更要关注如何优雅地呈现和处理这些中间思考步骤,以及如何在有限的显存中容纳更长的上下文窗口。
对于大多数开发者而言,直接上手 R1 可能会遇到两个直观障碍:一是推理过程中的大量 token 输出导致等待时间变长,二是思维链内容混杂在最终答案中,难以提取。本篇不讨论集群级别的分布式训练,而是聚焦于单卡或双卡消费级硬件下的实用部署策略。核心观点很明确:本地部署 R1 的价值不在于复现云端的全部算力,而在于构建一个可控、隐私安全且能深度干预推理过程的实验环境。
框架抉择:Ollama 的便捷与 vLLM 的极致
选择推理引擎是部署的第一步,这决定了后续优化的上限。目前主流方案中,Ollama 和 LM Studio 代表了“开箱即用”的极致,而 vLLM 或 Text Generation WebUI (基于 llama.cpp) 则提供了更细粒度的控制。
如果你追求快速验证,Ollama 是首选。它封装了底层的 llama.cpp,通过简单的命令行即可完成拉取和运行。对于 R1 模型,Ollama 社区通常会有经过量化处理的版本(如 Q4_K_M),这在保持精度的同时大幅降低了显存需求。在这种场景下,用户只需关注模型标签的选择,无需关心底层算子优化。
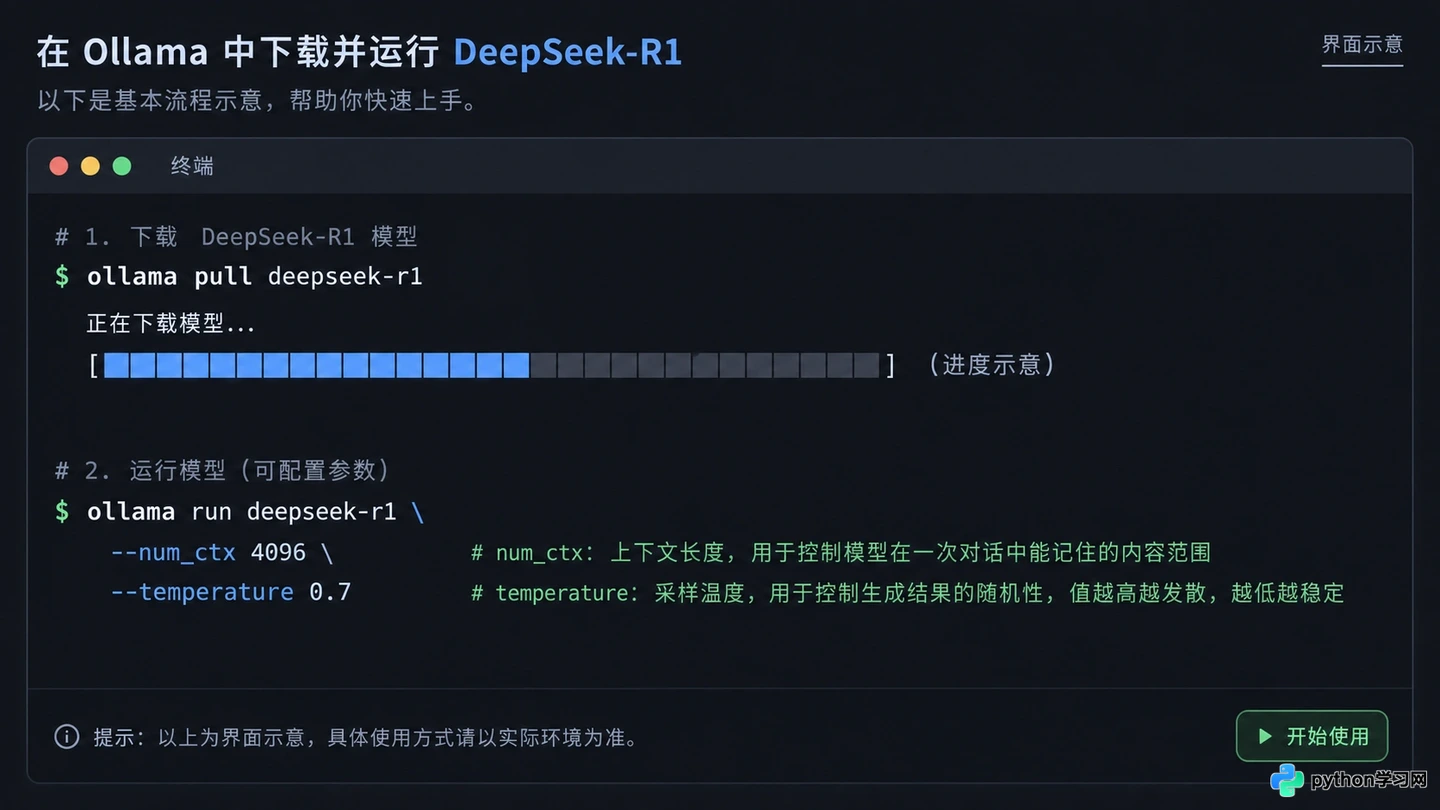
Ollama 终端界面显示模型下载进度及运行参数配置
然而,当需要处理长文档或高并发请求时,Ollama 的黑盒特性可能成为瓶颈。此时,vLLM 展现出其 PagedAttention 技术的优势。它能够更高效地管理 KV Cache(键值缓存),显著减少显存碎片。虽然配置 vLLM 需要一定的 Python 环境和 CUDA 基础,但它允许用户调整 gpu_memory_utilization 等参数,从而在显存占用和吞吐量之间找到最佳平衡点。对于希望深入理解 R1 推理机制的用户,建议从 Ollama 入门,随后过渡到支持更多后端配置的 WebUI 方案。
思维链的可见性:解析与分离的艺术
DeepSeek-R1 的核心特征是其在输出答案前会生成一段详细的思考过程。在本地部署中,如何处理这段内容直接影响用户体验。默认的 API 返回往往将 <think> 标签内的内容与最终答案混在一起,这对于需要结构化数据的应用来说是个麻烦。
在调用本地 API 时,关键在于对输出流的实时解析。大多数推理框架支持流式输出(Streaming)。开发者可以在前端或中间件层设置一个简单的状态机:当检测到 <think> 开始标签时,将后续内容渲染为灰色或小字体的“思考中”状态;当检测到 </think> 结束标签时,切换至正常字体显示最终答案。这种视觉上的分离,不仅提升了阅读体验,也让用户能直观感受到模型的推理逻辑。
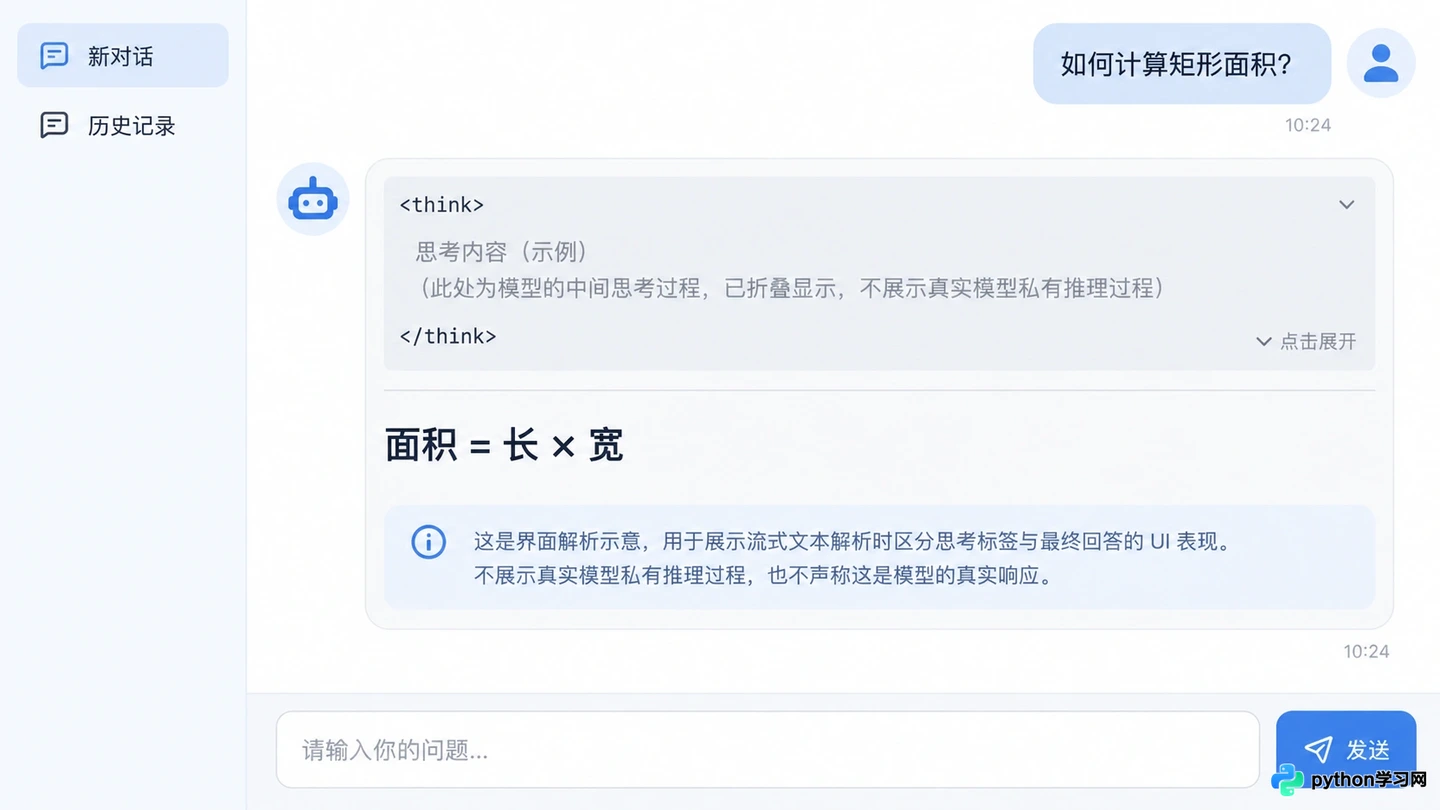
前端界面将 <think> 标签内的思考过程以灰色小字显示,与最终答案区分开
此外,部分高级用户可能希望完全屏蔽思维链以节省 Token 或加快响应。虽然可以通过 Prompt 工程要求模型“直接给出答案”,但这可能会削弱 R1 的推理优势。更推荐的做法是在后处理阶段截取 </think> 之后的内容。需要注意的是,某些量化版本的 R1 可能在标签闭合上存在微小差异,因此在编写解析正则表达式时,应保留一定的容错空间,避免因为标签缺失而导致程序崩溃。
显存博弈:量化精度与上下文窗口的权衡
运行 R1 这类参数量较大的模型,显存是最大的硬约束。7B、32B 乃至 70B 版本对硬件的要求截然不同。在消费级显卡(如 RTX 3090/4090)上,运行 32B 版本的 Q4 量化模型是一个常见的甜蜜点。但这里存在一个常被忽视的陷阱:上下文窗口(Context Window)。
R1 擅长处理复杂逻辑,往往伴随着长输入。默认情况下,许多推理框架会将上下文限制在 4k 或 8k。若要扩展至 32k 甚至更长,KV Cache 的显存占用会线性增长。在 Ollama 中,可以通过设置 num_ctx 参数来调整;在 vLLM 中,则需调整 max_model_len。切记,增加上下文长度是以牺牲最大批处理大小(Batch Size)为代价的。 如果显存报警,优先降低上下文长度而非进一步压缩量化精度,因为过低的精度(如 Q2)可能导致 R1 的逻辑推理能力断崖式下跌。
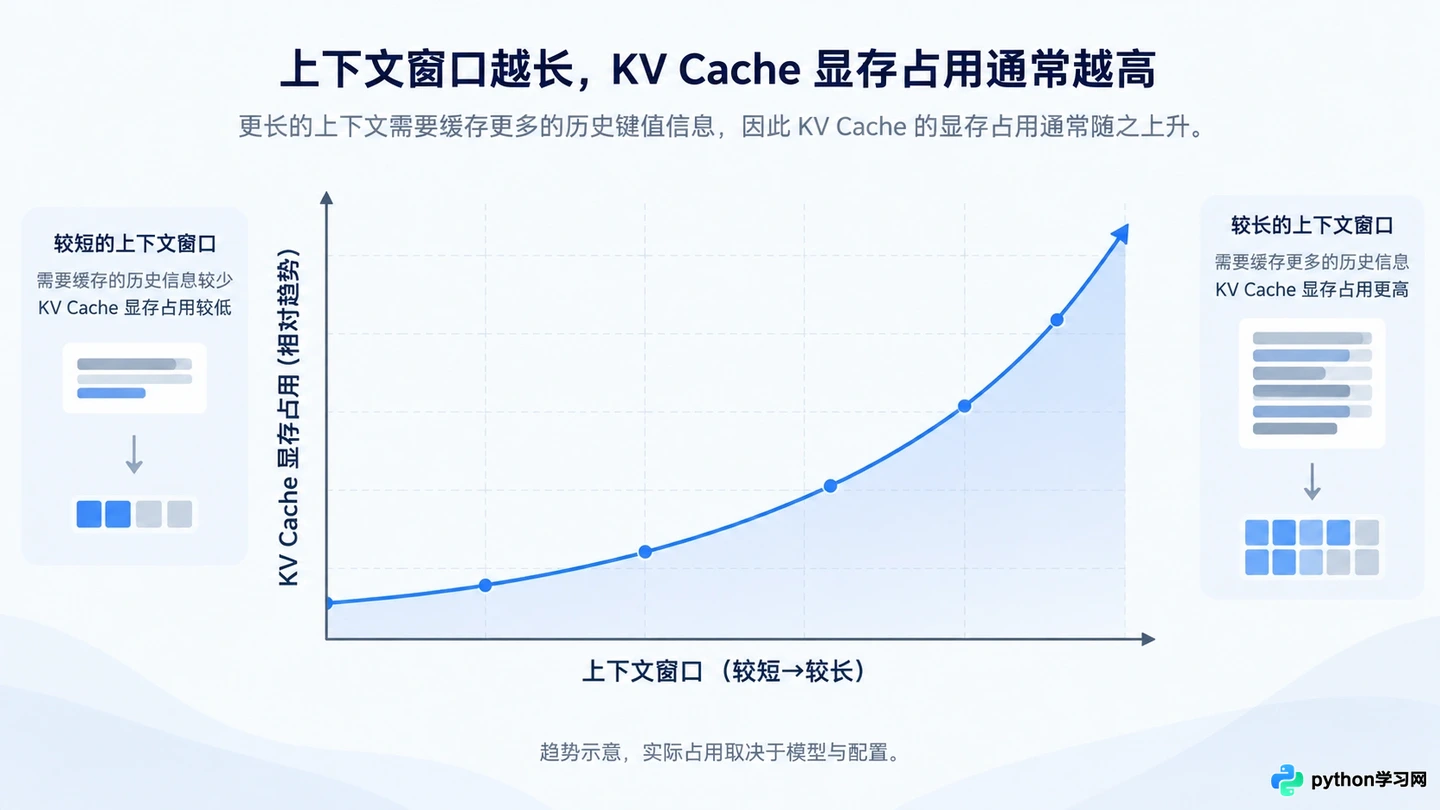
示意图展示随着上下文窗口增加,KV Cache 显存占用呈线性增长
对于双卡用户,利用 tensor parallelism(张量并行)可以将模型层分布在两张卡上。这不仅解决了单卡显存不足的问题,还能在一定程度上提升推理速度。配置时需确保 PCIe 带宽足够,否则卡间通信将成为新的瓶颈。在实际操作中,观察 nvidia-smi 的显存占用曲线,若发现某张卡显存未满而另一张已满,说明并行策略未生效或负载不均,需检查启动参数中的 tensor-parallel-size 设置。
提示词工程:引导 R1 发挥推理潜能
本地部署的最终目的是使用。与通用聊天模型不同,R1 对 Prompt 的结构更为敏感。为了激发其最佳的推理性能,建议在系统提示词(System Prompt)中明确角色设定和任务边界。例如,在处理数学或代码问题时,显式地要求模型“逐步分析”、“检查边界条件”,能够引导其生成更高质量的思维链。
同时,要注意避免“过度引导”。由于 R1 已经内置了强大的自我反思机制,过多的指令反而可能干扰其内部的推理路径。最佳实践是提供清晰的输入数据和明确的输出格式要求,将推理过程留给模型自主完成。在本地环境中,你可以轻松地进行 A/B 测试,对比不同 Prompt 模板下思维链的长度和质量,从而找到最适合特定业务场景的提示词策略。
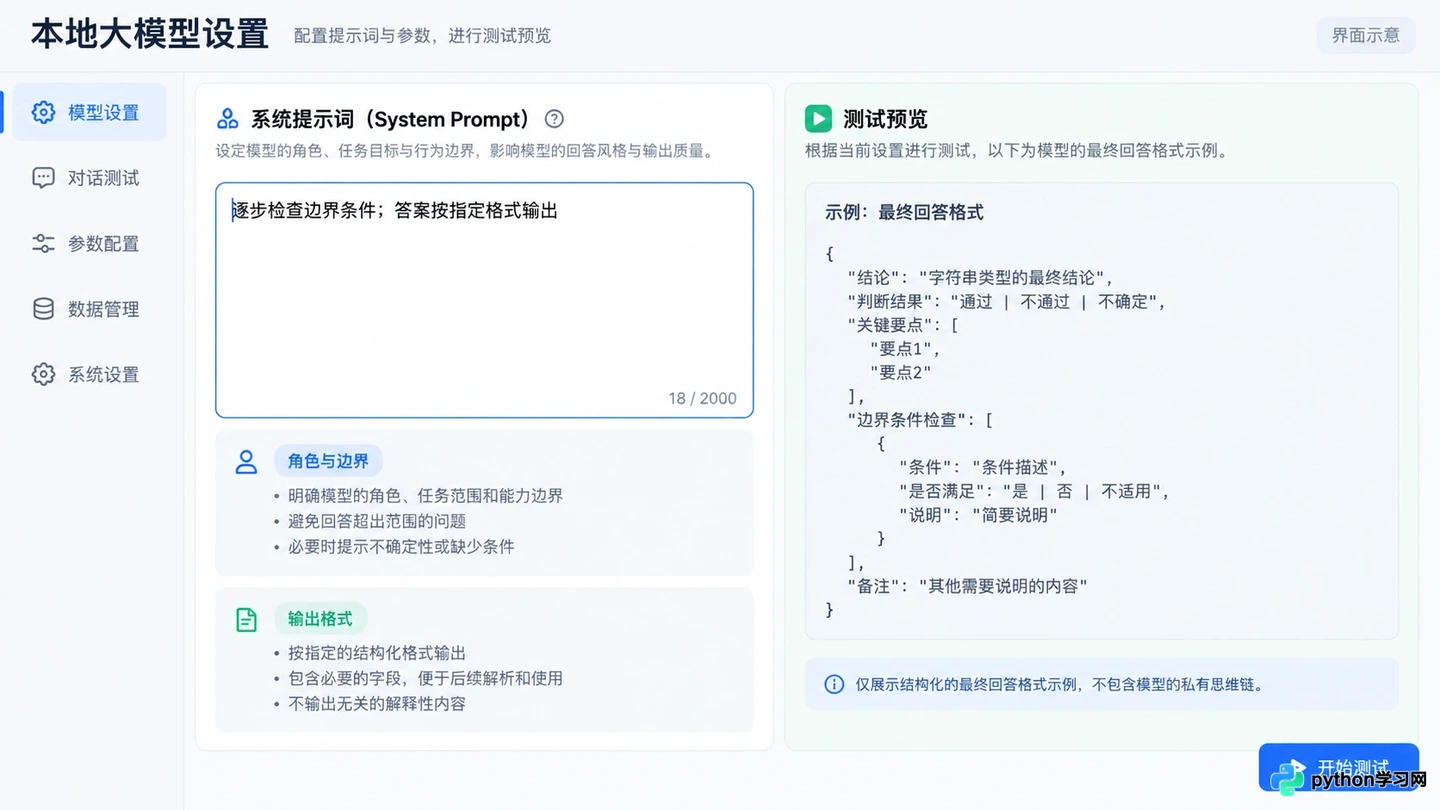
在本地部署工具中设置 System Prompt 以引导模型推理行为
值得注意的是,R1 在某些简单问题上可能会“过度思考”,生成冗长且不必要的推导。这时,可以在 Prompt 中加入“对于简单问题,请直接给出简短答案”的约束,或者在后处理阶段根据思维链的长度动态调整展示策略。这种灵活性正是本地部署的魅力所在:你不仅是用户,更是模型行为的调优师。
回到最初的取舍,本地部署 DeepSeek-R1 并非为了在速度上超越云端 API,而是为了获得对数据流向和推理过程的完全掌控。通过选择合适的推理框架、巧妙处理思维链输出、精细调配显存资源,我们能够在有限的硬件条件下,构建出一个既安全又高效的个人智能助手。对于那些重视隐私、需要定制化推理逻辑或仅仅享受折腾技术的开发者来说,这份掌控感远比单纯的算力数字更有价值。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









