

离线也能用?支持本地部署的AI PDF翻译软件推荐

在云端大模型无处不在的今天,我们习惯了将文档拖入网页,几秒后获得译文。这种便利背后隐藏着一个常被忽视的代价:数据出境。对于法律合同、医疗记录或企业内部技术文档而言,上传至第三方服务器不仅违反合规要求,更是一场心理博弈。此外,在高铁隧道、远洋船舶或封闭内网环境中,网络中断意味着工作停摆。
真正的自由,不是随时在线,而是断网时依然可控。
本地部署的AI翻译方案并非要完全取代云端服务,而是在特定边界内提供一种“主权在握”的选择。它牺牲了一定的便捷性和算力上限,换取了数据的绝对隐私和环境的独立性。本文将剥离参数罗列,从三个核心使用场景出发,评析当前可行的本地化AI PDF翻译路径,看看它们究竟解决了什么痛点,又留下了哪些麻烦。
隐私红线:当文档不能离开硬盘
对于法务、财务或研发人员来说,文档内容本身就是资产。传统的在线翻译工具虽然方便,但数据流向不可控。本地部署的核心价值在于切断这一链路,让计算发生在自己的设备上。
在这种场景下,Ollama 搭配浏览器插件或本地前端成为一种典型解法。Ollama 是一个轻量级的本地大模型运行框架,它允许用户在个人电脑上加载如 Llama 3 或 Qwen 等开源模型。配合支持本地 API 调用的翻译插件(如沉浸式翻译的本地模式),用户可以在不联网的情况下,将 PDF 中的文本提取并发送给本地运行的模型进行翻译。
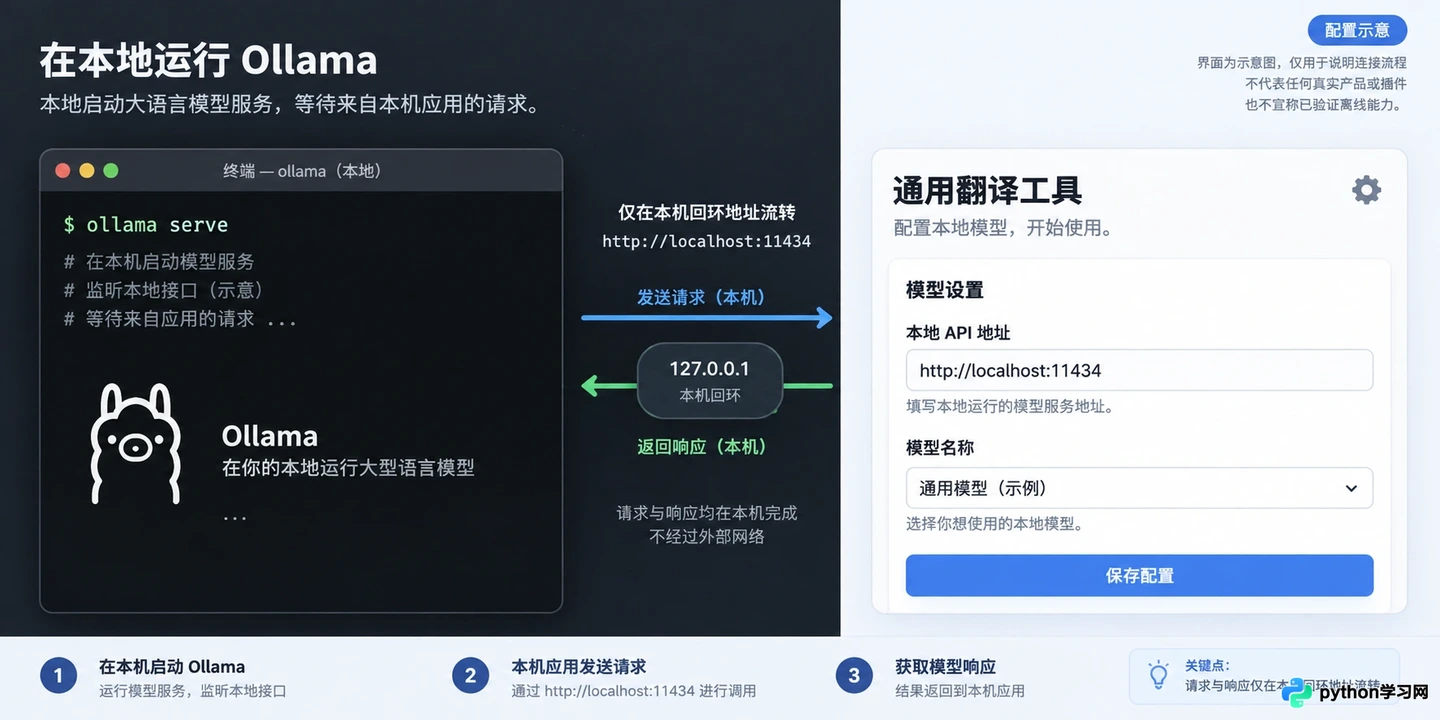
Ollama 后台运行状态与前端翻译插件的本地 API 连接设置
这种组合的优势在于彻底的数据闭环。PDF 文件从未离开过本地存储,翻译请求仅在 localhost 内部流转。然而,体验的断层也随之而来:开源模型的上下文理解能力通常弱于顶尖的云端商用模型,尤其是在处理长难句或专业术语时,可能需要人工二次校对。此外,PDF 的排版还原度取决于前端的解析能力,而非模型本身,复杂的图表和双栏排版往往会出现错位。
这并非完美的解决方案,但它是一道防火墙。当你面对一份绝密协议时,哪怕翻译结果略显生硬,其安全性也远胜于流畅但泄露风险的云端服务。
格式困境:在保持版面与翻译质量间走钢丝
PDF 翻译的最大痛点从来不是语言转换,而是版面重构。许多本地工具能翻译文字,却毁掉了原本精美的排版。对于需要直接交付译文的场景,格式保留至关重要。
DocTranslator 等基于本地 OCR 和翻译引擎的桌面软件在此类场景中表现出不同的侧重。这类软件通常不依赖生成式大模型进行语义重构,而是结合传统的机器翻译引擎(可离线部署)与光学字符识别技术。它们的工作逻辑是:先识别 PDF 中的文本块位置,替换文本,再尝试保持原有字体和布局。
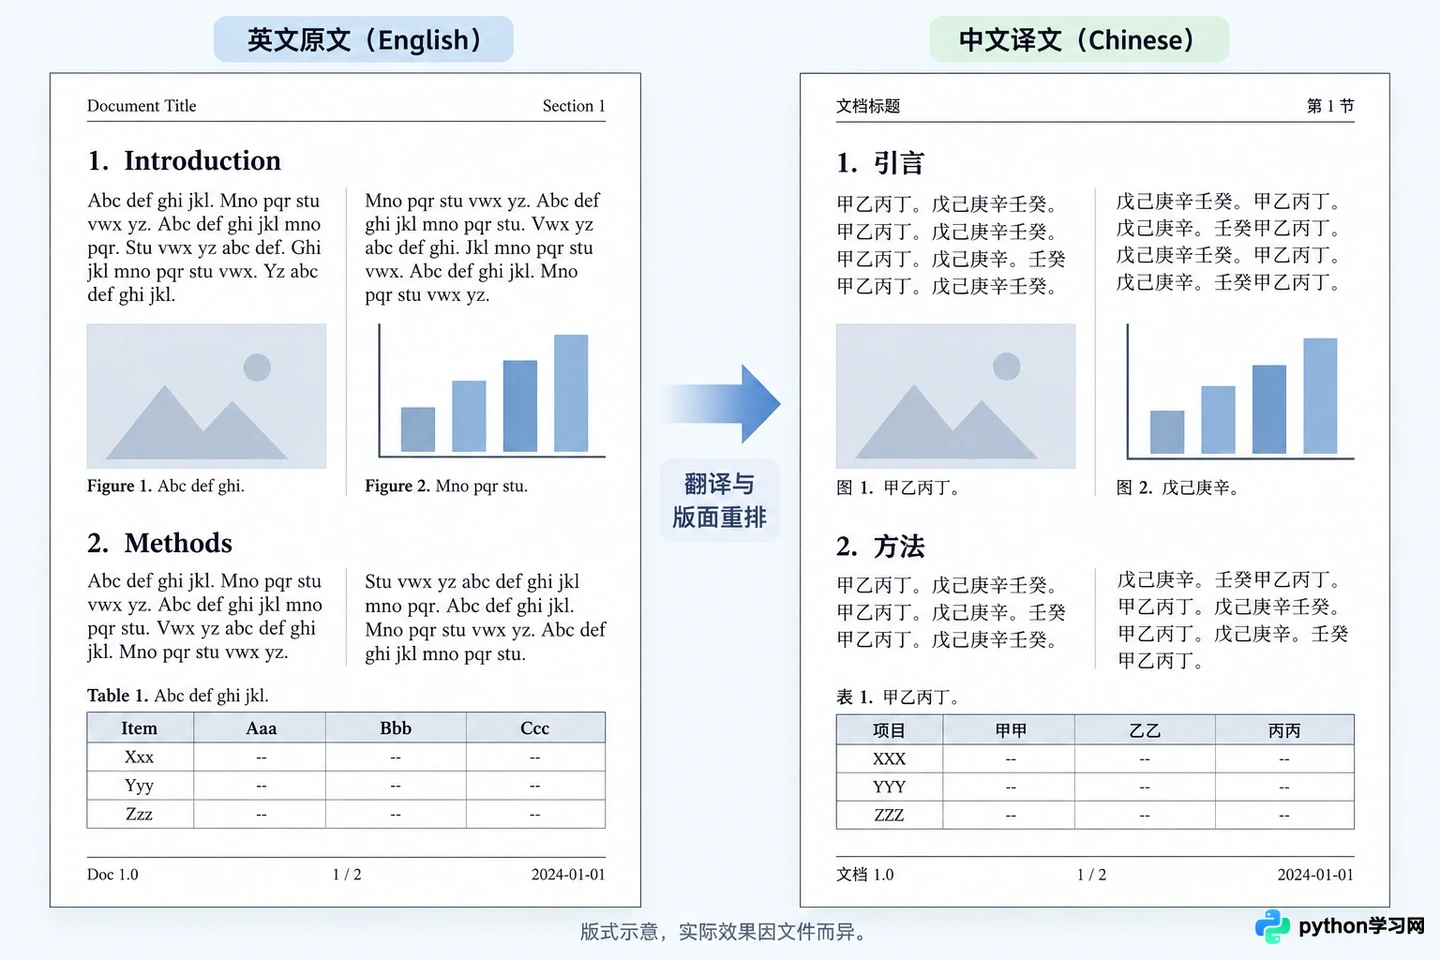
翻译前后 PDF 文档版面结构保持一致的视觉效果
在实际操作中,这类工具对扫描版 PDF 的支持优于纯文本提取工具。由于不依赖庞大的大模型推理,它们对硬件的要求相对较低,甚至在老旧笔记本上也能流畅运行。但其局限性同样明显:缺乏语境感知。例如,同一个词在不同段落可能有不同含义,本地轻量级引擎往往无法像大模型那样结合全文进行一致性调整,导致译文出现“机翻感”。
如果你需要的是一份用于内部快速浏览的参考译文,且原文包含大量扫描件,这种本地化工具是高效的选择;但若需出版级精度,仍需接受大量后期排版调整的成本。
算力门槛:本地部署不是免费的午餐
选择本地部署,意味着你要用自己的硬件为智能买单。这不是一个点击即用的服务,而是一次资源调配。
运行本地大模型进行高质量翻译,对 GPU 显存有着硬性要求。以主流的 7B-14B 参数量模型为例,至少需要 8GB 以上的独立显存才能保证流畅的推理速度。若显存不足,系统将调用内存甚至硬盘交换空间,导致翻译速度从“秒级”跌落至“分钟级”,甚至造成系统卡顿。
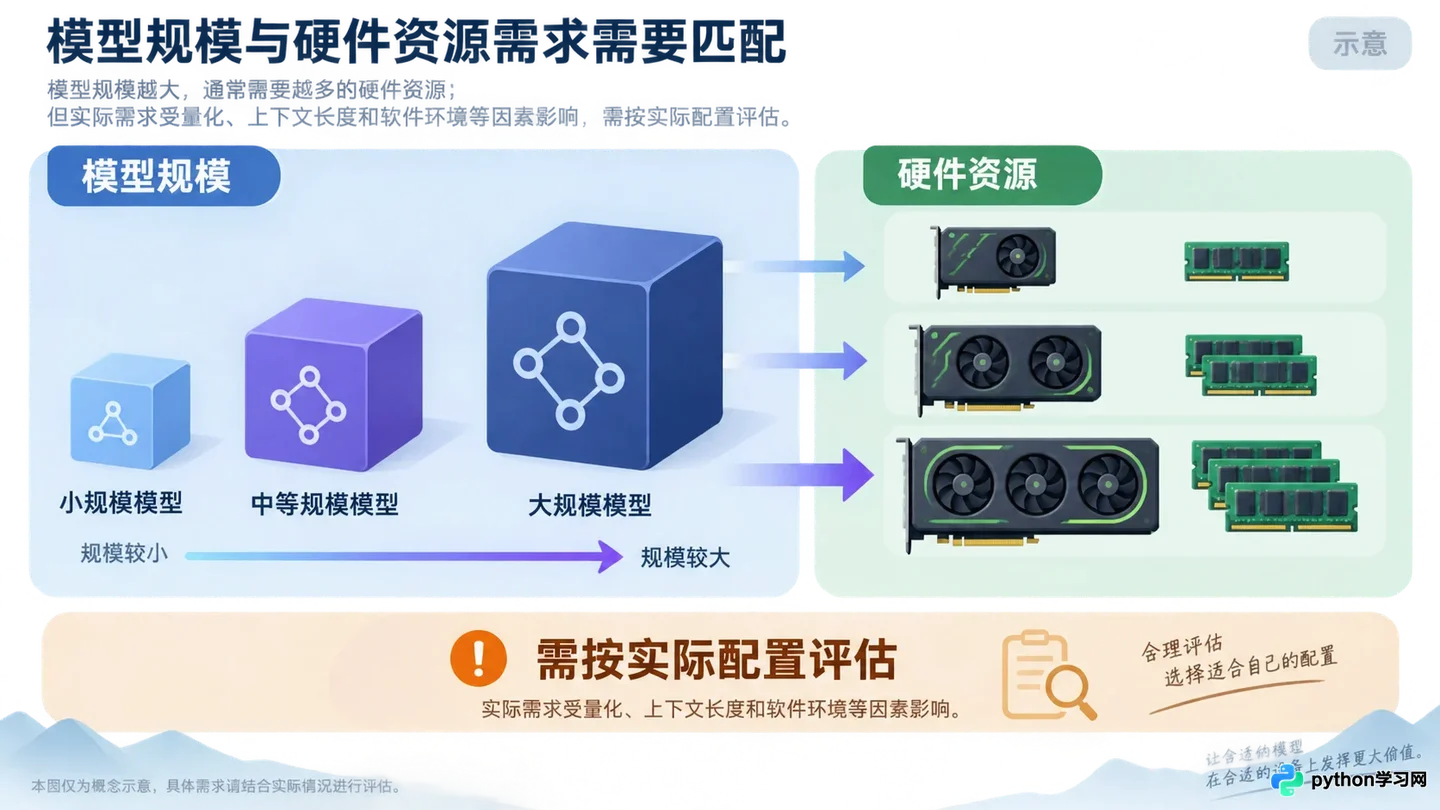
不同参数量模型对硬件资源的占用对比示意
此外,模型的选择也是一门学问。较小的模型速度快但准确度低,较大的模型准确度高但对硬件极其挑剔。用户需要在“等待时间”和“翻译质量”之间做出权衡。对于没有高性能显卡的用户,量化版本(Quantized Models)是一个折中方案,它在轻微损失精度的前提下大幅降低了显存占用,使得在普通消费级笔记本上运行成为可能。
这种门槛筛选了用户:只有那些对数据主权有极高要求,且具备一定技术动手能力的人,才能充分享受本地部署的红利。对于普通用户,配置环境的复杂度可能远超翻译本身带来的便利。
边界与选择:谁真正需要本地 AI 翻译?
回到最初的取舍:我们是否需要为了安全而忍受不便?答案取决于你的身份和需求。
如果你是自由职业者、学生或处理公开资料的研究员,云端翻译的高效和多模态能力依然是首选。它们的迭代速度和语境理解能力目前仍领先于大多数本地开源模型。
但如果你身处以下场景,本地部署则是必选项:
- 强合规行业:法律、医疗、金融等领域,数据不出域是底线。
- 无网环境:长期在隔离网络或移动信号盲区工作。
- 高频批量处理:拥有高性能工作站,希望一次性处理数百份文档而不受 API 调用限制。
离线环境中本地 AI 翻译工具的独立工作状态
本地 AI PDF 翻译不是万能钥匙,而是一把专用手术刀。它切断了数据泄露的风险,却也割裂了无缝衔接的体验。在选择之前,请先评估你的硬件底线和数据敏感度。毕竟,技术的终极意义不在于炫技,而在于在特定的约束条件下,提供最可靠的解决方案。
当网络断开,数据静默,唯有本地的算力在默默运转。这种掌控感,或许才是离线翻译最大的魅力所在。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









