

非程序员自学Python有必要吗?办公自动化与数据分析实战价值
全面分析非技术岗位自学Python的实战价值,深入拆解办公自动化与基础数据分析的核心应用场景、投入产出比决策模型、真实处理代码及避坑学习路径。
一、核心判断:什么样的业务场景真正需要 Python?
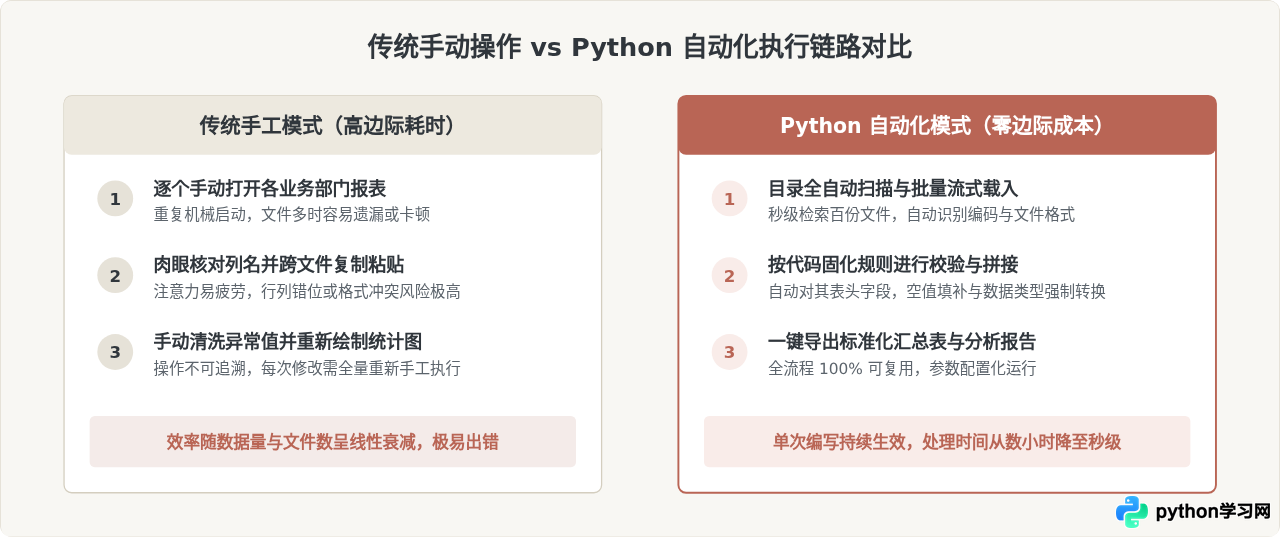
许多非程序员在考虑学习编程时,容易陷入“要么全盘接受,要么完全无用”的极端。实际上,工具的价值取决于它所解决问题的性质。评估 Python 是否值得投入时间学习,核心在于计算投入产出比(ROI):即学习基础语法与核心库所需耗费的几十个小时,能否在后续数月的工作中通过自动化释放出来。
通常来说,适合使用 Python 代替手工劳动的场景具备三个典型特征:处理频次高(每周或每日发生)、业务逻辑规则清晰(输入与输出确定)、涉及文件数量较多或跨格式(如批量处理 CSV、Excel、PDF 与邮件)。反之,对于临时性、规则每月变化或仅包含几十行数据的单次任务,使用手工或 Excel 解决反而更为敏捷。
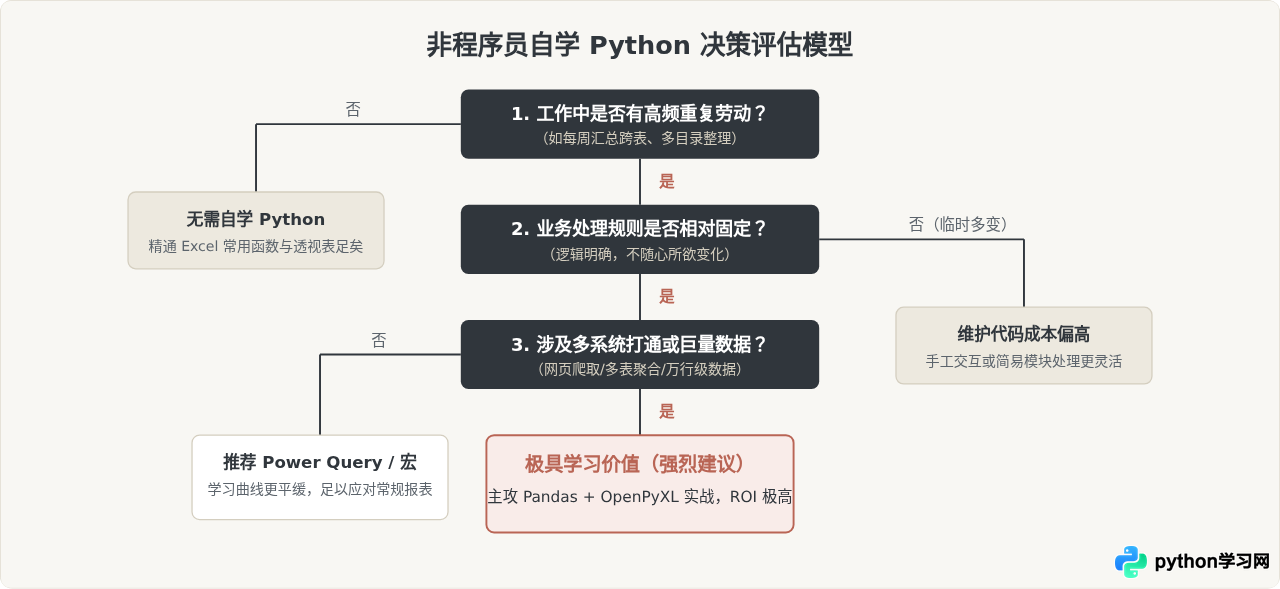
二、决策树:我是否应当开始学习 Python?
为了避免盲目跟风,非技术岗位在决定学习前,可以通过以下三个核心问题进行自我评估:
- 问题 1:日常表格数据量是否常超十万行? Excel 在处理数十万行数据或复杂关联公式(如大量 VLOOKUP、SUMIFS)时容易出现卡死或响应迟缓,而 Python 的 Pandas 库在内存中处理百万级数据仅需数秒。
- 问题 2:是否存在跨应用的数据孤岛? 如果需要从网页后台下载数据、解压压缩包、读取 PDF 中的表格、合并 Excel、最后将结果生成报告并发送企业微信或邮件,Excel 无法独立打通这一链路,而 Python 具备完善的系统胶水能力。
- 问题 3:业务处理逻辑是否具备周期重复性? 如果某项工作每个工作日或每周都需要严格按照相同的排查和计算逻辑跑一遍,那么将其写成脚本即可一劳永逸。
三、办公自动化实战:从手工合并到代码流转
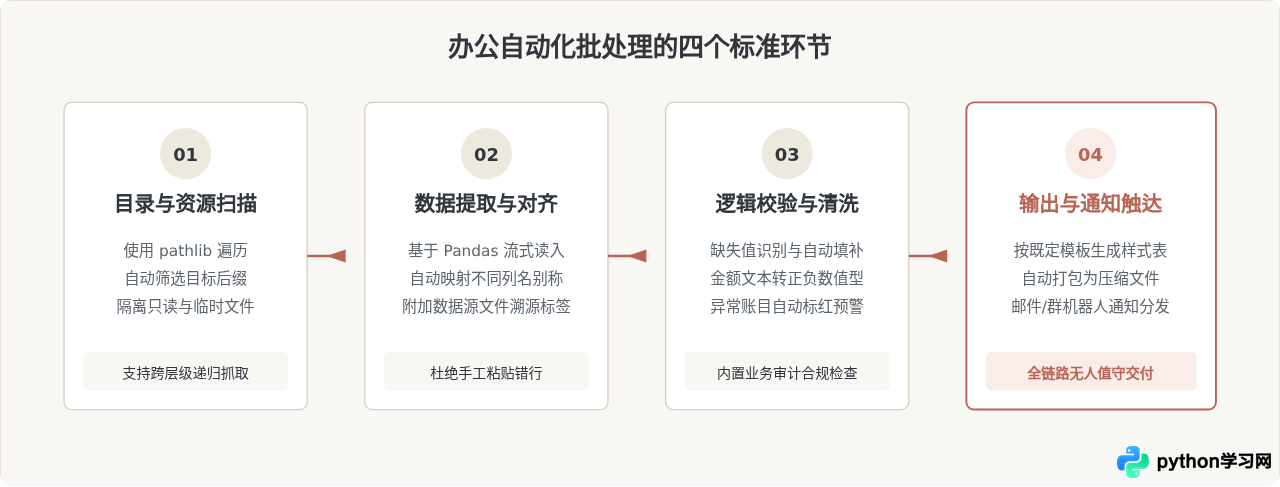
为了直观说明办公自动化的实际落地过程,以最常见的“各分公司月度销售明细合并”为例。假设每周各区域会提交数十个格式相同的 .xlsx 文件,传统方式需要财务或运营人员逐一打开、复制数据行、粘贴到总表末尾并手动排除标题行。
借助 Python 的 pandas 与 pathlib 库,只需要一段仅十余行的核心脚本,即可在 3 秒内完成所有文件的自动扫描、表头校验、空行过滤与汇总保存:
import pandas as pd
from pathlib import Path

def merge_sales_reports(source_dir: str, output_filepath: str):
    folder = Path(source_dir)
    excel_files = list(folder.glob("*.xlsx"))

    if not excel_files:
        print("未在指定目录下检索到 Excel 文件。")
        return

    data_frames = []
    for file in excel_files:
        # 跳过临时缓存文件
        if file.name.startswith("~$"):
            continue
        # 读取每个工作表,并自动保留来源文件名作为溯源列
        df = pd.read_excel(file)
        df["数据来源文件"] = file.name
        data_frames.append(df)

    # 一键纵向拼接
    combined_df = pd.concat(data_frames, ignore_index=True)

    # 基础数据清洗:去除关键列为空的脏数据
    combined_df.dropna(subset=["销售单号", "交易金额"], inplace=True)

    # 输出合并后的完整结果
    combined_df.to_excel(output_filepath, index=False)
    print(f"成功合并 {len(excel_files)} 个报表,累计行数:{len(combined_df)}")

# 示例调用
# merge_sales_reports("./各分部原始表", "./月度销售汇总表_已合并.xlsx")~$),并在合并时保留一个“来源文件列”,以便后续数据审计与错账反查。
四、数据分析实战价值:从“画折线图”到“业务归因”
非程序员自学数据分析时最容易误入歧途的,是误以为掌握复杂的机器学习算法(如随机森林、神经网络)才算懂数据分析。但在日常运营、市场或财务岗位中,90% 以上的数据分析价值来自于清晰的数据透视、多维分组统计与趋势归因。
Python 在此阶段的核心价值并非替代人类决策,而是极大降低了深度探索数据的阻力。例如在销售分析中,业务人员常常需要回答:“哪个渠道的客单价最高?”“退款率最高的商品类别有哪些特征?”在 Excel 中,频繁调整数据透视表维度很容易遭遇卡顿或层级混乱;而使用 Pandas,只需一行代码即可完成多维切片与聚合计算:
# 快速分析不同渠道、不同品类的关键业务指标
channel_summary = df.groupby(["渠道来源", "商品类别"]).agg(
    总成交额=("交易金额", "sum"),
    订单总量=("销售单号", "count"),
    客单均价=("交易金额", "mean"),
    退款率=("是否退款", "mean")
).reset_index()

# 筛选退款率高于 15% 且订单量大于 100 的重点关注品类
high_risk_categories = channel_summary[
    (channel_summary["退款率"] > 0.15) & (channel_summary["订单总量"] > 100)
]这种结构化表达不仅运行迅速,更重要的是分析逻辑具备完全的可复现性。当下个月新数据到达时,只需重新运行脚本,即可立刻获得最新的高风险预警清单,无需重新手动配置透视表。
五、自学路径规划:如何用最少时间拿到最高收益?
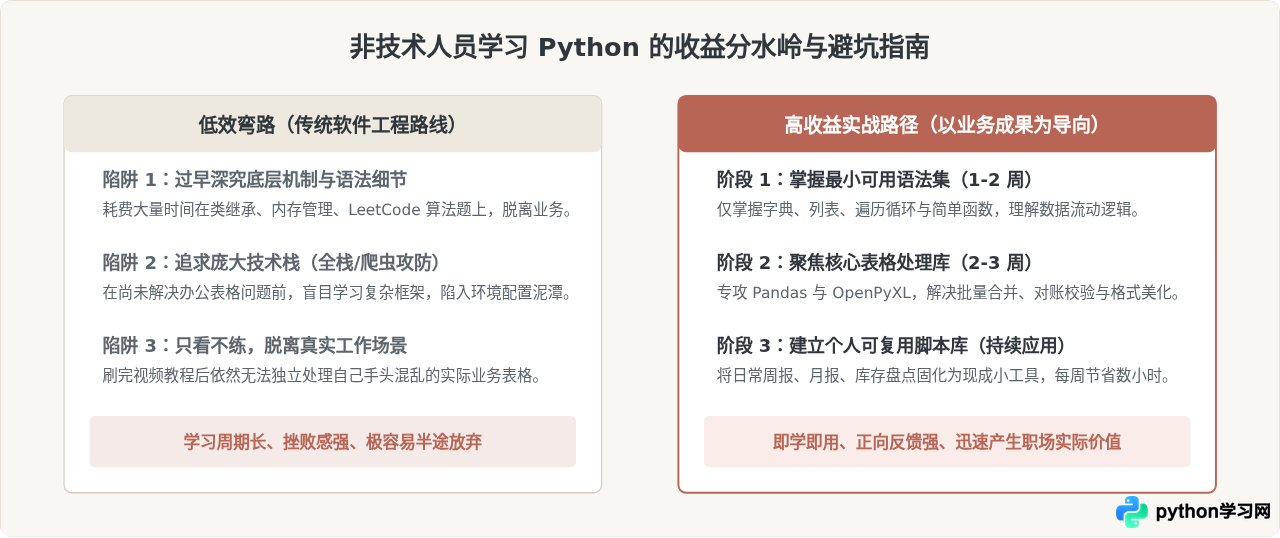
非程序员学 Python 失败的最主要原因,是按照计算机专业教材的方式去啃底层算法、数据结构(如二叉树、链表)或深入面向对象编程(类与元类)。对于业务人员而言,编程的本质是“功能调用”,而非“软件工程架构设计”。
建议采用“以终为始”的高效实用路径:
- 第一阶段(语法极简子集,约 1 周):仅学习变量、字符串操作、列表(List)、字典(Dictionary)、
for循环与基础条件判断(if-else)。跳过面向对象的高级特性与复杂装饰器。 - 第二阶段(业务库攻坚,约 2 周):重点掌握三大支柱:
pathlib(管理本地文件与文件夹路径)、pandas(表格读取、拼接、分组与计算)、openpyxl(调整 Excel 单元格颜色、边框与样式)。 - 第三阶段(自身痛点实战,持续):不要做教学演示中的虚拟练习题,直接拿自己工作中目前最繁琐的一项表格处理任务开刀,将其改造成一个自动化脚本。跑通一个实际工作流带来的正向激励,远超刷几十道理论题。
六、总结:工具理性与能力边界
回到最初的问题:“非程序员自学 Python 有必要吗?”答案是:不需要将自己培养成专业程序员,但完全值得将 Python 作为日常办公的高级外挂。
学习编程的核心目标不是转行去开发大型软件,而是利用脚本将自己从无休止的机械复制粘贴、肉眼对账和繁复的格式整理中解放出来。在数据驱动业务的当下,真正稀缺且具备职场竞争力的,是那些“既深刻理解实际业务痛点与客户逻辑,又能用轻量自动化工具将执行效率提升十倍”的复合型业务专家。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









