

Python concurrent.futures统一接口:简化多线程与多进程代码编写
深入解析 Python concurrent.futures 统一接口的设计思想与实战用法,通过代码示例、执行机制对比及调优策略,帮助开发者高效编写兼顾多线程与多进程的高并发程序。
在 Python 早期开发中,若要实现并发任务,通常需要分别依赖底层的 threading 模块或 multiprocessing 模块。这两套接口在线程与进程的生命周期管理、参数传递、队列同步以及异常捕获机制上存在明显的分歧与差异,导致业务逻辑与并发执行细节紧密耦合。Python 3.2 引入的 concurrent.futures 模块通过提供一致的高层抽象(Executor 基类及 Future 对象),将任务定义与实际底层执行机制解耦,使开发者只需通过统一的 API 就能无缝在多线程与多进程之间切换,大幅降低并发代码的编写与维护成本。
一、统一设计哲学与核心架构
concurrent.futures 的核心价值在于规范化并发编程范式。无论底层采用线程池还是进程池,调度端都面向完全相同的操作模型:创建执行器、提交任务、获取承载异步结果的句柄(Future),并在合适时机获取计算值或拦截异常。
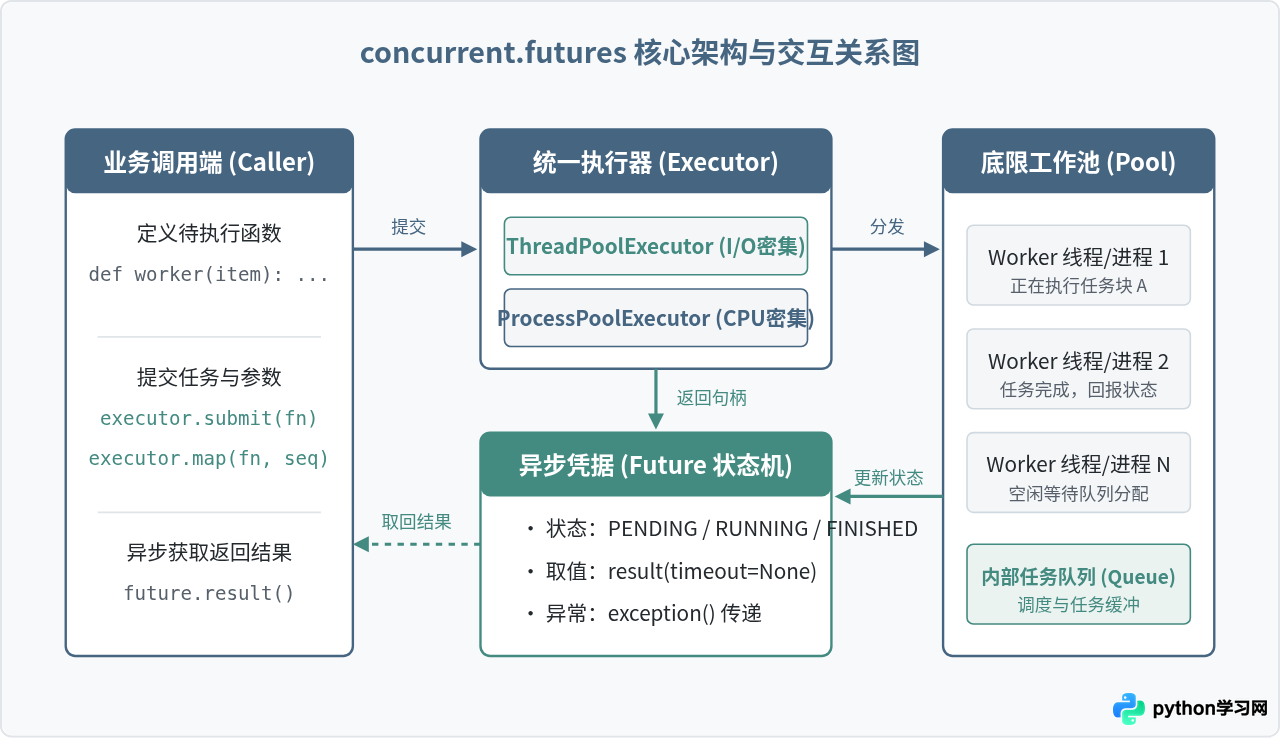
该模型由三个关键部分协同工作:
- Executor 基类:定义统一的执行生命周期与调度接口,具体子类为
ThreadPoolExecutor和ProcessPoolExecutor。 - Future 封装:表示一个尚未完成但承诺在未来返回结果的异步操作。它封装了执行状态、执行结果以及可能产生的异常,并提供状态查询与回调注册能力。
- 工作资源池与队列:由执行器在后台维护的工作线程或子进程集群。任务被放入内部队列后由空闲 Worker 取出执行,完成后自动将产物写回对应的 Future。
二、标准四步操作法与并发代码编写
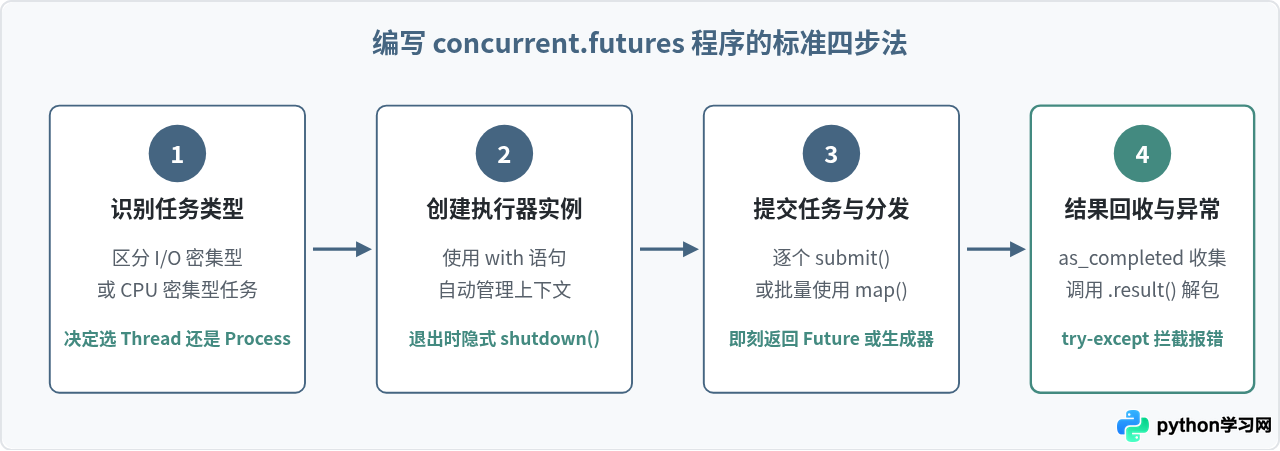
使用 concurrent.futures 编写并发程序有一套清晰标准的步骤。无论针对文件读取、接口请求还是密集数值计算,逻辑都分为负载判定、实例化、提交任务与获取结果四个环节。
1. 多线程示例:处理 I/O 密集型任务
网络请求与文件读写大部分时间消耗在等待外部响应上,Python 的全局解释器锁(GIL)在此期间会自动释放,因此非常适合采用 ThreadPoolExecutor。
import time
from concurrent.futures import ThreadPoolExecutor, as_completed

def fetch_data(task_id: int) -> dict:
    # 模拟网络 I/O 延迟
    time.sleep(1)
    if task_id == 3:
        raise ValueError(f"任务 {task_id} 数据校验未通过")
    return {"id": task_id, "data": f"content_{task_id}"}

task_ids = [1, 2, 3, 4, 5]

# 使用上下文管理器创建 3 个工作线程的线程池
with ThreadPoolExecutor(max_workers=3) as executor:
    # 建立 Future 到 task_id 的映射,便于溯源
    future_to_id = {executor.submit(fetch_data, tid): tid for tid in task_ids}

    # as_completed 会按任务完成的先后顺序迭代返回 Future
    for future in as_completed(future_to_id):
        tid = future_to_id[future]
        try:
            result = future.result()
            print(f"[成功] 任务 {tid} 返回: {result}")
        except Exception as exc:
            print(f"[异常] 任务 {tid} 抛出错误: {exc}")
2. 无缝平移:一行代码切换为多进程
如果任务从“网络请求”变更为“高密度矩阵计算”或“图像特征提取”,由于受制于 GIL,多线程无法利用多核 CPU。此时,由于 concurrent.futures 提供了完全一致的接口规范,我们几乎不需要改写任务提交和结果解析逻辑,只需更换执行器导入与实例化即可:
import math
from concurrent.futures import ProcessPoolExecutor, as_completed

def compute_heavy(n: int) -> int:
    # CPU 密集型计算任务
    return sum(int(math.sqrt(i)) for i in range(n))

if __name__ == '__main__':
    data_list = [5000000, 6000000, 7000000, 8000000]

    # 仅将 ThreadPoolExecutor 替换为 ProcessPoolExecutor
    with ProcessPoolExecutor(max_workers=4) as executor:
        futures = [executor.submit(compute_heavy, val) for val in data_list]
        for future in as_completed(futures):
            print(f"计算完成: {future.result()}")
with executor: 代码块时,执行器会自动触发 executor.shutdown(wait=True)。该操作会阻塞当前主线程,直到线程池或进程池中所有已提交的任务执行完毕,并安全释放底层系统句柄与内存,避免产生孤儿进程或悬挂线程。
三、结果收集方式对比:as_completed 与 map
在实际编码中,针对批量任务的结果收集,主要有两种途径:executor.map() 和 concurrent.futures.as_completed()。理解两者的调度与产出差异,是保证系统吞吐量的关键。
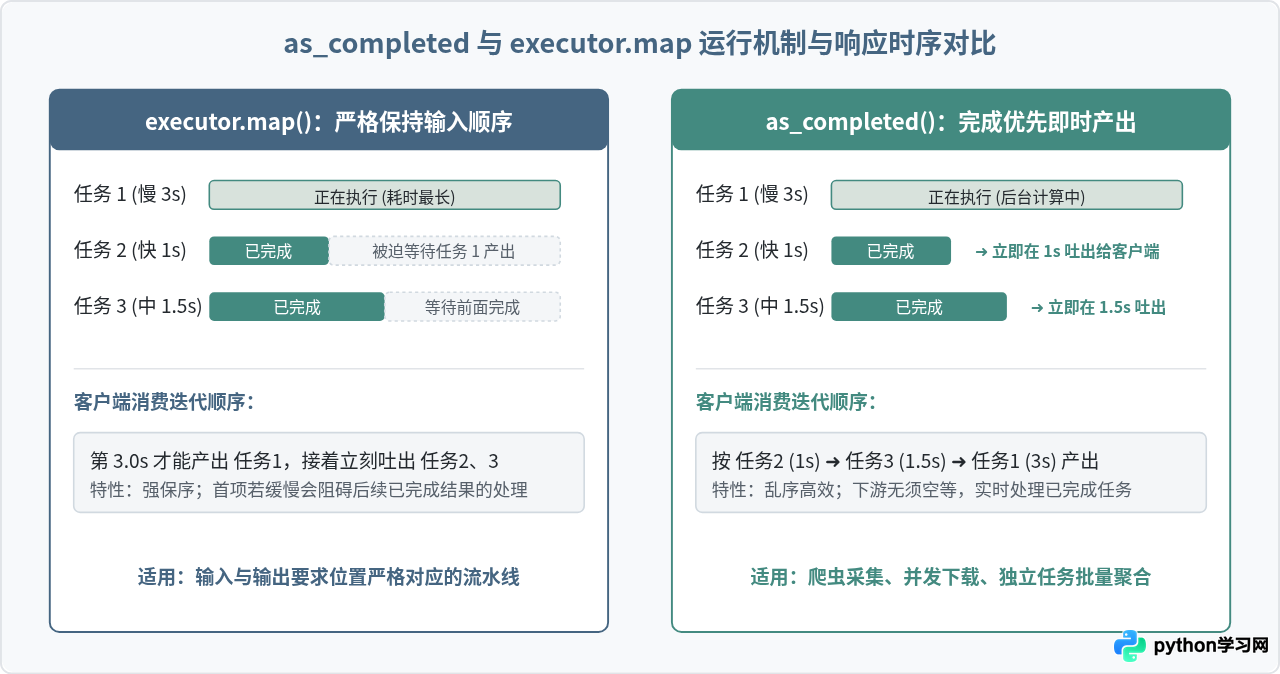
为了直观对比两者的使用方式与特征,可以参考下表:
| 对比维度 | executor.map(func, *iterables) | as_completed(fs) |
|---|---|---|
| 返回值类型 | 直接返回结果生成器(Generator of Results) | 返回已完成的 Future 迭代器(Iterator of Futures) |
| 输出顺序 | 严格与输入参数序列保持一致(保序) | 谁先计算完毕谁先产出(先到先得) |
| 阻塞特征 | 若前序某个任务耗时极长,后续结果虽已完成但仍被阻塞 | 无额外等待阻塞,只要有任何任务完成立即返回 |
| 异常处理时机 | 在遍历生成器遇到出错项时就地抛出异常 | 调用 future.result() 时才抛出,可细粒度针对单个任务 try-except |
| 适用场景 | 轻量批处理、对输出顺序有严格要求的数值映射 | 网络爬虫、并发微服务调用、高吞吐即时存储 |
四、实际应用中的关键限制与踩坑提示
尽管 concurrent.futures 大幅简化了接口,但在实际生产运行中,依然有几个关键限制需要严格遵守:
1. 多进程环境下的序列化(Pickle)限制
ProcessPoolExecutor 依赖操作系统进程间通信(IPC)。在任务分发与结果返回时,传递的参数函数、参数对象以及返回值必须能够被 Python 的 pickle 模块正常序列化。如果在任务中传递了数据库游标连接(Connection)、匿名函数(lambda)或局部闭包,系统会直接抛出 PicklingError。
2. 平台差异与入口保护
在 Windows 和 macOS(Python 3.8+ 默认使用 spawn 启动进程模式)上,子进程启动时会重新导入主模块。因此,创建 ProcessPoolExecutor 的代码必须包裹在 if __name__ == '__main__': 守护块内,否则会引发递归创建子进程的无限循环崩溃。
3. 并发工作数(max_workers)配置策略
工作线程与工作进程的数量不能随意设置:
- CPU 密集型(ProcessPoolExecutor):建议设置为本机的物理核心数,即
os.cpu_count()。进程过多不仅无法提升算力,反而会因为操作系统频繁的 CPU 进程上下文切换而导致性能严重下降。 - I/O 密集型(ThreadPoolExecutor):由于线程在网络 I/O 时处于挂起状态,通常可以设置得稍大。在 Python 3.8+ 中,若不指定
max_workers,默认值为min(32, (os.cpu_count() or 1) + 4),能够兼顾大部分吞吐需求。
五、并发选型与调优决策指南
在面对具体的业务需求时,通过以下决策路径可以快速确定适合的执行器与收集方案:
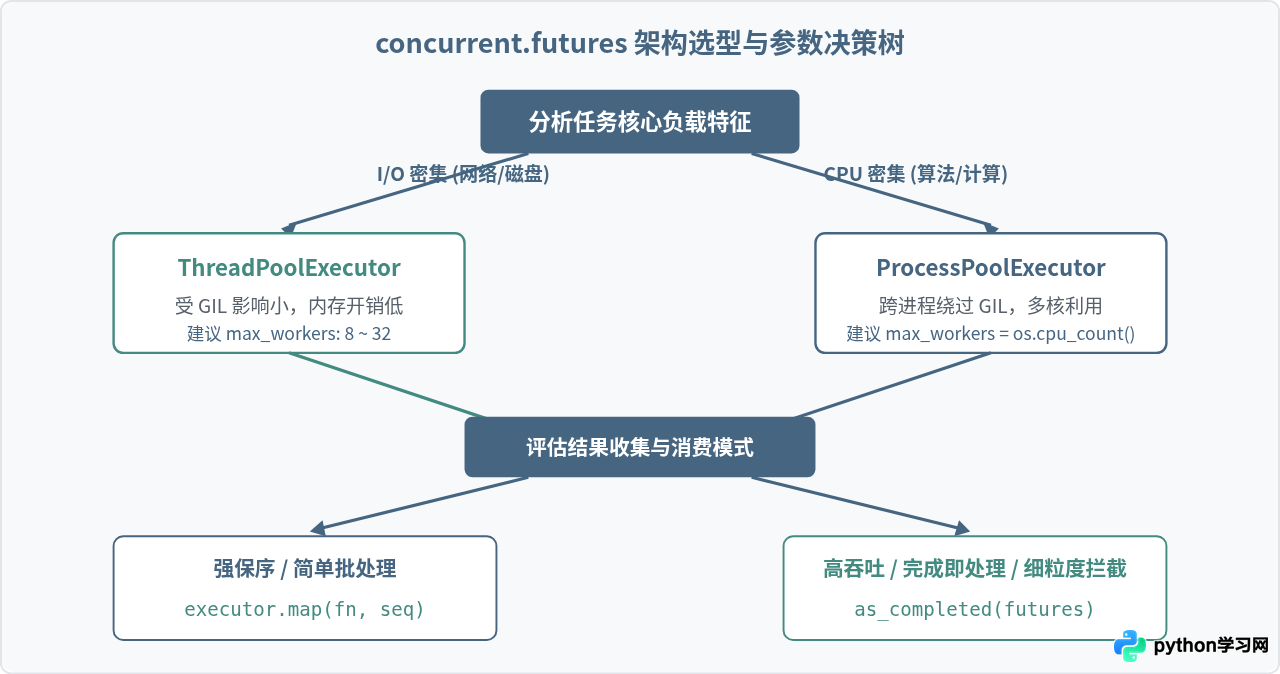
concurrent.futures 模块通过提供一致的高层 API,将 Python 中多线程与多进程的编程范式高度统一。在实际开发中,优先使用带有 with 的上下文管理器管理池生命周期,合理评估 I/O 与 CPU 负载,并结合 as_completed 实现高吞吐流水线,能够让并发代码在保证稳健性的同时显著提升编写效率。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









