

Python元组怎么统计元素出现次数和查找位置
本文详细讲解在Python元组中如何使用count()方法统计元素出现次数,以及使用index()方法查找元素索引位置,涵盖基本语法、范围查找、ValueError异常防御与多位置查找等实用技巧。
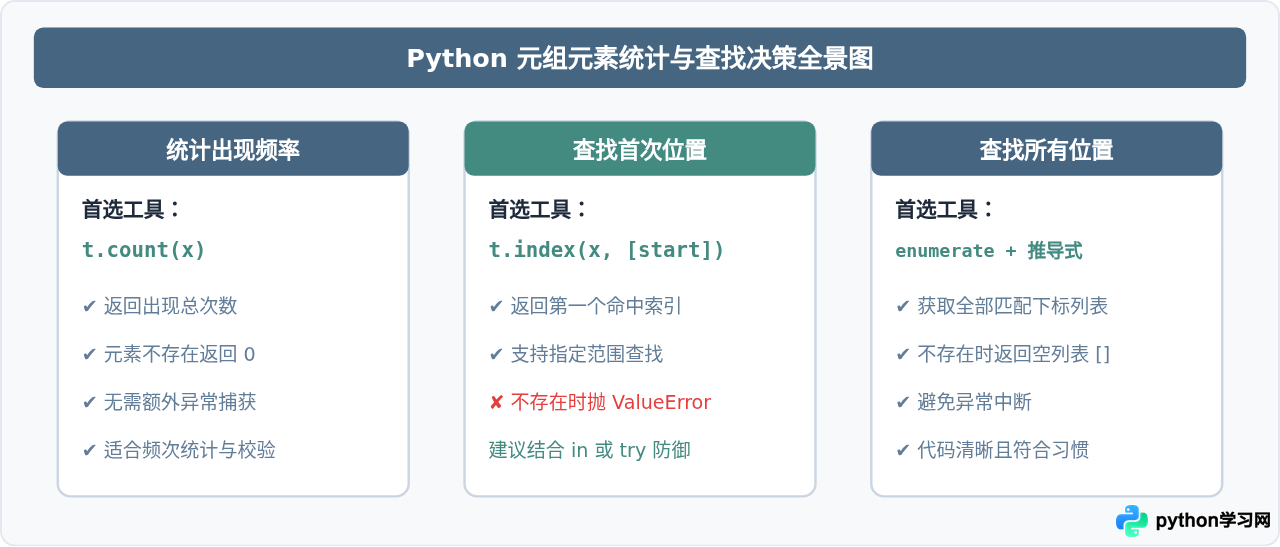
在 Python 中,元组(tuple)是一种不可变且有序的序列结构。统计某个元素在元组中出现的次数,可以使用内置的 count() 方法;查找某个元素第一次出现的位置索引,则使用内置的 index() 方法。这两个方法执行速度快且直接返回结果,是处理元组元素定位与频率统计的标准手段。
一、元组内置统计与查找方法概览
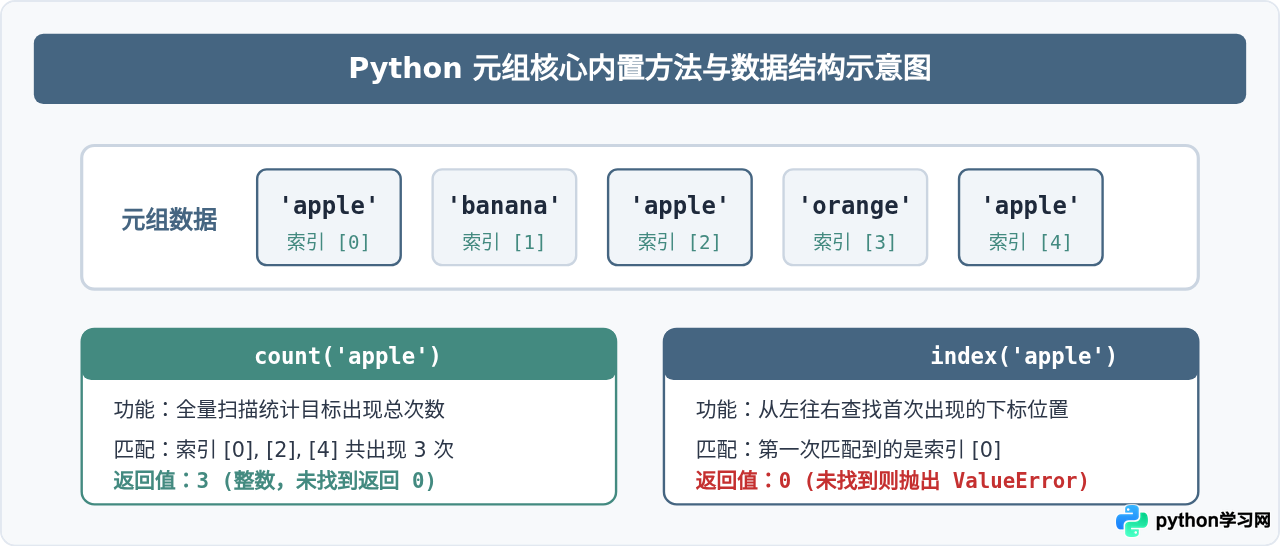
元组因为具有不可变性,所以没有像列表那样的 append()、remove() 或 pop() 等修改方法。Python 元组直接提供的操作方法只有两个:tuple.count(x) 和 tuple.index(x, [start, [stop]])。它们在保证数据安全不被更改的前提下,满足读取、定位和统计的核心需求。
二、使用 count() 统计元素出现次数
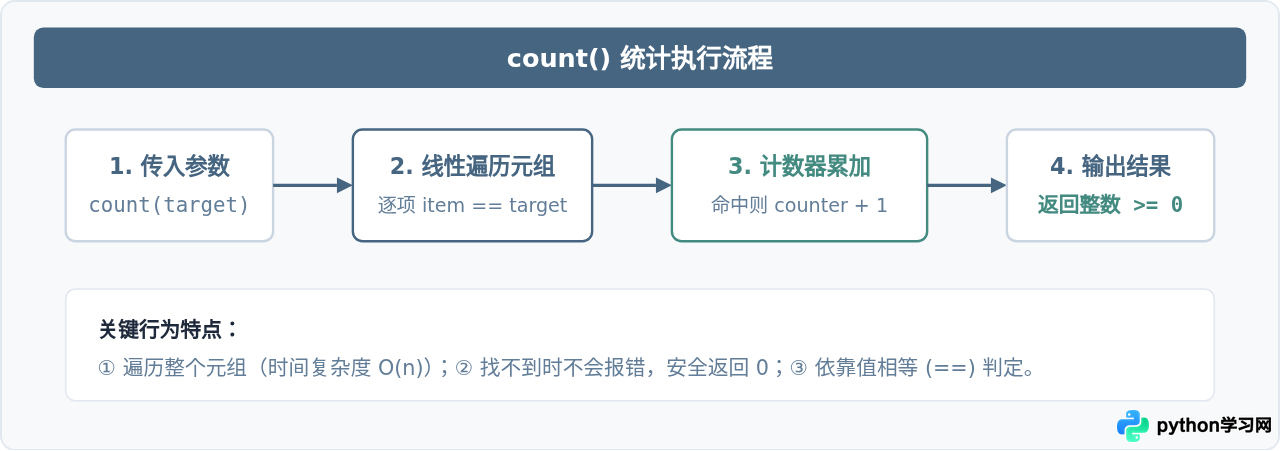
count() 方法接收一个参数,即需要统计的目标元素,其返回值是一个非负整数。如果目标元素在元组中存在,则返回具体的出现频次;若完全不存在,则安全返回 0,不会产生报错。
1. 基本使用示例
下面演示统计不同数据类型元素在元组中的出现次数:
# 定义包含重复元素的元组
scores = (95, 88, 95, 76, 95, 100, 88)

# 统计 95 分出现的次数
count_95 = scores.count(95)
print("95分出现的次数:", count_95)  # 输出示例:95分出现的次数: 3

# 统计元组中不存在的元素 60
count_60 = scores.count(60)
print("60分出现的次数:", count_60)  # 输出示例:60分出现的次数: 0
2. 数据类型与相等性判断细节
在 Python 中,count() 是通过双等号 ==(值相等性)进行比对的。这意味着如果元组中同时包含布尔值与数值,可能会命中隐式相等的匹配规则:
# Python 中 True == 1 且 False == 0
mixed_tuple = (1, True, "hello", 0, False)

# 统计数字 1,会将 True 计入;统计 True 同样会将 1 计入
print(mixed_tuple.count(1))     # 输出示例:2
print(mixed_tuple.count(True))  # 输出示例:2
在编写混合数据类型的元组统计逻辑时,如果必须区分具体类型,建议先通过类型过滤或使用列表推导式配合 is 关键字核验。
三、使用 index() 查找元素的索引位置
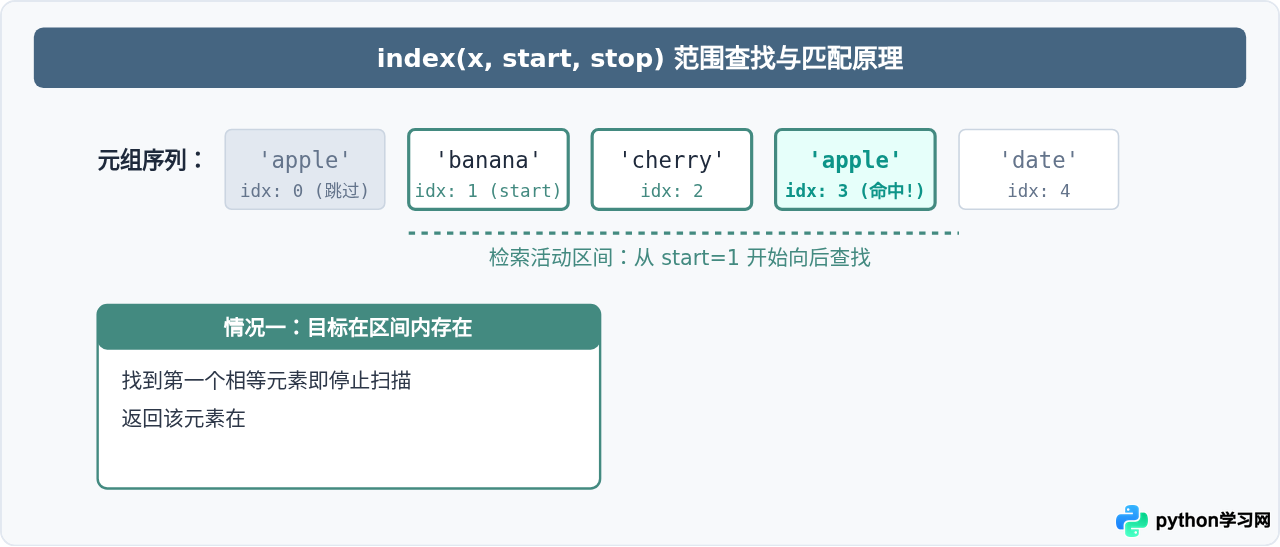
index() 方法用于检索目标元素在元组中首次出现的位置索引(索引从 0 开始计数)。它的完整语法形式为:
tuple.index(x, [start, [stop]])x:要检索的目标元素值。start(可选):检索起始索引(包含该位置)。stop(可选):检索终止索引(不包含该位置,即左闭右开区间)。
1. 基础查找与首次匹配特性
fruits = ('apple', 'banana', 'cherry', 'apple', 'date')

# 查找 'banana' 的位置
pos_banana = fruits.index('banana')
print("banana 的索引位置:", pos_banana)  # 输出示例:banana 的索引位置: 1

# 查找包含重复项的 'apple'
pos_apple = fruits.index('apple')
print("apple 第一次出现的索引位置:", pos_apple)  # 输出示例:apple 第一次出现的索引位置: 0
可以看到,元组中虽然有两个 'apple',但 index() 一旦遇到第一个匹配项就会立即终止搜索并返回其索引 0。
2. 指定范围查找(start 与 stop)
如果希望从特定位置之后开始查找,或者将检索限制在某一段区间,可以指定 start 和 stop 参数:
# 从索引 1 开始向后查找下一个 'apple'
second_apple = fruits.index('apple', 1)
print("从索引1开始找到的apple位置:", second_apple)  # 输出示例:从索引1开始找到的apple位置: 3

# 在区间 [1, 3) 内查找,不包含索引 3
try:
    fruits.index('apple', 1, 3)
except ValueError as e:
    print("在[1, 3)区间内未找到apple")  # 输出示例:在[1, 3)区间内未找到apple
四、异常处理与进阶技巧:查找所有出现位置
在实际编程中,直接调用 index() 如果不加防护,当元素不存在时会导致整个程序抛出 ValueError 中断运行。另外,index() 只能找到第一个匹配项,如果元组中有多个重复元素,需要掌握获取全部索引的方法。
1. 避免 ValueError 的两种防护手段
第一种手段是使用 in 关键字进行前置成员检查;第二种手段是使用 try...except 结构捕获异常:
target = 'mango'
fruits = ('apple', 'banana', 'cherry')

# 方式一:使用 in 前置判断(逻辑清晰、代码直观)
if target in fruits:
    pos = fruits.index(target)
    print(f"找到 {target},索引为:{pos}")
else:
    print(f"{target} 不在元组中,安全跳过")

# 方式二:使用 try-except 捕获异常(适用于频繁查找且大概率存在的场景)
try:
    pos = fruits.index(target)
    print(f"找到 {target},索引为:{pos}")
except ValueError:
    print(f"未检索到 {target}")
2. 获取元素出现的全部索引位置
当元素在元组中出现多次时,如果想要得到所有出现位置的索引列表,可以使用内置函数 enumerate() 配合列表推导式:
letters = ('a', 'b', 'c', 'a', 'd', 'a', 'e')
target = 'a'

# 使用 enumerate 同时获取下标与值,筛选出值等于 target 的所有下标
all_indices = [idx for idx, val in enumerate(letters) if val == target]

print(f"元素 '{target}' 出现的所有索引位置:", all_indices)
# 示例输出:元素 'a' 出现的所有索引位置: [0, 3, 5]
这种写法不仅简洁高效,而且即使元素完全不存在,也会自然返回一个空列表 [],既安全又易于后续处理。
五、方法对比与选型指南
为了帮助读者在不同开发场景中快速选择合适的操作方式,下表对常见统计与查找方案进行了横向对比:
| 需求场景 | 推荐使用方式 | 返回值类型 | 未匹配时的表现 | 时间复杂度 |
|---|---|---|---|---|
| 统计某元素在元组中出现的总频次 | tuple.count(x) |
int(数值 >= 0) |
返回 0(不报错) |
O(n) |
| 获取某元素首次出现的具体索引 | tuple.index(x)(建议配合 in) |
int(位置下标) |
抛出 ValueError |
O(n) 最坏情况 |
| 仅判断元素是否在元组中存在 | x in tuple |
bool(True/False) |
返回 False |
O(n) 最坏情况 |
| 获取某元素出现的所有索引列表 | [i for i, v in enumerate(t) if v == x] |
list(索引集合) |
返回空列表 [] |
O(n) |
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









