

python私有函数下划线命名约定是什么
全面解析Python私有函数与下划线命名约定:单前导下划线的内部弱约束、双前导下划线的名称修饰机制、魔术方法与最佳决策流程。
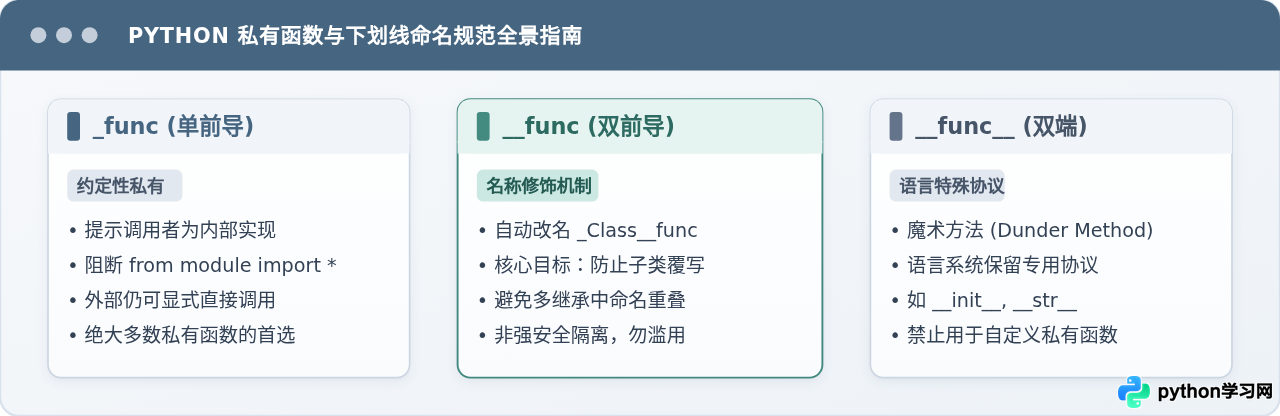
private 等关键字强行限制函数或方法访问权限的语法机制,而是依靠下划线命名约定与解释器名称修饰(Name Mangling)来实现不同程度的内部封装与防冲突隔离。其中核心规范包括:单前导下划线(如 _func)用于向开发者提示该函数属于内部实现细节并在通配符导入时自动过滤;双前导下划线(如 __func)由解释器自动重命名以防止在复杂继承体系中被子类意外覆盖;首尾双下划线(如 __init__)则是 Python 保留的内建魔术协议。
一、设计哲学:为什么 Python 没有真正的 private 关键字
在深入各类下划线前,需要先理解 Python 社区著名的准则:“大家都是成年人(We are all consenting adults here)”。Python 语言的设计者认为,严格的语法级访问控制往往并不能阻止真正想破坏封装的程序员,反而会增加调试、反射、单测打桩和扩展框架时的阻碍。
因此,Python 选择了一种“基于约定的软件工程实践”:由语言规范(PEP 8)定义清晰的命名语义,由代码阅读者与维护者共同遵守契约。这种设计把注意力放在了 API 边界的清晰划分,而不是构筑难以突破的内存围墙。
二、单前导下划线(_func):弱私有与内部使用约定
以单个下划线开头的函数或方法(例如 _validate_data()、_parse_token()),是 Python 中最通用、也是最推荐的“私有函数”写法。PEP 8 明确将其定义为“指示内部使用的弱约定(Weak 'Internal Use' Indicator)”。
1. 命名语义与开发规范
当一个函数被命名为 _helper() 时,作者明确向外界传递了两个信息:
- 稳定性警告:该函数属于模块或类的内部实现细节,未来可能随时修改其参数、签名甚至直接废弃,外部调用者不应将其作为公共 API 建立业务依赖。
- 封装意图:外部代码应该通过没有下划线的公共接口(如
calculate())来间接触发此功能,而不是直接绕过外层逻辑单独调用内部处理步骤。
2. 解释器的实际拦截行为:通配符导入过滤
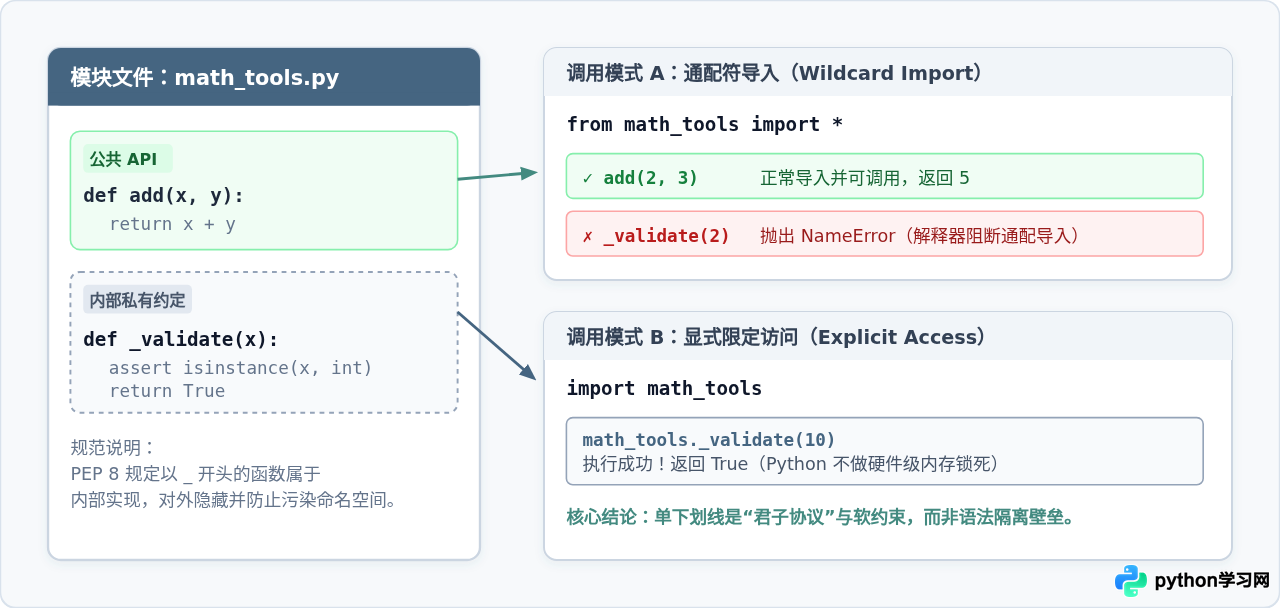
单前导下划线并非纯粹的文字约定,Python 解释器在处理模块导入时为其赋予了一项具体的语法特性:当使用 from module import * 时,所有以单下划线开头的对象都会被自动忽略,不会被加载到当前命名空间中。
# 文件名:math_tools.py

def add(x, y):
    """公开函数:正常计算加法"""
    _check_type(x)
    _check_type(y)
    return x + y

def _check_type(val):
    """内部私有函数:校验输入类型"""
    if not isinstance(val, (int, float)):
        raise TypeError("参数必须为数值类型")
在另一个脚本中测试导入行为:
# 示例调用 A:使用通配符导入
from math_tools import *

print(add(10, 20))       # 示例输出:30
# _check_type(10)        # 示例输出:抛出 NameError: name '_check_type' is not defined

# 示例调用 B:显式导入或模块属性访问
import math_tools
math_tools._check_type(10) # 示例输出:执行正常通过,返回无异常__all__ = ['add', '_check_type'],那么通配符导入的行为将完全以 __all__ 列表为准,此时即使带有下划线的函数也会被导入。
三、双前导下划线(__func):名称修饰(Name Mangling)机制
当在类的方法或属性前使用两个连续的前导下划线,且末尾至多只有一个下划线时(例如 __calculate_hash()、__secret_key),Python 解释器会触发一项名为名称修饰(Name Mangling)的底层机制。
1. 名称修饰的真实目的:防范子类意外覆盖
许多刚接触 Python 的开发者容易误以为双下划线等于 Java 中的 private。事实上,双下划线的设计初衷不是为了实现严格的安全保密,而是为了在多继承或深层类继承体系中,防止子类不小心定义了同名方法而覆盖父类的核心实现。
2. 编译器重命名规则
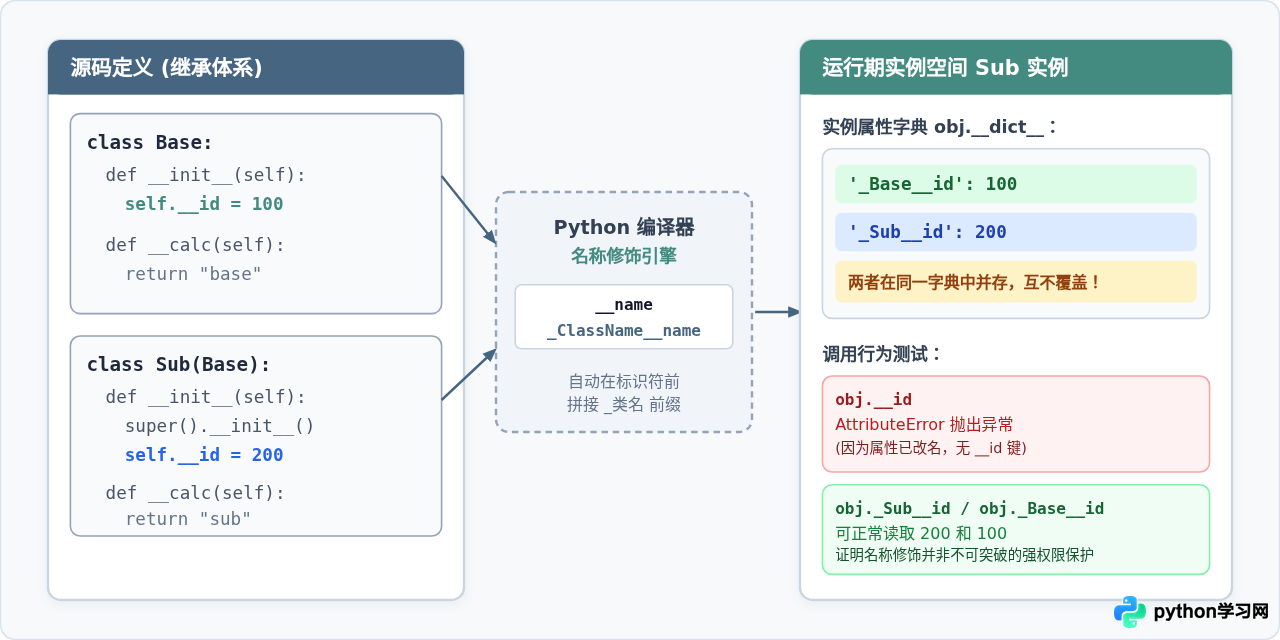
在将 Python 源码编译为字节码的过程中,凡是在类体内部定义的 __identifier,解释器都会将其自动转换并重写为 _ClassName__identifier。以下通过完整代码展示这一过程:
class BaseService:
    def __init__(self):
        self.__status = "ready"

    def __validate(self):
        return f"Base validation (status: {self.__status})"

    def execute(self):
        return self.__validate()

class CustomService(BaseService):
    def __validate(self):
        return "Custom validation"

service = CustomService()
print(service.execute())
运行结果示例:
Base validation (status: ready)可以看到,虽然子类 CustomService 也定义了一个名为 __validate 的方法,但父类的 execute() 依然成功调用了父类原本的验证逻辑。这是因为在编译阶段:
- 父类的
__validate被重命名为_BaseService__validate; - 子类的
__validate被重命名为_CustomService__validate; - 父类内部的
self.__validate()在编译时已经被重写成了self._BaseService__validate()。
两个方法在实例的属性字典中作为不同的键共存,彻底消除了继承中的命名污染。
3. 为什么名称修饰不是强私有安全机制
如果在类外部直接执行 service.__validate(),程序确实会抛出 AttributeError: 'CustomService' object has no attribute '__validate'。但这只是因为原名在属性字典中不存在。如果外部代码显式使用转换后的名称:
# 显式使用修饰后的真实属性名进行调用
print(service._BaseService__validate())
# 示例输出:Base validation (status: ready)
这意味着任何了解命名规则的代码依然可以轻易绕过修饰限制。因此,在日常代码编写中,如果仅仅需要标记“内部函数”,过度使用双下划线只会给单元测试、子类扩展和交互调试带来不必要的麻烦。
四、其他易混淆下划线命名的边界辨析
在 Python 的实际代码库中,除了前文提到的两种私有约定外,还经常能看到其他形式的下划线。理解它们的边界,有助于避免误用:
1. 首尾双下划线(__func__):Dunder / 魔术方法
例如 __init__、__str__、__len__、__call__ 等,社区通常将其读作“Dunder(Double Underscore)方法”。
- 本质特征:这是 Python 语言核心协议定义的特殊钩子,用于支持运算符重载、生命周期管理、迭代器协议等。
- 使用禁忌:永远不要发明属于自己的
__my_func__命名。Python 官方保留了未来向语言内建更多双下划线协议的权利,自定义此类命名极易与未来的 Python 标准产生冲突。
2. 单后置下划线(func_):关键字冲突避让
例如在函数参数或变量名中使用 class_、type_、id_。当某个变量或方法最恰当的名词恰好是 Python 内置保留关键字(如 class、def、in)时,PEP 8 推荐在末尾追加一个单下划线以避免语法解析错误。
3. 单独单下划线(_):临时与废弃占位符
在解包赋值或循环中,如果某个返回值不需要被后续逻辑使用,通常约定将其赋值给 _,例如 for _ in range(5): 或 name, _, email = parse_user_row(),向阅读者表明该变量可被安全忽略。
五、工程实践:下划线命名的选择依据与决策流程
在面对一个新的内部函数或方法时,应当遵循简洁、可维护的原则来决定其命名形式。绝大多数场景下,保持简单的单前导下划线是 Python 社区推崇的 Pythonic 做法。
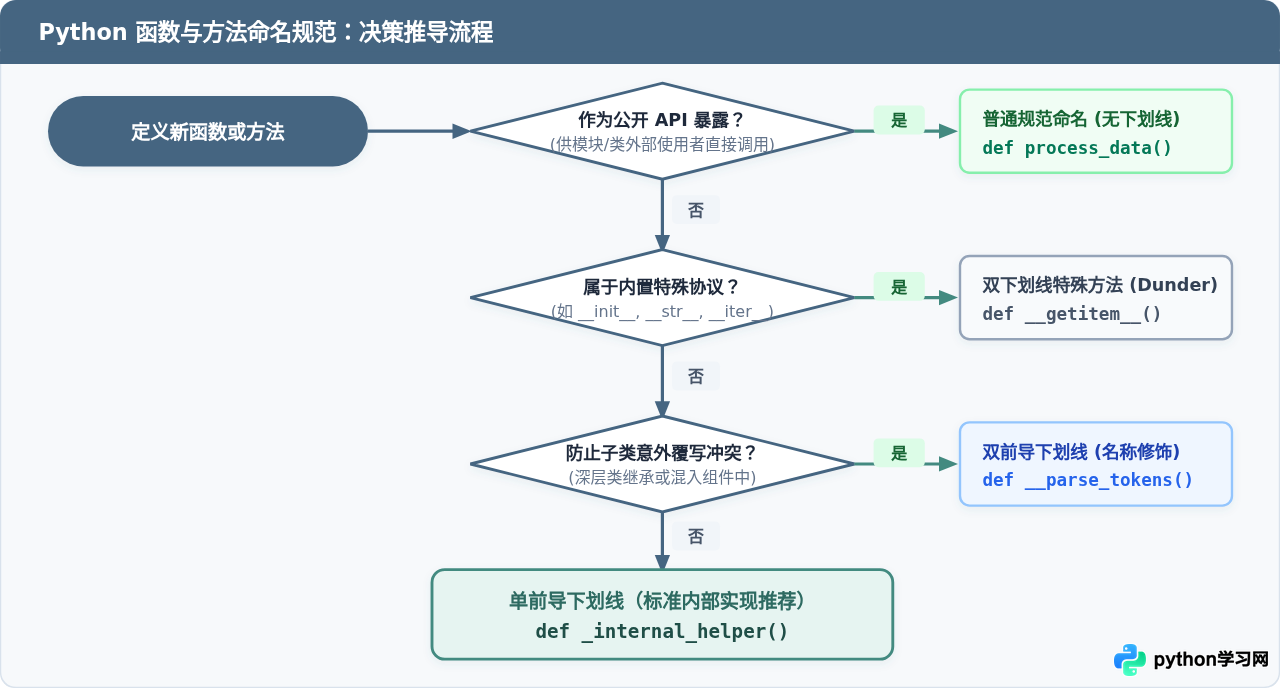
决策步骤拆解:
- 第一步(判断可见性):该函数是否属于对外承诺的公开稳定接口?若是,采用普通小写加下划线命名(如
calculate_price()),编写完整文档字符串(Docstring);若否,进入内部实现命名。 - 第二步(判断协议性):该方法是否用于实现 Python 解释器的内置协议(如对象的字符串表达、容器下标访问)?若是,使用语言保留的 Dunder 命名(如
__repr__);若否,进入私有范畴。 - 第三步(判断冲突风险):该方法是否处于多层复杂继承框架中,并且极其关键、绝不允许被不可控的派生类重名覆盖?若是,使用双前导下划线
__func启用名称修饰;若是一般的业务逻辑、数据校验或算法拆解,一律使用单前导下划线_func。
六、全景特征对比与核心总结
为了便于速查与复习,下表将 Python 中涉及函数与属性命名的各类下划线模式整理为统一的特征矩阵:
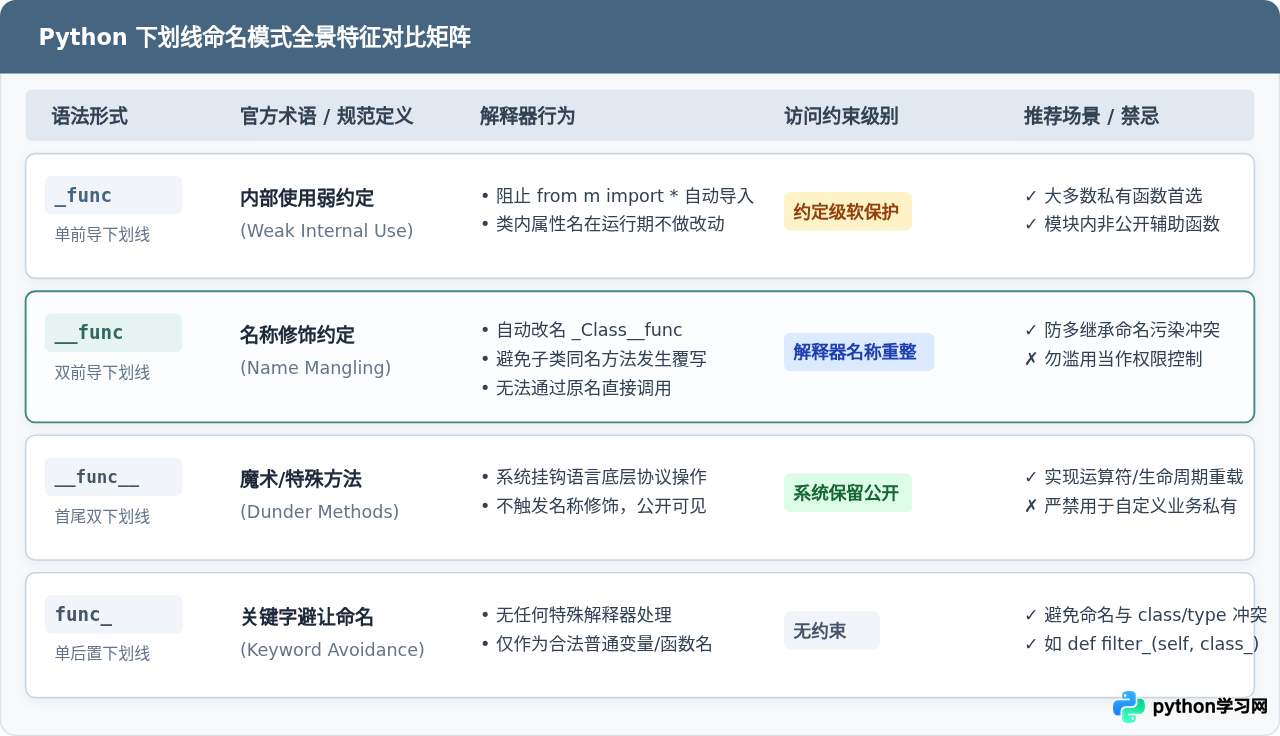
_func 是通用的内部实现标记,依靠开发者的自觉与约定维系封装边界;双前导下划线 __func 则是针对继承冲突的技术补丁(名称修饰)。编写 Python 代码时,遵从 PEP 8 规范,合理使用单下划线组织模块与类的内部逻辑,才能写出既地道又易于维护的高质量代码。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









