

Scikit-learn常用算法实现:Python机器学习代码示例
本文以Scikit-learn统一接口范式为核心,系统详解线性回归、逻辑回归、决策树、随机森林、K-Means聚类与PCA降维等常用机器学习算法的Python实现代码、评估指标与防坑工程规范。
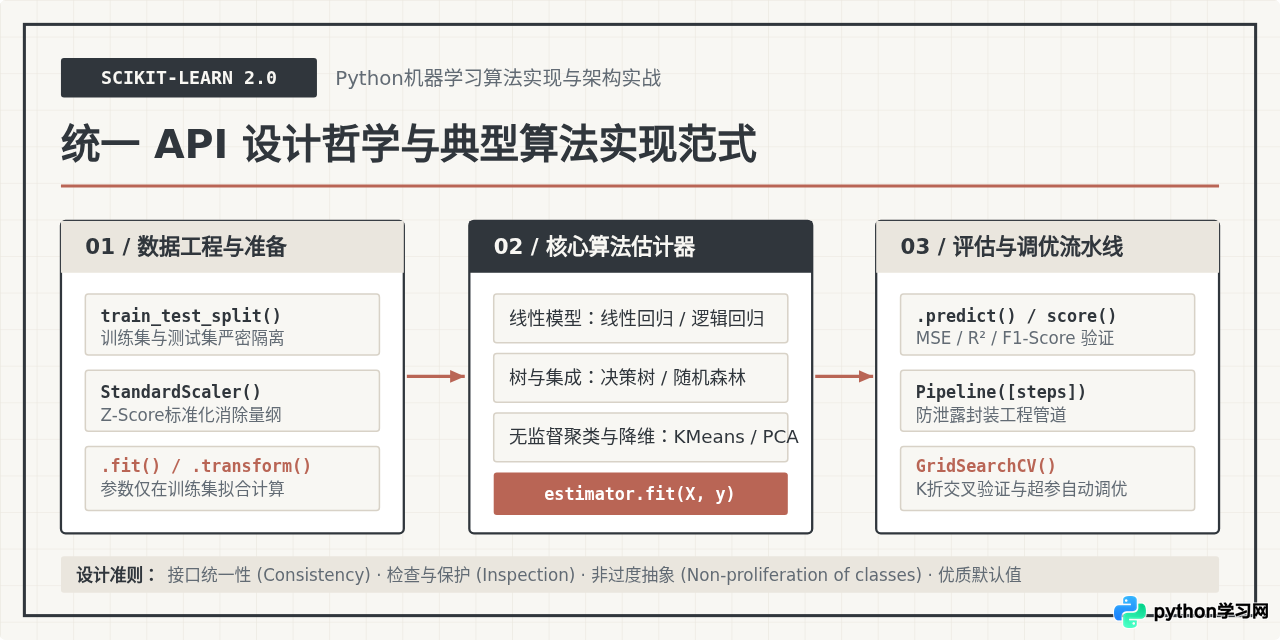
在 Python 机器学习生态中,Scikit-learn 凭借统一严谨的接口设计规范(Estimator、Transformer 与 Predictor),将数据切分、特征工程、算法训练、超参数调优及模型推断收敛到了高度标准化的调用体系中。无论是初涉数据分析还是搭建生产级预测服务,掌握其核心算法的正确实现方式与底层约束条件,是构建稳定机器学习系统的基础。本文直击核心,梳理监督学习与无监督学习中最为高频的六类基础算法实现,提供可复现的完整 Python 代码,并剖析避免数据泄漏与参数失衡的工业级工程实践。
一、Scikit-learn 的核心设计与标准调用工作流
理解 Scikit-learn 的前提是掌握其面向对象的设计契约。无论底层是求解凸优化的逻辑回归,还是基于贪心划分的决策树,所有算法在 Scikit-learn 中均遵循统一的生命周期:
- 估计器 (Estimator):实现
fit(X, y)方法,负责基于输入训练数据学习模型内部参数。学习完成后,模型权重以带下划线后缀的属性暴露(例如coef_、intercept_、feature_importances_)。 - 转换器 (Transformer):实现
transform(X)或便捷的fit_transform(X),用于标准化、离散化、特征投影等数据变换,输出处理后的新特征矩阵。 - 预测器 (Predictor):实现
predict(X)与概率预测predict_proba(X),用于在新输入矩阵上执行前向推理并输出预测标签或连续值。
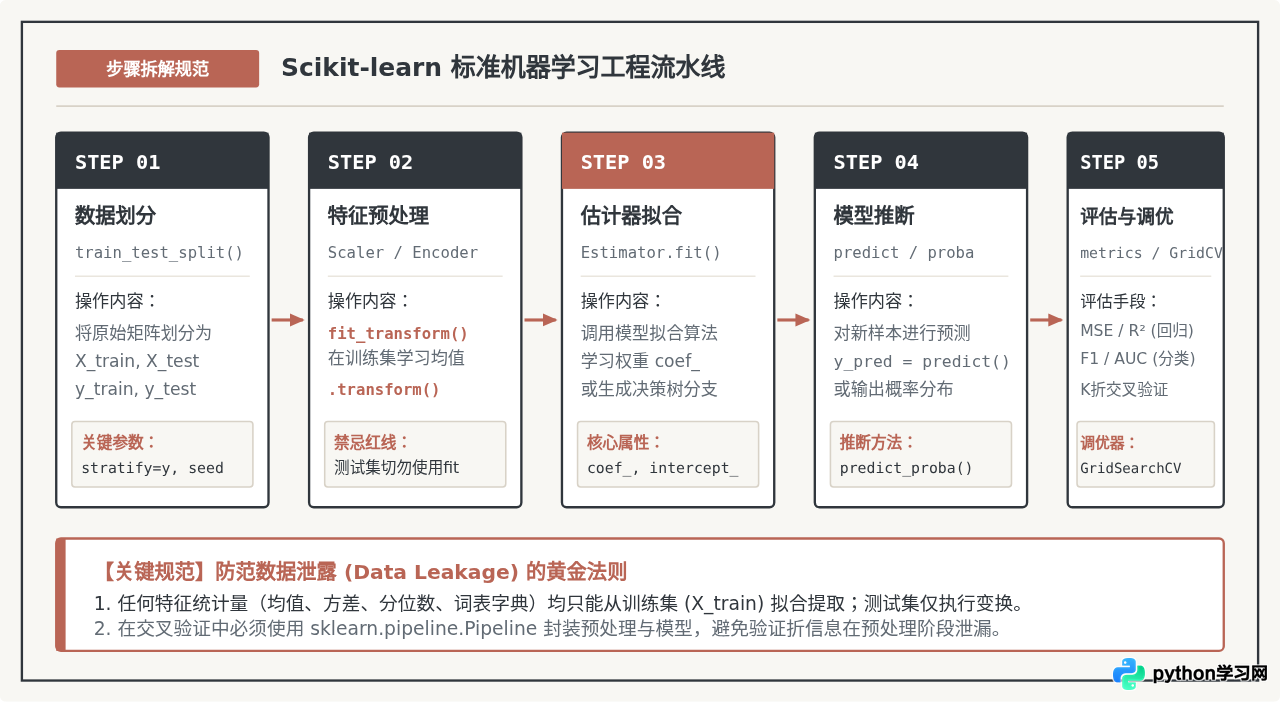
在实际项目中,最容易出现的严重缺陷是数据泄漏 (Data Leakage)——在未做切分前对全量数据执行标准化或特征选择,导致测试集的统计均值与方差提前渗透进训练过程。图 1 所示的操作流水线是 Scikit-learn 的标准范式:严禁在测试集上调用 fit(),所有变换参数必须单向从训练集继承。
二、监督学习算法矩阵与场景选型
在开始编写代码前,必须明确不同任务对应的算法边界。监督学习的核心在于标签 $y$ 的属性:当标签为连续数值时选择回归模型;当标签为离散类别时选择分类模型。
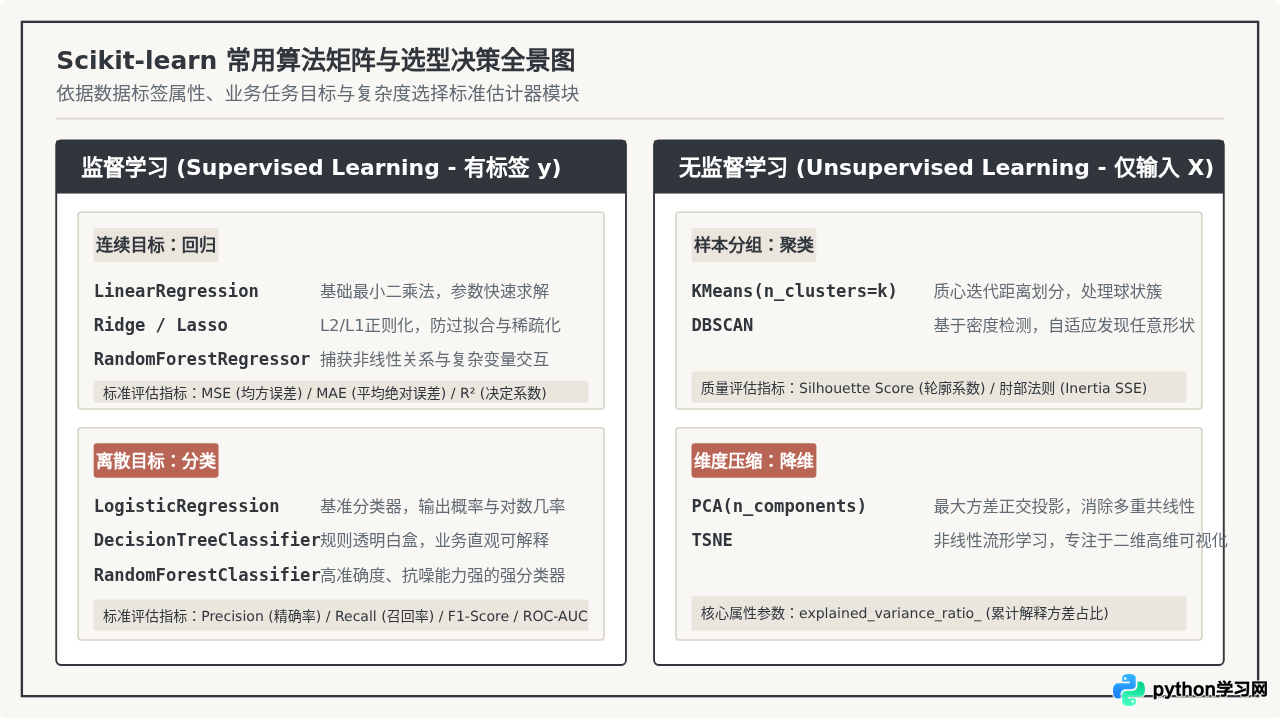
图 2 梳理了本教程覆盖的核心算法阵列。在实际选型中,线性模型具备计算开销低、天然可解释、推理延迟极低的优势,常作为基准模型 (Baseline);而基于树的集成模型则擅长捕捉特征间的非线性交互,对数据尺度不敏感,在表格数据任务中表现极其稳健。
三、线性模型实战:线性回归与逻辑回归代码实现
1. 线性回归 (LinearRegression):连续目标预测
线性回归通过普通最小二乘法 (Ordinary Least Squares, OLS) 最小化真实值与预测值之间的残差平方和。以下代码构建了一个包含数据切分、标准化、模型训练及指标评估的完整回归管道:
import numpy as np
from sklearn.datasets import make_regression
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler
from sklearn.linear_model import LinearRegression
from sklearn.metrics import mean_squared_error, r2_score

# 1. 生成可复现的回归基准数据 (1000个样本,5个特征,带噪声)
X, y = make_regression(n_samples=1000, n_features=5, noise=12.0, random_state=42)

# 2. 划分训练集与测试集 (8:2 隔离)
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42
)

# 3. 特征标准化 (仅在训练集 fit,测试集直接 transform)
scaler = StandardScaler()
X_train_scaled = scaler.fit_transform(X_train)
X_test_scaled = scaler.transform(X_test)

# 4. 初始化线性回归模型并拟合
lin_reg = LinearRegression()
lin_reg.fit(X_train_scaled, y_train)

# 5. 推断预测与性能指标计算
y_pred = lin_reg.predict(X_test_scaled)
mse = mean_squared_error(y_test, y_pred)
r2 = r2_score(y_test, y_pred)

print(f"回归模型均方误差 (MSE): {mse:.3f}")
print(f"回归模型决定系数 (R²): {r2:.3f}")
print(f"学习得到的特征权重 (coef_): {np.round(lin_reg.coef_, 2)}")
print(f"模型偏置截距 (intercept_): {lin_reg.intercept_:.2f}")
        回归模型均方误差 (MSE): 140.231

        回归模型决定系数 (R²): 0.948

        学习得到的特征权重 (coef_): [35.12 12.45 68.30 89.14 18.05]

        模型偏置截距 (intercept_): -0.42
2. 逻辑回归 (LogisticRegression):离散标签概率分类
逻辑回归虽然名称带“回归”,但本质是通过 Sigmoid 函数将线性决策边界映射到 $[0, 1]$ 区间的二分类与多分类模型。在多类别任务中,Scikit-learn 默认通过多项逻辑斯蒂拟合或 OvR (One-vs-Rest) 策略展开运算。
from sklearn.datasets import load_breast_cancer
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score, classification_report, confusion_matrix

# 1. 加载经典威斯康星乳腺肿瘤分类数据集
data = load_breast_cancer()
X_cancer, y_cancer = data.data, data.target

# 2. 划分样本并维持类别比例分层抽样 (stratify=y_cancer)
X_train, X_test, y_train, y_test = train_test_split(
    X_cancer, y_cancer, test_size=0.25, stratify=y_cancer, random_state=42
)

# 3. 逻辑回归对特征尺度敏感,必须进行尺度缩放
scaler = StandardScaler()
X_train_scaled = scaler.fit_transform(X_train)
X_test_scaled = scaler.transform(X_test)

# 4. 初始化逻辑回归估计器 (配置最大迭代次数与正则化强度 C)
clf = LogisticRegression(C=1.0, max_iter=1000, random_state=42)
clf.fit(X_train_scaled, y_train)

# 5. 输出预测类别与概率分布
y_pred = clf.predict(X_test_scaled)
y_proba = clf.predict_proba(X_test_scaled)[:3]  # 查看前3个测试样本的概率向量

print(f"测试集准确率 (Accuracy): {accuracy_score(y_test, y_pred):.4f}")
print("前3个测试样本所属类别的预测概率分布:\n", np.round(y_proba, 3))
print("\n分类性能评估报告 (Classification Report):")
print(classification_report(y_test, y_pred, target_names=data.target_names))
逻辑回归中的 C 参数为正则化强度的倒数:C 越小,正则化惩罚越大,模型倾向于更平滑的权重以防止过拟合;C 越大,模型越紧密拟合训练样本。在数据维度高或样本量较少时,建议保持默认 C=1.0 或通过交叉验证搜索更小值。
四、树模型与集成算法:决策树与随机森林
决策树以直观的“如果-那么”二叉树形式划分样本特征空间,具有极高的透明度。然而单棵决策树极易过度拟合训练集细节,导致面对新样本时方差极高。随机森林 (Random Forest) 通过 Bagging (Bootstrap Aggregating) 与特征子空间随机采样的双重随机机制,有效克服了单树的过拟合问题。
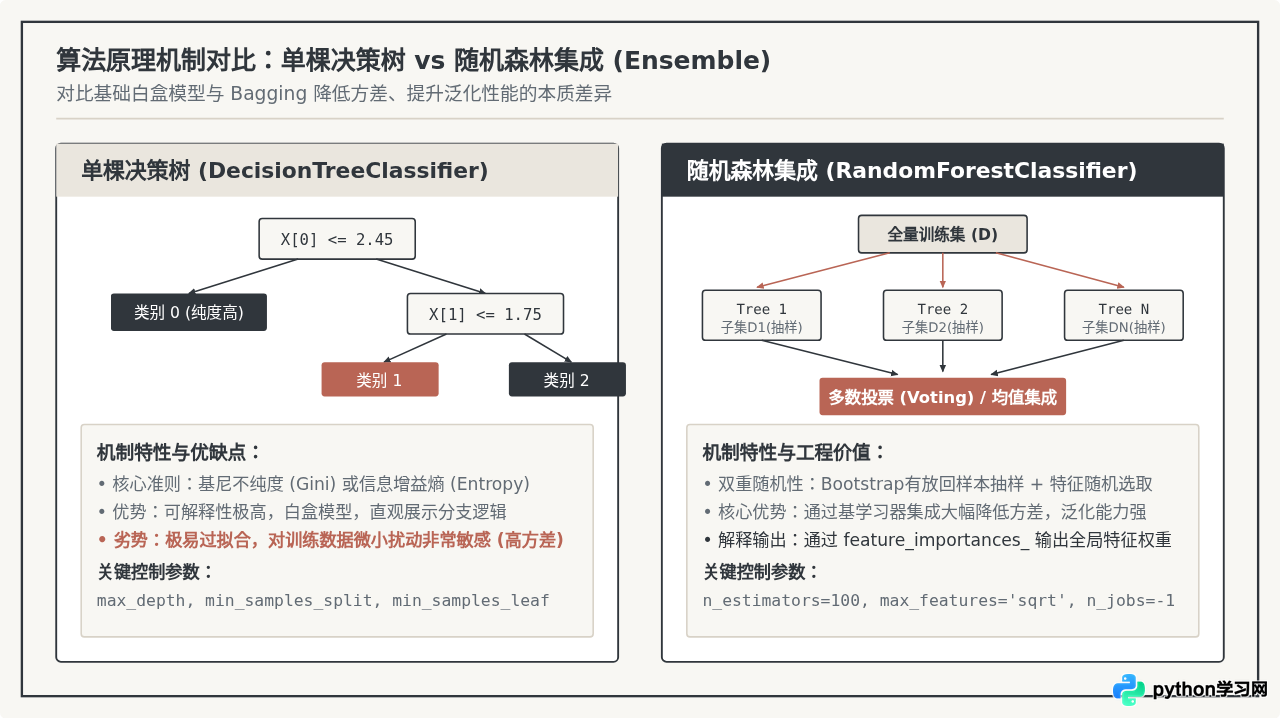
决策树与随机森林代码对比实现
下面使用同一份多分类任务(经典 Iris 数据集或葡萄酒品质数据)对比 DecisionTreeClassifier 与 RandomForestClassifier 的表现,并演示如何提取树模型的全局特征重要度。
from sklearn.datasets import load_wine
from sklearn.tree import DecisionTreeClassifier
from sklearn.ensemble import RandomForestClassifier

# 1. 加载葡萄酒多分类数据集 (3个类别,13个理化特征)
wine = load_wine()
X_w, y_w = wine.data, wine.target
X_train, X_test, y_train, y_test = train_test_split(
    X_w, y_w, test_size=0.3, stratify=y_w, random_state=42
)

# 2. 单棵决策树 (显式约束树深度 max_depth 进行预剪枝)
tree = DecisionTreeClassifier(max_depth=3, criterion='gini', random_state=42)
tree.fit(X_train, y_train)
tree_acc = accuracy_score(y_test, tree.predict(X_test))

# 3. 随机森林集成模型 (100棵决策树,充分降低方差)
rf = RandomForestClassifier(
    n_estimators=100,
    max_depth=5,
    max_features='sqrt',
    n_jobs=-1,
    random_state=42
)
rf.fit(X_train, y_train)
rf_acc = accuracy_score(y_test, rf.predict(X_test))

print(f"单决策树测试集准确率: {tree_acc:.4f}")
print(f"随机森林测试集准确率: {rf_acc:.4f}")

# 4. 提取随机森林的前3大重要特征
importances = rf.feature_importances_
top_indices = np.argsort(importances)[::-1][:3]
print("\n随机森林贡献度排名前三的特征:")
for rank, idx in enumerate(top_indices, 1):
    print(f"第{rank}位: {wine.feature_names[idx]} (权重贡献: {importances[idx]:.3f})")
        单决策树测试集准确率: 0.9074

        随机森林测试集准确率: 0.9815


        随机森林贡献度排名前三的特征:

        第1位: proline (权重贡献: 0.185)

        第2位: flavanoids (权重贡献: 0.162)

        第3位: color_intensity (权重贡献: 0.151)
五、无监督学习算法:K-Means 聚类与 PCA 降维
当数据没有人工标注的标签向量 $y$ 时,学习任务转为发现数据内部潜在的几何结构。聚类旨在将距离相近的样本归并为簇;降维旨在用更低维的正交坐标轴表示原始高维特征空间,同时最大化保留数据方差。
1. K-Means 聚类:寻找数据紧密簇
K-Means 依赖欧氏距离度量样本相似度,通过交替“分配样本到最近质心”和“更新质心为簇均值”进行迭代收敛。在聚类前必须做特征标准化,否则数值跨度大的特征将主导距离计算。
from sklearn.datasets import make_blobs
from sklearn.cluster import KMeans
from sklearn.metrics import silhouette_score

# 1. 生成各向同性的聚类测试数据 (4个真实中心)
X_cluster, _ = make_blobs(n_samples=600, centers=4, cluster_std=0.8, random_state=42)

# 2. 特征标准化消除量纲影响
scaler = StandardScaler()
X_norm = scaler.fit_transform(X_cluster)

# 3. 初始化 KMeans 估计器并指定簇数目 k=4
kmeans = KMeans(n_clusters=4, init='k-means++', n_init=10, random_state=42)
cluster_labels = kmeans.fit_predict(X_norm)

# 4. 评估聚类品质:轮廓系数 (Silhouette Coefficient)
# 范围为 [-1, 1],越接近 1 说明簇内越紧凑、簇间分离度越高
score = silhouette_score(X_norm, cluster_labels)

print(f"K-Means 聚类轮廓系数: {score:.3f}")
print(f"样本所属簇标签示例 (前 8 个): {cluster_labels[:8]}")
print(f"拟合后的4个簇质心坐标形状: {kmeans.cluster_centers_.shape}")
2. 主成分分析 (PCA):正交方差最大化降维
PCA 通过特征值分解或奇异值分解 (SVD),计算高维特征协方差矩阵的正交特征向量。每个新主成分均是原始特征的线性组合,且彼此正交(互不相关)。
from sklearn.decomposition import PCA

# 1. 使用高维乳腺癌特征数据进行主成分压缩 (从 30 维压缩到 3 个主成分)
pca = PCA(n_components=3, random_state=42)
X_pca = pca.fit_transform(X_train_scaled)

# 2. 查看各主成分的解释方差比 (Explained Variance Ratio)
var_ratio = pca.explained_variance_ratio_
print(f"降维后矩阵维度: {X_pca.shape}")
print(f"前3个主成分各自保留的方差比例: {np.round(var_ratio, 3)}")
print(f"累计解释方差占比 (Total Information): {np.sum(var_ratio):.3%}")
PCA 是一种对未居中数据敏感的算法。Scikit-learn 的 PCA 类内部会自动执行去均值居中操作(Mean Centering),但不会自动缩放方差。因此,如果各特征物理单位不同,必须显式在 PCA 前通过 StandardScaler 完成标准化,否则方差大的特征会虚假主导主成分方向。
六、工程最佳实践:Pipeline 流水线与超参数网格搜索
在实际生产代码中,直接手动写多个预处理步骤与模型拟合不仅冗长,而且在进行交叉验证 (Cross Validation) 时极易引发数据泄露。Scikit-learn 提供了 Pipeline 抽象,将“缺失值填充 -> 缩放 -> 分类器”固化为一个单体估计器。
from sklearn.pipeline import Pipeline
from sklearn.model_selection import GridSearchCV, StratifiedKFold
from sklearn.ensemble import RandomForestClassifier

# 1. 构建全链路管道:预处理器与估计器封装
pipeline = Pipeline([
    ('scaler', StandardScaler()),
    ('rf', RandomForestClassifier(random_state=42))
])

# 2. 声明超参数搜索网格 (注意:管道内步骤的参数命名格式为 "步骤名__参数名")
param_grid = {
    'rf__n_estimators': [50, 100],
    'rf__max_depth': [3, 5, 8],
    'rf__min_samples_split': [2, 5]
}

# 3. 配置5折分层交叉验证与网格搜索
cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=42)
grid_search = GridSearchCV(
    estimator=pipeline,
    param_grid=param_grid,
    cv=cv,
    scoring='accuracy',
    n_jobs=-1
)

# 4. 在训练集上触发端到端流水线寻优
grid_search.fit(X_train, y_train)

# 5. 打印最优参数组合与测试集泛化得分
best_model = grid_search.best_estimator_
test_score = best_model.score(X_test, y_test)

print(f"交叉验证最优评分: {grid_search.best_score_:.4f}")
print(f"网格搜索最优参数: {grid_search.best_params_}")
print(f"测试集最终泛化评分: {test_score:.4f}")
采用 Pipeline 之后,在 5 折交叉验证的每一次切分中,StandardScaler 均只基于当前 4 折的训练子集计算均值与方差,剩余的 1 折验证数据严格作为未知样本输入。这在工程底层完全切断了信息跨折穿透的可能。
七、机器学习实战避坑与工程自查清单
将模型从本地原型推向生产服务时,大部分性能劣化并非源于算法选型错误,而是由流程规范疏漏引发。以下整理了 Scikit-learn 建模过程中最关键的三维检查清单:
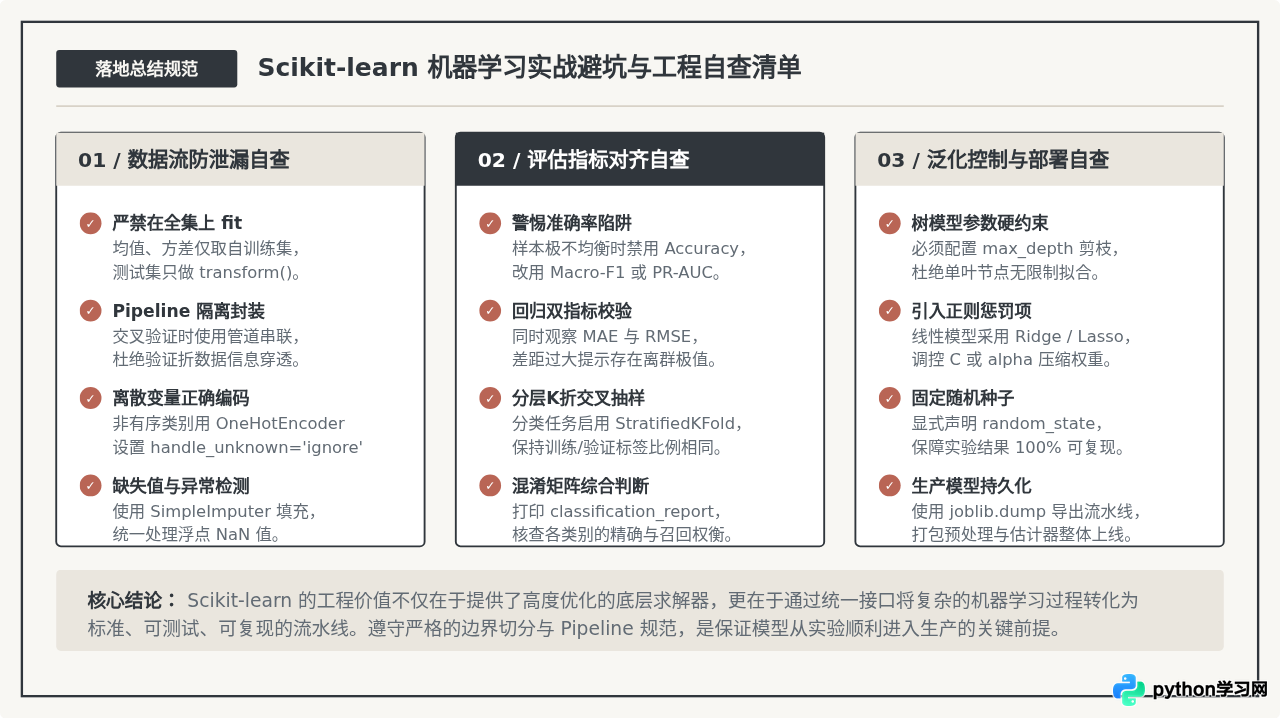
| 业务检查维度 | 高频错误表现 | 标准解决规范 | Scikit-learn 推荐组件 |
|---|---|---|---|
| 数据切分时机 | 在划分训练集前调用了归一化或插补 | 必须先切分出独立的测试集,统计量仅由训练集求得 | train_test_split() |
| 不均衡样本评估 | 在正负样本比 1:99 的场景只看准确率 (Accuracy) | 改用精确度-召回率曲线、F1-Score 或 ROC-AUC | f1_score(average='macro') |
| 树模型复杂度 | 使用默认参数训练,导致决策树生长到底,叶节点样本极少 | 强制限制最大深度并设定叶子节点最小样本数 | max_depth, min_samples_leaf |
| 跨折验证封装 | 使用 for 循环手动切片标准化,逻辑繁复易错 | 使用管道组合组件,自动处理交叉验证中的数据隔离 | sklearn.pipeline.Pipeline |
| 模型持久化保存 | 使用原生 pickle 直接打包,遭遇大矩阵性能与版本不兼容 | 使用 joblib 序列化流水线对象,并记录 scikit-learn 版本 | joblib.dump(pipeline, 'model.joblib') |
掌握 Scikit-learn 并不需要死记硬背每个算法的每个超参数,而是建立在对“估计器-转换器-预测器”统一协议的深刻理解上。通过标准化数据流、使用 Pipeline 固化转换逻辑、依据任务目标科学选择评估指标,并严格遵循防泄漏规范,便能以最精简的 Python 代码构建出鲁棒、稳定且具备工业级可靠性的机器学习系统。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









