

llama.cpp v1.0.0的FP8 KV缓存与MoE专家缓存分别有什么作用
区分llama.cpp v1.0.0的状态缓存、专家缓存和主机内存边界,同时理解新增参数与旧API移除的迁移影响。
llama.cpp v1.0.0中的FP8 KV缓存与MoE专家缓存解决两类不同的内存问题:前者压缩推理状态的存储表示,后者把专家缓存放到主机内存并管理缓存未命中时的CPU份额。二者不能互相替代,也不能仅凭模型大小推断固定显存节省或速度提升。同轮b12347、b12359、b12360为nightly构建,正式发行说明指向b12359。
KV缓存记录状态,专家缓存管理权重访问
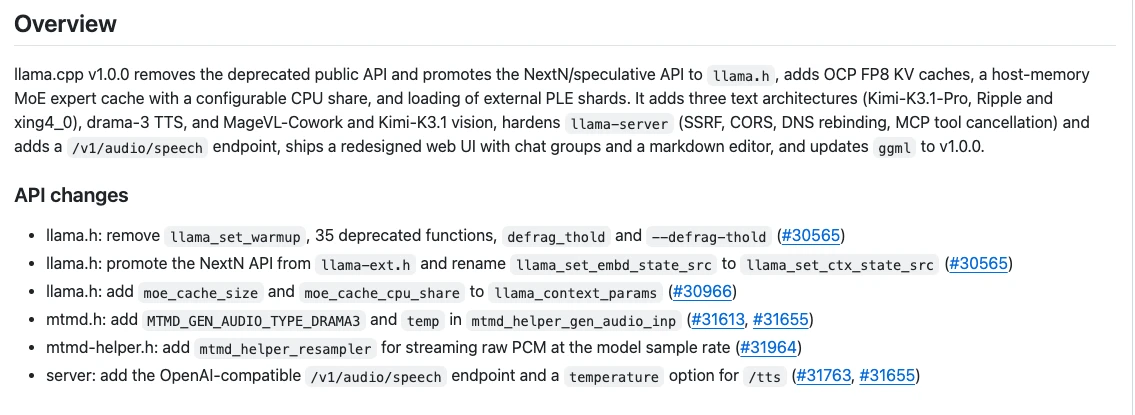
v1.0.0增加OCP FP8 KV缓存,缓存类型为f8_e4m3,并支持可选的静态逐张量缩放。KV缓存的对象是推理过程中需要保留的状态;模型权重格式、KV状态表示和专家缓存不是同一层面的设置,不能把启用其中一项写成整个模型都变成FP8。
MoE缓存面向专家访问。正式说明列出了缓存未命中时的CPU份额、LRFU/ClassLRU替换策略,以及对已缓存专家避免CPU等待等变化;llama_context_params增加moe_cache_size与moe_cache_cpu_share。这里描述的是可配置的缓存行为,不是所有MoE模型都能在相同硬件上获得一致收益的承诺。
为什么不能给出统一的内存收益数字
实际运行还涉及模型架构、上下文长度、设备后端和参数组合。发行说明增加某种缓存能力,只证明项目支持这一机制,不能由此推算每个用户能节省多少内存,或把不同缓存的收益直接相加。尤其是主机内存与设备内存属于不同资源边界,专家缓存存在于主机侧,并不意味着设备端压力会在所有工作负载下同比降低。
该版本还允许通过独立GGUF分片加载外部PLE/engram。这是加载路径的扩展,不是将任意权重文件拆分后都能互换使用的保证。权重文件、状态缓存和分片结构应分别对应模型实际要求。
内存参数变化同时涉及接口迁移
v1.0.0移除35个已弃用公共函数、llama_set_warmup、defrag_thold和--defrag-thold,并把NextN接口从llama-ext.h提升到llama.h;llama_set_embd_state_src更名为llama_set_ctx_state_src。因此,依赖旧结构字段或旧函数的应用,可能在使用新缓存能力之前就遇到接口不兼容,不能只检查命令行是否支持某个类型名称。
这一组变化有明确的删除与更名范围,不代表所有旧参数都有一一对应的替代项。NextN/speculative成为公共接口,也不等于所有模型自动启用推测解码;模型能力与调用层仍需分开理解。
本地运行与服务器访问保持独立边界
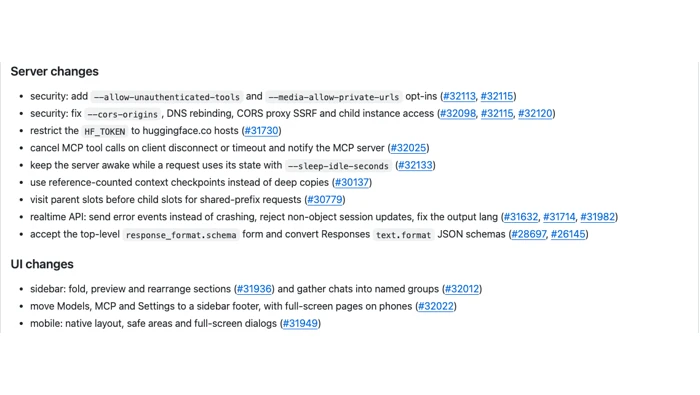
v1.0.0同时修复llama-server的SSRF、CORS与DNS重绑定等问题,并为未认证工具、私有媒体URL设置显式选择启用的开关。MCP工具在客户端断开或超时后取消并通知服务端。这些访问边界与缓存选择没有互相替代关系:一个配置能够加载模型,不说明面向网络提供服务时已经具备合适的访问约束。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









