

为什么老项目还停留在pandas1.5要谨慎升级?
深入解析老旧生产项目为何普遍停留在pandas 1.5.3,详尽对比pandas 2.0+引入的底层内存机制、静默逻辑变动、废弃API陷阱及三方依赖链断裂,并提供稳妥安全的五步升级路线与决策指南。
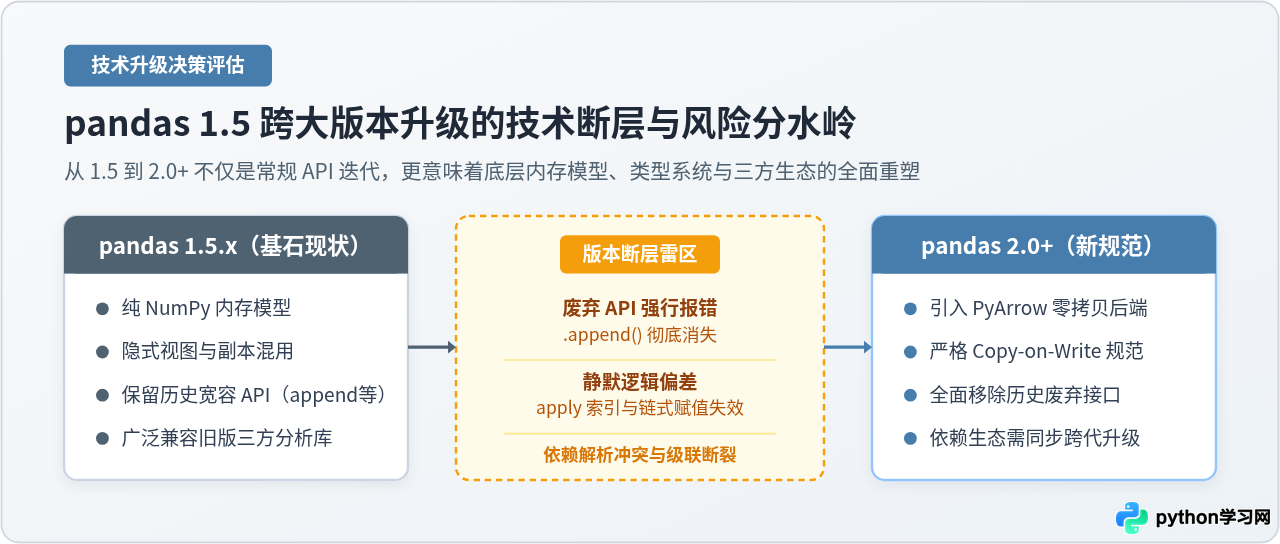
在大量工业级数据流水线、量化回测引擎以及生产后台系统中,我们常常能看到一个耐人寻味的现象:Python 解释器已经换代数次,众多周边依赖也已更新,但数据处理的核心库却依然死死锁定在 pandas==1.5.3。这并不是工程团队技术停滞或疏于维护,而是因为从 pandas 1.5 跨越到 2.0+ 属于事实上的底层范式重构。升级不仅意味着代码语法层面的兼容,更牵涉到底层内存管理模型、隐式类型推断、静默计算逻辑以及庞大下游生态链的连环震荡。未经审慎评估与全量回归测试的冒然升级,往往会把原本健壮的生产流水线拖入难以察觉的数据失真甚至系统瘫痪的深渊。
一、底层范式之变:从 NumPy 独占到 PyArrow 与 Copy-on-Write
理解老项目为何不敢轻动 pandas 1.5 的第一道关卡,在于底层内存与数据模型的质变。在 pandas 1.x 时代,pandas 基本上是构建在 NumPy 数组之上的高层封装。这种设计既造就了它的流行,也留下了诸多历史债务:内存中视图(View)与副本(Copy)的边界模糊不清、整数列无法原生表达缺失值(NaN)而被迫降级为浮点数、时间戳受限于 64 位纳秒整数范围等。
进入 pandas 2.0 后,核心架构迎来两大关键转变:全面引入 PyArrow 存储引擎 与正式推行 写入时复制(Copy-on-Write,简称 CoW) 机制。这虽然带来了显著的性能飞跃与内存节省,却彻底打破了老代码赖以运行的惯性假定。
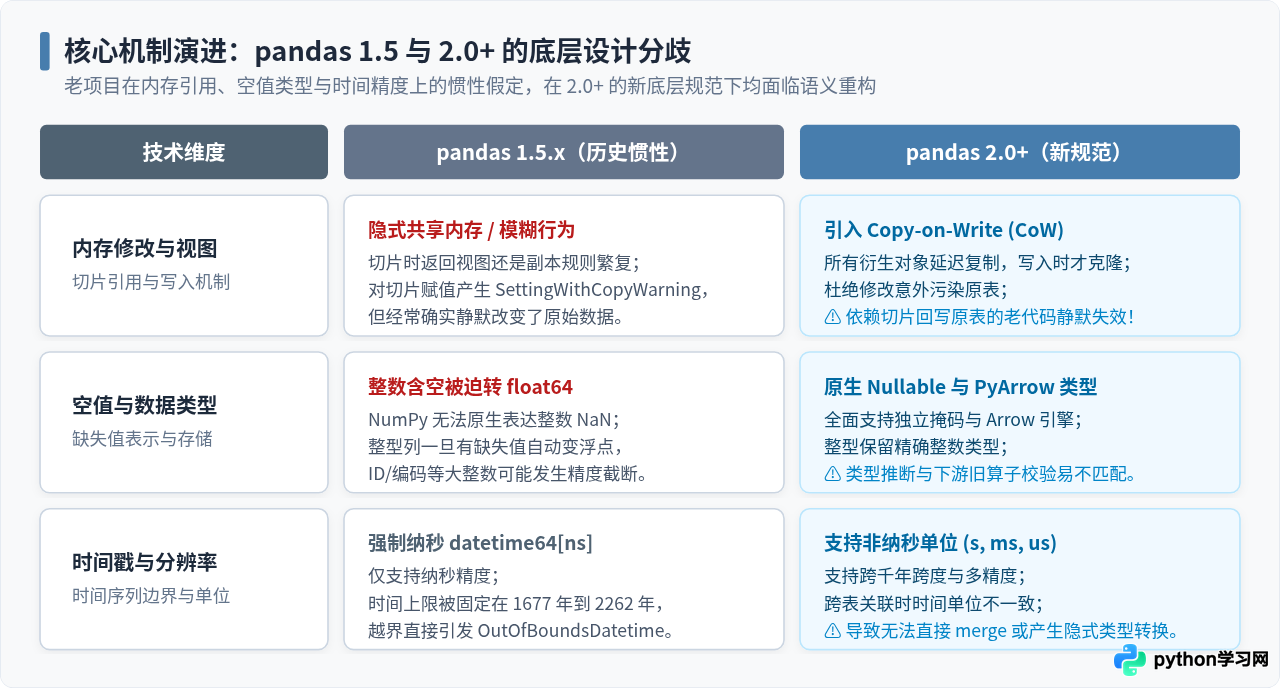
1. 写入时复制(CoW)对传统切片赋值的颠覆
在 pandas 1.5 及更早版本中,用户对 DataFrame 进行切片时,返回的对象可能是原始数据的浅层视图,也可能是深拷贝,其行为取决于底层内存块的布局。老项目中常见这类链式或切片赋值代码:
# 老项目中的典型危险写法
sub_df = df[df['status'] == 'PENDING']
sub_df['retry_count'] = 0  # 1.5 中常抛出 SettingWithCopyWarning,但原始 df 有时确实被修改了
当项目升级到 pandas 2.0+ 且逐步开启 Copy-on-Write 规范后,任何衍生切片在发生写入时都会立即与原底层 Buffer 解耦。这意味着:对切片或中间变量的赋值将绝对不再穿透影响原始 DataFrame。原本在 1.5 中由于副作用侥幸生效的业务逻辑,在 2.0+ 下会静默失去对原表的数据更新能力。程序不报错、退出码为 0,但下游写入数据库的数据却依旧是未修改的脏数据。
2. 数据类型体系的重构与精度风险
pandas 1.5 普遍依赖 NumPy 原生 dtype。例如包含空值的整型订单号,在 1.5 中会被自动提升为 float64。老项目的下游系统往往为此编写了容错逻辑,甚至习惯了这种“带小数点的数字字符”转换。而在 2.0+ 中,若项目切换至 PyArrow 后端或原生 Nullable 类型(如 Int64、string[pyarrow]),原本的类型转换假定全部失效。如果老代码中使用 np.float64、isinstance(val, float) 或依赖 C 扩展的 Cython 算子进行校验,就会立即触发类型不匹配异常。
二、升级排雷:四类最易诱发生产事故的代码陷阱
除了底层运行机制的转变,pandas 2.0 对长期积攒的历史废弃 API 进行了“硬性拔除”,并且对部分关键聚合函数的返回值索引行为作出了反转。以下四类陷阱是老旧业务升级过程中最高发的事故策源地:
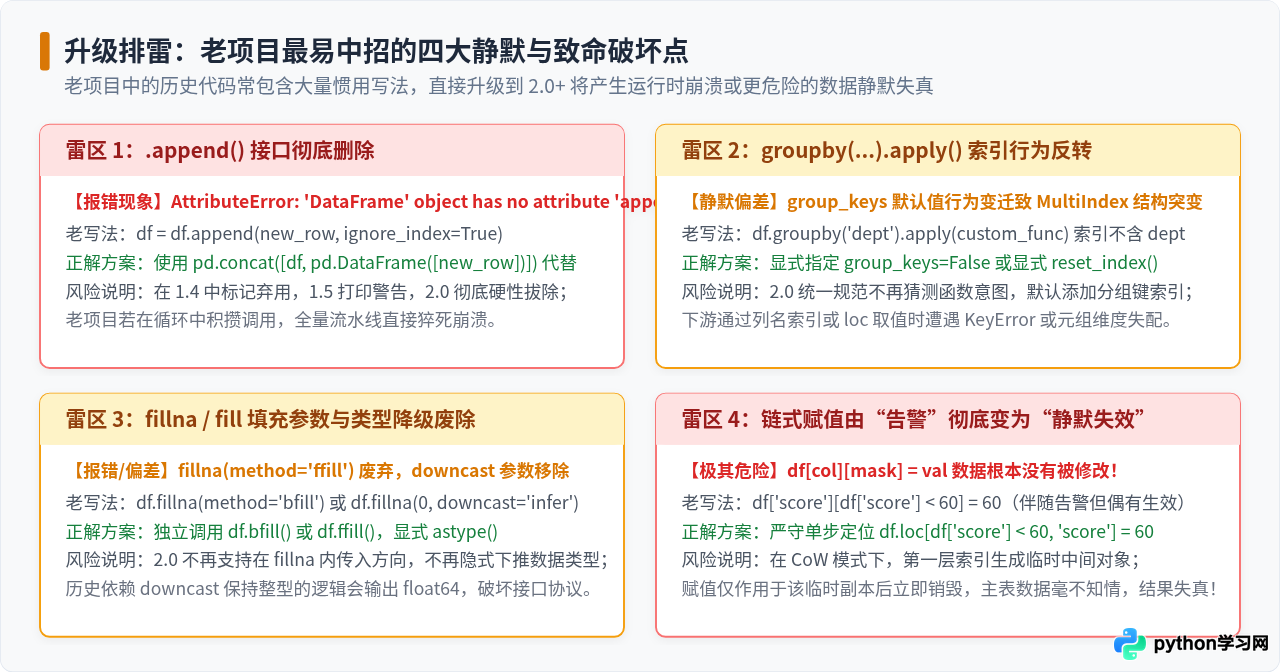
1. 彻底移除的 DataFrame.append() 与 Series.append()
在 pandas 1.4 中,官方正式标记 append() 为 Deprecated,而在 1.5 中每次调用均会输出 FutureWarning。到了 pandas 2.0,该方法被完全删除,调用直接抛出 AttributeError: 'DataFrame' object has no attribute 'append'。
老代码中如果存在如下以累加方式拼接数据的循环,在 2.0 下将立刻崩溃:
# ❌ 2.0+ 中直接抛 AttributeError 的老写法
result = pd.DataFrame()
for batch in stream_source:
    result = result.append(batch, ignore_index=True)

#  稳妥规范的替代写法:收集后单次 concat
batch_list = []
for batch in stream_source:
    batch_list.append(batch)
result = pd.concat(batch_list, ignore_index=True)append,每次拼接都触发全量内存重分配,本身就是 O(N²) 的性能黑洞。升级修改时切忌简单机械替换为单行 pd.concat 并在循环中反复赋值,必须重构为列表暂存后再统一拼接。
2. groupby(...).apply() 的 group_keys 行为反转
在 pandas 1.5 中,当在 groupby 对象上调用 apply() 时,pandas 会根据自定义函数的返回值形态“猜测”是否在结果的 Index 中包含分组键(group keys)。这一行为在 2.0 中被严格统一:group_keys 的默认值在绝大多数操作下被强制规范为 True。
# 行为反转案例
df = pd.DataFrame({'group': ['A', 'A', 'B'], 'val': [1, 2, 3]})
res = df.groupby('group').apply(lambda g: g[['val']])

# 在 pandas 1.5 下:res 的 index 可能是单层 RangeIndex 或特定复合结构
# 在 pandas 2.0 下:res 的 index 必然包含复合 MultiIndex: ('group', index)
这一改变极其危险:它不会抛出任何运行时异常,但输出 DataFrame 的索引层级从单层变为了 MultiIndex。当后续代码执行 res['val']、res.loc[0] 或依赖原有索引对账时,将因键路径变更而抛出冷门的 KeyError 或产生行列错位。
3. fillna 参数剥离与 downcast 移除
在 pandas 1.5 中,通过 df.fillna(method='ffill') 或 df.fillna(method='bfill') 实现前向/后向填充是极为普及的操作。在 2.0+ 中,method 参数被正式废弃并移除,必须显式调用独立方法 df.ffill() 或 df.bfill()。
同时,fillna、replace 等函数中的 downcast='infer' 参数也被停用。过去很多系统依赖自动 downcast 将浮点数据还原为整数,失去此特性后,数据列将长期驻留在高精度浮点类型,不仅内存占用倍增,写入 MySQL/ClickHouse 等强类型数据库时还可能触发类型校验告警。
4. 链式赋值由“黄牌告警”变为“静默丢失”
很多老项目由于缺乏静态代码检查,充斥着 df['score'][df['score'] < 60] = 60 这种链式赋值语句。在 pandas 1.5 下,终端会打印 SettingWithCopyWarning,但由于 NumPy 连续内存视图的底层特性,主表数据经常能够“走运”被直接修改成功。开发者见系统运转正常,往往直接通过 warnings.filterwarnings('ignore') 掩耳盗铃。
然而在 2.0+(尤其是开启 CoW 时),第一段索引 df['score'] 会被当作一个必须被保护的中间对象,第二段修改完全作用在一个临时生命周期的副本上,随即被垃圾回收销毁。代码执行毫无阻碍,但主表没有任何数据被更新。这是生产升级中最为隐蔽的“静默数据失真”。
三、复杂的下游生态依赖网络:牵一发动全身
很多时候,阻碍工程团队升级的不是 pandas 本身的代码,而是周围错综复杂的三方库依赖链。作为一个基础设施级工具包,pandas 与整个科学计算和工程生态存在深度的二进制与接口绑定:
| 下游工具 / 库 | pandas 1.5 兼容状态 | 升级至 pandas 2.0+ 面临的核心冲突 |
|---|---|---|
| SQLAlchemy | 稳定兼容 1.4.x 系列(使用 Engine / Raw Connection 均可) | pandas 2.0 的 read_sql 严格要求符合 DBAPI2 规范,若项目停留在 SQLAlchemy < 1.4.46 会直接抛出无法解析 Connection 的异常。 |
| Scikit-Learn | 兼容 0.24 ~ 1.1.x | 旧版 sklearn 的 Transformer 内部依赖旧版 Series 索引和 .values 属性,直接搭配 pandas 2.0 运行常在交叉验证时崩溃。 |
| PyArrow / FastParquet | 早期版本(pyarrow < 7.0) | pandas 2.0 依赖较新的 PyArrow(建议 >= 10.0.1)提供基础 C++ 接口,升级会触发 pip dependency resolver 产生包依赖死锁。 |
| Dask / Modin | 兼容 1.5 内部 BlockManager API | 分布式框架深度 hook 了 pandas 内部未公开的数据块组织接口,这些私有 API 在 2.0 中发生大幅重构,老版本分布式库直接失灵。 |
在包含成百上千个微服务或共享基础镜像的现代企业架构中,升级基础镜像的 pandas 版本往往意味着同时要升级 SQLAlchemy、numpy、scipy 以及企业内部自研的算法 SDK。如果团队无法一次性投入充分的回归排期,贸然升级将带来难以估量的级联故障。
四、生产老项目稳妥升级五步实施路线图
如果业务由于性能瓶颈、内存溢出(OOM)或必须使用 Python 3.12+ 解释器而决定启动升级,绝不能在生产环境或单机配置中直接将版本号改为 2.x。推荐采取经过工业界验证的渐进式五步迁移流水线:
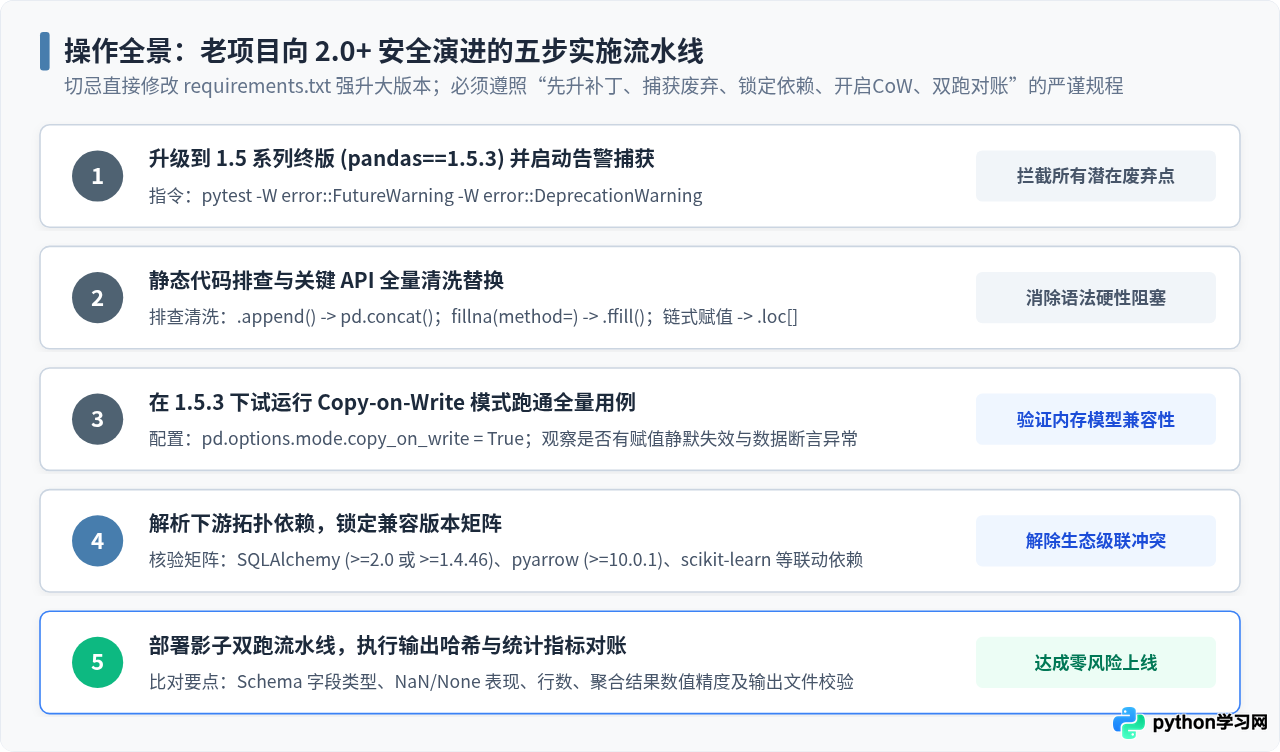
第 1 步:升级至 1.5.3 补丁终版,开启告警抛错
在开始跨越之前,必须先将当前环境平滑收敛到 1.5 系列的最后版本 pandas==1.5.3。随后在 CI 测试流程中配置警告过滤器,强制将未来废弃告警转为硬性异常:
# 启动 pytest 时将 FutureWarning 和 DeprecationWarning 提升为 Error
pytest -W error::FutureWarning -W error::DeprecationWarning tests/
通过测试套件的拦截,精准暴露所有使用了旧版行为的代码段落,确保它们在 1.5 体系内先被修复。
第 2 步:静态语法扫描与 API 全量清洗
使用代码检索工具或 AST 分析工具,针对四大高危模式进行集中清洗:
- 全面清除
.append(),换用pd.concat(); - 全面清除
fillna(method=...),换用.ffill()与.bfill(); - 搜索所有多层中括号链式赋值(如
df[a][b] = c),重写为标准的df.loc[mask, col] = val; - 明确指定
groupby.apply(..., group_keys=False),消除索引维度的潜在歧义。
第 3 步:在 1.5.3 中提前开启实验性 Copy-on-Write
鲜为人知的是,pandas 1.5.3 已经内置了 Copy-on-Write 机制的预览开关。在业务初始加载模块中加入如下配置,并运行全量业务集成测试:
import pandas as pd
# 在 1.5.3 中提前开启 CoW 模式
pd.options.mode.copy_on_write = True
如果测试用例在此配置下全部通过,说明业务逻辑在内存视图隔离机制上已经完全达到了 2.0+ 的标准。
第 4 步:解开依赖锁网,建立双版本兼容测试矩阵
审查 requirements.txt 或 poetry.lock,对 SQLAlchemy、pyarrow、scikit-learn 进行针对性解绑与升级。在 Docker 容器或本地虚拟环境中,分别配置 pandas==1.5.3 与 pandas==2.2.x 两套隔离环境,执行横向比对测试。
第 5 步:生产环境影子双跑(Shadow Pipeline)与数据对账
这是保障数据准确性的终极防线。将同一批生产流量或增量离线数据,同时输入 1.5.3 旧流水线与 2.0+ 新流水线。对两者的输出结果进行严格的字段级对账:
- 行数与主键唯一性校验:排查是否存在因索引合并反转导致的重复记录;
- Schema 字段类型比对:验证是否出现意外的
float64溢出或类型降级; - 数值差值(Delta)容差对账:浮点数比较允许设定微小容差(如 10⁻⁹),绝对不能出现 NaN 扩散或大整数失真。
五、升级评估决策矩阵:升还是不升?
软件工程从来不是一味求新,而是权衡风险与收益的艺术。老项目是否应当升级,可以参照下面的决策矩阵进行客观对照:
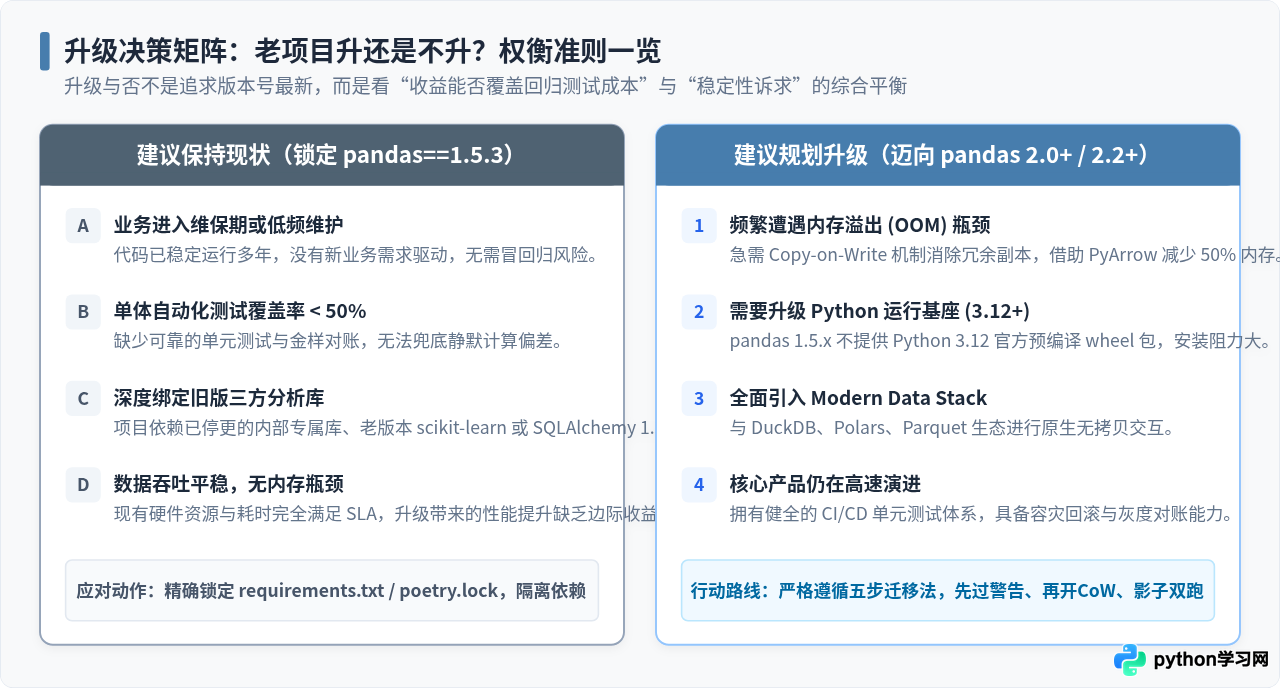
- 保持现状:低频维护的稳定报表、自动化测试覆盖率不足 50%、深度依赖旧版算法包的项目。此时锁定
pandas==1.5.3是最负责任的工程防御手段。 - 果断升级:面临严重单机内存瓶颈(急需 CoW 与 PyArrow 减负)、必须全面适配 Python 3.12+ 现代化运行基座、或正处于高速迭代期的核心系统。升级时严格遵照五步路线图平滑演进。
六、写在最后
谨慎升级,不等于永久不升;坚守 1.5,更不是因循守旧。对老项目而言,保持 pandas==1.5.3 是为了在既有资源约束下确保系统坚如磐石的可靠性。当团队决定跨越这一版本分水岭时,务必将它视作一次严肃的架构级重构,而非普通的小版本迭代。唯有看清底层机制的每一处变化,做好完备的代码审计、告警清零与影子对账,才能让数据流水线在新的时代里既跑得飞快,又行稳致远。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









