

Python怎么分块读取超大CSV文件避免内存溢出
在Python中处理几十吉字节的超大CSV文件时,直接加载极易引发MemoryError内存溢出。本文详细讲解Pandas chunksize参数与原生csv模块的流式分块读取方法,提供增量聚合与过滤落盘的完整代码实现及架构解析。
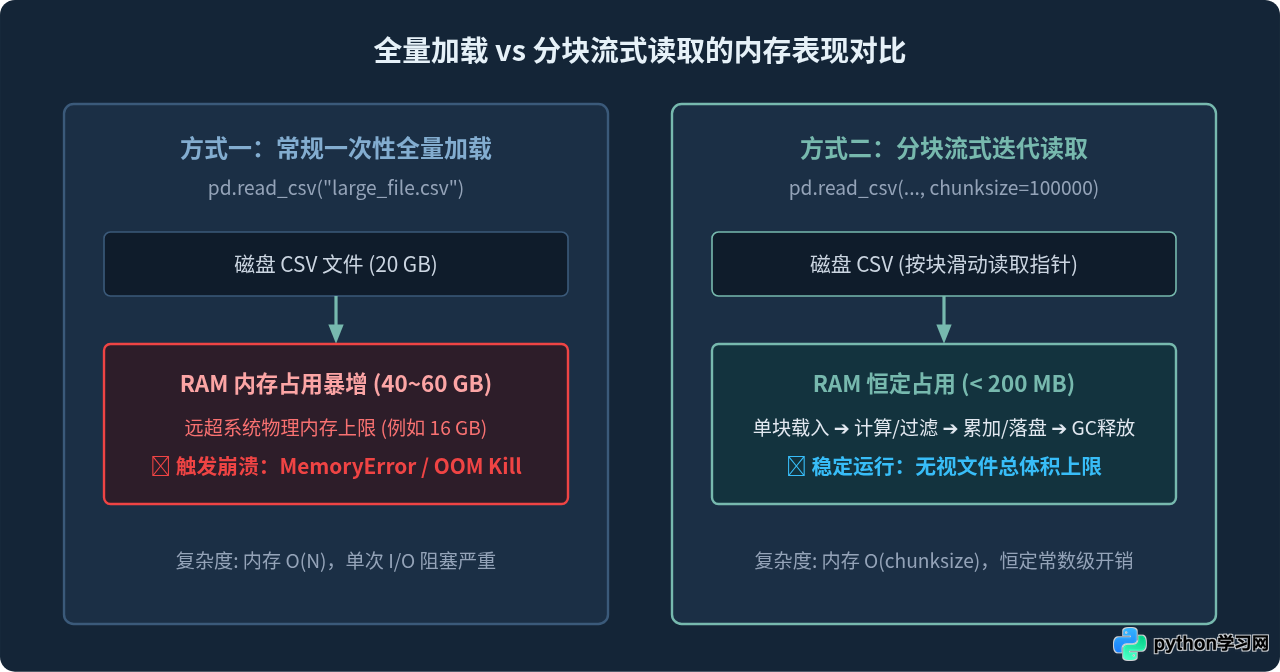
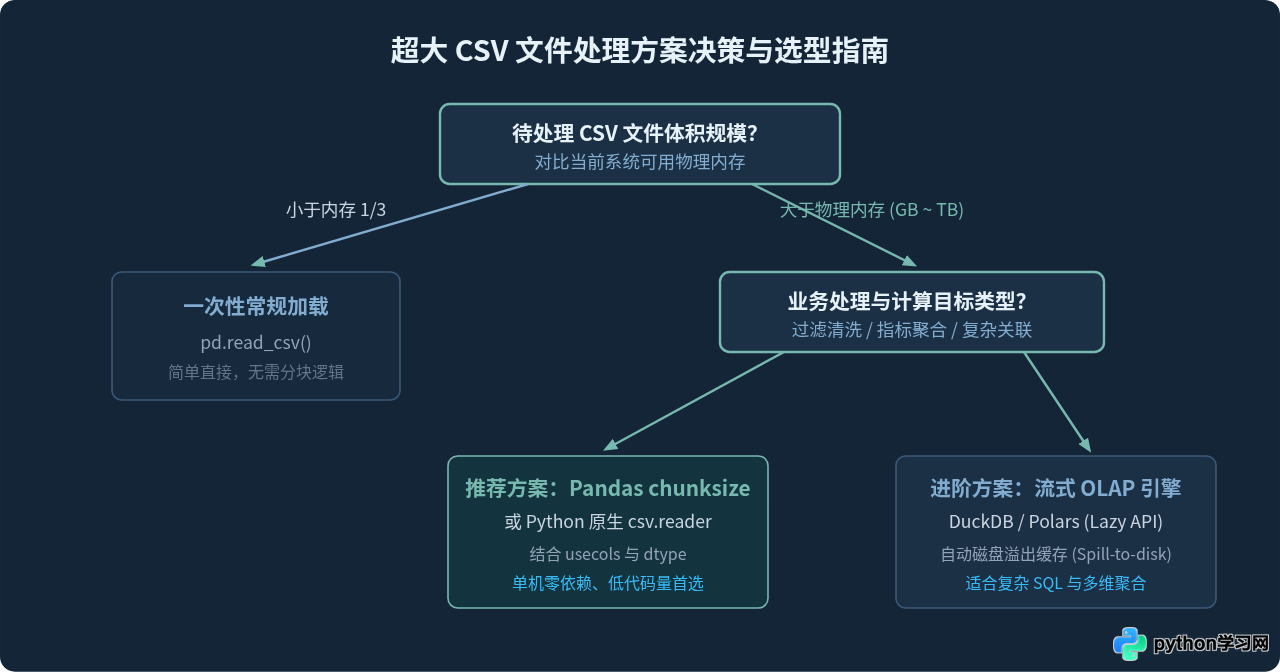
在一台可用内存仅剩 8GB 的开发机上,尝试读取一个 20GB 的服务器访问日志或历史交易记录 CSV 文件,如果直接执行 pd.read_csv('big_data.csv'),程序往往会在卡顿数十秒后直接崩溃,终端抛出醒目的 MemoryError。解决这个问题的核心思路并非盲目升级物理内存,而是利用流式批处理思想,通过分块读取(Chunking)将大文件切分为可控的数据块依次载入内存,处理并聚合后立即释放当前块的内存空间。
一、为什么直接读取大文件会导致内存溢出?
许多初学者误以为 10GB 大小的 CSV 文件载入内存后只会占用 10GB 空间,实际情况往往更加严峻。CSV 属于未压缩的纯文本文件,在被 Pandas 或 Python 内置对象解析后,文本形式的数字会被转换成 64 位整型或双精度浮点型,字符串则会被包装为 Python 字符串对象或 Pandas 的 Object/Category 类型。Python 对象自身的指针开销与元数据开销,会导致内存占用通常达到原始磁盘文件体积的 2 到 5 倍。
一次性载入的策略试图在内存中开辟一段连续空间容纳整个数据集。当申请的虚拟内存超过系统限制或物理内存耗尽时,操作系统的 OOM Killer 会强制终止进程。分块读取则颠覆了这种“全盘接收”的模式:它将数据视为流(Stream),每次只在内存中保留固定数量的记录,使得无论原始文件是 10GB 还是 1TB,内存占用始终被约束在固定上限之内。
二、核心方案一:使用 Pandas 的 chunksize 参数
在 Pandas 中,pd.read_csv() 提供了一个极其关键的参数 chunksize。只要指定了这个整数参数(代表每个分块包含的行数),该函数便不会直接返回 DataFrame,而是返回一个名为 TextFileReader 的迭代器对象。
1. 基础用法:遍历分块对象
下面的代码展示了如何按批次读取大文件,并对每个数据块进行局部检查:
import pandas as pd

file_path = "huge_server_logs.csv"
chunk_size = 100000  # 每次读取 10 万行

# 返回 TextFileReader 迭代器,不一次性载入全部数据
reader = pd.read_csv(file_path, chunksize=chunk_size)

total_rows = 0
for i, chunk in enumerate(reader):
    # chunk 为普通的 pd.DataFrame
    total_rows += len(chunk)
    print(f"成功处理第 {i+1} 个分块,当前块记录数: {len(chunk)},累计读取行数: {total_rows}")

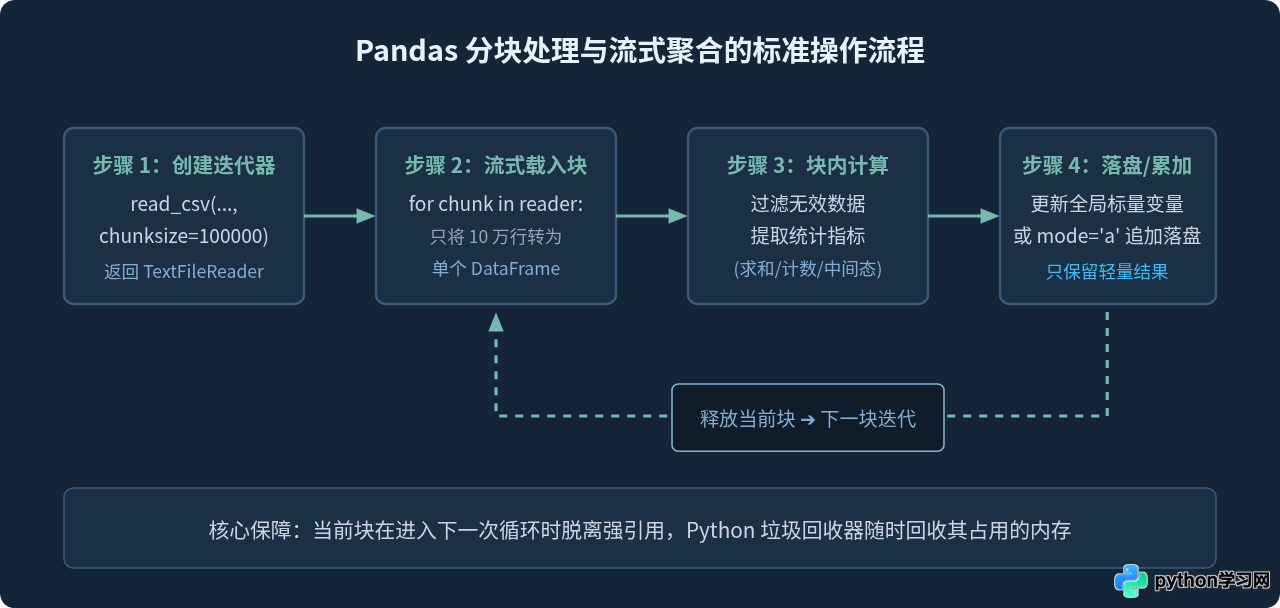
print(f"全部读取完成,总记录行数: {total_rows}")关键认知:千万不要在循环体中执行 all_data.append(chunk) 并最终调用 pd.concat(all_data)。这样做会重新将所有数据搜集进内存,分块读取避免内存溢出的初衷将彻底失效。分块的本质是“即读即处理,随手释放”。
2. 实战演练:流式计算超大 CSV 中某一列的真实平均值
求平均值是数据分析中最常见的操作之一。若直接求平均,通常需要全量求和与总行数。在分块场景下,只需在每块维护局部求和(sum)与局部数量(count),最后通过全局两数相除即可获得全局精确平均值,全程不需要堆积原始明细:
import pandas as pd

def calculate_chunked_mean(file_path, target_column, chunk_size=100000):
    """
    分块计算指定数值列的精确平均值
    """
    total_sum = 0.0
    total_count = 0

    # 结合 usecols 只加载目标列,进一步精简内存
    reader = pd.read_csv(
        file_path,
        chunksize=chunk_size,
        usecols=[target_column]
    )

    for chunk in reader:
        # 去除无效空值
        valid_series = chunk[target_column].dropna()
        total_sum += valid_series.sum()
        total_count += len(valid_series)

    if total_count == 0:
        return 0.0

    global_mean = total_sum / total_count
    return global_mean

# 执行示例
result_mean = calculate_chunked_mean("user_transactions.csv", "amount", 100000)
print(f"交易金额全局加权平均值: {result_mean:.2f}")
3. 实战演练:分块过滤并将有效数据追加写出到新文件
当任务目标是从超大文件中提取满足特定条件的记录(例如只保留状态码为 200 的日志,或金额大于 1000 的订单)时,可以利用 Pandas 的 to_csv() 追加模式(mode='a')实现流式落盘:
import os
import pandas as pd

input_file = "huge_access_log.csv"
output_file = "filtered_logs.csv"
chunk_size = 100000

# 如果输出文件已存在则预先清理,确保幂等写入
if os.path.exists(output_file):
    os.remove(output_file)

reader = pd.read_csv(input_file, chunksize=chunk_size)

for chunk in reader:
    # 步骤:块内过滤
    filtered_chunk = chunk[chunk["status_code"] == 200]

    if not filtered_chunk.empty:
        # 判断目标文件是否存在,仅在初次写入时添加表头 (header)
        write_header = not os.path.exists(output_file)
        filtered_chunk.to_csv(
            output_file,
            mode='a',
            index=False,
            header=write_header,
            encoding='utf-8'
        )

print(f"数据清洗过滤完成,提取结果已安全落盘至 {output_file}")
三、核心方案二:Python 原生 csv 模块与生成器逐行消费
在没有安装外部第三方依赖(如纯粹的标准库环境)或系统可用内存极度拮据(例如 256MB 内存的微型容器)的场景下,Python 内置的 csv 模块是更加轻量、透明的解决方案。
1. csv.reader 为什么不会内存溢出?
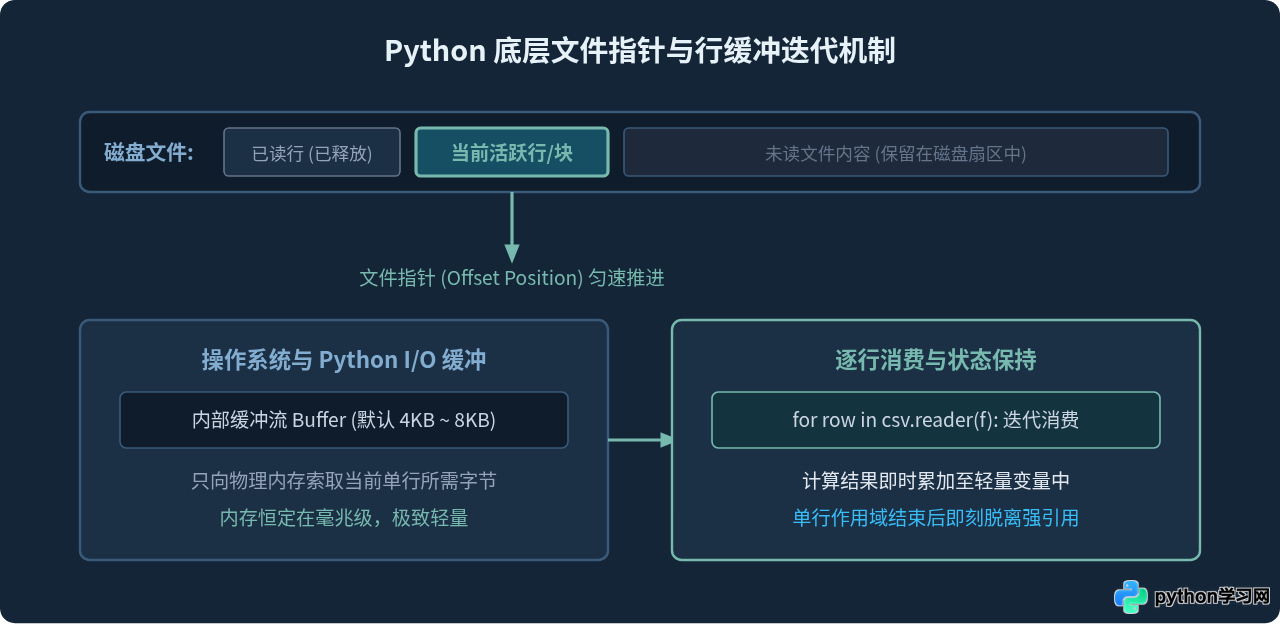
Python 标准库的 open() 函数在底层利用操作系统的行缓冲机制(Line Buffer),在 for line in file: 时仅从磁盘顺序读取一行字符至内存缓冲区中。csv.reader 或 csv.DictReader 建立在该迭代器之上,数据在被读取、解析、处理后会立即被覆写或释放,其内存占用通常维持在几兆字节的微小级别。
2. 原生代码示例:利用生成器将逐行输入组装为自定义批次
逐行读取虽然极其节省内存,但在频繁执行数据库写入或远程网络提交时,单行提交的开销较大。通过 Python 生成器函数(yield),可以非常优雅地将逐行输入聚合为指定大小的微批次(Batch):
import csv

def generate_csv_batches(file_path, batch_size=5000):
    """
    使用原生 CSV 模块的高效生成器,按指定批次抛出字典列表
    """
    with open(file_path, mode='r', encoding='utf-8', errors='replace') as f:
        reader = csv.DictReader(f)
        batch = []
        for row in reader:
            batch.append(row)
            if len(batch) >= batch_size:
                yield batch
                batch = []
        if batch:
            yield batch

# 消费自定义生成器
for batch_idx, records in enumerate(generate_csv_batches("raw_metrics.csv", batch_size=5000)):
    # 模拟批量写入或业务处理
    print(f"消费批次 {batch_idx + 1},本批包含记录条数: {len(records)}")
    # 此处无需手动释放,每次 yield 返回后,新循环会重置 batch 列表
四、进阶优化:参数调优与内存防爆细节
虽然分块读取从根本上解决了内存溢出问题,但在实际生产场景中,如果忽视了参数细节,仍可能遭遇运行极其缓慢或由于数据类型推断错误引起的隐蔽 Bug。以下是必须注意的四条最佳实践:
1. 强制声明 dtype,规避跨块类型不一致风险
Pandas 在读取每一块时,默认会根据该块前几千行的数据内容独立推断每一列的数据类型。如果某列在前 10 万行全是纯整数字符串(被推断为 int64),但在第 12 万行突然出现空值或字母(例如 "N/A"),Pandas 会在该分块触发类型警告,并将该列转换为 object。这会导致不同分块的列结构不统一,后续计算报错。显式指定 dtype 既能保证一致性,又能减少内存消耗(例如将 64 位浮点转换为 32 位):
import numpy as np
import pandas as pd

dtypes_spec = {
    "user_id": np.int32,
    "status": "category",      # 对于低基数字符串列使用 category 大幅削减内存
    "payment_amount": np.float32,
    "device_code": "string"
}

reader = pd.read_csv("transactions.csv", chunksize=100000, dtype=dtypes_spec)
2. 使用 usecols 过滤无关列,减小 I/O 开销
许多业务 CSV 包含数十列甚至上百列字段,但具体业务可能仅需要其中两列进行聚合。使用 usecols 参数可以在读取解析底层直接丢弃其余字段,不仅节省内存,还能成倍缩短 I/O 解析耗时:
# 仅载入业务核心两列
reader = pd.read_csv("massive_data.csv", chunksize=100000, usecols=["order_id", "total_price"])
3. 合理权衡 chunksize 数值
| 设定规模 | 典型取值 (行数) | 内存消耗 | I/O 与 CPU 效率 | 适用场景 |
|---|---|---|---|---|
| 极小分块 | 1,000 ~ 10,000 | 几 MB 到十几 MB | 开销较大,循环切换频繁,解释器调度耗时高 | 超微型容器环境(如 256MB 内存实例) |
| 推荐分块 | 50,000 ~ 200,000 | 50 MB ~ 300 MB | 达到最佳平衡点,充分发挥向量化计算优势 | 绝大多数常规服务器与本地开发机器 |
| 过大分块 | 1,000,000 以上 | 数 GB 到十几 GB | 单次 I/O 吞吐快,但极易接近内存临界值 | 拥有海量物理内存(64GB+)的高配服务器 |
五、总结
处理大体积 CSV 文件引发的内存溢出问题,核心在于建立“数据流”意识,避免在整个计算生命周期内维持全局数据的强引用:
- 日常首选:使用
pd.read_csv(..., chunksize=N),配合usecols和dtype,将内存占用稳定限制在几百兆字节以内。 - 极简环境:使用标准库的
open()搭配csv.reader,借助操作系统的行缓冲实现真正的 $O(1)$ 级别极低内存消耗。 - 状态收敛:牢记只在分块循环中计算或累加标量结果(如数量、加权和、极值),或者使用
mode='a'分批向磁盘文件追加写入,严禁在迭代过程中将分块 DataFrame 追加到列表中重建全局对象。
遵循上述方法,即便在配置有限的普通开发机或微型云服务器上,也能游刃有余、稳健地完成数十至数百吉字节超大 CSV 文件的处理任务。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









