

学习Python后能从事什么AI工作?算法工程师与数据分析师的Python技能需求
全面解析掌握Python后在人工智能与数据科学领域的两大核心岗位方向:算法工程师与数据分析师的技术栈差异、日常职责、技能需求对比及系统化学习路径。
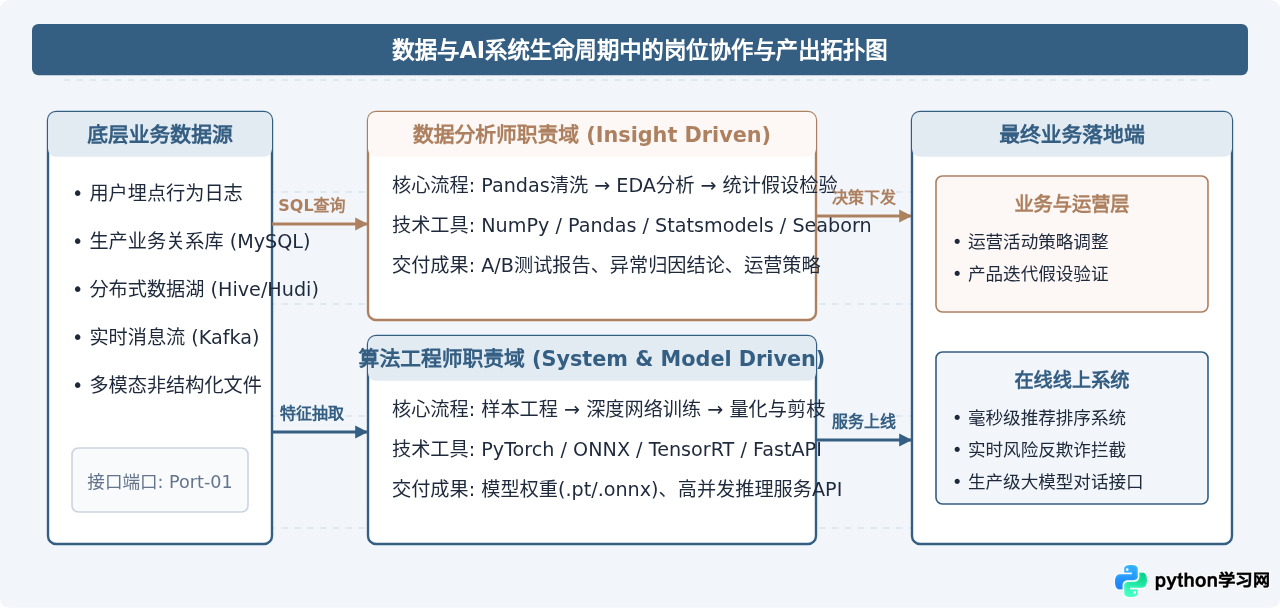
一、两大岗位的职责边界与产出物对比
很多刚学完Python基础语法的求职者常常陷入一个误区,以为只要调用fit()和predict()就算掌握了AI技术。在工业界实际生产环境中,算法工程师与数据分析师在业务链路中处于完全不同的节点,交付标准也存在本质差异:
- 算法工程师:核心任务是交付线上运行的智能服务或高泛化能力模型权重。日常工作包括离线特征构建、深层网络结构设计、损失函数调优、多GPU分布式训练、模型剪枝量化,以及利用FastAPI/C++封装高并发推理接口。系统的评价指标通常是准确率(Accuracy)、F1-score、延时(P99 Latency)与显存占用。
- 数据分析师:核心任务是交付业务决策建议、归因分析报告与指标监控体系。日常工作涵盖业务数据提取(SQL)、多源数据清洗过滤、探索性数据分析(EDA)、统计假设检验(A/B Testing)、同期群留存分析以及构建交互式看板。衡量产出的标准是业务指标提升幅度、异常归因准确性与决策支撑价值。
二、算法工程师的Python核心技术栈
对于算法工程师,Python不仅是进行算法验证的脚本工具,更是构建大型机器学习系统粘合层与核心训练框架的主控语言。工业界对算法工程师的Python工程能力要求极高,强调代码规范、并发性能与底层计算图的理解。
1. 必备的核心Python库与工具链
- 深度学习与计算框架:
PyTorch(当前学术界与工业界训练主流)、TensorFlow / Keras。要求熟练掌握自定义Dataset与DataLoader、torch.nn.Module网络搭建、反向传播梯度累加及混合精度训练(AMP)。 - 大模型与前沿生态:
Hugging Face Transformers、PEFT(低秩适配LoRA等微调工具)、Accelerate、vLLM(高吞吐LLM推理引擎)。 - 模型加速与工程部署:
ONNX / ONNX Runtime、TensorRT、FastAPI。将训练完成的复杂计算图固化为跨平台格式,并使用高性能异步框架封装为RESTful或gRPC接口。 - 科学计算基石:
NumPy、SciPy。用于张量运算、相似度距离度量(如余弦相似度、欧氏距离矩阵广播计算)。
2. 算法工程师典型代码范式:推理流水线与API封装
以下示例展示了算法工程师标准的推理类封装:采用面向对象组织代码、包含设备检测、批处理(Batching)、类型标注(Type Hints)与异常拦截机制。
# 环境要求: Python 3.9+, torch>=2.0.0, pydantic>=2.0.0
# 执行位置: 模型服务层 inference_service.py
import torch
import torch.nn as nn
from typing import List, Dict, Any

class LightweightTextClassifier(nn.Module):
    """用于文本特征嵌入分类的轻量级模型结构"""
    def __init__(self, input_dim: int = 768, num_classes: int = 3):
        super().__init__()
        self.classifier = nn.Sequential(
            nn.Linear(input_dim, 256),
            nn.ReLU(),
            nn.Dropout(0.2),
            nn.Linear(256, num_classes)
        )

    def forward(self, x: torch.Tensor) -> torch.Tensor:
        return self.classifier(x)

class ModelInferenceEngine:
    """生产级离线/在线推理引擎封装"""
    def __init__(self, model_path: str, device: str = None):
        # 1. 硬件资源自适应判定
        self.device = device or ("cuda" if torch.cuda.is_available() else "cpu")
        self.model = LightweightTextClassifier(input_dim=768, num_classes=3)

        # 2. 权重加载与状态设置 (eval模式避免BatchNorm/Dropout波动)
        state_dict = torch.load(model_path, map_location=self.device)
        self.model.load_state_dict(state_dict)
        self.model.to(self.device)
        self.model.eval()

    @torch.no_grad()
    def predict_batch(self, feature_tensors: List[List[float]]) -> List[Dict[str, Any]]:
        """批量推理计算,规避梯度跟踪开销"""
        # 转换为张量并移动到计算设备
        inputs = torch.tensor(feature_tensors, dtype=torch.float32).to(self.device)
        logits = self.model(inputs)
        probabilities = torch.softmax(logits, dim=-1)
        predictions = torch.argmax(probabilities, dim=-1)

        results = []
        for i in range(len(feature_tensors)):
            results.append({
                "class_id": int(predictions[i].item()),
                "confidence": float(probabilities[i][predictions[i]].item())
            })
        return results

# 示例验证逻辑
if __name__ == "__main__":
    import tempfile
    import os

    # 构造假权重进行代码运行完整性验证
    temp_dir = tempfile.mkdtemp()
    dummy_weight_path = os.path.join(temp_dir, "model.pt")
    dummy_model = LightweightTextClassifier()
    torch.save(dummy_model.state_dict(), dummy_weight_path)

    # 实例化引擎并执行批处理推理
    engine = ModelInferenceEngine(model_path=dummy_weight_path, device="cpu")
    dummy_inputs = [[0.05] * 768, [-0.1] * 768]
    outputs = engine.predict_batch(dummy_inputs)
    print("推理结果输出示例:", outputs)
三、数据分析师的Python核心技术栈
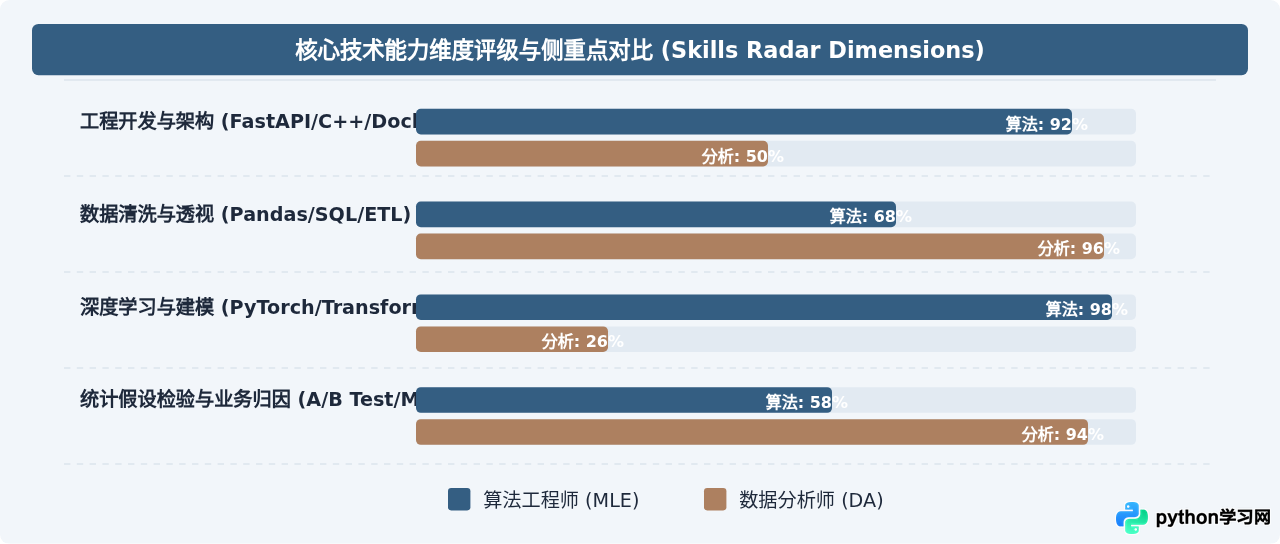
与算法工程师深挖底层网络与系统吞吐不同,数据分析师更看重Python在数据处理敏捷度、统计学可靠性与业务透视能力上的表现。分析师的核心壁垒在于将凌乱的业务事件流抽象为可衡量的量化指标体系。
1. 必备的核心Python库与工具链
- 数据清洗与变形:
Pandas。必须精通向量化计算、多级索引(MultiIndex)、窗口函数(rolling/expanding)、数据透视(pivot_table)以及大规模合并连接(merge/join)。 - 高性能数值计算:
NumPy。熟练掌握布尔切片、矢量广播、缺失值处理与分位数计算。 - 统计建模与假设检验:
Statsmodels、Scipy.stats。掌握单/双样本t检验、卡方拟合优度检验、Mann-Whitney U检验、多元线性回归分析与因果推断基础。 - 数据可视化与洞察呈现:
Matplotlib、Seaborn、Plotly。要求能够绘制规范的箱线图、热力图、小提琴图与用户留存阶梯图。 - 数据源交互:
SQLAlchemy、PyMySQL。利用Python实现自动化ETL作业与异构数据源抓取。
2. 数据分析师典型代码范式:A/B测试显著性验证与同期群留存分析
以下示例展示了数据分析师处理业务数据的典型场景:基于Pandas清洗计算用户核心转化,并使用Scipy进行双样本比例Z检验(Two-Sample Proportion Z-Test)。
# 环境要求: Python 3.8+, pandas>=1.5.0, scipy>=1.9.0
# 执行位置: 数据分析作业 script_ab_test.py
import pandas as pd
import numpy as np
from scipy import stats

def analyze_ab_test(df: pd.DataFrame, alpha: float = 0.05) -> dict:
    """
    计算A/B测试实验组与对照组的转化率差异及统计显著性
    df必须包含列: ['user_id', 'group', 'converted']
    """
    # 1. 分组聚合统计核心指标
    metrics = df.groupby('group')['converted'].agg(
        total_users='count',
        converted_users='sum',
        conversion_rate='mean'
    ).reset_index()

    ctrl = metrics[metrics['group'] == 'control'].iloc[0]
    treat = metrics[metrics['group'] == 'treatment'].iloc[0]

    n_ctrl, conv_ctrl = int(ctrl['total_users']), int(ctrl['converted_users'])
    n_treat, conv_treat = int(treat['total_users']), int(treat['converted_users'])

    # 2. 双样本比例合并Z检验 (Pooled Two-sample Z-test)
    p_pool = (conv_ctrl + conv_treat) / (n_ctrl + n_treat)
    se_pool = np.sqrt(p_pool * (1 - p_pool) * (1 / n_ctrl + 1 / n_treat))

    # 计算统计量Z与双尾p-value
    z_stat = (treat['conversion_rate'] - ctrl['conversion_rate']) / se_pool
    p_value = 2 * (1 - stats.norm.cdf(abs(z_stat)))

    # 3. 统计显著性推断结论
    is_significant = p_value < alpha
    relative_uplift = (treat['conversion_rate'] - ctrl['conversion_rate']) / ctrl['conversion_rate']

    return {
        "control_cr": round(ctrl['conversion_rate'], 4),
        "treatment_cr": round(treat['conversion_rate'], 4),
        "relative_uplift": f"{round(relative_uplift * 100, 2)}%",
        "p_value": round(float(p_value), 5),
        "is_significant": bool(is_significant),
        "recommendation": "可推全实验版本" if (is_significant and relative_uplift > 0) else "未达显著正向收益,建议回滚"
    }

# 模拟真实业务数据并运行
if __name__ == "__main__":
    np.random.seed(42)
    sample_size = 5000

    # 模拟数据生成
    data = pd.DataFrame({
        "user_id": np.arange(1, sample_size * 2 + 1),
        "group": ["control"] * sample_size + ["treatment"] * sample_size,
        "converted": np.concatenate([
            np.random.binomial(1, 0.120, sample_size),  # 对照组真实转化率 12.0%
            np.random.binomial(1, 0.138, sample_size)   # 实验组真实转化率 13.8%
        ])
    })

    report = analyze_ab_test(data)
    print("A/B测试业务量化结果:", report)
四、系统化进阶学习路径与分支决策步骤
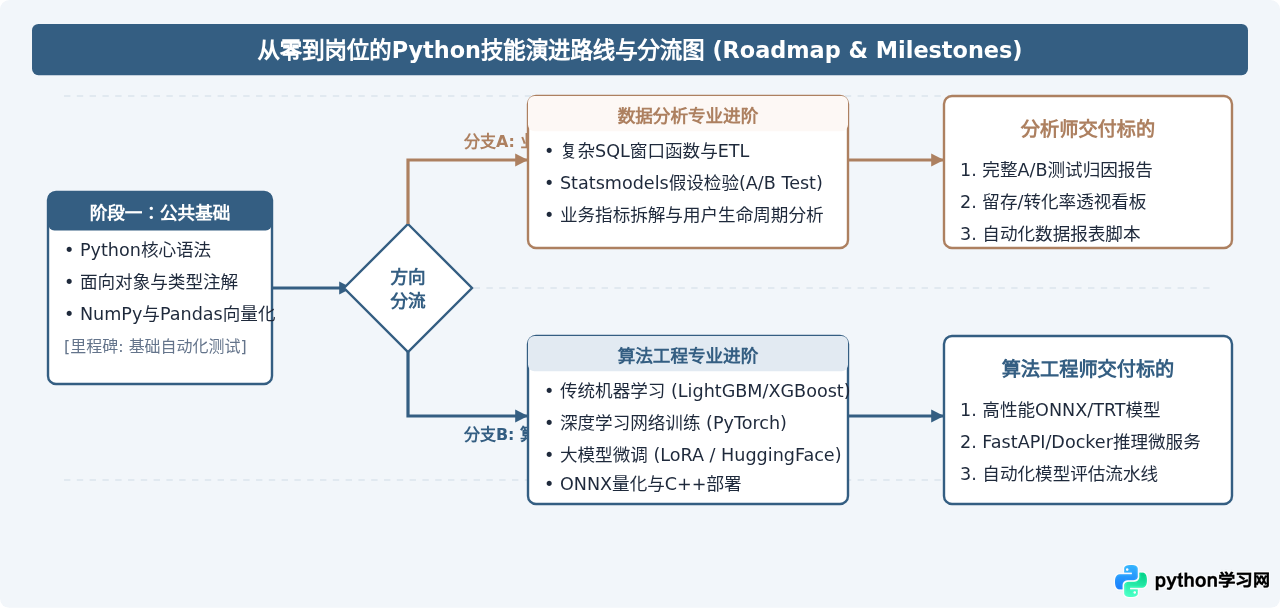
无论选择哪个方向,都不能脱离Python通用基础。合理的学习策略是“筑牢公共基底,在分水岭节点做有针对性的深度突破”。以下是经过工业界检验的四阶段落地实施步骤:
- 阶段一:Python语言核心基石(耗时约2~3周)
- 重点掌握:数据结构(List、Dict、Set底层哈希原理)、面向对象设计(继承、魔术方法)、闭包与装饰器、上下文管理器(
with)、生成器与迭代器。 - 避坑要求:彻底告别全局变量滥用,学会使用
venv或conda隔离项目依赖,养成添加PEP 484类型标注的习惯。
- 重点掌握:数据结构(List、Dict、Set底层哈希原理)、面向对象设计(继承、魔术方法)、闭包与装饰器、上下文管理器(
- 阶段二:科学计算双核心基础(耗时约3周)
- 重点掌握:
NumPy多维数组切片、多维广播机制(Broadcasting)、矩阵点积与范数;Pandas的DataFrame操作、时间序列重采样、缺失值填充与离群值处理。 - 验收标准:能够摆脱Python原生
for循环,完全使用向量化计算完成百万行级数据集的统计过滤。
- 重点掌握:
- 阶段三:方向分化决策与专精突破(耗时约6~8周)
- 选择分支A(算法方向):系统攻克微积分与线性代数 → 掌握Scikit-Learn传统算法(XGBoost/LightGBM/随机森林) → 深入PyTorch计算图机制与梯度更新 → 专攻大语言模型微调(Hugging Face生态)或CV目标检测 → 掌握ONNX导出与FastAPI部署。
- 选择分支B(分析方向):精通复杂SQL窗口函数与多表透视 → 掌握Scipy/Statsmodels统计假设检验方法论 → 构建指标字典与归因分析模型 → 结合Plotly/Tableau实现动态看板并编写业务决策报告。
- 阶段四:全链路工程落地验证(耗时约3~4周)
- 算法方向产出:包含Docker容器化编排、负载测试报告与自动化推理端点的GitHub完整工程仓库。
- 分析方向产出:基于真实业务场景(如电商流失预测、营销ROI测算)的端到端分析研报,包含可复现的数据处理代码与决策建议。
五、如何根据自身背景进行方向抉择?
选择哪条职业路线不仅取决于兴趣,更取决于个人的先验背景、知识结构与投入产出比:
| 评估维度 | 算法工程师 (Algorithm Engineer) | 数据分析师 (Data Analyst) |
|---|---|---|
| 前置数理要求 | 高。要求扎实掌握线性代数、多变量微积分、概率论与数理统计、最优化理论。 | 中等。熟练掌握应用统计学、假设检验、描述性统计分析即可上手。 |
| 代码工程要求 | 极高。需要深刻理解内存/显存分配机制、多进程并发、计算图优化与Docker容器化。 | 中等。强调代码的可读性、快速原型处理、SQL查询效率与数据处理脚本健壮度。 |
| 业务敏感度 | 中。主要基于既定业务目标进行特征抽象和指标调优。 | 极高。必须深入理解业务商业模式、漏斗模型、用户增长飞轮与行业KPI定义。 |
| 适合的专业背景 | 计算机科学、自动化、软件工程、应用数学、计算物理等工科专业。 | 经济学、统计学、金融学、信息管理、电子商务及理工科跨界转型者。 |
- 警惕“伪算法”陷阱:如果日常工作只是调用现成封装好的库、调整超参数而完全不理解模型损失函数原理与底层特征分布,在就业市场上会面临非常严峻的竞争。算法工程师的竞争力很大程度上建立在对底层数学推导和软硬件协同优化的理解上。
- 警惕“取数机器”陷阱:数据分析师的核心价值在于通过数据挖掘出业务决策点(Insights),而非机械地完成SQL跑数。如果只学习Python语法而不去深究产品指标和业务逻辑,很难进阶为高级商业分析专家。
六、全景总结与技能需求速查
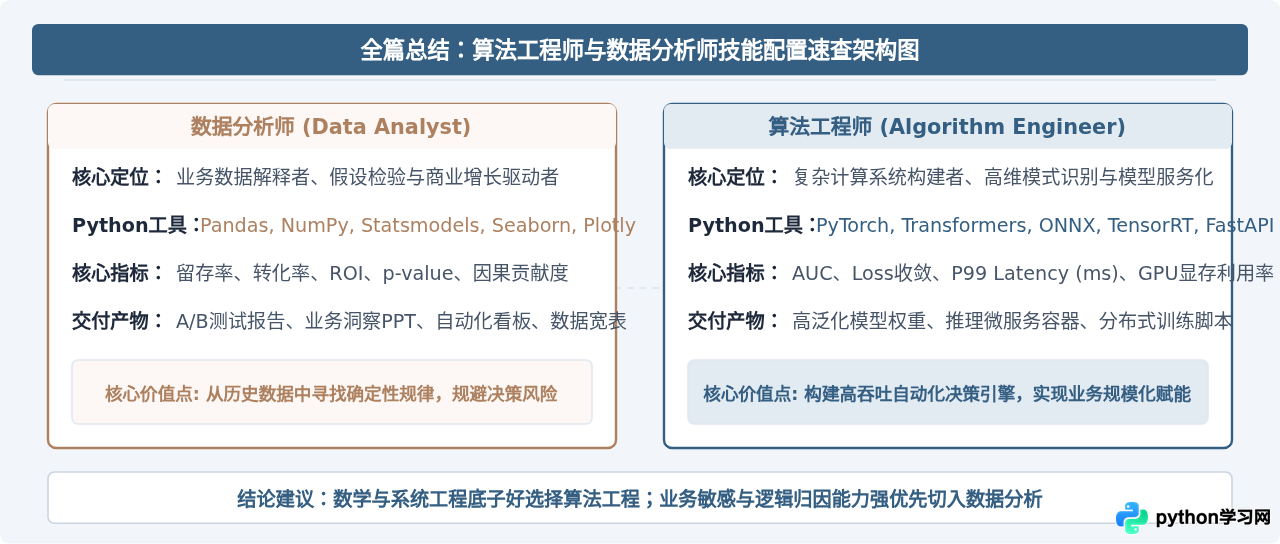
Python为初学者提供了极其平滑的学习曲线,但在迈向职业化阶段后,必须根据目标岗位构建具有深度的技术栈。下方的总结全景图清晰列出了两大岗位在工具层、核心思维与交付标准上的对照体系:
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









