

Python自带装饰器使用注意事项与常见陷阱
深入解析Python标准库与内置装饰器的核心用法、堆叠执行顺序、内存泄漏风险、元数据丢失与常见陷阱,提供针对性的防御代码与避坑指南。
Python 标准库和内置模块提供了丰富的装饰器工具,如内置的 @property、@classmethod、@staticmethod,以及来自 functools 与 dataclasses 的 @wraps、@lru_cache、@dataclass 等。这些工具开箱即用,极大地简化了类定义、状态管理和性能缓存。然而,由于装饰器在函数定义期即完成求值,且涉及描述符协议、闭包强引用和类层次构建,若对其底层机制理解不深,极易引发难以排查的内存滞留、元数据丢失和继承覆盖等隐藏缺陷。本文系统梳理 Python 自带核心装饰器的执行机理、典型缺陷场景与可靠的防御方案。
一、装饰器堆叠顺序与定义期执行机制
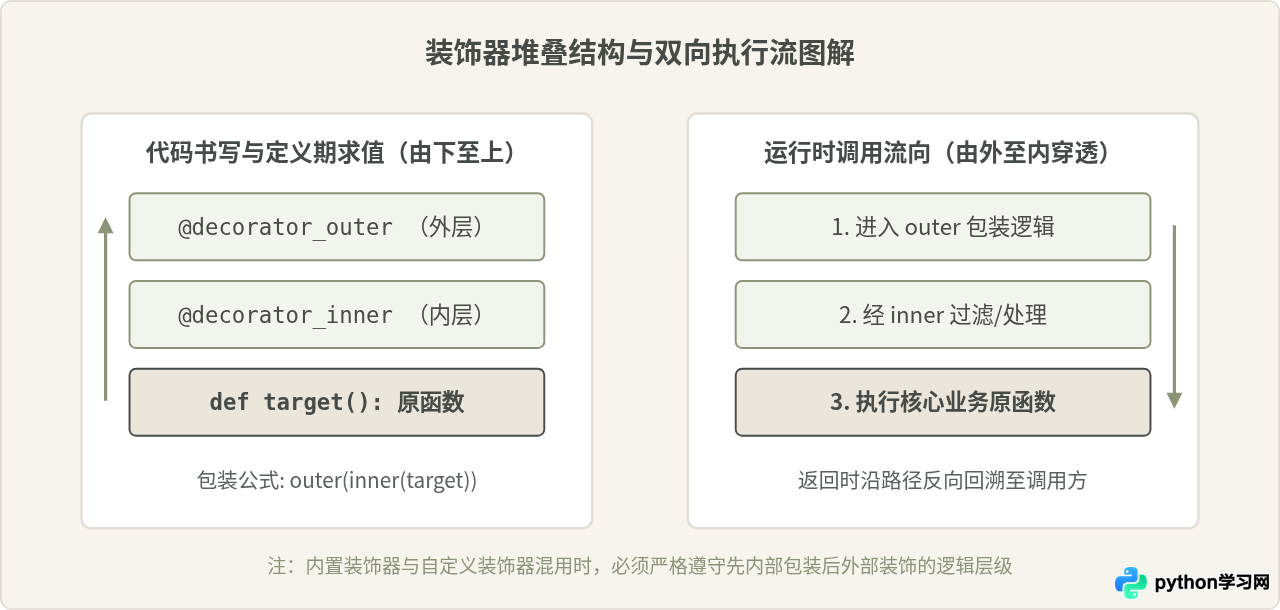
在 Python 中,装饰器本质上是高阶函数的语法糖。多个装饰器堆叠在同一个函数上方时,它们的求值过程并非从上至下,而是在模块加载或类构建的定义期,由内向外(从下到上)依次嵌套包装;而在函数被实际调用时,执行流则是自外向内逐层穿透。
# 语法书写形式
@decorator_a
@decorator_b
def target_func():
    pass

# 等价求值过程(在代码定义阶段执行)
target_func = decorator_a(decorator_b(target_func))
这种顺序直接决定了装饰器之间的协同行为。例如,当同时使用参数校验装饰器和缓存装饰器时,若将校验装饰器置于外层,缓存命中时校验层仍然每次执行;若将缓存装饰器置于最外层,则命中缓存后直接返回结果,跳过内层校验。若顺序颠倒或混淆了包装层次,将直接导致逻辑断层。
二、functools.wraps:缺失元数据引发的反射陷阱
当编写用于增强函数的装饰器时,最常见的疏忽是没有使用标准库提供的 @functools.wraps。在未加 @wraps 的情况下,被装饰函数的 __name__、__doc__、__annotations__ 以及 __module__ 会被包装函数(如 wrapper)覆盖。
在纯算法脚本中,这种覆盖可能仅影响调试日志中的函数名;但在现代 Python 框架中,依赖类型注解与签名的组件(例如 FastAPI 路由参数解析、Click 命令行参数提取、Sphinx 文档生成、Sphinx/pytest 测试用例收集)均通过 inspect.signature 反射函数。一旦元信息变成通用的 (*args, **kwargs),反射机制将全盘失效。
import functools
import inspect

def bad_decorator(func):
    def wrapper(*args, **kwargs):
        return func(*args, **kwargs)
    return wrapper

def good_decorator(func):
    @functools.wraps(func)
    def wrapper(*args, **kwargs):
        return func(*args, **kwargs)
    return wrapper

@bad_decorator
def query_user(user_id: int) -> dict:
    """查询指定用户档案"""
    return {"id": user_id}

# 陷阱表现:原始属性丢失,反射只能读取到 wrapper
print(query_user.__name__)  # 输出: wrapper
print(query_user.__doc__)   # 输出: None
print(inspect.signature(query_user)) # 输出: (*args, **kwargs)避坑指南:任何自定义装饰器的内部闭包,首行务必添加 @functools.wraps(func)。它不仅拷贝基础属性,还会挂载 __wrapped__ 属性,方便单元测试时直接访问未包装的底层原函数。
三、functools.lru_cache 与 cache:对象滞留与可变对象篡改
@functools.lru_cache(以及 Python 3.9+ 引入的 @functools.cache)提供了极其高效的结果记忆功能。但将它们应用于类实例方法时,隐藏着两个极易导致生产事故的陷阱。
1. 实例强引用导致的内存泄漏
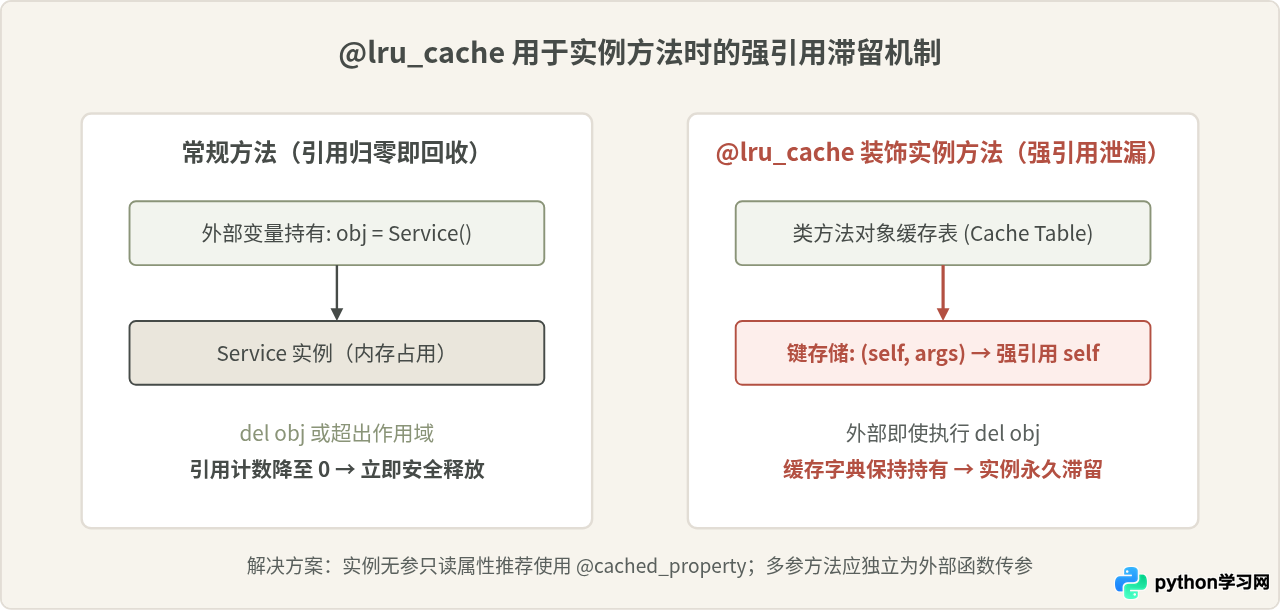
当 @lru_cache 装饰实例方法时,被缓存函数接收的第一个参数正是 self。缓存字典内部以函数参数作为键(即 (self, *args)),从而持有了 self 的强引用。只要缓存未被手动清空或淘汰,该实例以及它挂载的所有属性、缓冲区和连接对象都永远无法被垃圾回收器释放。
2. 不可哈希参数与可变对象污染
lru_cache 依赖字典记录传参,因此被调用的实参必须全部可哈希(Hashable)。若传入列表、字典或集合,将直接抛出 TypeError: unhashable type: 'list'。更严重的问题在于返回值如果是列表等可变对象,外部调用者的修改会直接污染缓存池:
from functools import lru_cache

@lru_cache(maxsize=128)
def get_default_tags():
    # 错误实践:返回可变数据结构
    return ["python", "backend"]

tags = get_default_tags()
tags.append("dangerous_mutation")

# 再次读取时,缓存池数据已被外部篡改
print(get_default_tags()) # 输出: ['python', 'backend', 'dangerous_mutation']避坑指南:被缓存函数的返回值必须设计为不可变数据(例如 tuple、frozenset 或只读数据类),若必须返回列表,可在调用端执行浅拷贝,或在函数中返回不可变类型后再由外部转换。
四、内置描述符类:@property、@classmethod 与 @staticmethod
Python 内置的 @property、@classmethod 和 @staticmethod 均基于描述符协议实现。在使用这些修饰器时,存在以下几处典型陷阱:
1. @property 隐蔽性能损耗与 setter 遮蔽
@property 将方法伪装为普通属性访问。这虽然提升了 API 语义的优雅度,但也容易让调用方误以为属性读取是 $O(1)$ 的廉价操作。若在 property 内部执行磁盘读写、复杂 SQL 或网络请求,会导致原本轻量的点号访问(如 obj.status)引发卡顿或线程阻塞。
此外,定义 setter 和 deleter 时,被修饰方法必须与原 property 保持完全相同的名称,否则会发生同名属性丢失或产生难以追踪的 AttributeError:
class Account:
    def __init__(self, balance: float):
        self._balance = balance

    @property
    def balance(self) -> float:
        return self._balance

    # 错误写法:如果方法名不叫 balance,会导致 setter 无法挂载到同一描述符
    # @balance.setter
    # def set_balance(self, value): ...

    # 正确写法:方法名必须与 property 名一致
    @balance.setter
    def balance(self, value: float) -> None:
        if value < 0:
            raise ValueError("余额不能为负数")
        self._balance = value
2. @classmethod 与 @staticmethod 的继承派发与版本混用陷阱
在继承体系中,若需要使用子类的重写逻辑,必须使用 @classmethod(传入动态绑定的 cls),而不是 @staticmethod。@staticmethod 剥离了类上下文,无法实现工厂方法的多态分发。
值得特别警惕的是跨版本兼容性:Python 3.9 曾一度允许 @classmethod 与 @property 堆叠使用以实现类级属性,但这破坏了描述符链条并引发大量边缘错误,因此在 Python 3.11 及更新版本中已被正式废弃并抛出运行时警告。要实现跨版本的类属性,应当在元类(metaclass)中定义 property,而非随意嵌套自带装饰器。
五、dataclasses.dataclass 的默认值与继承顺序陷阱
@dataclass 极大地精简了实体类的样板代码,但在字段默认值设定与类继承上存在严格的语法约束:
- 可变默认值陷阱:绝对不能将
[]或{}直接赋值给 dataclass 字段。Python 会在定义时创建该对象,导致所有实例共享同一份引用。必须使用field(default_factory=list)。 - 继承参数顺序陷阱:若父类中定义了带默认值的字段,子类若新声明了无默认值的字段,
@dataclass在自动合成__init__时,会产生“非默认参数紧随默认参数之后”的语法错误。
from dataclasses import dataclass, field

# 错误示范:所有实例将共享同一个 items 列表
# @dataclass
# class Basket:
#     items: list = []

# 正确规范:使用 default_factory 工厂函数
@dataclass
class Basket:
    owner: str
    items: list = field(default_factory=list)
六、自带装饰器选型与安全检查流程
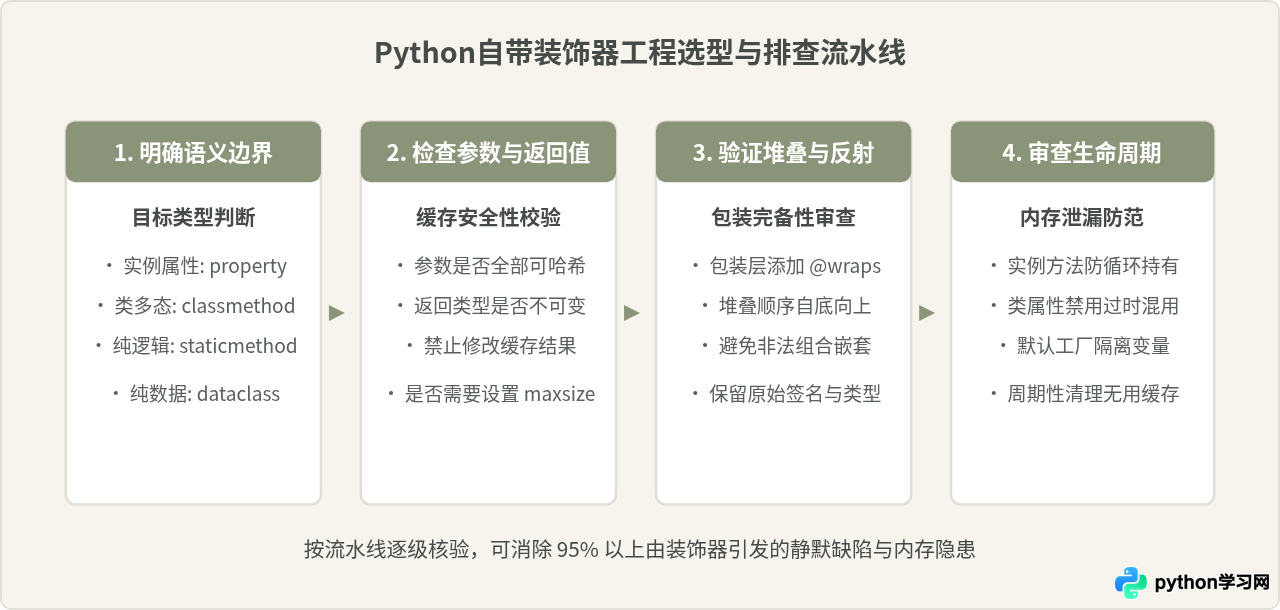
在实际工程开发中,应按照以下四个步骤对所使用的自带装饰器进行防御性排查,确保代码在生命周期、调用栈和并发环境下安全稳健:
七、常见认知误区与辨析
在日常讨论与初学者代码中,常常存在一些关于装饰器的直觉性错误认知,有必要针对性地加以厘清:
- 误区一:“装饰器是在函数被调用时才执行的”:这是最常见的误解。装饰器本身的外层执行逻辑是在模块导入或函数定义完成的瞬间执行的,只有装饰器内部返回的闭包包装函数才会在每一次实际调用时执行。如果把耗时的初始化操作直接写在装饰器外层函数体中,会导致模块导入时间显著变长。
- 误区二:“@lru_cache 只要 maxsize 设得足够大就万事大吉”:盲目增大
maxsize(或使用无上限的@cache)会使内存无底线扩张。当入参组合基数很大时,缓存命中率极低,不仅无法提升性能,反而会持续消耗宝贵内存,甚至触发容器 OOM(内存溢出)。缓存必须设置合理的maxsize并在必要时主动调用cache_clear()。 - 误区三:“@property 只是单纯的语法糖,没有任何副作用”:
@property将方法伪装为字段,极易诱使调用方在循环内频繁访问。如果方法背后涉及序列化解析、ORM 延迟加载或线程锁竞争,会导致极其隐蔽的性能瓶颈。
八、核心装饰器特性与避坑速查表
为了便于在日常开发与代码审查中快速定位问题,下表将 Python 自带的典型装饰器、核心用途、高频陷阱及防御策略进行了系统化归纳:
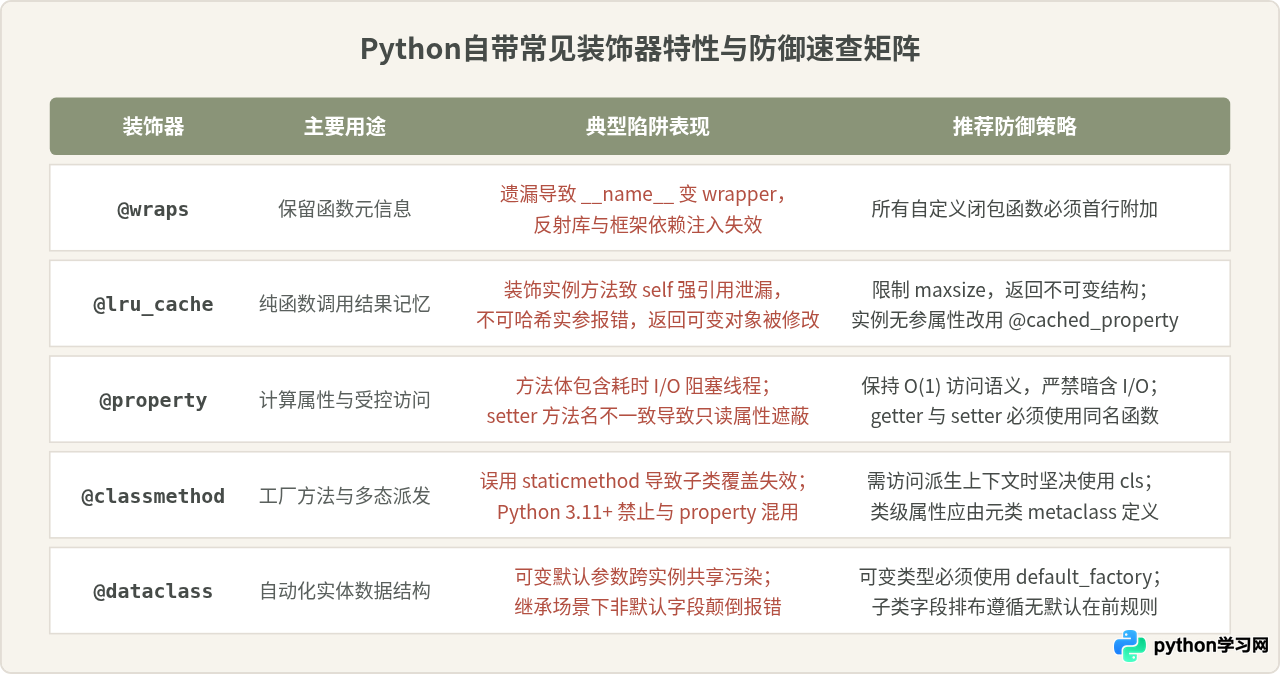
正确使用 Python 自带装饰器的关键,在于清晰把握“定义期注册”与“调用期分发”的生命周期差异。在编写或审查代码时,时刻保持对元数据保留(@wraps)、强引用闭包(lru_cache)以及多态边界(classmethod/property)的警惕,便能充分享受标准库装饰器带来的高表达力,同时确保系统的健壮与高效。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









