

Python列表报错没有head属性?用切片list[:n]模拟head效果
针对Python内置列表调用head()引发AttributeError的常见报错,深入分析原因,并详解如何利用切片语法list[:n]优雅模拟head效果及边界处理技巧。
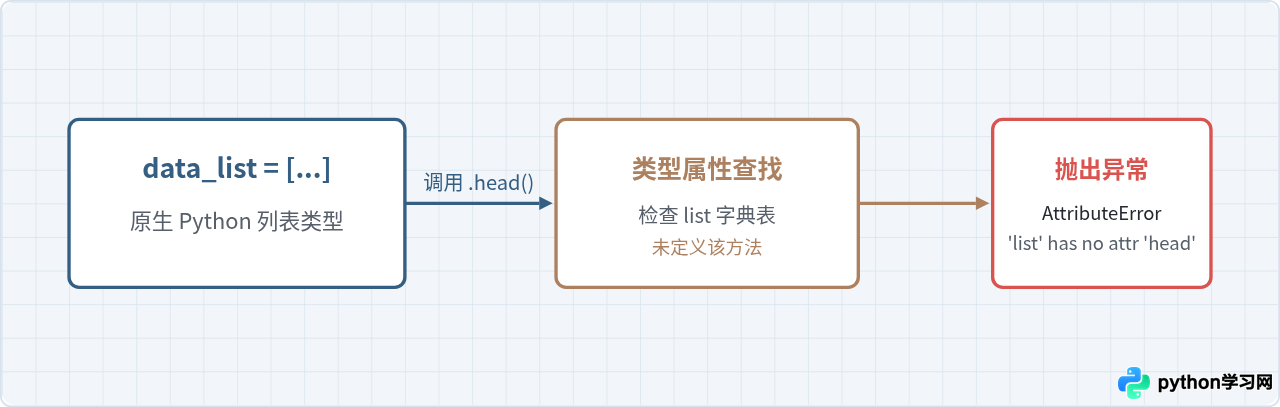
在 Python 中对原生列表(list)对象调用 .head() 方法时,程序会立即中断并抛出 AttributeError: 'list' object has no attribute 'head' 错误。这是因为 head() 是数据分析库 Pandas(针对 DataFrame 和 Series)中的专属方法,原生列表并未定义该属性。解决该问题的标准做法是使用 Python 内置的原生切片语法 list[:n] 来提取前 n 个元素,其不仅零额外依赖、运行高效,而且具备安全的越界容错机制。
一、报错复现与根本原因排查
许多开发者在从 Pandas 数据清洗转向通用 Python 开发时,很容易将查看前几行数据的直觉带入普通列表操作中。以下为最典型的触发场景:
# 错误示例:试图在普通列表上调用 head()
data_list = ["apple", "banana", "cherry", "date", "elderberry"]

try:
    preview = data_list.head(3)
except AttributeError as e:
    print(f"捕获异常: {e}")

# 示例输出:
# 捕获异常: 'list' object has no attribute 'head'
Python 解释器在执行 data_list.head(3) 时,会在 list 类的命名空间中查找名为 head 的属性或方法。因为内置 list 类型仅包含 append、pop、extend、sort 等原生方法,未定义 head,查找失败后便抛出 AttributeError。
二、解决方案:使用切片 list[:n] 模拟 head 效果
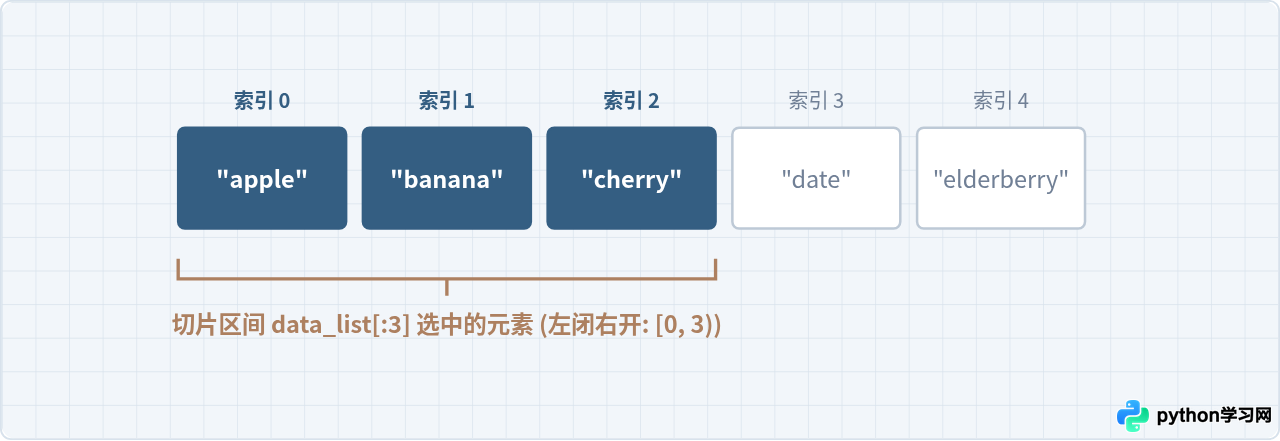
在 Python 序列操作中,切片表达式 sequence[start:stop:step] 是最基础也是最高效的提取手段。如果希望模拟 head(n) 获取列表的前 n 个元素,只需省略起始索引 start(缺省默认为 0),将终止索引指定为 n 即可:list[:n]。
# 正确示范:使用切片 list[:n]
data_list = ["apple", "banana", "cherry", "date", "elderberry"]

# 模拟 head(3):获取前 3 个元素
head_3 = data_list[:3]
print("data_list[:3] ->", head_3)

# 模拟 head(1):获取第 1 个元素构成的列表
head_1 = data_list[:1]
print("data_list[:1] ->", head_1)

# 示例输出:
# data_list[:3] -> ['apple', 'banana', 'cherry']
# data_list[:1] -> ['apple']需要注意切片的“左闭右开”规则:data_list[:3] 提取的是索引为 0、1、2 的三个元素,并不包含索引为 3 的元素。
三、切片模拟的边界行为与关键细节
许多初学者担心如果请求的 n 大于列表长度,切片是否会抛出 IndexError。事实上,Python 对切片边界的处理非常宽容:
1. 长度超出预期时(n > len(list))
在直接使用单索引访问时(如 data_list[10]),超出范围会引发 IndexError: list index out of range。但切片操作永远不会引发越界异常。当 n 超过列表总长时,切片会自动截取到列表末尾,返回完整的列表浅拷贝:
short_list = [10, 20]
# 列表仅有 2 个元素,切片请求前 5 个
result = short_list[:5]
print("short_list[:5] ->", result)

# 示例输出:
# short_list[:5] -> [10, 20]
2. 浅拷贝机制
切片返回的是一个全新的列表容器(浅拷贝),修改返回的新列表不会改变原列表的结构,但如果列表中嵌套了可变对象(如字典或子列表),其内部元素的引用仍然是共享的。
四、操作步骤:从报错到正确实现模拟
要在工程实践中彻底排查并替换此类调用,建议遵循以下四个标准化排查与实施步骤:
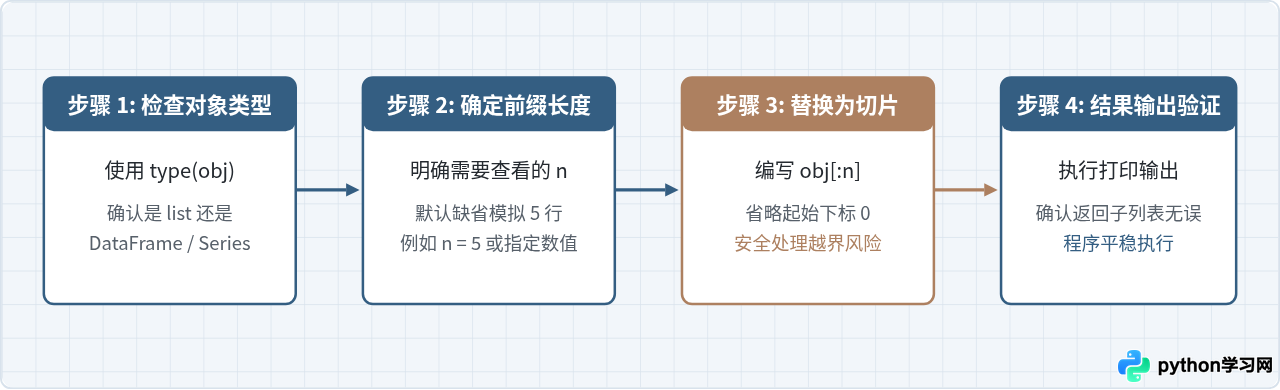
- 类型确认:在调用前先使用
print(type(obj))明确数据结构,确认其确系list而非封装好的 Pandas 对象。 - 明确截取长度:Pandas 中
head()默认取 5 行,若希望完全对齐该默认行为,可设定变量n = 5。 - 替换为切片代码:将
obj.head(n)替换为原生表达式obj[:n]。 - 输出与验证:运行脚本并检查返回值,确保无异常抛出。
五、进阶技巧:封装通用辅助函数与生成器截取
如果项目中有大量不同类型的数据(可能同时存在原生列表与数据帧),或者处理的是无法切片的大型迭代器(如生成器),可以采用以下更具通用性的方法。
1. 编写兼容性 preview 函数
def head(data, n=5):
    """
    通用 head 辅助函数:
    若对象自带 head 方法则直接调用,否则使用切片机制
    """
    if hasattr(data, "head") and callable(data.head):
        return data.head(n)
    return data[:n]

# 测试普通列表
print(head([1, 2, 3, 4, 5, 6, 7], 3))  # 输出: [1, 2, 3]
2. 对生成器使用 itertools.islice
如果数据不是已经加载在内存中的列表,而是占用内存较小的生成器对象,直接切片 gen[:n] 会引发 TypeError: 'generator' object is not subscriptable。此时应使用 Python 标准库中的 itertools.islice:
from itertools import islice

# 模拟大容量数据生成器
def number_stream():
    num = 1
    while True:
        yield num
        num += 1

stream = number_stream()
# 获取前 5 个元素
head_stream = list(islice(stream, 5))
print("生成器模拟 head(5) ->", head_stream)

# 示例输出:
# 生成器模拟 head(5) -> [1, 2, 3, 4, 5]
六、总结与对比
下表与图示全面总结了 Python 列表切片与 Pandas head() 的关键属性差异,帮助开发者根据场景选择最适方案:
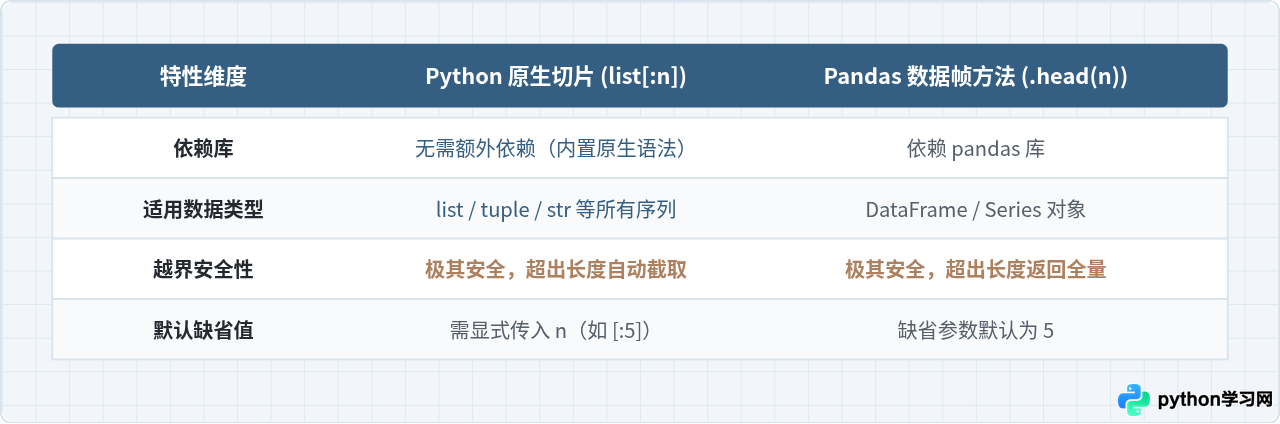
AttributeError: 'list' object has no attribute 'head' 时,无需引入复杂的外部库或重构数据管道,直接将 .head(n) 替换为原生切片语法 [:n],即可在保持高效的同时完美实现预览前置元素的需求。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









