

python必背源代码pandas缺失值处理代码
精选Python中Pandas库缺失值处理核心代码与实战技巧,涵盖缺失值检测、条件删除、统计与时序填充、线性插值以及隐藏异常值替换,提供标准工作流与代码避坑指南。
在 Python 数据分析与机器学习特征工程中,缺失值(以 NaN、None 或自定义异常值形式出现)是破坏计算管道与模型稳定性的主要因素。处理缺失值的标准解决路径由四个确定步骤构成:排查统计分布 ➔ 统一异常缺失标记 ➔ 依据业务边界分流处理(删除或填充) ➔ 最终类型验证对齐。掌握 Pandas 中针对缺失值处理的核心代码模板与参数机制,能够直接解决实际开发中从粗清洗到建模输入过程中的数据完整性问题。
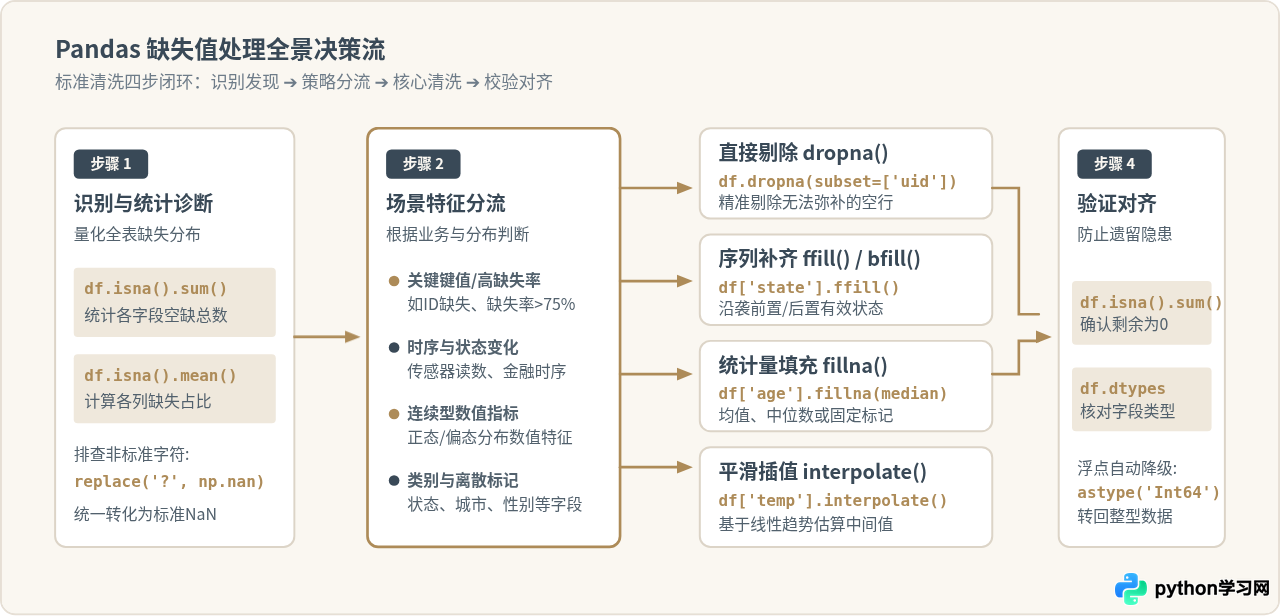
一、缺失值的快速识别与统计诊断
处理缺失值的第一步必须是量化缺失的规模与分布,避免在未掌握整体概貌的情况下直接粗暴删除。Pandas 提供了基于布尔掩码的判断函数以及针对列和维度的汇总计算能力。
1. 核心检测与统计代码
import pandas as pd
import numpy as np

# 示例数据集准备
data = {
    'user_id': [1001, 1002, 1003, 1004, 1005],
    'age': [23, np.nan, 34, np.nan, 29],
    'score': [88.5, 92.0, np.nan, 76.5, np.nan],
    'city': ['北京', '上海', np.nan, '广州', np.nan]
}
df = pd.DataFrame(data)

# 1. 必背:查看全表各列缺失值绝对数量
missing_count = df.isna().sum()

# 2. 必背:查看全表各列缺失占比(浮点保留两位小数)
missing_ratio = (df.isna().mean() * 100).round(2)

# 3. 汇总成缺失诊断报告表格
summary = pd.DataFrame({'缺失数量': missing_count, '缺失比例(%)': missing_ratio})
print(summary)
2. 定位包含空值的特定记录
除了按列统计,我们经常需要把存在缺失值的具体行提取出来进行人工核实:
# 提取含有任何缺失字段的行
rows_with_na = df[df.isna().any(axis=1)]

# 全局判断:整个 DataFrame 是否存在任何缺失值(返回单一布尔值)
has_any_missing = df.isna().values.any()在 Pandas 中,df.isna() 与 df.isnull() 完全等价,两者底层实现相同,官方推荐统一使用语义更准确的 isna()。
二、样本剔除代码:dropna() 关键参数与切片控制
当缺失数据集中在无法人工补充的关键主键、标签列,或某特征缺失比例过高(例如超过 70%)时,删除是维护数据严谨性的首选方式。但默认调用无参的 df.dropna() 会采用 how='any' 规则删除任意包含空值的行,极易导致有效数据被大面积误删。
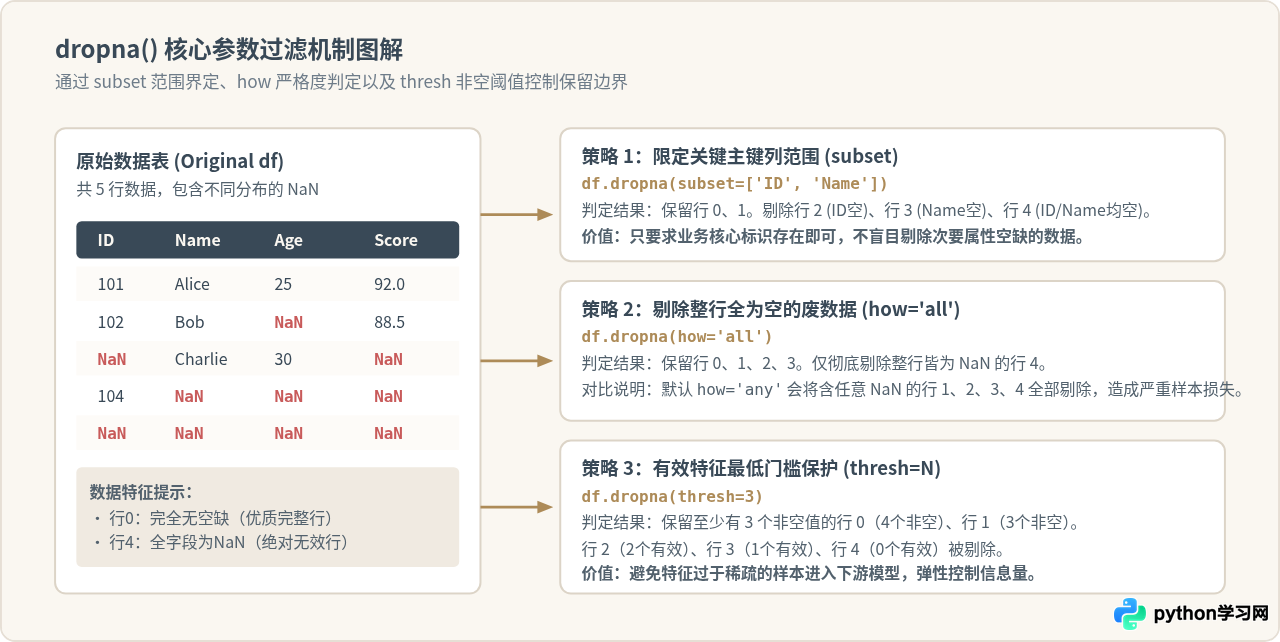
1. 针对业务主键的定向删除(subset)
大部分场景下,我们只关心某些核心列是否存在空值,比如用户 ID、成交金额等决定性字段:
# 必背:只在 user_id 或 score 为空时才剔除对应行
df_clean = df.dropna(subset=['user_id', 'score'])
2. 删除整行完全为空的无效记录(how='all')
# 必背:仅当一整行所有列全为 NaN 时才执行删除
df_clean = df.dropna(how='all')
3. 基于有效信息量阈值的保护性删除(thresh)
thresh=N 参数要求该行必须包含至少 N 个非空有效值才予以保留,非常适合过滤特征采集严重不全的脏数据:
# 必背:保留至少有 3 个非空字段的样本行
df_clean = df.dropna(thresh=3)
4. 删除整列缺失严重的特征维度(axis=1)
# 必背:计算各列缺失率,过滤掉缺失率超过 50% 的无效列
threshold = len(df) * 0.5
df_filtered_cols = df.dropna(thresh=threshold, axis=1)现代 Pandas 强烈不建议使用 inplace=True。原地修改破坏链式调用,并在内部可能产生隐式复制导致性能下降。推荐始终采用变量重新赋值:df = df.dropna(...)。
三、值填充代码:fillna() 策略与现代规范
对于次要特征或不可避免产生信息折损的指标,删除样本往往代价过高,需采用数值填充。Pandas 提供了标量替换、列差异化映射以及基于统计分布的填充能力。
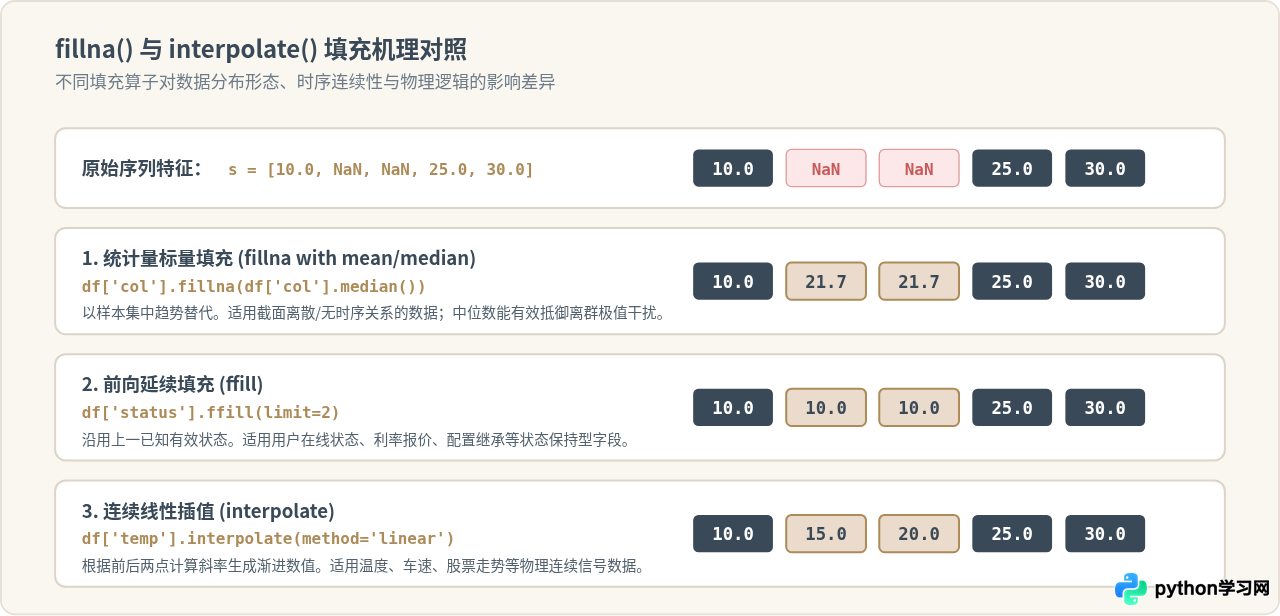
1. 统计量填充(均值、中位数与众数)
对数值型指标,应结合分布形态选用均值或中位数;中位数在存在极端异常值时不发生偏倚:
# 1. 必背:数值列使用中位数填充(抗离群点)
df['age'] = df['age'].fillna(df['age'].median())

# 2. 必背:正态分布数值列使用均值填充
df['score'] = df['score'].fillna(df['score'].mean())

# 3. 必背:分类字段使用众数填充(mode() 返回 Series,取 index 0)
city_mode = df['city'].mode()[0]
df['city'] = df['city'].fillna(city_mode)
2. 多列批量差异化填充(字典映射法)
在工业级数据管道中,逐列写代码繁琐且易乱,使用字典映射可以一行代码完成全表多列定制化填充:
# 必背:通过字典定义不同字段的填充缺省值
fill_rules = {
    'age': df['age'].median(),
    'score': 0.0,
    'city': '未知城市'
}
df = df.fillna(fill_rules)
3. 序列与时序数据填充(ffill 与 bfill)
对于机器运行状态、报价记录等具有状态延续性的数据,采用前向填充(用前一个有效值延续补空)或后向填充:
# 必背:现代 Pandas 2.0+ 推荐写法(直接调用 ffill/bfill 方法)
# 注意:限制最多连续向前填充 2 个空缺,避免过度延续
df['status'] = df['status'].ffill(limit=2)

# 后向填充:用下一个最近的有效值补空
df['status'] = df['status'].bfill(limit=2)
四、时序与连续信号插值:interpolate() 代码
对于传感器监测、温度采样、股价与连续物理量数据,前向延续会出现阶梯状跳变,均值填充会破坏连续走势。此时应当使用插值法(Interpolation)根据前后趋势拟合填补。
# 示例连续时间序列
ts_data = pd.Series([10.0, np.nan, np.nan, 25.0, 30.0])

# 1. 必背:标准线性插值(前后数据按直线斜率平滑过渡)
ts_linear = ts_data.interpolate(method='linear')
# 输出对应补齐为:[10.0, 15.0, 20.0, 25.0, 30.0]

# 2. 必背:限制最大连续插值个数,防止长时间掉线数据被虚假填满
ts_limited = ts_data.interpolate(method='linear', limit=1, limit_direction='forward')

# 3. 基于时间间隔的非等距插值(索引须为 DatetimeIndex)
# df['sensor_val'] = df['sensor_val'].interpolate(method='time')
五、非标准缺失字符归一化与类型修正
许多业务系统导出的 CSV 或日志中,缺失并未直接标记为标准 NaN,而是使用了 '?'、'None'、'-999'、'N/A' 或纯空格字符串。如果未先将其归一化,后续的 isna() 与 fillna() 将完全失效。
1. 替换伪缺失标记为标准 NaN
# 1. 必背:列表匹配替换
df = df.replace(['?', '-', '-999', 'N/A', 'None'], np.nan)

# 2. 必背:使用正则表达式将纯空格/空白字符清洗为 NaN
df = df.replace(r'^\s*$', np.nan, regex=True)
2. 缺失值填充后的类型修正(astype)
在 Pandas 中,包含 np.nan 的整型列会被自动向上转型为 float64。在清洗填充完成后,必须显式转换回整型或使用 Pandas 可空整型:
# 方案 A:填充后转为原生整型 int
df['age'] = df['age'].fillna(0).astype(int)

# 方案 B:使用 Pandas 内置支持 NaN 的扩展整数类型 Int64
df['age'] = df['age'].astype('Int64')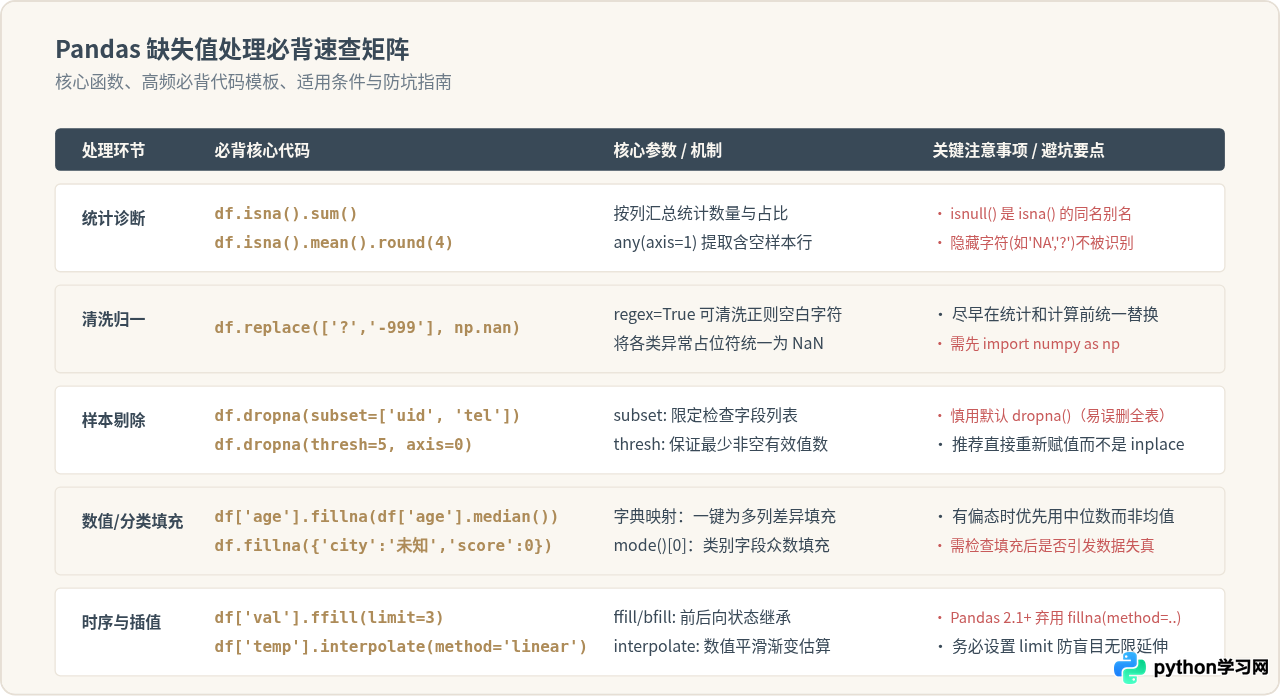
六、生产环境端到端通用清洗模板
将上述所有核心代码整合为一段结构紧凑、可直接嵌入实际工程或 ETL 任务的标准函数模块:
def clean_dataframe_missing_values(df_raw):
    """
    生产级缺失值标准化清洗通用函数
    """
    df = df_raw.copy()

    # 步骤 1:排查并统一替换异常占位符
    df = df.replace(['?', '-999', 'NA', 'null'], np.nan)
    df = df.replace(r'^\s*$', np.nan, regex=True)

    # 步骤 2:剔除整行全空及核心主键确实缺失的样本
    df = df.dropna(how='all')
    if 'user_id' in df.columns:
        df = df.dropna(subset=['user_id'])

    # 步骤 3:按字段特性执行差异化补齐
    num_cols = df.select_dtypes(include=[np.number]).columns
    cat_cols = df.select_dtypes(include=['object', 'category']).columns

    # 数值特征采用中位数填充
    for col in num_cols:
        if df[col].isna().any():
            df[col] = df[col].fillna(df[col].median())

    # 类别特征填充缺省字符串
    for col in cat_cols:
        if df[col].isna().any():
            df[col] = df[col].fillna('缺失未记录')

    # 步骤 4:校验确保零残留
    remaining_na = df.isna().sum().sum()
    print(f"清洗完成,当前剩余缺失值总数: {remaining_na}")

return df免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









