

Python嵌套for循环的执行顺序与实战案例
深入解析Python嵌套for循环的执行顺序、状态机运行机制、break与continue的作用域范围,并结合矩阵遍历、笛卡尔积与九九乘法表等实战案例,讲解工程优化与避免性能陷阱的具体策略。
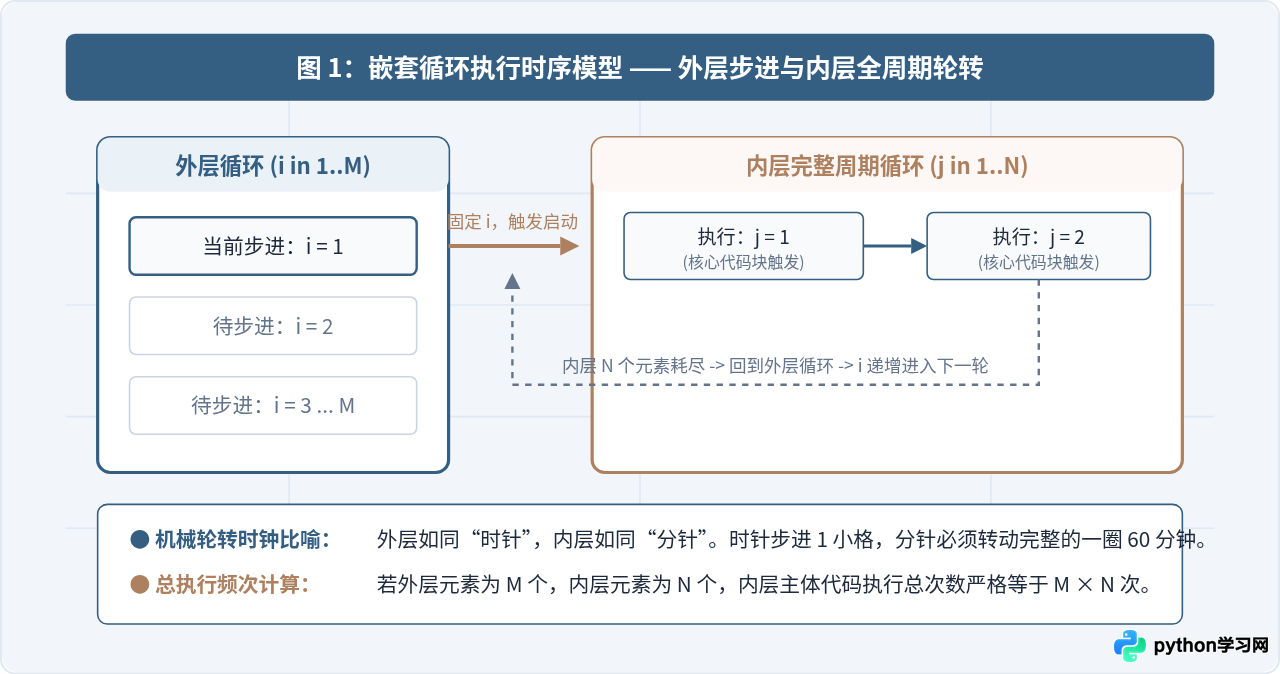
在 Python 编程中,嵌套 for 循环遵循“外层步进一次,内层完整走完一轮”的严格时序规律。若外层循环执行 M 次、内层循环执行 N 次,内层循环体内的核心逻辑总计将执行 M × N 次。深入理解这套由外向内的推进机制与状态边界,是处理矩阵操作、笛卡尔积组合以及规避性能陷阱的基础。
一、核心执行机制与时序规律
嵌套 for 循环是指在一个正在运行的 for 循环代码块内,嵌套定义了另一个或多个 for 循环。Python 解释器在遇到外层循环时,会首先提取外层可迭代对象的第一个元素,随后进入其内部代码块;一旦遇到内层 for 循环,解释器将把控制权完全移交给内层循环,直到内层循环遍历完其自身的所有元素,控制权才会返回到外层循环,使其推进到下一个元素。
我们可以通过一段带有显式跟踪输出的代码直观验证这一行为:
# 嵌套循环时序验证代码示例
for i in range(1, 4):  # 外层循环:迭代 3 次 (i = 1, 2, 3)
    print(f"--> [外层启动] 第 {i} 轮迭代开始 (i = {i})")

    for j in range(1, 3):  # 内层循环:迭代 2 次 (j = 1, 2)
        print(f"    * [内层执行] i = {i}, j = {j}")

    print(f"<-- [外层结束] 第 {i} 轮内层已全部走完\n")
该脚本的示例执行输出如下:
--> [外层启动] 第 1 轮迭代开始 (i = 1)
    * [内层执行] i = 1, j = 1
    * [内层执行] i = 1, j = 2
<-- [外层结束] 第 1 轮内层已全部走完

--> [外层启动] 第 2 轮迭代开始 (i = 2)
    * [内层执行] i = 2, j = 1
    * [内层执行] i = 2, j = 2
<-- [外层结束] 第 2 轮内层已全部走完

--> [外层启动] 第 3 轮迭代开始 (i = 3)
    * [内层执行] i = 3, j = 1
    * [内层执行] i = 3, j = 2
<-- [外层结束] 第 3 轮内层已全部走完
通过以上输出可以提炼出两个核心结论:
- 外层变量维持稳定:在内层循环由
j = 1推进到j = 2的整个执行周期中,外层变量i的取值始终被固定,不会发生改变。 - 内层迭代彻底重置:当外层变量由
i = 1步进至i = 2后,内层循环会重新从头初始化,从最初的j = 1重新开始执行完整周期。
二、单步状态转移与控制语句作用域
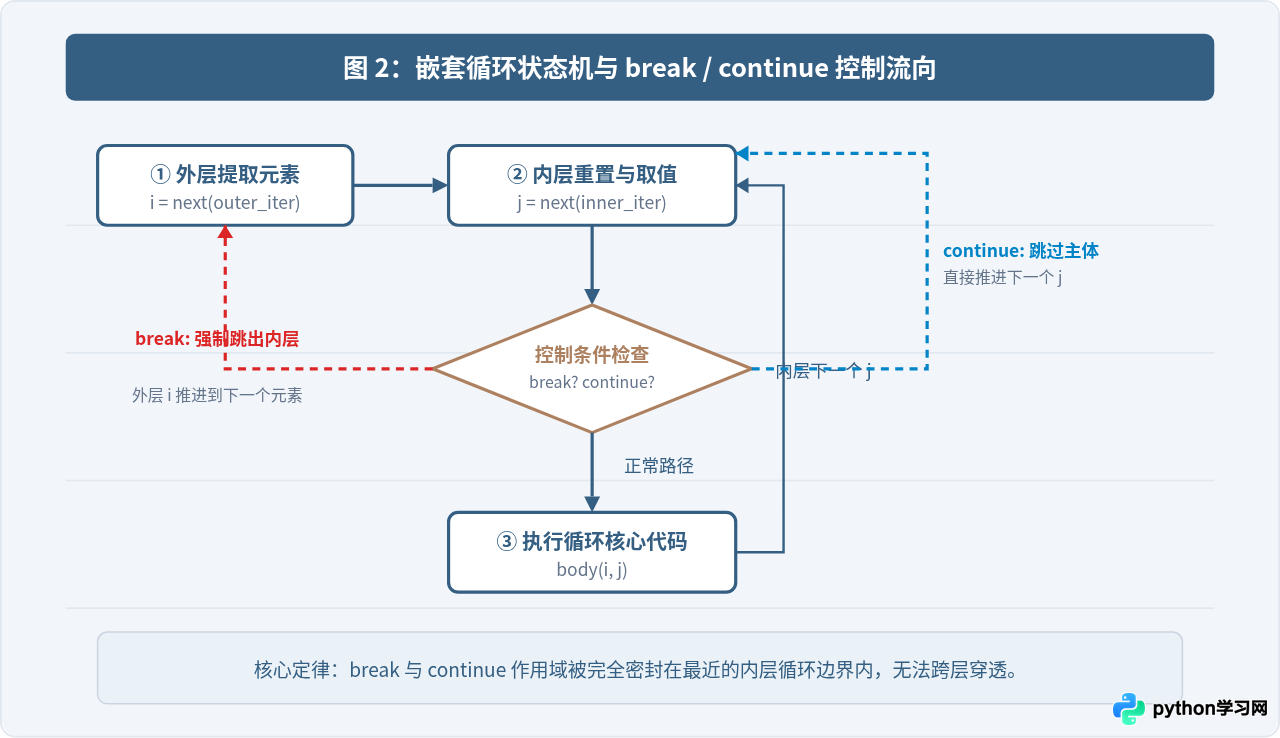
在深入复杂的业务场景前,必须准确掌握循环控制语句(break 与 continue)在嵌套结构下的作用范围。许多初学者容易产生一种误解,认为一条 break 会终止所有循环层,或者 continue 会直接跳回最外层,这种认知偏差往往会导致隐蔽的逻辑缺陷。
1. 控制语句的作用域仅限于“当前最内层”
Python 语法规范明确界定了循环控制指令的有效边界:
break语句:仅终止并跳出直接包含它的那层循环。如果位于内层循环体中,它会立即结束内层循环当前周期的剩余迭代,控制流直接跳至该内层循环结束之后,外层循环随即继续推进到下一次迭代。continue语句:仅跳过当前内层循环当次迭代中剩余的代码,控制流直接跳转到内层循环的下一个元素抽取步骤,完全不影响外层循环的正常运转。
# break 与 continue 局部作用域验证
for i in range(1, 4):
    print(f"[外层开始] i = {i}")
    for j in range(1, 4):
        if j == 2:
            print(f"    --> 命中 j == 2,触发 break 退出内层!")
            break  # 仅跳出内层 for j 循环,不会打断外层 for i
        print(f"    执行内层: i = {i}, j = {j}")
    print(f"[外层结束] i = {i} 的后续代码继续正常执行\n")
执行该脚本后可以看到,尽管每一轮内层在 j = 2 时都触发了 break,但外层的 i = 1, 2, 3 依旧完整遍历完毕,证实 break 绝不会跨层扩散。
2. 如何在内层满足条件时“一次性跳出所有嵌套”?
在实际开发中,例如在二维矩阵中找到了目标元素,我们往往需要直接终止所有循环。常用解法有两种:
- 布尔标志位法(Flag Variable):在外层设立布尔变量(例如
found = False),内层触发后将其置为True并break,外层检查到该标志后紧接着执行外层break。 - 函数封装法(推荐工程实践):将嵌套搜索逻辑封装在一个独立函数内,一旦内层命中目标,直接使用
return返回结果,即可优雅退出整个嵌套执行栈。
三、典型实战场景与代码落地
理解了时序机制后,我们可以将嵌套循环应用于常见的三大实战场景:二维矩阵访问、动态阶梯计算与多维属性正交组合。
案例 1:二维矩阵与表格数据的“行优先”遍历
在计算机图形学、电子表格以及 NumPy 多维数组处理中,数据通常以行(Row)和列(Column)组织。在 Python 原生列表中,嵌套循环的标准访问范式为:外层循环枚举每一行,内层循环枚举该行内的所有列元素。
# 二维列表数据矩阵
matrix = [
    [10, 20, 30],
    [40, 50, 60],
    [70, 80, 90]
]

# 行优先遍历访问
for row_idx, row in enumerate(matrix):
    for col_idx, value in enumerate(row):
        print(f"坐标 [{row_idx}][{col_idx}] -> 数值: {value}")
在该案例中,外层 row_idx 推进一次,内层 col_idx 会依次访问 0, 1, 2,形成严密的行优先扫描序列。
案例 2:九九乘法表生成(内层动态依赖外层变量)
嵌套循环并不要求内层迭代范围必须是恒定不变的。在许多算法中,内层的迭代区间直接依赖外层当前变量的实时值,例如打印经典的下三角九九乘法表:
# 动态边界:内层循环终点依赖外层当前循环变量 i
for i in range(1, 10):
    row_text = []
    # 内层遍历从 1 到 i,实现阶梯式扩展
    for j in range(1, i + 1):
        row_text.append(f"{j}×{i}={i * j:<2}")
    print("  ".join(row_text))
当 i = 1 时,内层仅循环 1 次;当 i = 9 时,内层循环 9 次。这种“动态约束”机制广泛运用于冒泡排序、下三角矩阵运算以及图的邻接表遍历中。
案例 3:多属性正交组合(笛卡尔积 SKU 生成)
在电商系统或者自动化参数测试中,经常需要将多个维度的属性进行两两或三三组合。嵌套循环可以非常直观地表达笛卡尔积(Cartesian Product):
colors = ["曜石黑", "冰川白"]
storages = ["128GB", "256GB", "512GB"]

all_skus = []
for color in colors:
    for storage in storages:
        sku_name = f"{color} - {storage}"
        all_skus.append(sku_name)

print("生成的所有SKU规格组合:", all_skus)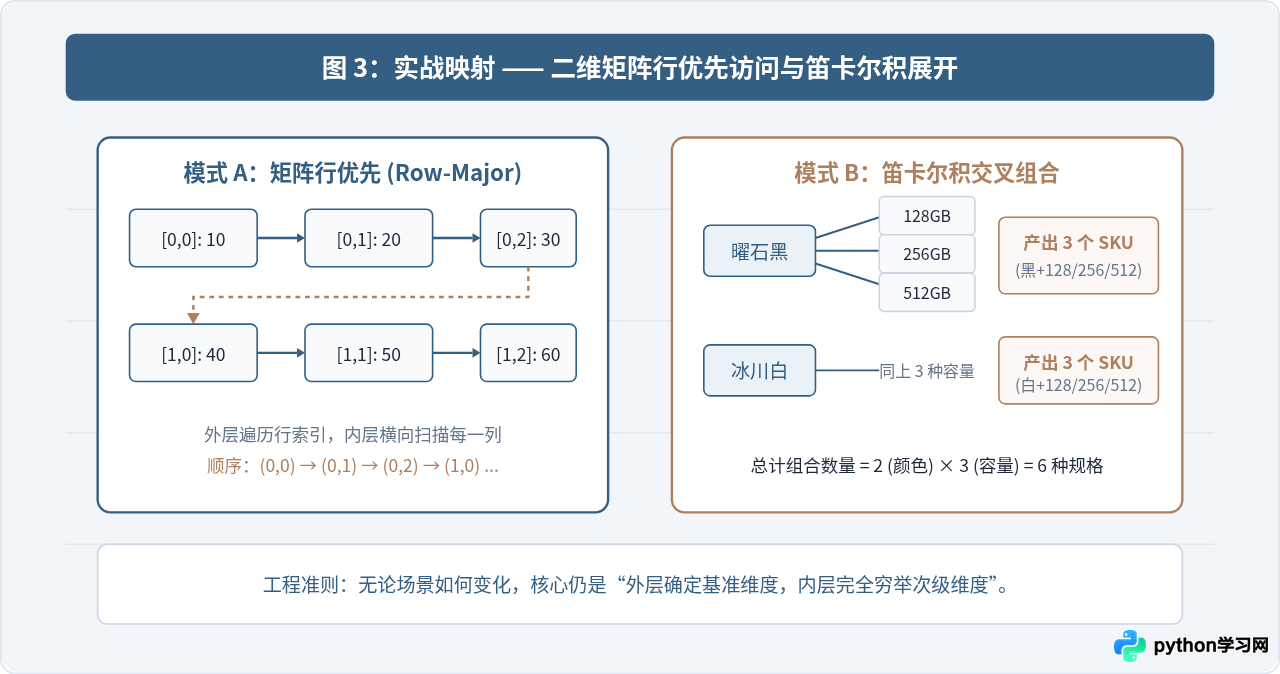
四、性能瓶颈分析与工程优化建议
嵌套循环在提供强大建模能力的同时,也潜藏着显著的性能陷阱。随着嵌套层级的加深,代码执行时间将呈现乘积级甚至指数级爆发。编写生产环境代码时,必须关注以下三项优化法则:
1. 时间复杂度风险与嵌套深度限制
两层嵌套循环的时间复杂度通常为 O(M × N)。如果两个列表的长度都达到 10,000,则内层核心代码需要执行 1 亿次,在 Python 解释器中通常耗时数秒到十几秒;若出现三层嵌套(O(N³)),在工业界通常被直接视作严重的代码坏味道(Code Smell),极易引发程序卡死或超时报错。
2. 循环体内不变计算“外提”(Invariant Hoisting)
很多开发者容易无意识地在内层循环中调用高开销函数或重复计算。只要某项计算仅依赖外层变量(甚至与内外变量均无关),就必须将其提取至外层循环之外,避免重复执行 M × N 次:
# 优化前:len(dataset) 和 format 计算在内层被重复计算了 M × N 次
for item in large_list_a:
    for sub in large_list_b:
        total_len = len(large_list_b)  # 冗余计算!
        process(item, sub, total_len)

# 优化后:不变计算外提,仅计算 1 次
total_len = len(large_list_b)
for item in large_list_a:
    for sub in large_list_b:
        process(item, sub, total_len)
3. 高频匹配场景:用哈希结构(Dict / Set)将 O(M×N) 降维至 O(M+N)
在进行两组数据匹配(如根据 ID 关联用户和订单)时,很多初学者习惯使用嵌套循环暴力查找。这种做法可以通过“预建字典/哈希集合”优化为常数时间查找:
# 优化前:暴力嵌套匹配,耗时 O(M × N)
matched = []
for order in orders:
    for user in users:
        if order["user_id"] == user["id"]:
            matched.append((order, user))
            break

# 优化后:预建索引映射,耗时 O(M + N)
user_map = {user["id"]: user for user in users}  # 构建耗时 O(N)
matched = []
for order in orders:  # 遍历耗时 O(M)
    user = user_map.get(order["user_id"])
    if user:
        matched.append((order, user))
4. 善用标准库 itertools.product 提高可读性
如果嵌套循环纯粹是为了生成笛卡尔积或进行多重范围枚举,可以使用 Python 官方标准库 itertools.product,它不仅底层采用 C 语言高效实现,而且可以消除深层缩进:
from itertools import product

# 使用 product 消除深层缩进,逻辑更加扁平直观
for color, storage in product(["曜石黑", "冰川白"], ["128GB", "256GB"]):
    print(f"规格: {color} - {storage}")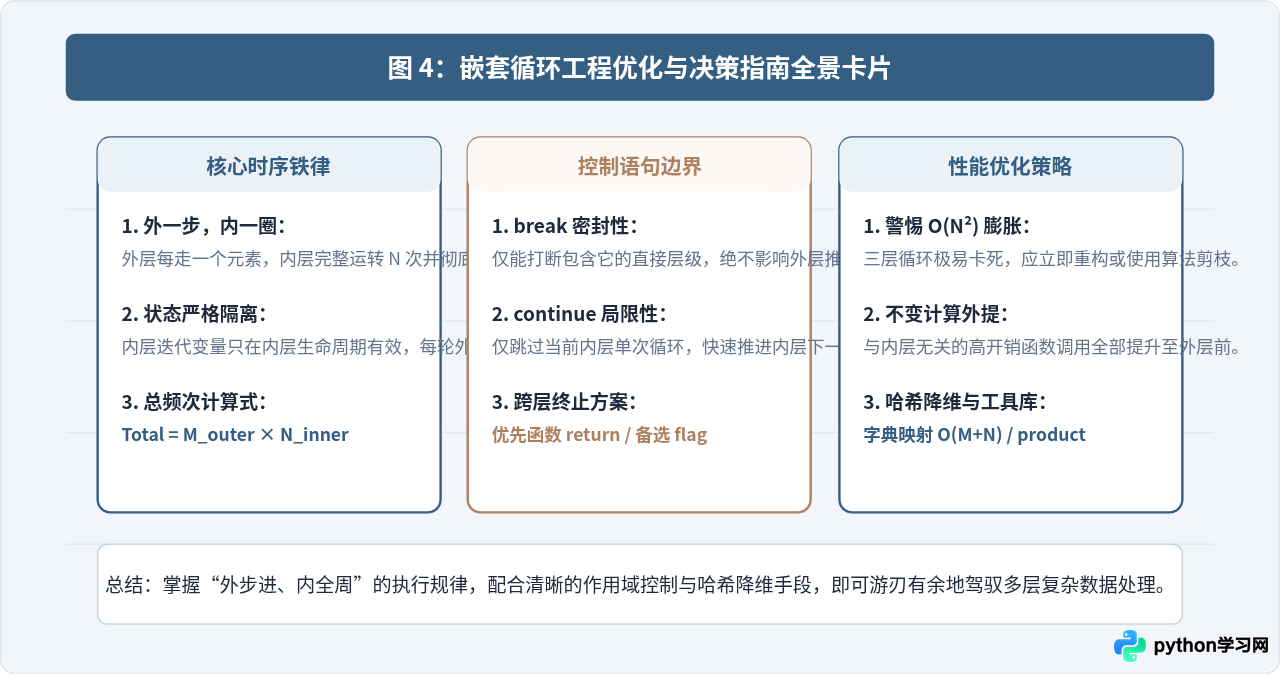
break 与 continue 绝不跨层的密封特性,并在面对大数据集时主动使用哈希映射与不变计算外提进行优化,就能在保证程序正确性的同时,写出兼具可读性与高性能的高质量 Python 代码。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









