

Python运行环境与JVM的本质区别:解释执行与即时编译
深入剖析Python运行环境(CPython)与Java虚拟机(JVM)在代码执行路径上的本质区别,从字节码解释大循环、动态类型开销到JVM分层JIT即时编译与去优化机制,揭示两者在性能、内存布局与设计哲学上的深层差异。
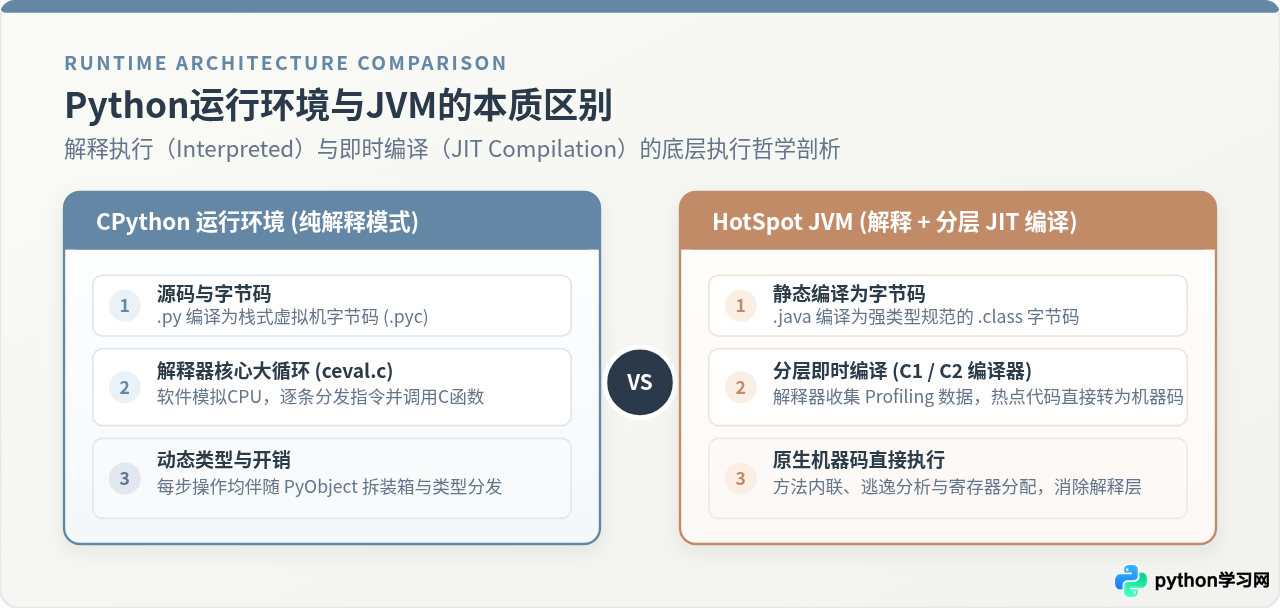
核心结论先行:许多开发者初学时常听说“Python是解释型语言,Java是编译型语言”,但这一说法并不准确,因为两者都会先将源码翻译为中间字节码。Python官方标准运行环境(CPython)与Java虚拟机(如主流的 HotSpot JVM)的本质区别在于运行时的执行机制与指令消费方式:CPython 本质上是一个用 C 语言编写的栈式字节码解释器,核心是一个不断分发并调用 C 函数的解释循环;而现代 JVM 则是以解释启动、以分层即时编译(JIT, Just-In-Time Compilation)为核心的混合执行引擎,它在运行时监控代码执行频率,将热点字节码直接重写为 CPU 原生机器码并在硬件流水线中全速执行。理解这两者的底层分野,是看清动态语言与静态语言性能代差、内存占用及架构设计的钥匙。
一、从源码到机器指令:两条截然不同的执行流水线
高级程序语言最终都必须转化为 CPU 能够识别的机器指令才能完成计算。虽然 Python 与 Java 在运行前都会经历“将源代码解析为抽象语法树(AST),再发射为字节码”的前端编译阶段,但后续交给虚拟机的生命周期存在分水岭。
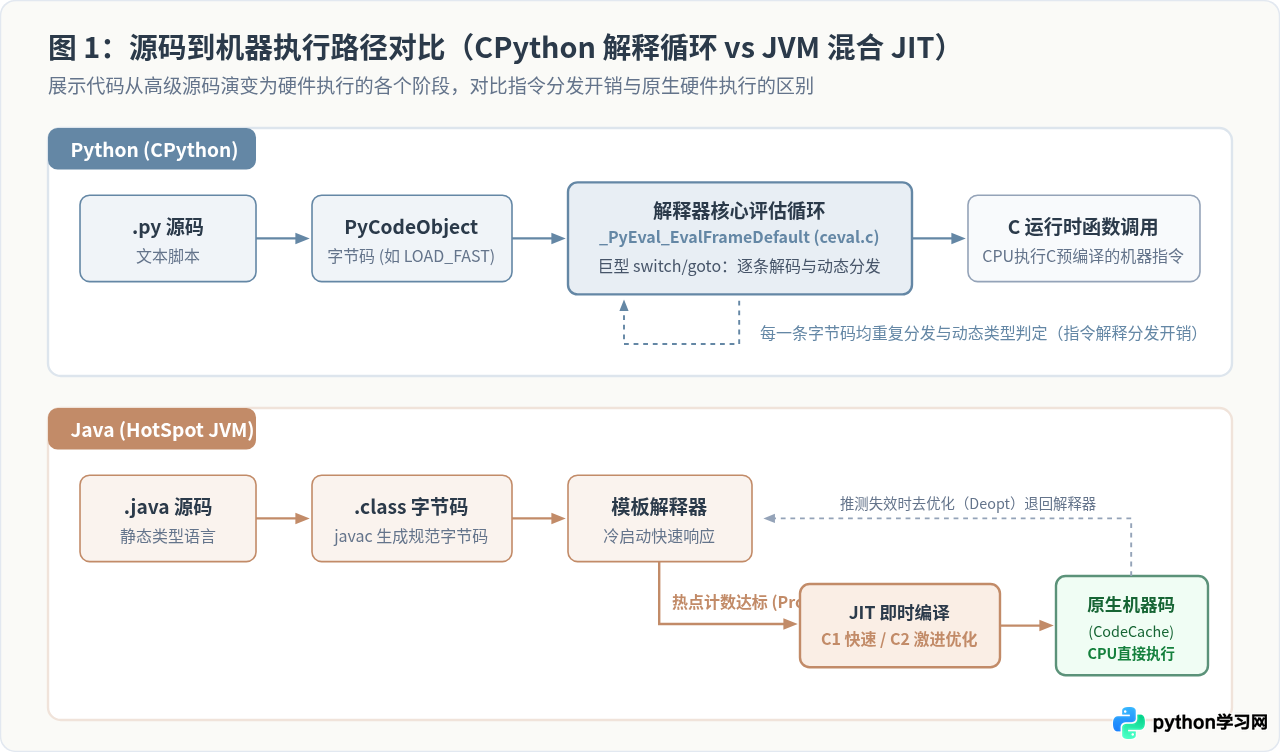
在 Python 中,.py 源码由解释器前端转换为字节码对象(PyCodeObject,有时缓存在 .pyc 文件中)。当程序执行时,CPython 虚拟机将这些字节码逐条送入内部解释函数,由宿主机 C 代码模拟执行其行为。无论一段代码执行了一万次还是十万次,在标准 CPython 下,每条字节码依然要老老实实地走一遍虚拟机解释逻辑。
而在 Java 中,javac 编译器先将 .java 静态编译为强类型的 .class 规范字节码。JVM 启动时,为了避免漫长的启动编译等待,首先使用轻量级的模板解释器(Template Interpreter)直接执行字节码;与此同时,JVM 内部的采样分析系统(Profiling)开始严密监控每个方法与循环的执行频次。一旦某个代码块被判定为“热点(Hotspot)”,即时编译器(JIT)就会在后台启动,将字节码直接编译为物理机原生汇编指令并存入内存代码缓存(CodeCache)。下一次执行该方法时,程序直接跳转到原生机器码运行,彻底甩掉虚拟机解释器的外壳。
二、深入 CPython 执行内核:字节码与解释器大循环
为了看清解释执行的内部细节,我们必须拆解 CPython 的核心源码。在 CPython 的核心代码文件(位于源码目录的 Python/ceval.c,Python 3.11+ 重构为 Python/bytecodes.c 生成)中,驻留着一个名为 _PyEval_EvalFrameDefault 的巨型函数。这个函数就是整个 Python 虚拟机的“动力心脏”。
这个函数本质上是一个庞大的循环,内部包含一条巨型的 switch-case 结构(或基于编译器特性的计算跳转 computed goto)。虚拟机维护着一个程序计数器(PC)和一个求值栈(Evaluation Stack)。每次循环取出一条操作码(Opcode),通过分发逻辑跳转到对应的 C 分支代码,执行压栈、出栈、调用 C 运行时函数,然后再跳回循环头部获取下一条指令。
1. 现场观察:一段简单累加函数的 Python 字节码
我们可以使用 Python 标准库自带的 dis 模块反编译一段简单的累加代码,观察其底层字节码指令构成:
import dis

def calculate_sum(limit):
    total = 0
    for i in range(limit):
        total += i
    return total

print("--- 字节码反编译输出 ---")
dis.dis(calculate_sum)$ python3 inspect_eval.py
--- 字节码反编译输出 ---
3 0 RESUME 0
4 2 LOAD_CONST 1 (0)
4 STORE_FAST 1 (total)
5 6 LOAD_GLOBAL 1 (NULL + range)
18 LOAD_FAST 0 (limit)
20 PRECALL 1
24 CALL 1
34 GET_ITER
>> 36 FOR_ITER 8 (to 54)
38 STORE_FAST 2 (i)
6 40 LOAD_FAST 1 (total)
42 LOAD_FAST 2 (i)
44 BINARY_OP 0 (+)
48 STORE_FAST 1 (total)
50 JUMP_BACKWARD 8 (to 36)
7 >> 54 LOAD_FAST 1 (total)
56 RETURN_VALUE2. 为什么解释执行单步计算开销巨大?
仔细观察循环体内的核心指令:LOAD_FAST、LOAD_FAST、BINARY_OP (+)、STORE_FAST。在原生机器汇编中,两个寄存器相加只需要一条单周期的 add %rax, %rbx 指令。但在 CPython 中,每一步都付出了惊人的计算代价:
- 指令分发开销(Dispatch Overhead):解释器必须不断执行读取指令、解码参数、分支跳转的逻辑。分支预测器频繁面临难以预测的跳转地址,打断了 CPU 的深级流水线。
- 指针解引与动态类型检查:Python 变量保存的绝不是裸内存数字,而是指向堆中
PyObject的指针。执行BINARY_OP (+)时,虚拟机必须先解引total对应的PyObject,检查它的类型对象指针ob_type,查看该类型是否实现了nb_add函数槽位;再检查i的类型;最终调用对应的 C 实现函数long_add。 - 堆内存分配与垃圾回收计数:在 Python 中,整数是不可变对象(Immutable)。每次加法得出新结果,CPython 都要在堆上动态分配一个新的
PyLongObject(即使有小整数对象池缓存),填充其类型头、引用计数和变长数组,并递减旧对象的引用计数。
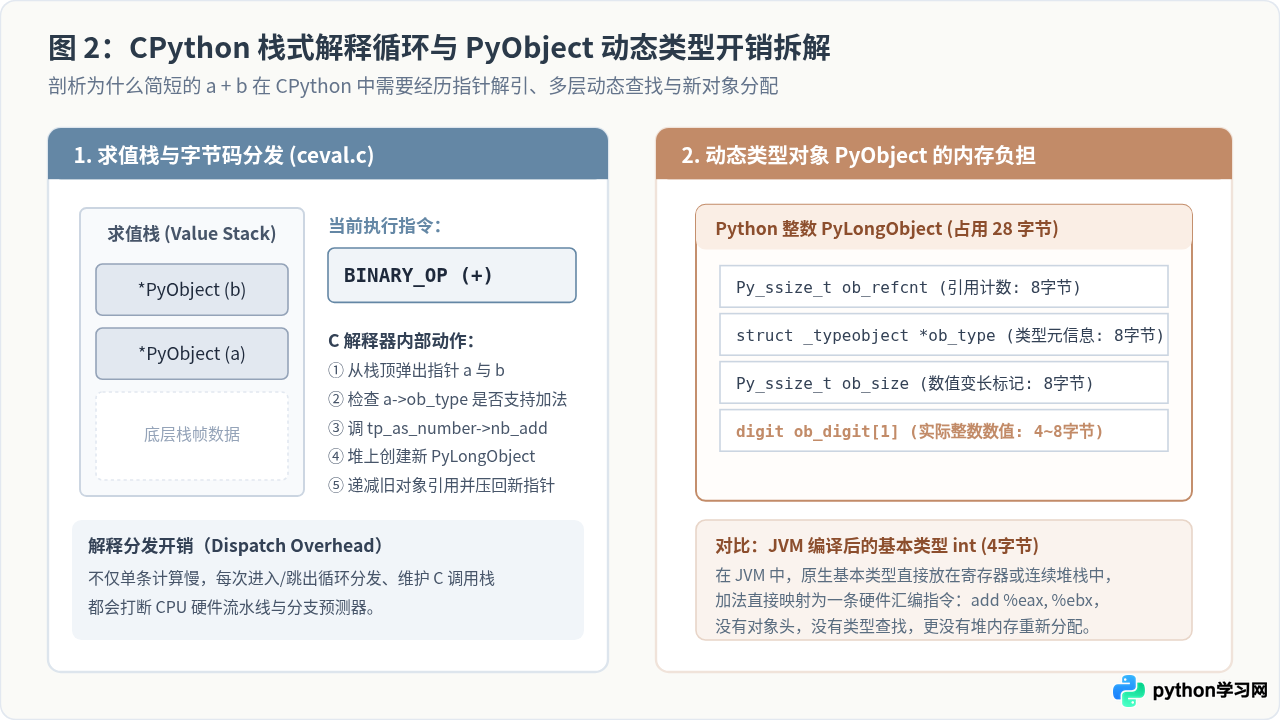
在 CPython 64 位体系下,一个最普通的整数 1 占用的内存就高达 28 字节(8 字节引用计数 + 8 字节类型指针 + 8 字节长度标记 + 4 字节有效数值)。这种内存多级间接寻址导致 CPU 缓存命中率(Cache Locality)极差,这是纯解释执行之外的另一大性能杀手。
三、深入 JVM 执行内核:分层即时编译(Tiered Compilation)
与 CPython 固守解释大循环不同,现代 JVM(以 OpenJDK HotSpot 为例)的设计思想是:将资源精准投放在最具价值的代码上。一个大型企业系统中的代码,90% 以上是只执行有限次数的冷代码(如初始化、配置文件解析),只有不足 10% 是密集运行的热点核心。
如果一开始就全量编译为机器码,不仅启动缓慢,而且会消耗巨量内存;如果全量解释执行,则吞吐量无法接受。JVM 采用的分层编译架构完美兼顾了这两端:
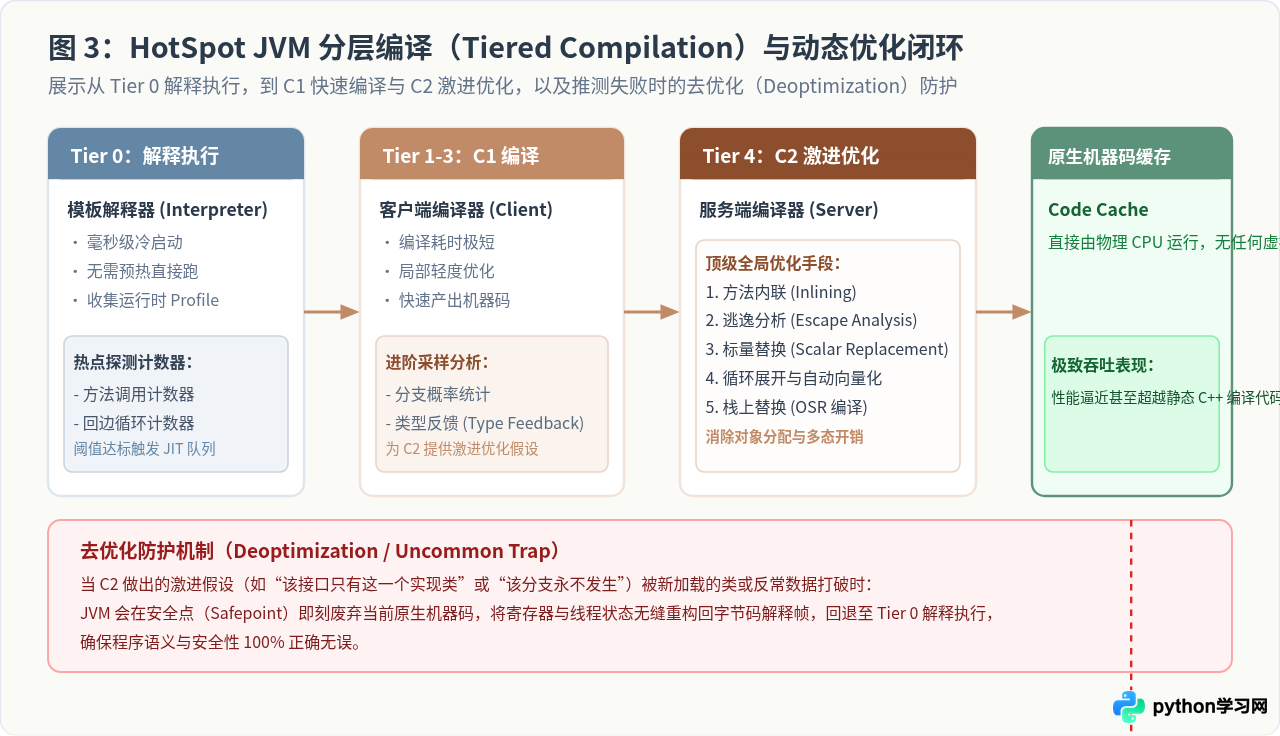
- Tier 0(解释器):使用高度优化的汇编模板解释器执行字节码,启动飞快,同时利用插入在方法入口和循环回边的计数器收集运行期数据(Invocation Counter & Backedge Counter)。
- Tier 1~3(C1 客户端编译器):当计数器超过阈值,JVM 判定该方法为热点,提交给 C1 编译器。C1 追求极高的编译速度,仅做基础的局部优化,快速产出原生机器码替换掉解释器执行。在 Tier 2/3 下,C1 生成的代码中仍带有采样探针,进一步收集分支走势和类型信息。
- Tier 4(C2 服务端编译器 / Graal):当代码持续高频运行,JVM 将其提升至 C2 编译器。C2 耗费较多的编译时间与 CPU 预算,基于前期积累的丰富 Profile 数据,执行激进的全局优化。
1. C2 编译器的王牌优化技术
C2 生成的机器码之所以能够比肩甚至超越静态编译语言,依赖于几项革命性的即时优化:
- 方法内联(Inlining):消除函数调用的栈帧开辟、参数压栈与寄存器保存开销,并为后续的死代码消除与常量折叠创造空间。
- 逃逸分析与标量替换(Escape Analysis & Scalar Replacement):如果 JIT 发现一个对象只在当前方法内部使用,不会逃逸到外部堆或其他线程,它就会彻底取消堆分配,直接把该对象的字段打散并映射到 CPU 寄存器或线程栈中。这直接消除了垃圾回收(GC)的分配压力。
- 去虚拟化(Devirtualization):通过 Profile 发现某个多态接口在实际运行中 99% 的情况下都只有同一个实现类,JIT 会将昂贵的多态虚函数查表调用直接改写为单态的直接指令跳转。
- 去优化(Deoptimization):这是 JIT 最具魔力的地方。静态编译器不敢轻易做激进假设,因为必须保证边界情况安全;而 JIT 敢于做出“这个条件分支永远不发生”的推测优化。一旦后续运行中出现罕见的反常数据(Uncommon Trap),JVM 会在预设的安全点(Safepoint)瞬间切回现场,将机器码状态无缝还原成解释栈帧,退回解释器安全运行。
2. 现场观察:JVM 如何在运行时把方法编译为机器码
我们可以编写一段等价的 Java 累加代码,通过 JVM 诊断参数 -XX:+PrintCompilation 直观查看编译器的分层提升过程:
public class JitDemo {
    public static long calculateSum(long limit) {
        long total = 0;
        for (long i = 0; i < limit; i++) {
            total += i;
        }
        return total;
    }

    public static void main(String[] args) {
        // 进行多次循环触发 JIT 热点编译
        for (int round = 0; round < 20000; round++) {
            calculateSum(1000);
        }
        System.out.println("Execution finished.");
    }
}$ javac JitDemo.java
$ java -XX:+TieredCompilation -XX:+PrintCompilation JitDemo 124 79 3 JitDemo::calculateSum (25 bytes)
125 80 4 JitDemo::calculateSum (25 bytes)
Execution finished.在上面的输出中:第 3 列的数字代表分层等级(Tier)。可以看到 calculateSum 方法首先在第 124 毫秒被 Tier 3(C1 编译器)编译;紧接着仅仅过了 1 毫秒,随着循环回边计数器再次饱和,它立即被提交给 Tier 4(C2 编译器)进行激进重写。从这一刻起,该方法内的整个循环在 CPU 内部全部以寄存器直接累加运行,执行时间下降数个数量级。
四、关键追问:为什么 Python 无法像 JVM 那样“直接加个 JIT”?
不少初学者常问:“既然 JIT 编译这么强大,为什么官方 CPython 不直接内置一个像 HotSpot 一样的 JIT 编译器,从而瞬间拥有 Java 级别的速度?”
答案隐藏在语言的动态语义契约与历史生态包袱中:
- 极致动态性破坏了编译器推测的前置条件:在 Java 中,类的结构、方法的签名和字段的类型在类加载完成后基本固定。而在 Python 中,任何对象、模块、函数乃至类本身的属性都可以在运行期随时被猴子补丁(Monkey Patching)动态篡改;代码还支持随时随地的反射与动态命名空间检查(如
sys._getframe())。要让 JIT 做优化,就必须对每一处动态属性访问增加大量的守卫判断(Guards),当动态性过高时,检查守卫的开销甚至可能超过纯解释执行。 - C-API 的历史锁定:Python 拥有极其繁荣的科学计算与人工智能生态(NumPy、PyTorch、TensorFlow 等),这些库完全依赖 CPython 底层的 C-API。而 C-API 深度暴露了
PyObject结构体的内部字段和指针布局。如果 JIT 编译器尝试做“标量替换”把对象打散存进寄存器,一旦第三方 C 扩展索取该对象的裸指针,虚拟机就必须把寄存器状态重新“物化(Materialize)”成真实的堆内存结构,极大制约了编译器的发挥空间。 - 全局解释器锁(GIL)的束缚:CPython 的 GIL 确保了单进程内只有一个原生线程在执行字节码,这虽然极大简化了 C 扩展的线程安全,但也使得多线程运行时无法充分利用多核硬件来并行分摊 JIT 编译与分析的背景负担。
不过,演进并未停止。专注于 JIT 的替代实现 PyPy 通过元追踪(Tracing JIT)技术证明了 Python 性能翻倍的可能;而官方 CPython 从 3.11 开始引入特化自适应解释器(Specialized Adaptive Interpreter),并在 3.13 中正式引入了实验性的基于“复制与修补(Copy-and-Patch)”技术的 Tier-1/Tier-2 JIT 编译器,正朝着混合执行方向迈出实质性步伐。
五、全维度对比总结与工程选型建议
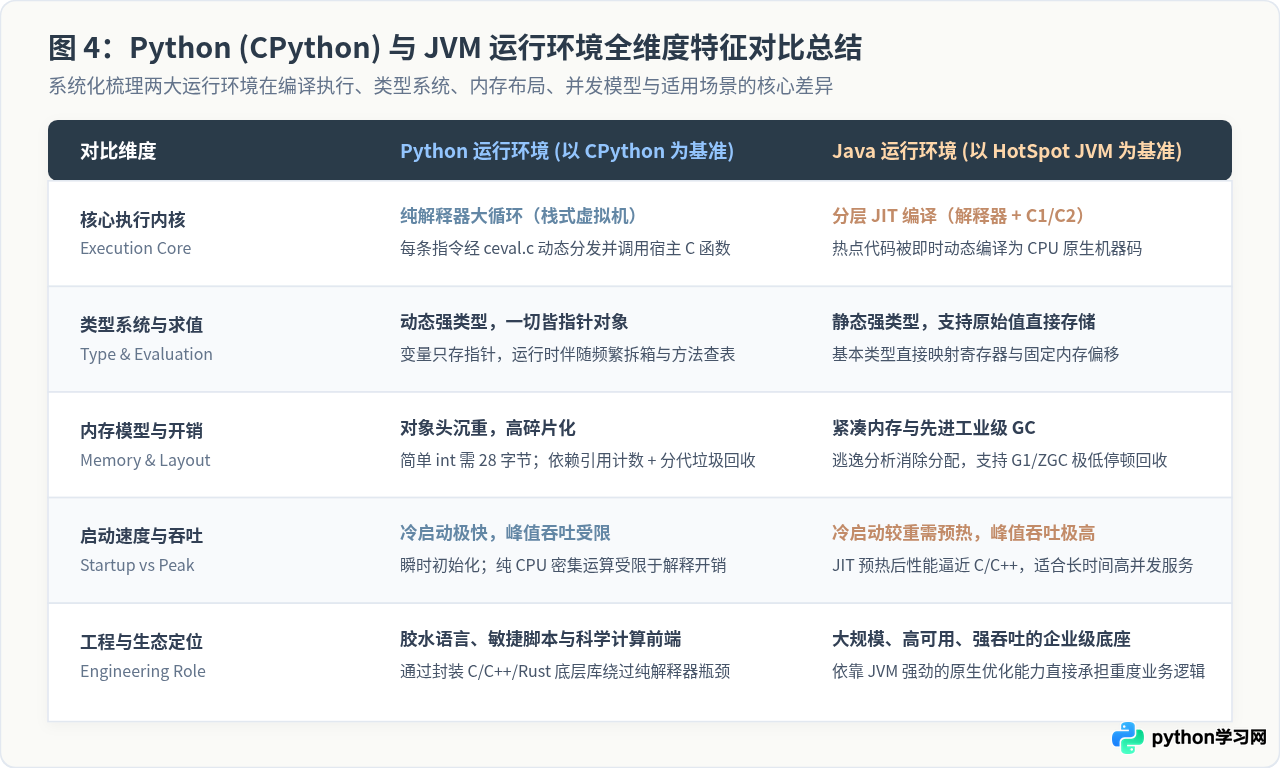
解释执行与即时编译并无绝对的高下之分,它们是针对不同工程场景做出妥协与权衡的结果:
工程选型与实践指导:
- 优先选择 Python 运行环境的场景:任务偏向胶水整合、轻量自动化脚本、CLI 工具、以及使用 NumPy/Pandas/PyTorch 进行的数据与 AI 工程。在这些领域,Python 凭借毫秒级的冷启动速度与动态交互便利性无可替代,性能瓶颈则由底层 C/C++/CUDA 算子库高效承载。
- 优先选择 JVM 运行环境的场景:长周期常驻的大型企业级微服务、海量数据吞吐的分布式计算(如 Kafka、Flink、Spark)以及复杂的重度业务逻辑系统。JVM 优秀的分层 JIT 编译能够榨干服务器硬件性能,结合现代分代低停顿 GC(ZGC/Shenandoah),为高并发系统提供稳定可靠的吞吐支撑。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









