

2026年数据分析面试还考不考Python3.10?
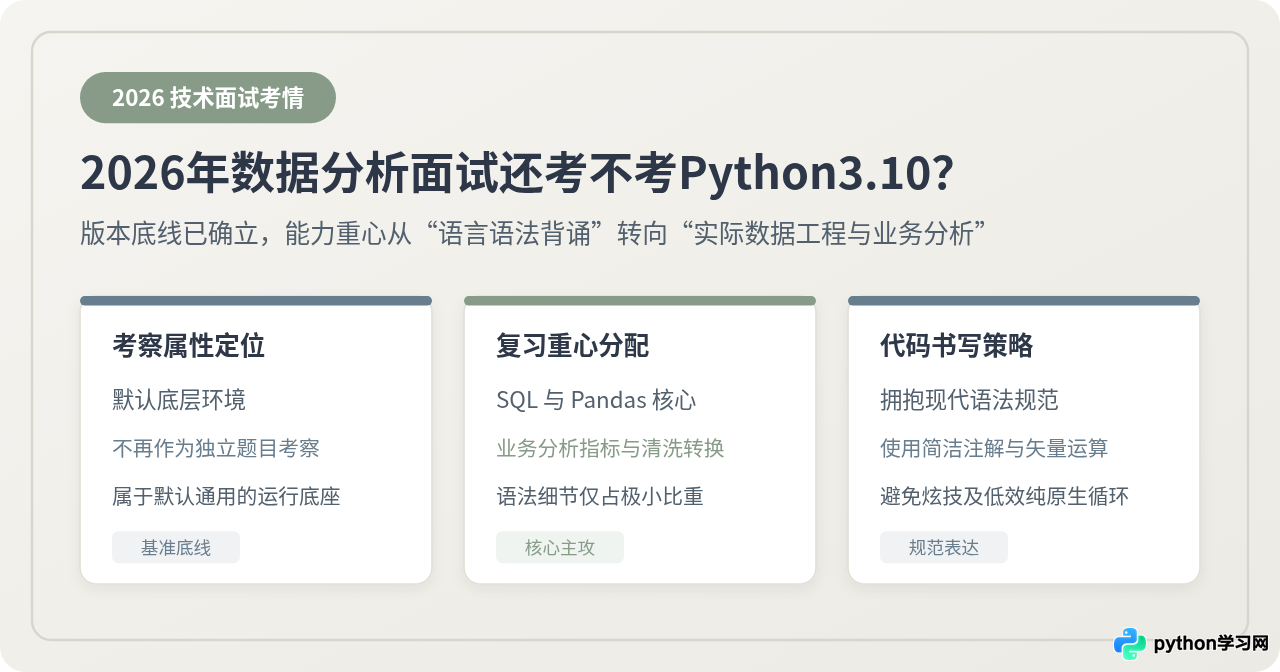
解析2026年数据分析师岗位面试中对Python 3.10的实际考察情况,对比语法琐细考点与实际业务工程能力的差异,提供明确的面试准备推导步骤与复习重心建议。
|)或模式匹配已被视作日常自然的书写习惯,而不是单独设立分值的考察点。
一、核心结论:面试考核与特定版本号脱钩
初次准备数据分析面试的求职者常常陷入一种误区:认为各大技术论坛或教程中提到的“新版本特性”是面试的必考八股文,因而耗费大量时间背诵诸如 Python 3.10 的结构化模式匹配(Structural Pattern Matching)、参数规格变量(ParamSpec)等语言底层细节。但在2026年的招聘现场,这种考察方式已经基本不存在。
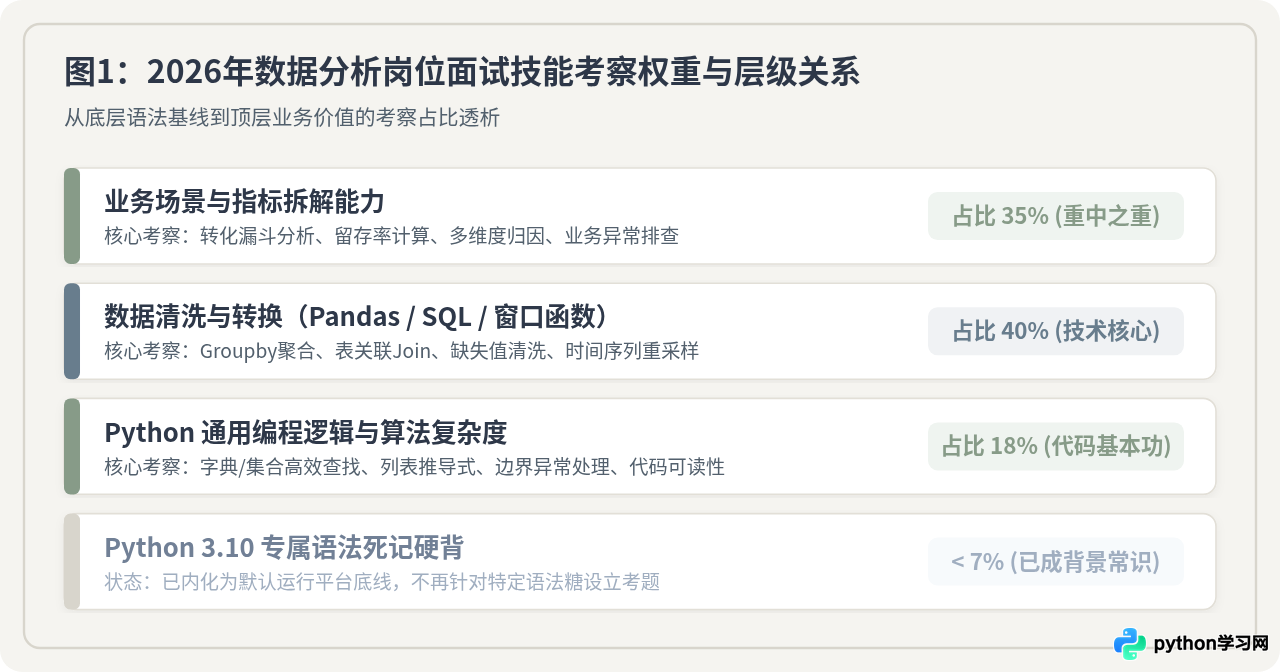
出现这种现象的原因十分明确:数据分析岗位的根本诉求是“利用数据发现并解决业务问题”,而非“评估候选人对解释器版本差异的记忆力”。企业技术面试主要分为两类场景:一是线上机考(如牛客、LeetCode、HackerRank 等评测系统),二是现场或远程白板编码(Live Coding / Jupyter Notebook)。在这些场景中,评测容器默认运行的 Python 环境通常是 3.10、3.11 或更新版本,评测脚本只校验函数返回的数据清洗结果、特征工程输出或指标数值是否正确,从不过问代码使用的是哪个特定版本的专有语法。
二、关键差异对比:版本专属考点 vs 实际业务工程能力
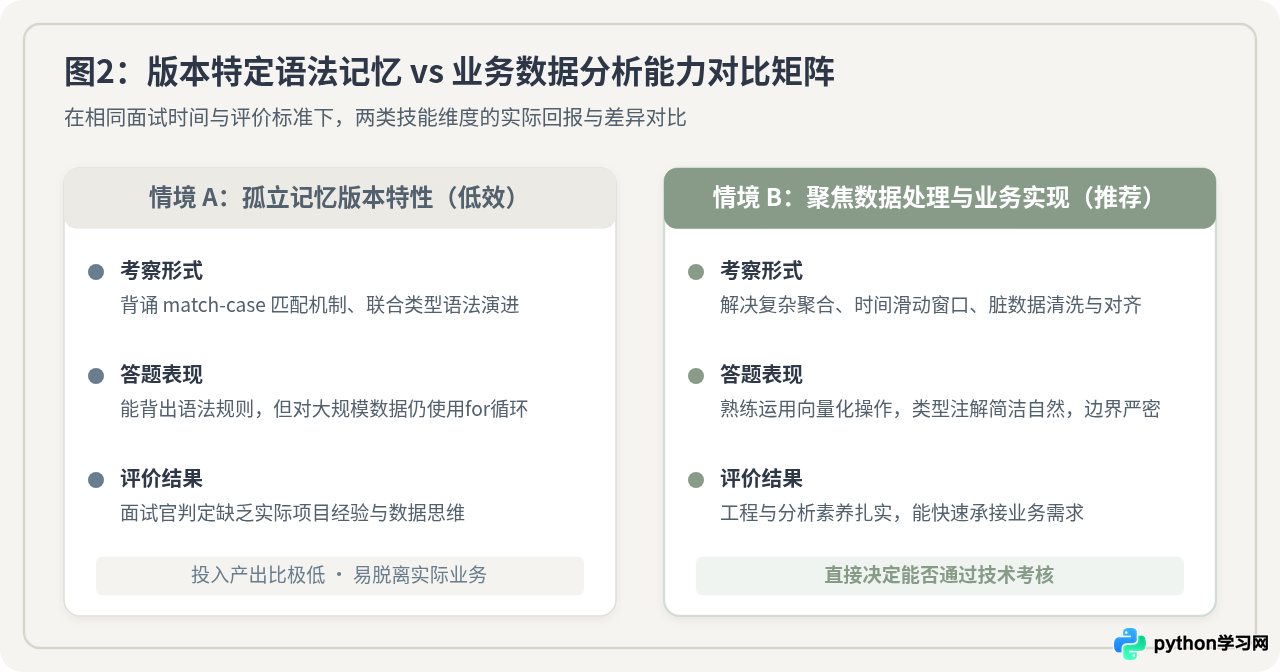
为了让复习方向更加明确,我们可以把“版本专属语法考点”与“实际业务数据工程能力”放在同一个求职考核场景中进行对比。两者的关注维度、解题表现及在面试官眼中的评估价值存在显著差异:
| 比较维度 | 版本语法记忆(低效备考) | 业务与工程分析能力(推荐重心) |
|---|---|---|
| 核心目标 | 死记 match-case 语法规则、UnionType 字节码细节 |
解决数据缺失、维度爆炸、多表聚合与时序重采样 |
| 面试考题形式 | 偏向语言基础八股问答(在数据分析面试中极少出现) | 给出电商漏斗或用户行为日志,计算复购率与留存矩阵 |
| 代码表现形式 | 大量使用原生嵌套循环,代码行数长且运行耗时过大 | 熟练使用 Pandas 矢量化计算与链式操作,简洁高效 |
| 评分权重 | 低于 5%(通常仅作为代码风格印象分) | 75% 以上(直接决定是否发放 Offer 的硬指标) |
| 职场迁移价值 | 极低,真实分析工作中极少依赖冷门版本糖 | 极高,入职即可直接承接业务取数与看板构建工作 |
从对比可以看出,将时间投入到具体的清洗操作和统计计算上,其面试通过率远高于纠结于某个版本语法细节。即便候选人能精准复述 Python 3.10 的全部更新日志,如果面对一张包含十万行缺失值和异常值的交易明细表写不出规范的 Groupby 聚合,依然无法通过考核。
三、面试现场的代码风格示范:自然融入现代语法
虽然面试不专门考查 Python 3.10 的定义细节,但在代码书写上,展现出符合现代 Python 规范的编码习惯会给面试官留下良好的工程素养印象。最典型的体现是在函数入参的类型注解(Type Hints)以及数据结构的规整上。
例如,在 Python 3.10 之前,表示一个字段既可以是整型也可以是浮点型时,必须显式从 typing 模块导入 Union。而在 3.10 之后,直接使用管道符 int | float 已经成为行业通用标准。在面试中应当以自然、简洁为准绳,而不是为了“显露版本特性”去刻意堆砌复杂的语法结构。
import pandas as pd
import numpy as np

def calculate_user_retention(
    df: pd.DataFrame,
    active_threshold: int | float = 1
) -> pd.DataFrame:
    """
    计算多周期用户活跃与留存率(示例代码)
    使用 Python 3.10+ 标准类型注解 'int | float',逻辑聚焦在矢量化操作上
    """
    # 步骤1:数据类型转换与关键列清洗
    cleaned = df.dropna(subset=["user_id", "action_date"]).copy()
    cleaned["action_date"] = pd.to_datetime(cleaned["action_date"])

    # 步骤2:确定每位用户的首访月份(基准群组 Cohort)
    cleaned["cohort_month"] = cleaned.groupby("user_id")["action_date"].transform("min").dt.to_period("M")
    cleaned["event_month"] = cleaned["action_date"].dt.to_period("M")

    # 步骤3:计算月份间隔(Period 偏移量)
    cleaned["period_offset"] = (
        (cleaned["event_month"].dt.year - cleaned["cohort_month"].dt.year) * 12 +
        (cleaned["event_month"].dt.month - cleaned["cohort_month"].dt.month)
    )

    # 步骤4:透视聚合计算留存人数矩阵
    cohort_data = (
        cleaned.groupby(["cohort_month", "period_offset"])["user_id"]
        .nunique()
        .reset_index()
    )
    retention_pivot = cohort_data.pivot(index="cohort_month", columns="period_offset", values="user_id")

    # 步骤5:转化为留存百分比
    cohort_sizes = retention_pivot.iloc[:, 0]
    retention_matrix = retention_pivot.divide(cohort_sizes, axis=0).round(4)

    return retention_matrix
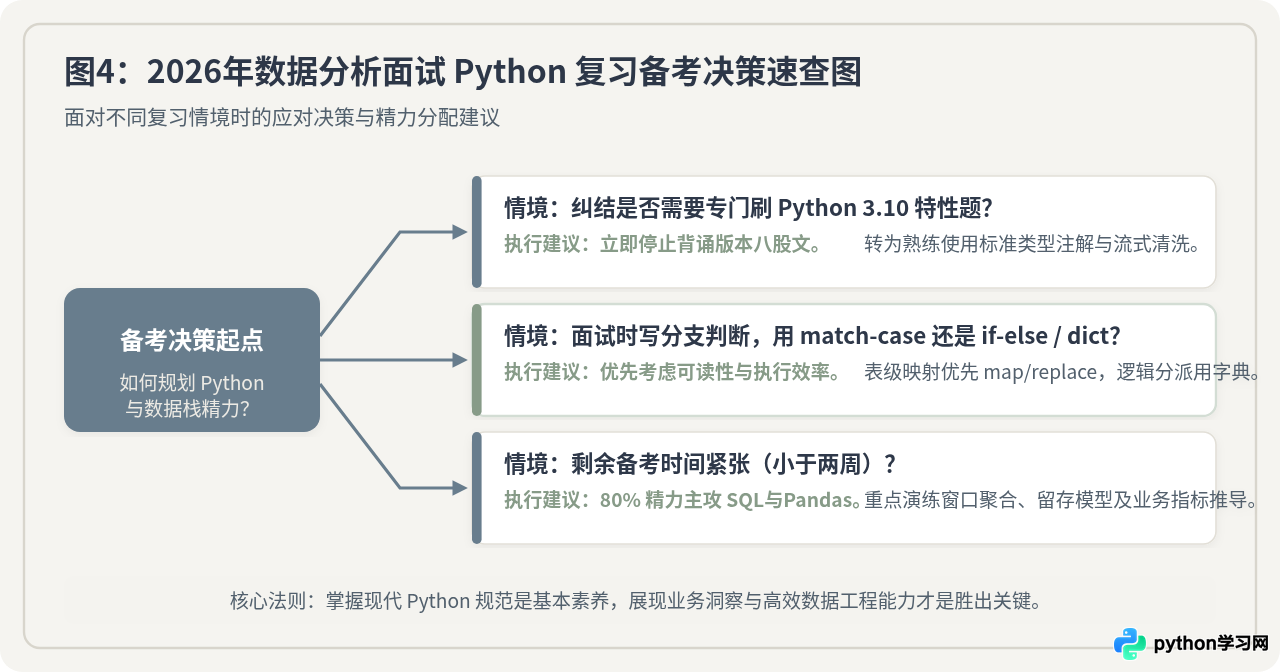
在处理单条特定字典协议或编译器AST时,模式匹配(match-case)非常优雅;但在数据分析的二维表格处理中,对 Series 或 DataFrame 的列使用模式匹配往往需要通过低效的行循环(如 apply 或 iterrows),这是面试官极其忌讳的性能反模式。对于多值条件映射,优先使用 pd.Series.map(dict) 或 np.select()。
四、数据分析面试代码准备与验证三步流程
对于计划参加2026年数据分析岗位技术面试的候选人,建议遵循以下清晰的三个步骤展开代码能力训练与环境确认:
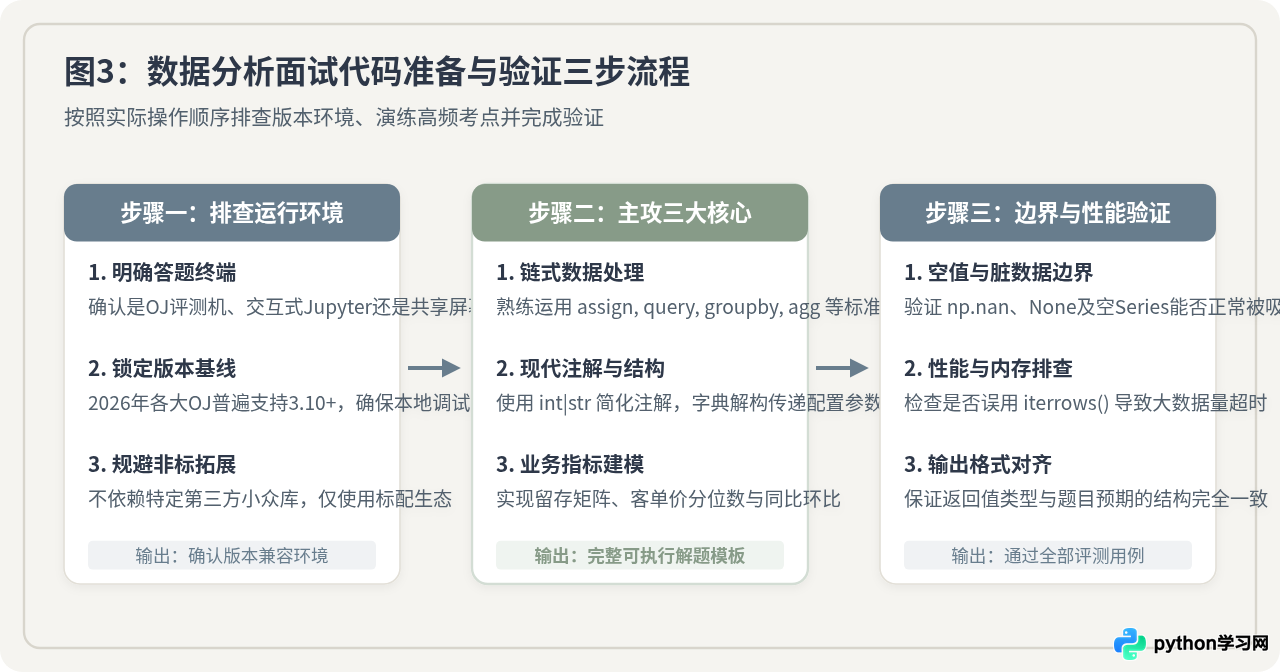
步骤一:确认答题环境与版本基线
在收到面试通知后,首先确认考核形式:
- 平台 OJ 模式:查看邮件中给出的平台链接(如牛客、LeetCode 等)。在个人练习界面提交一行简单的
import sys; print(sys.version),确认其运行的 Python 大版本通常在 3.10 至 3.12 之间,确保本地运行环境与之对齐。 - 在线 Jupyter 协作模式:如果面试提供共享的云端 Notebook 链接,提前测试其支持的 Pandas、NumPy 版本,重点避免使用已弃用(Deprecated)的旧 API,例如早期的
df.append()(在 Pandas 2.0+ 中已被移除,应改用pd.concat)。
步骤二:主攻三大高频核心能力
将 80% 的练习时间分配在以下三大高频题型上:
- 数据重塑与分组聚合:透视表
pivot_table、宽长表转换melt、多级索引处理以及各类窗口聚合(滚动平均、累计求和)。 - 时序与文本处理:日期跨度计算、工作日过滤、正则表达式提取结构化指标。
- 业务模型推导:RFM 用户价值分群、漏斗转化各环节流失率、营销活动 ROI 归因。
步骤三:真机编码与边界测试验证
写完解答函数后,不要立即提交,必须自行设计两到三组边界测试用例进行防御性验证:
- 空数据与全 NaN 边界:验证当传入空 DataFrame 或某一列全为空值时,函数是否会崩溃抛出未捕获的 KeyError 或 ZeroDivisionError。
- 数据类型突变:当数据中夹杂非预期类型(如原本应为数字的列包含字符串
"N/A"或"-")时,检查清洗逻辑是否具备容错转换。
五、常见认知误区与避坑指南
在面试复习中,有几个经常被提及的疑虑,可以通过以下准则明确应对:
- “面试官会因为我没用 match-case 而扣分吗?”
答案是完全不会。结构化模式匹配主要用于复杂的结构解构与编译器状态机开发,在以表格统计为主要场景的数据分析中,清晰的条件字典(dict.get)或矢量化掩码过滤更加直观、运行速度更快,也是资深分析师公认的规范写法。 - “在 3.10 的底座环境下,还能使用旧语法吗?”
Python 具备极强的向后兼容性。即便你习惯了传统的typing.Union[int, float]或常规的if-elif-else,在 Python 3.10 及更高版本中完全可以正常运行并得到满分。现代语法能让代码更加清爽,但并不会单纯因为使用了旧写法而导致功能错误。 - “面试时需要关注 Python 解释器的执行速度吗?”
需要关注的是算法的时间复杂度与数据处理的矢量化,而不是语言本身的解释开销。若在百万级数据分析题中采用纯 Pythonfor循环逐行累加,必然会导致评测超时;此时改用 NumPy/Pandas 的底层 C/C++ 矢量实现才是正确的解题路径。
六、总结与复习决策速查
综上所述,2026年数据分析面试对 Python 3.10 的态度是:它是无须刻意讨论但默认适用的基础设施。求职者无需将精力分散在对版本专有语法特性的死记硬背上,而应将全部力量倾注在 SQL 核心取数、Pandas 核心数据操作与业务分析思维的打磨上。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









