

怎么用Python正则表达式提取所有匹配结果及分组内容
本文详细讲解如何使用Python的re模块提取字符串中所有匹配结果及分组内容,深入对比re.findall与re.finditer的机制差异、常见陷阱与最佳实践。
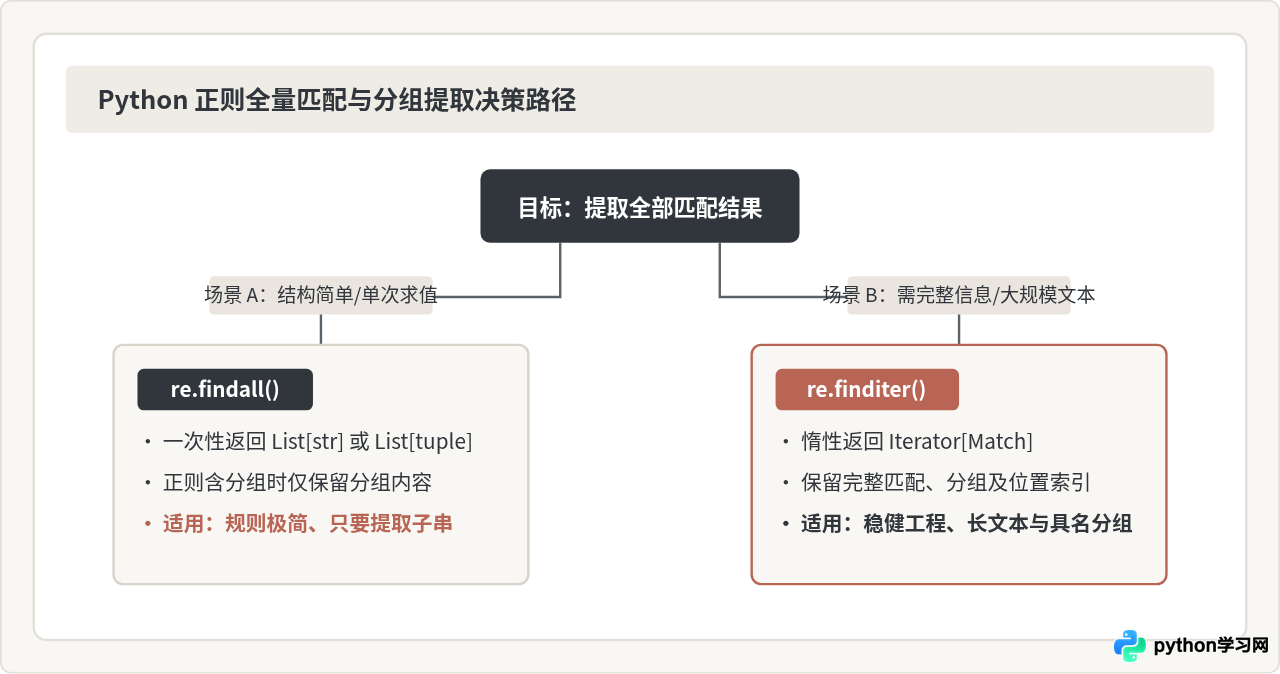
在 Python 中提取字符串里所有符合正则规则的内容并获取括号分组数据,核心依靠标准库 re 中的 re.findall() 和 re.finditer() 两个函数。如果只需要快速获取无分组或纯元组格式的分组字符串,使用 re.findall() 最省代码;如果需要同时保留完整匹配串、提取位置坐标、命名分组或处理海量文本,re.finditer() 则是结构更清晰且内存更安全的选择。
一、提取全量匹配与分组的核心工具选型
很多开发者在初次尝试从文本中提取多个匹配结果时,容易直接调用 re.search() 或 re.match()。这两个函数在找到第一个匹配后就会停止扫描,无法满足“提取所有”的需求。要想提取整个字符串中所有匹配项,必须转向 re.findall() 或 re.finditer()。
但在引入捕获分组(即正则表达式中的圆括号 ())后,这两个函数的处理逻辑产生了明显分歧:
re.findall(pattern, string):直接返回一个 Python 列表(List)。没有分组时列表中是纯字符串;一旦出现捕获分组,返回值会变成仅包含分组内容的元组(Tuple)列表,原始的完整匹配文本反而会被隐式丢弃。re.finditer(pattern, string):返回一个惰性可迭代对象(Iterator),每次迭代产出一个re.Match对象。该对象不仅保留了完整的匹配文本,还允许通过索引或名字自由提取任意分组,并附带起止位置索引(Span)。
二、使用 re.findall() 提取及其分组陷阱
re.findall() 的语法非常直观:传入模式和待匹配文本,它会扫描整个字符串,按从左到右的顺序收集非重叠的匹配项。然而,它的返回格式完全取决于正则表达式中是否书写了圆括号 ()。
1. 无分组模式:获取所有完整匹配
当正则表达式中没有任何圆括号捕获组时,re.findall() 的输出最符合直觉——它返回一个由所有匹配文本构成的字符串列表:
import re

text = "apple: $12, banana: $8, orange: $15"
# 提取所有价格标签(包含美元符号和数字)
matches = re.findall(r"\$\d+", text)

print(matches)
# 示例输出: ['$12', '$8', '$15']
2. 包含分组时的行为突变
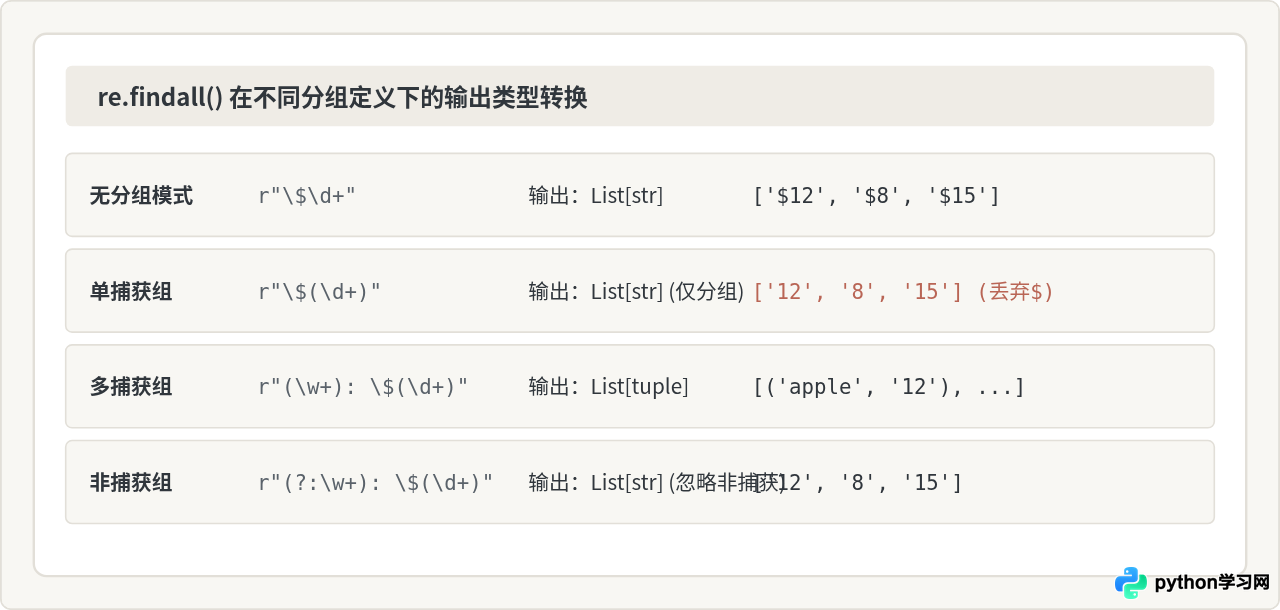
如果希望在提取价格的同时把纯数字分离出来,初学者往往会自然地写下 r"(\$)(\d+)" 或 r"\$(\d+)"。此时 re.findall() 的输出规则将发生突变:
- 恰好一个分组:返回仅包含该分组捕获文本的字符串列表,不再返回外层完整匹配。
- 两个或更多分组:返回元组列表,每个元组的元素按圆括号从左到右的顺序排列。
import re

text = "apple: $12, banana: $8, orange: $15"

# 情况一:单个分组,只想提取数字部分
single_group = re.findall(r"\$(\d+)", text)
print(single_group)
# 示例输出: ['12', '8', '15']

# 情况二:多个分组,分别提取品名与价格
multi_group = re.findall(r"(\w+):\s*\$(\d+)", text)
print(multi_group)
# 示例输出: [('apple', '12'), ('banana', '8'), ('orange', '15')]
注意:如果你既想要整个 "apple: $12" 这段完整文本,又想要里面的品名和金额,直接用普通的 re.findall(r"(\w+):\s*\$(\d+)", text) 是拿不到完整文本的。解决方案要么给最外层再套一个大括号 r"((\w+):\s*\$(\d+))",让它成为第一个分组;要么直接改用后文讲解的 re.finditer()。
3. 非捕获分组 (?:...) 的妙用
有时我们在正则中使用括号仅仅是为了应用量词或限定作用域(例如匹配 (?:https?|ftp)),并不希望它被当作提取目标。此时必须使用非捕获分组语法 (?:...)。非捕获分组不会影响 re.findall() 的输出行为,Python 会视其为无分组规则处理。
import re

text = "http://example.com and https://test.org"
# 使用 (?:...) 组合协议头,但不作为分组截取
urls = re.findall(r"(?:https?|ftp)://\w+\.\w+", text)

print(urls)
# 示例输出: ['http://example.com', 'https://test.org']
三、使用 re.finditer() 稳健提取全部匹配与分组
相比于 re.findall() 的隐式转换,re.finditer() 是工程开发中最推荐的做法。它不会一次性把所有结果压入内存列表,而是返回一个迭代器,循环中每个元素都是标准的 re.Match 实例。通过该实例,我们可以完全掌控数据的各个维度。
1. 核心方法详解
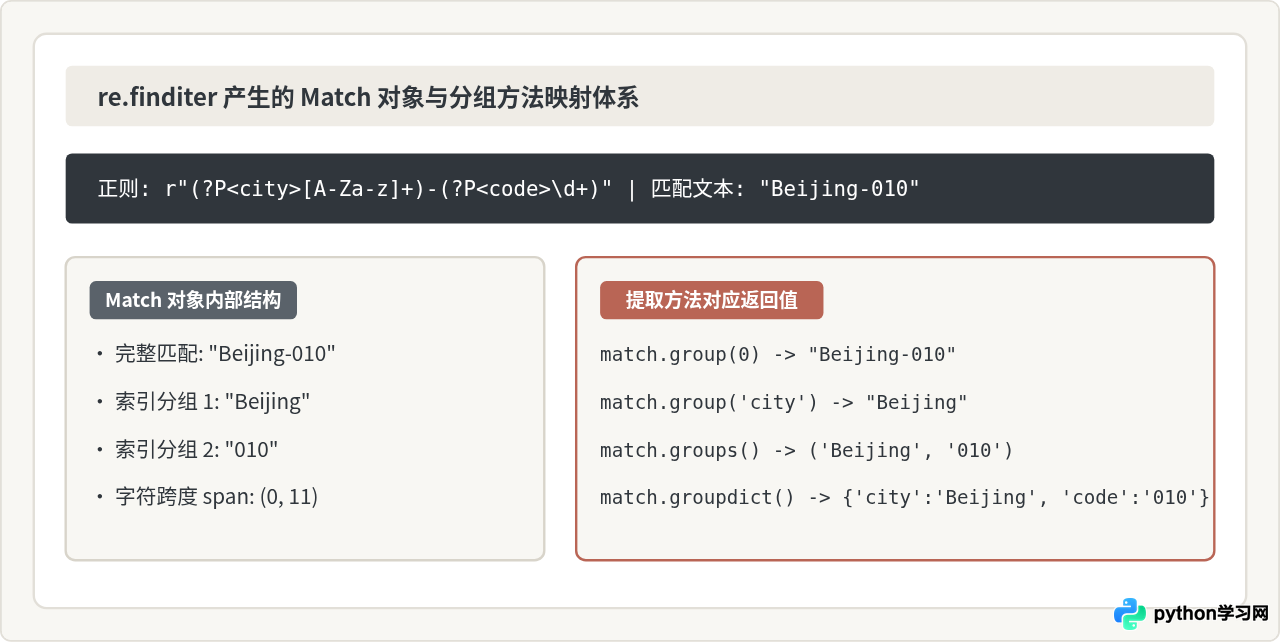
在每次循环拿到的 match 对象上,可以调用以下核心方法:
match.group(0)或match.group():获取本次匹配的完整原始字符串。match.group(N):获取第N个括号捕获的内容(从 1 开始编号)。match.groups():返回一个元组,按序包含该条匹配中的所有分组;如果某个可选分组未匹配到,则填充为None。match.span()/match.start()/match.end():获取匹配项在原字符串中的字符起止下标。
import re

raw_log = "2026-10-24 [INFO] User login success; 2026-10-24 [ERROR] File not found"
pattern = r"(\d{4}-\d{2}-\d{2})\s+\[([A-Z]+)\]\s+([^;]+)"

for match in re.finditer(pattern, raw_log):
    full_text = match.group(0)     # 完整匹配
    date_str  = match.group(1)     # 第1个分组
    level     = match.group(2)     # 第2个分组
    msg       = match.group(3)     # 第3个分组
    start_pos, end_pos = match.span()

    print(f"位置 [{start_pos}:{end_pos}] 级别: {level} | 日期: {date_str} | 消息: {msg}")

# 示例输出:
# 位置 [0:37] 级别: INFO | 日期: 2026-10-24 | 消息: User login success
# 位置 [39:75] 级别: ERROR | 日期: 2026-10-24 | 消息: File not found
2. 具名分组(Named Groups)与 groupdict()
当正则规则较长或分组超过 3 个时,纯数字索引(1, 2, 3)的可读性和可维护性会急剧下降,稍微调整表达式的括号顺序就会导致代码提取错位。此时应使用具名捕获分组,语法为 (?P<name>pattern)。
配合 match.groupdict(),每条匹配项可以直接转化为标准 Python 字典:
import re

content = """
item: Laptop, price: 5499, stock: 12
item: Mouse, price: 89, stock: 450
item: Keyboard, price: 299, stock: 0
"""

pattern = r"item:\s*(?P<name>\w+),\s*price:\s*(?P<price>\d+),\s*stock:\s*(?P<qty>\d+)"

records = []
for m in re.finditer(pattern, content):
    data = m.groupdict()
    # 转换为指定业务数据类型
    records.append({
        "name": data["name"],
        "price": float(data["price"]),
        "qty": int(data["qty"])
    })

print(records)
# 示例输出:
# [
#   {'name': 'Laptop', 'price': 5499.0, 'qty': 12},
#   {'name': 'Mouse', 'price': 89.0, 'qty': 450},
#   {'name': 'Keyboard', 'price': 299.0, 'qty': 0}
# ]
四、复合场景下的关键处理技巧
1. 预编译模式提升循环提取效率
如果在批处理任务或大型日志分析中频繁提取匹配,切忌在每次循环内直接调用 re.findall() 或 re.finditer()。应预先通过 re.compile() 将正则表达式编译为正则对象(Pattern Object),这能减少重复解析正则语法树的开销:
import re

# 提前编译正则,并附带忽略大小写标志
pattern = re.compile(r"ID-(?P<id>\d{5})", re.IGNORECASE)

lines = [
    "user id-10023 login",
    "guest ID-99882 logout",
    "admin Id-00001 update"
]

all_ids = []
for line in lines:
    for m in pattern.finditer(line):
        all_ids.append(m.group("id"))

print(all_ids)
# 示例输出: ['10023', '99882', '00001']
2. 可选分组的处理机制
在实际业务中,部分数据字段是可选的(例如电话号码可能包含分机号,也可能不包含)。使用 (?P<ext>\d+)? 时,若未匹配到该部分,group() 会返回 None 而不是空字符串,在组装数据时需妥善防御:
import re

data = "Tel: 010-88889999 ext 102; Tel: 021-66667777"
pattern = r"Tel:\s*(?P<phone>\d{3}-\d{8})(?:\s+ext\s+(?P<ext>\d+))?"

for m in re.finditer(pattern, data):
    phone = m.group("phone")
    ext = m.group("ext")  # 未匹配时返回 None
    print(f"电话: {phone}, 分机: {ext if ext is not None else '无'}")

# 示例输出:
# 电话: 010-88889999, 分机: 102
# 电话: 021-66667777, 分机: 无
五、常见问题排查与避坑清单
- 嵌套括号的编号顺序容易混淆:
如果正则表达式中存在括号嵌套,例如r"((A)(B))",分组编号永远严格按照左括号(从左到右出现的先后顺序决定:group(1)是最外层的完整AB,group(2)是A,group(3)是B。 - 误将分组量词写在括号外导致丢失中间值:
如果模式写成r"(\d)+"去匹配"123",捕获分组只保存最后一次迭代的值'3',前面的'1'和'2'会被覆盖。若要提取一整串数字,应将量词放进括号内:r"(\d+)"。 - findall 结果中完整匹配“失踪”:
如前文所述,一旦引入捕获括号,findall就不再返回整体字符串。若必须使用findall且需要整体字符串,请为整个模式最外层加上大括号,或者全量改用re.finditer()。 - 贪婪模式导致分组捕获过多内容:
默认情况下.*会尽可能向后吞噬字符,常常导致中间分组跨越了预期边界。例如提取 HTML 标签内文本时,请务必使用非贪婪量词.*?。
六、两种提取方式全维度对比总结
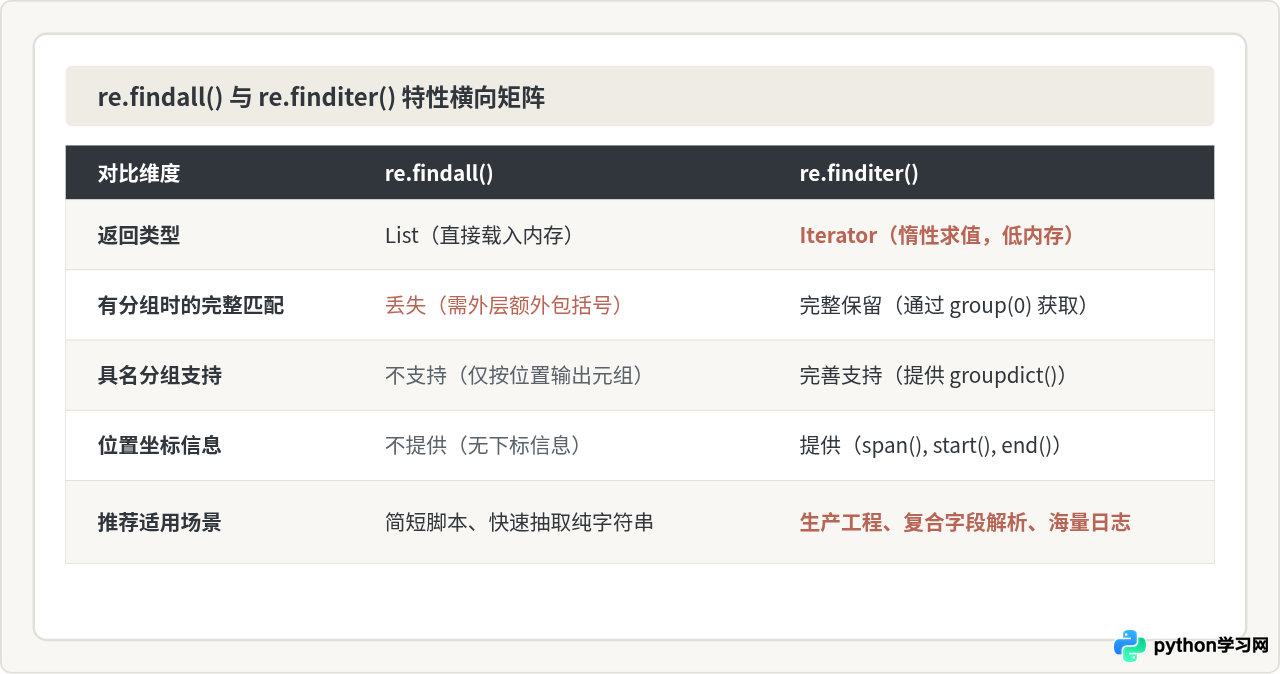
综上所述,在 Python 正则表达式实践中,处理无捕获分组的简单字符串提取时,re.findall() 能带来最短的代码行数;而在涉及分组捕获、具名提取以及要求高健壮性的工业级场景中,始终优先使用 re.finditer() 能够彻底规避结构突变与内存峰值风险。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









