

Python for循环基础语法:遍历列表、字典与字符串
深入浅出讲解Python for循环的基础语法与运行机制,涵盖列表、字典与字符串的三种核心遍历方式,配合enumerate与items解包技巧,以及避坑指南与总结矩阵。
在 Python 编程中,for 循环是最基本、使用频次最高的流程控制结构之一。与 C/Java 等语言中依赖索引计数器(如 for (int i=0; i<n; i++))不同,Python 的 for 循环本质上是一个“迭代器遍历器”。它直接作用于可迭代对象(Iterable),无论对象是序列还是映射,都能以清晰、直观的语法逐项提取元素。本文将详细讲解 Python 中最常用的三种容器与序列——列表(List)、字典(Dictionary)与字符串(String)的基础遍历语法、执行机理及典型应用,帮助读者建立系统、规范的循环认知。
一、for循环核心语法与底层执行逻辑
Python 中 for 循环的基本语法由 for、in 关键字以及缩进的代码块组成:
for 目标变量 in 可迭代对象:
    # 每次迭代执行的具体操作
    执行语句
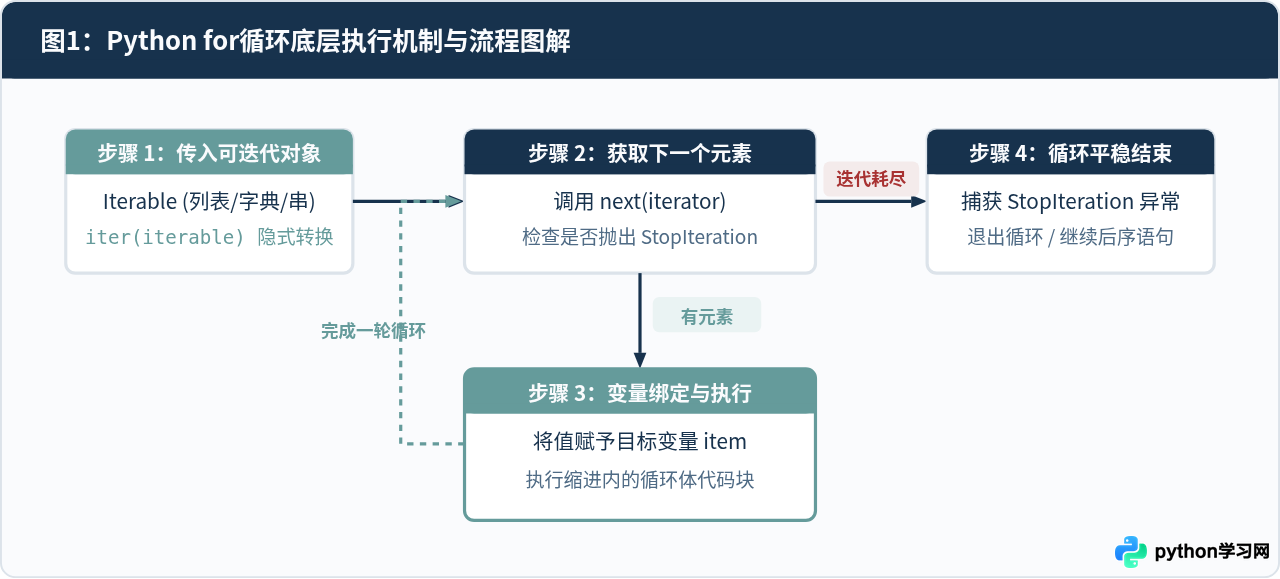
这里的“可迭代对象”是指任何实现了 __iter__() 方法或序列协议的对象。在循环开始前,Python 会在后台自动调用 iter() 函数获取该对象的迭代器;随后,每次循环都会调用迭代器的 next() 方法,将取出的下一个值赋给目标变量,并执行循环体。当所有元素耗尽时,迭代器会抛出 StopIteration 异常,Python 的 for 循环会自动捕获该异常并平稳退出循环。整个过程对开发者完全透明,既保证了语法的简洁,又避免了手动维护索引计数器可能带来的越界风险。
二、遍历列表(List):直接访问与索引辅助
列表是 Python 中最常用的有序容器。在遍历列表时,主要有两种场景:只需访问元素内容,或者既需要访问元素又需要获得当前元素在列表中的序号。
1. 直接遍历元素
如果业务逻辑只需要读取列表里的每个数据项,直接将列表置于 in 之后是最简洁的写法:
fruits = ["苹果", "香蕉", "西瓜"]

for fruit in fruits:
print(f"当前水果名称:{fruit}")当前水果名称:香蕉
当前水果名称:西瓜
2. 使用 enumerate() 同步获取索引
许多初学者习惯写 for i in range(len(fruits)): 来通过下标索引元素,这种写法在 Python 中并不推崇,因为其代码冗长且降低了可读性。Python 提供了内置函数 enumerate(),它会将可迭代对象包装为一个每次生成 (索引, 元素) 元组的迭代器:
fruits = ["苹果", "香蕉", "西瓜"]

# start 参数可指定起始索引,默认为 0
for index, fruit in enumerate(fruits, start=1):
print(f"序号 {index} -> {fruit}")序号 2 -> 香蕉
序号 3 -> 西瓜
三、遍历字符串(String):按字符展开
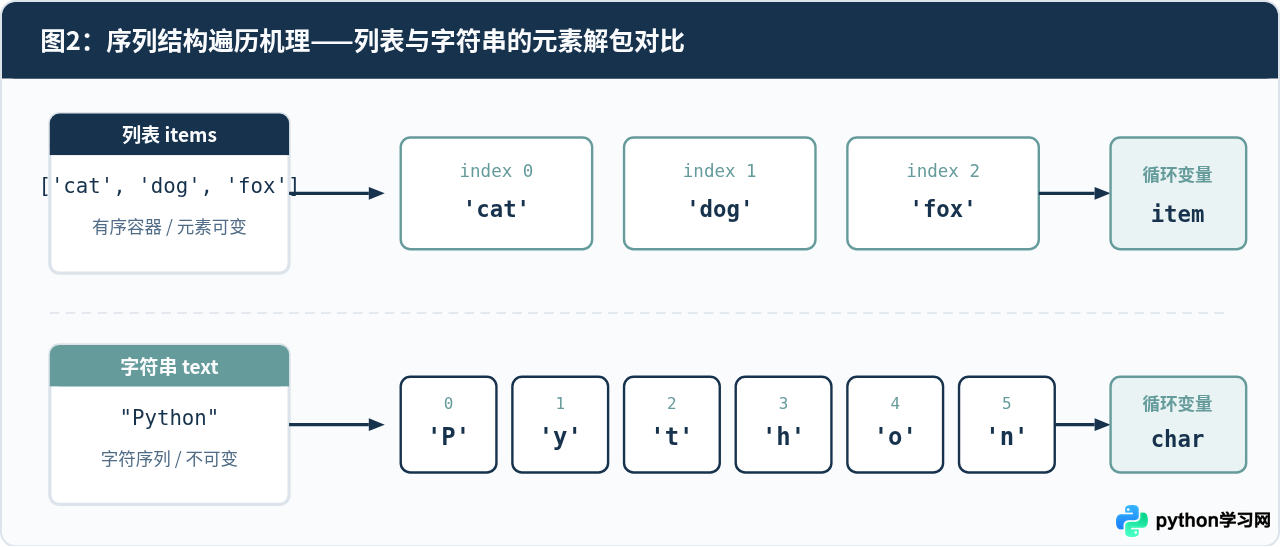
在 Python 中,字符串也是一种内置的序列类型(Sequence)。因此,对字符串执行 for 循环时,迭代器会把字符串按照字符位置依次解开,每次循环得到一个长度为 1 的单个字符(在 Python 中没有专门的 char 类型,单个字符仍然是 str 类型)。
language = "Python"

for char in language:
print(f"字符: {char} (ASCII码: {ord(char)})")字符: y (ASCII码: 121)
字符: t (ASCII码: 116)
字符: h (ASCII码: 104)
字符: o (ASCII码: 111)
字符: n (ASCII码: 110)
遍历字符串常用于字符统计、数据过滤、密码规则校验等场景。下图对比了列表与字符串在内存中元素解包遍历的结构差异:
四、遍历字典(Dictionary):键、值与项的三种姿态
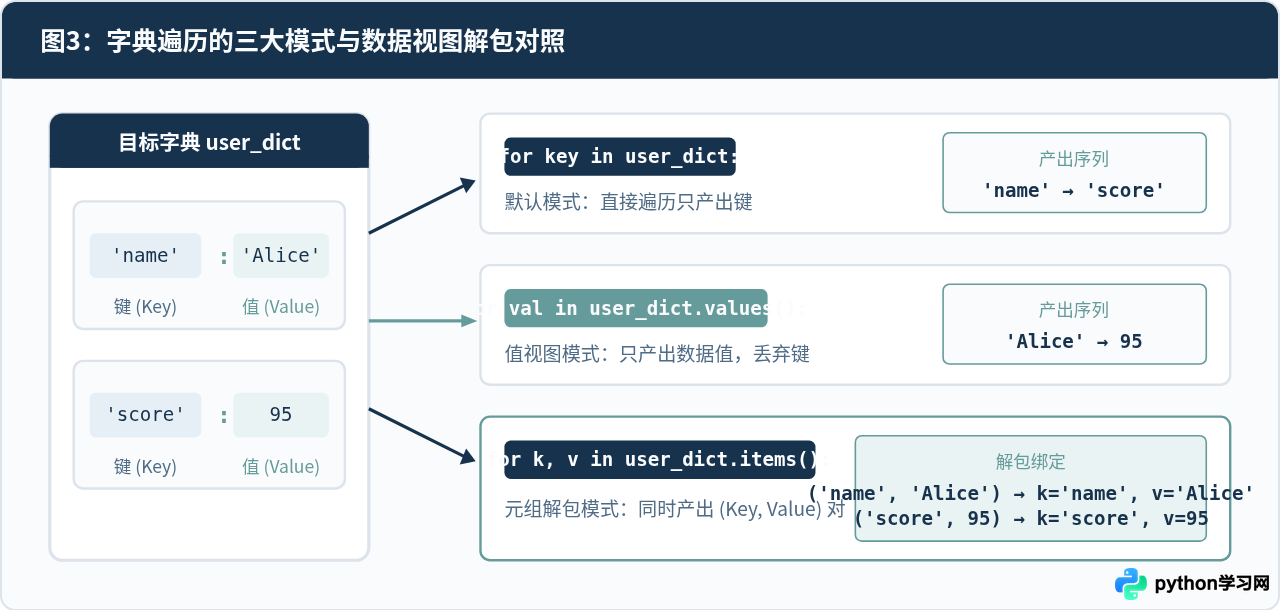
字典是键值对(Key-Value)映射容器。由于字典包含两组紧密关联但维度不同的数据,Python 提供了三种内置视图方法来满足不同的遍历诉求。
1. 默认遍历:直接获取键(Keys)
如果直接将字典传递给 for key in my_dict:,Python 默认只会迭代字典的所有键(Keys),等同于调用 my_dict.keys():
user_profile = {"name": "张伟", "role": "工程师", "city": "北京"}

for key in user_profile:
    # 可以在循环体内部通过字典下标取值
print(f"键: {key} -> 值: {user_profile[key]}")键: role -> 值: 工程师
键: city -> 值: 北京
2. 值视图遍历:只关心数据(Values)
在只需统计、汇总或筛选数据值而完全不需要使用键的场景下,可以调用 .values() 方法:
scores = {"语文": 88, "数学": 95, "英语": 91}

total = 0
for score in scores.values():
    total += score

print(f"总分为: {total}")3. 项视图遍历:同时解包键与值(Items)
当需要同时处理键和对应的值时,最地道、最高效的做法是使用 .items()。该方法每次迭代产出一个形如 (key, value) 的元组,配合 Python 的多变量解包语法,可以直接在 for 后声明两个变量接收:
user_profile = {"name": "张伟", "role": "工程师", "city": "北京"}

for key, val in user_profile.items():
print(f"属性 [{key}] 的设定值为: {val}")属性 [role] 的设定值为: 工程师
属性 [city] 的设定值为: 北京
五、实战常见错误与防坑指南
在实际编写 for 循环时,有三个最容易发生逻辑缺陷甚至运行时崩溃的陷阱需要特别警惕:
在遍历列表时直接调用 remove() 或 del,会导致底层索引偏移,造成元素“漏检跳过”;而在遍历字典时直接调用 pop() 或添加新键,Python 解释器会直接抛出严重异常:RuntimeError: dictionary changed size during iteration。
安全解法:遍历原容器的浅拷贝切片 for item in my_list[:]:,或者遍历字典键的列表镜像 for k in list(my_dict.keys()):;更优雅的方式是使用列表推导式构建新对象。
当遍历包含元组或列表的嵌套序列时,左侧声明的变量数量必须与单次迭代产出的元素个数严格一致。若元素只包含一个值却写了两个变量,会报错 ValueError: not enough values to unpack;反之则报错 ValueError: too many values to unpack。
与 C/Java 等块级作用域语言不同,Python 中的 for 循环变量在循环结束后不会被销毁,其仍保留在当前函数或全局作用域中,并维持最后一次迭代的值。如果循环后继续使用同名变量,可能会引发意料之外的逻辑覆盖。
六、遍历语法全景决策与最佳实践总结
为了在开发中迅速选择最合适的遍历模式,下表总结了列表、字符串与字典各遍历写法的特性与典型场景:
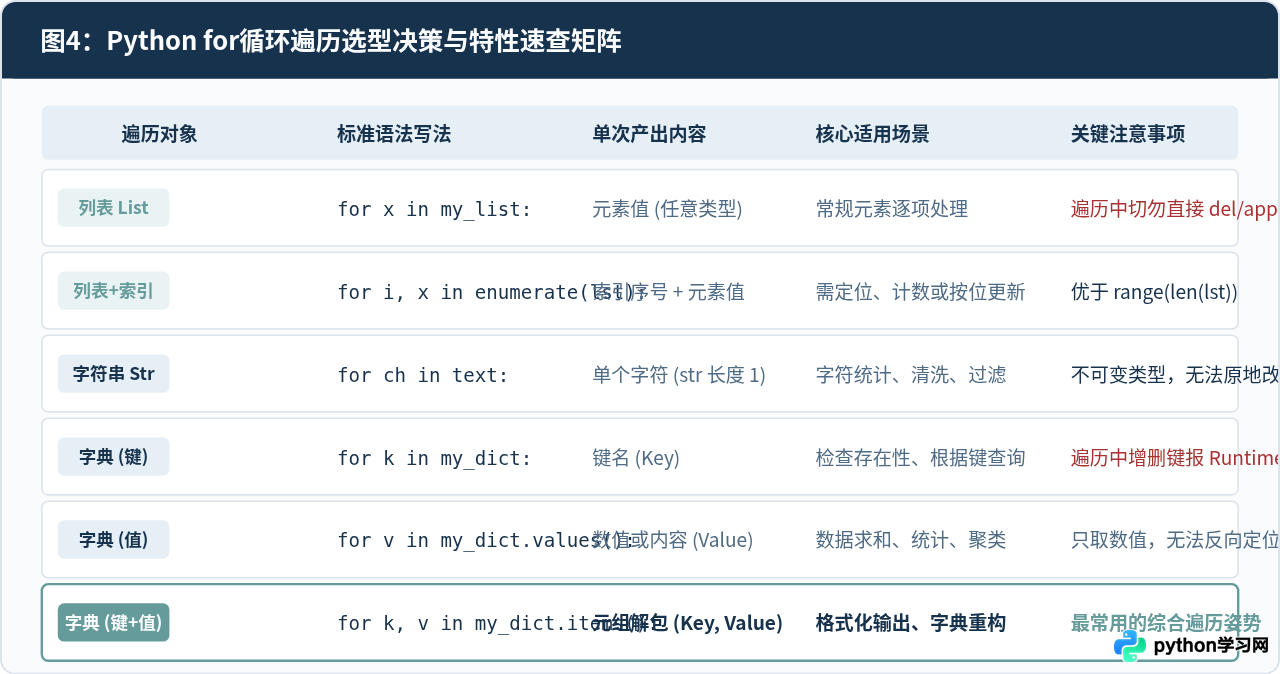
掌握 Python for 循环的关键,在于理解“按元素迭代”的哲学:针对列表,优先直取元素,需索引时搭配 enumerate();针对字符串,直接逐字符展开;针对字典,根据需求选用直接遍历(键)、.values()(值)或 .items()(键值对)。养成避免在循环体中就地改变容器尺寸的习惯,就能写出高效、优雅且不易出错的 Pythonic 代码。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









