

Python怎么避免循环导入错误?使用importlib动态导入技巧
深入解析Python循环导入(Circular Import)错误的本质原因,并详细介绍如何通过importlib.import_module实现动态延迟导入与模块解耦。
在 Python 开发过程中,当两个或多个模块在顶层相互引用对方的成员时,解释器常会抛出类似 ImportError: cannot import name 'xxx' from partially initialized module 的循环导入异常。解决该问题的根本思路是打破模块加载阶段的初始化死锁,而使用 Python 标准库中的 importlib.import_module() 进行动态延迟导入,是一种无须大规模重构目录层级、能在运行时安全获取依赖的实用技巧。本文将从底层机制出发,详细讲解循环导入发生的原因、常见误区,并通过具体代码演示如何利用 importlib 优雅解耦。
一、循环导入的本质与报错触发机制
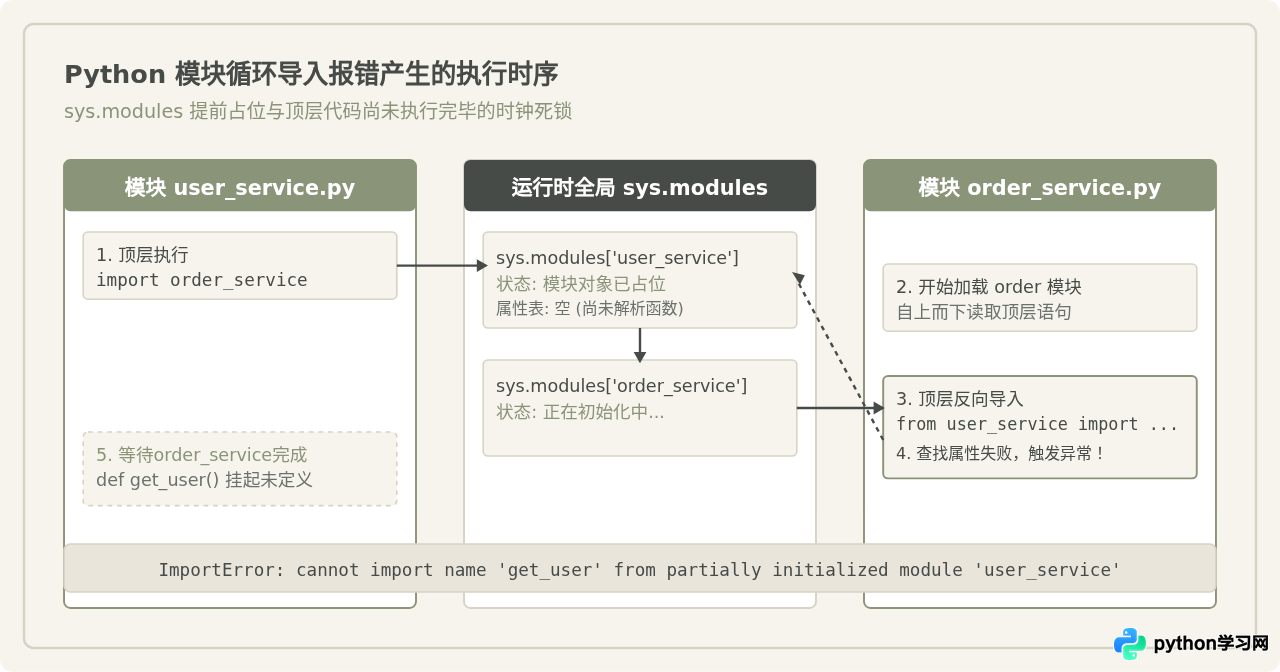
要彻底避免循环导入,首先要明白 Python 是如何加载一个模块的。Python 在首次执行 import foo 时,主要经历以下关键步骤:
- 检查内置缓存字典
sys.modules,看目标模块是否已被加载。 - 若未加载,创建一个全新的空模块对象,并将其写入
sys.modules['foo']占位。 - 按顺序自上而下逐行执行该模块文件中的全局代码,填充该模块对象的命名空间。
- 执行完毕后,模块初始化完成。
当存在双向依赖时,模块 A 在第 3 步执行过程中导入了模块 B;模块 B 随后又在自己的顶层代码中通过 from A import func_a 试图导入模块 A 的内容。此时 Python 检查 sys.modules,发现模块 A 已经在字典中(即第 2 步的占位对象),于是直接返回该对象。然而,此时模块 A 仍停留在第 3 步中途,func_a 尚未被解释器执行和定义。此时 Python 就会报错:无法从“部分初始化的模块(partially initialized module)”中导入属性。
二、容易混淆的说法:在函数内部普通 import 就足够了吗?
面对循环导入,许多开发者的第一反应是:“把顶层的 import 移到调用它的函数内部,不就延后执行了吗?”
这种说法看似合理,且在许多简单脚本中确实能解决问题,但它存在适用边界和潜在隐患:
- 它成立的前提:被延迟导入的模块仅仅在函数被调用时才会被执行,从而避开了 Python 启动初期的顶层加载顺序冲突。
- 它不足的原因:在代码规范(如 PEP 8)中,所有
import原则上都应统一置于文件顶部。在函数体内随意散落局部import会导致代码可读性急剧下降,给后续维护者排查依赖带来困扰。 - 容易被代码格式化工具破坏:许多团队在持续集成中使用
isort、autopep8或ruff等自动化工具,这些工具默认可能将函数内的局部导入误识别或重新提升到顶部,导致循环导入在重新格式化后再次复发。
因此,对于复杂的系统架构,或者需要动态路由、插件扩展、反射加载的模块调用,使用显式的 importlib.import_module() 是更加严谨、意图明确且不易被静态格式化工具意外修改的工程解法。
三、实战操作:使用 importlib 动态解耦的步骤
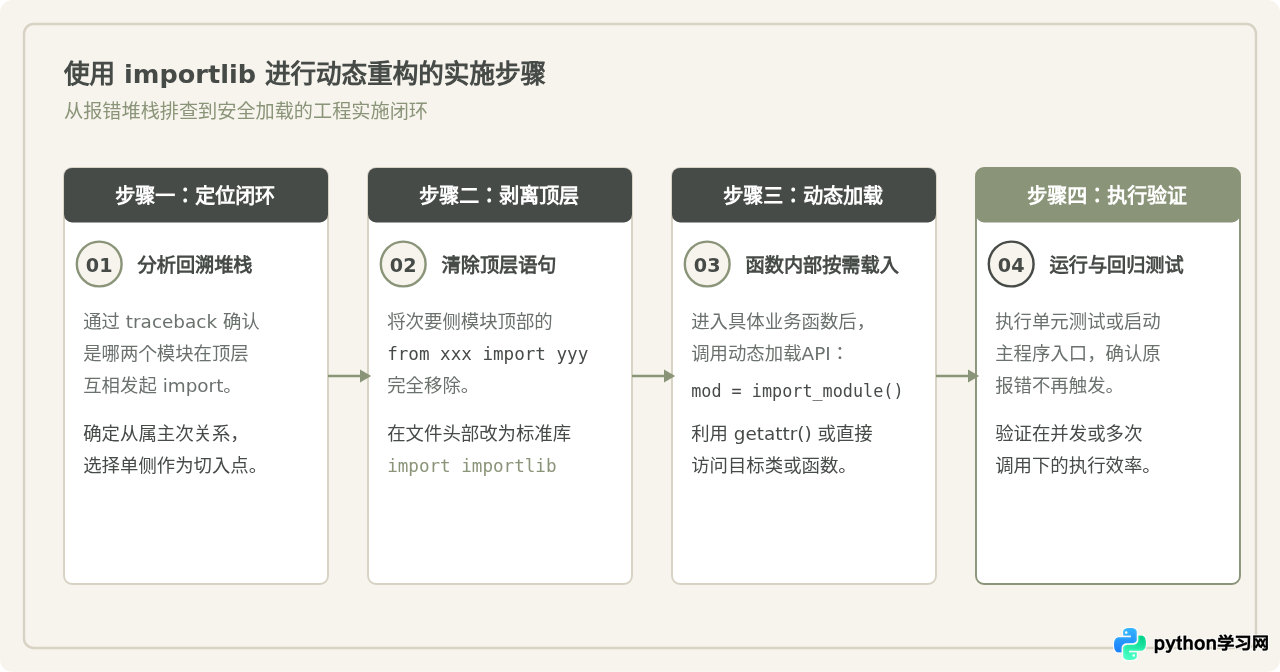
使用 importlib 解决循环依赖的核心流程可以分为四步:明确调用时机、替换静态导入、在运行时获取对象、加入容错与缓存管理。
1. 问题场景:两个互相调用的业务服务
假设我们有两个服务文件 user_service.py 与 order_service.py。用户服务需要查询该用户的订单详情,而订单服务在结算时又需要验证用户信用状态。
发生错误的原始代码:
# user_service.py
from order_service import get_orders_by_user_id  # 顶层导入

def get_user_profile(user_id: int) -> dict:
    orders = get_orders_by_user_id(user_id)
    return {"user_id": user_id, "name": "Alice", "orders": orders}

def is_user_valid(user_id: int) -> bool:
    return user_id > 0
# order_service.py
from user_service import is_user_valid # 顶层反向导入
def create_order(user_id: int, item_id: str) -> dict:
if not is_user_valid(user_id):
raise ValueError("Invalid user")
return {"order_id": "ORD-1001", "user_id": user_id, "item": item_id}
def get_orders_by_user_id(user_id: int) -> list:
return [{"order_id": "ORD-1001", "item": "Book"}]当执行 python -c "import user_service" 时,终端直接输出以下示例错误:
[示例终端输出]
Traceback (most recent call last):
  File "<string>", line 1, in <module>
  File "/project/user_service.py", line 1, in <module>
    from order_service import get_orders_by_user_id
  File "/project/order_service.py", line 1, in <module>
    from user_service import is_user_valid
ImportError: cannot import name 'is_user_valid' from partially initialized module 'user_service' (most likely due to a circular import)
2. 使用 importlib 改造后的方案
我们在 order_service.py 中保持顶层干净,导入标准库 importlib,将具体模块的解析推迟至 create_order 业务逻辑执行之时:
# order_service.py (重构后)
import importlib

def create_order(user_id: int, item_id: str) -> dict:
    # 动态加载 user_service 模块
    user_mod = importlib.import_module("user_service")
    is_valid_fn = getattr(user_mod, "is_user_valid")

    if not is_valid_fn(user_id):
        raise ValueError("Invalid user")
    return {"order_id": "ORD-1001", "user_id": user_id, "item": item_id}

def get_orders_by_user_id(user_id: int) -> list:
    return [{"order_id": "ORD-1001", "item": "Book"}]
重新执行入口调用,测试结果如下:
[示例终端输出]
$ python -c "import user_service; print(user_service.get_user_profile(101))"
{'user_id': 101, 'name': 'Alice', 'orders': [{'order_id': 'ORD-1001', 'item': 'Book'}]}
可以看到,双向调用的依赖死锁瞬间化解,整个模块初始化顺利完成。
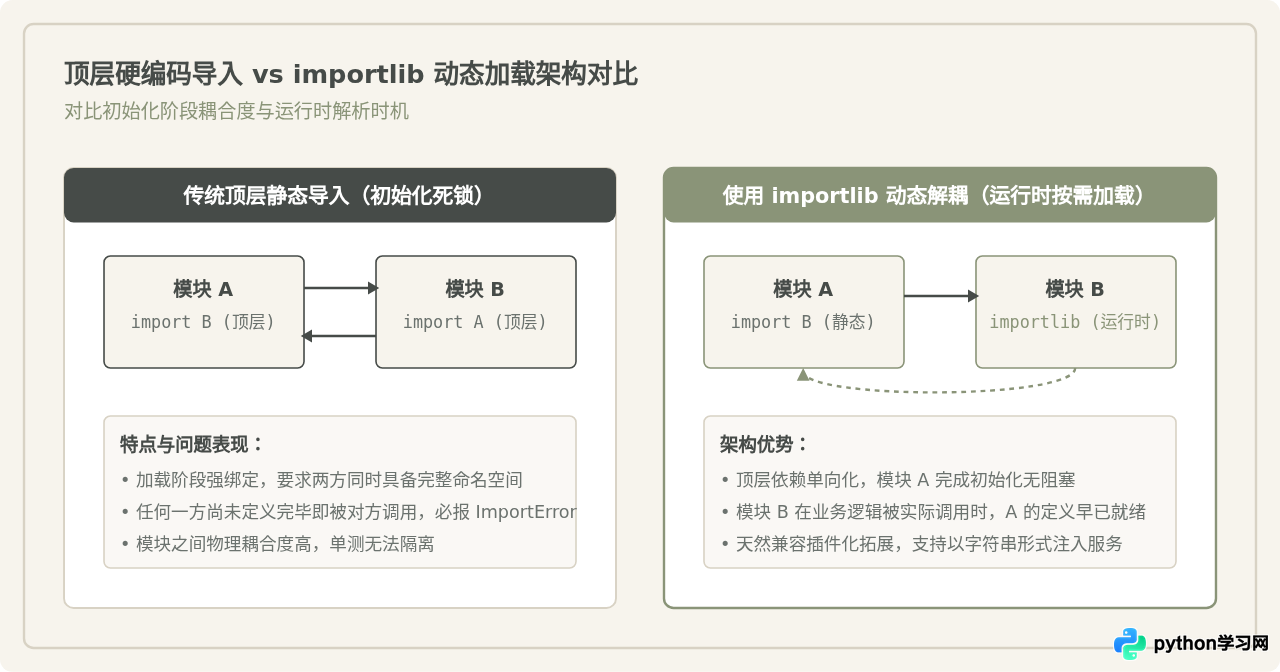
四、架构对比:顶层静态导入 vs importlib 动态解耦
为了直观展现差异,我们可以通过依赖结构图对比两种模式下的耦合关系:
五、importlib 动态导入的关键细节与注意事项
虽然 importlib.import_module() 能有效解决循环导入,但在实际工程中使用时,必须注意以下几点:
很多读者担心每次调用业务函数都执行
importlib.import_module() 会带来巨大的性能损耗。实际上,Python 内部通过 sys.modules 进行缓存。第一次动态导入后,后续调用 importlib.import_module() 本质上只是一次快速的字典哈希查找(时间复杂度为 O(1)),并不会重新读取磁盘或重复编译字节码。因此其开销极小,绝大多数业务场景下完全可以忽略。
因为模块名称传入的是字符串(如
"user_service"),IDE(如 PyCharm、VS Code)的静态重命名功能可能无法感知到该字符串引用。如果后续重命名了模块文件,可能在运行时才会抛出 ModuleNotFoundError。因此,建议:
- 为动态导入的模块定义常量或配置项,集中管理模块路径字符串。
- 配合全面的单元测试覆盖,确保动态导入路径在 CI 构建阶段得到检验。
如果在包(package)内部使用相对导入语法(如
..service.user),importlib.import_module 必须传入第二个参数 package,例如:
# 在包内部使用相对导入时
user_mod = importlib.import_module("..user_service", package=__name__)package 参数,将直接抛出 ValueError: relative import with no known parent package。
六、循环导入治理的综合决策建议
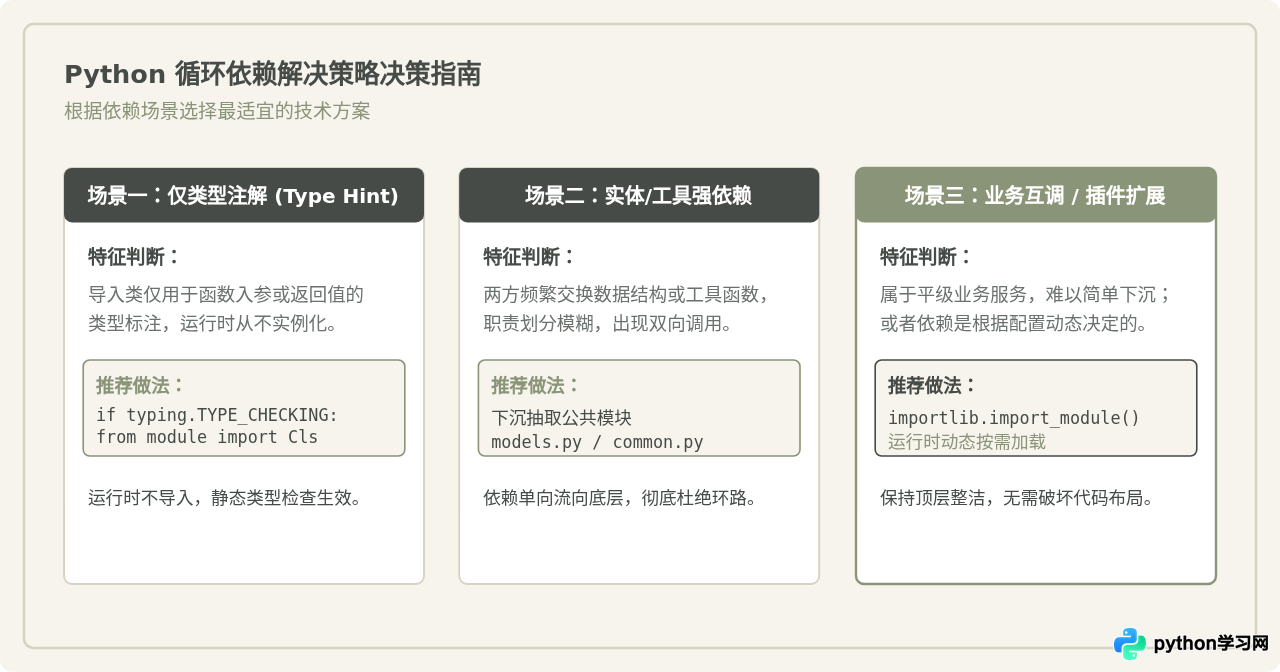
importlib 动态导入是解决循环依赖的一把利器,但在 Python 项目的整体架构设计中,面对循环依赖我们应根据具体场景选择成本最低、维护性最好的策略:
总结
Python 的循环导入错误本质上是解释器顶层执行时序与 sys.modules 未完成初始化的冲突。理解了这一底层机制,我们便可以在工程实践中有的放矢:
- 对于仅在类型检查时需要的类型,优先采用
typing.TYPE_CHECKING配合字符串注解进行隔离。 - 对于两个业务模块间深层次的相互依赖,优先考虑将共用数据结构抽象至独立的下层模块(如
common或models)。 - 对于难以拆分的业务互调、扩展插件或需要保持现有文件结构的场景,使用
importlib.import_module()在函数执行期动态加载是标准、可读且稳妥的解耦方案。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









