

面试问NumPy2.0类型提升规则变了怎么答?
针对面试中关于NumPy 2.0类型提升规则(NEP 50)变更的高频考点,本文系统梳理从核心定性、旧版痛点、黄金推导原则、代码实测对比到面试四步答题框架与工程迁移策略的完整解答方案。
一、核心定性:30秒说清 NumPy 2.0 到底改了什么
在面试中,面对考官抛出的这道问题,最忌讳的是先背诵琐碎的函数名变更或笼统回答“类型更严格了”。高水平的回答应该开门见山,用精准的规范术语完成核心定性:
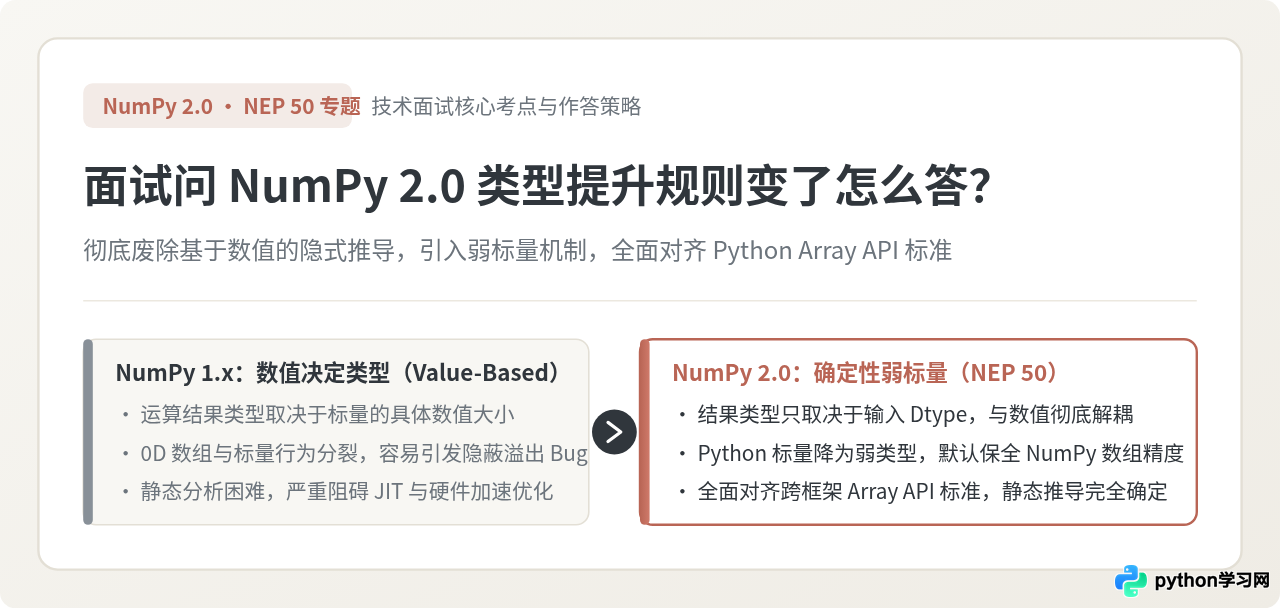
“NumPy 2.0 依据 NEP 50 提案,彻底废除了旧版本沿用多年的‘基于数值检查(Value-based Casting)’机制,改为只依赖操作数输入类型的‘确定性推导’,并将 Python 原生标量(int、float、complex)定义为弱类型标量,优先保全 NumPy 数组自身的精度,彻底解决了单精度被反向污染和运行时偶发溢出导致的类型漂移问题。”
这一定性概括了四个关键技术锚点:NEP 50、废除数值检查、弱标量保全精度以及静态确定性。考官听完这句话,就能立刻确认候选人真正读过官方规范,具备系统级的理解。
二、旧版痛点:NumPy 1.x 的类型提升为什么非改不可?
技术演进往往源于工程痛点。向面试官解释“为什么改”,是展现技术视野的最佳切入点。NumPy 1.x 的历史机制在过去的实际生产中埋下了三大隐患:
1. 数据依赖导致类型“薛定谔化”
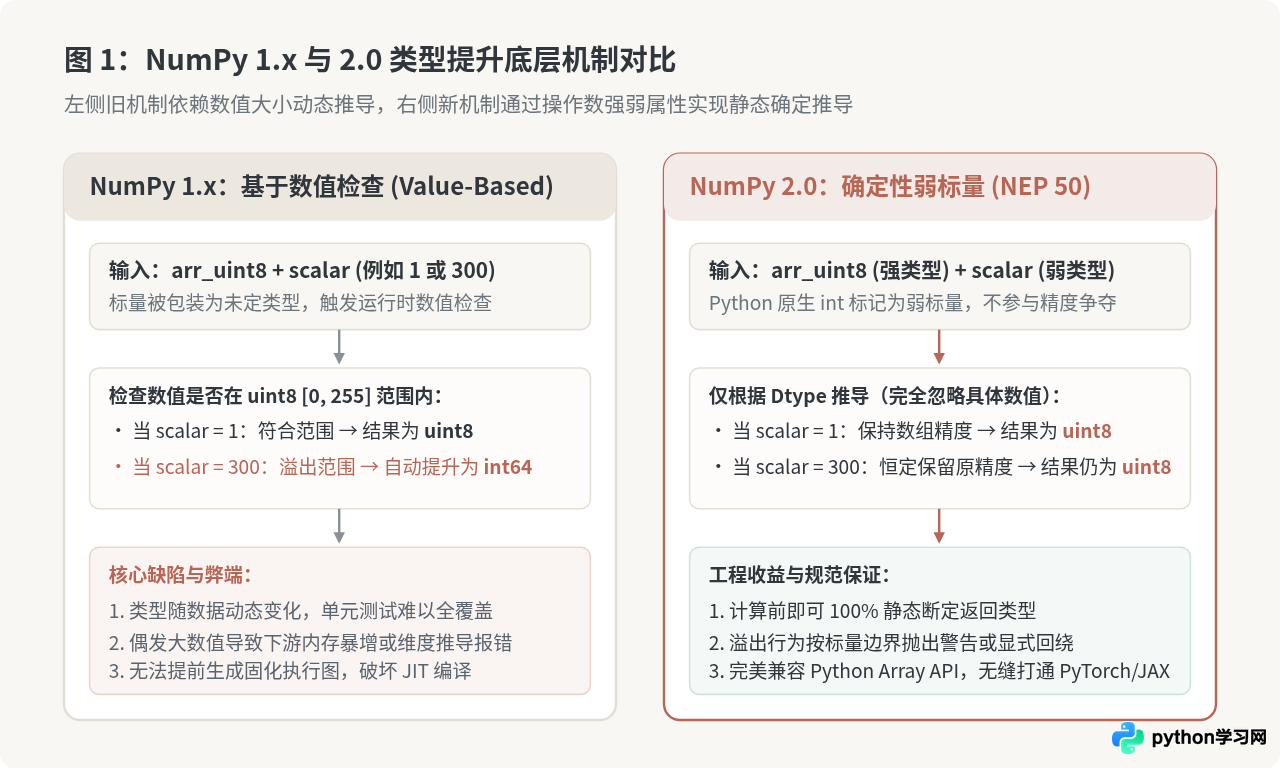
在 NumPy 1.x 中,运算结果的类型不仅取决于变量类型,还取决于标量具体的数值大小。例如:一个 uint8 类型的数组加上一个 Python 整数 1,结果依然是 uint8;但如果加上 300(超出了 uint8 的 0~255 表示范围),NumPy 1.x 就会在运行时偷偷将整个数组升级为 int16 或 int64。
这种设计初衷是“防止数值截断”,但在生产流水线中却是个灾难。单元测试阶段由于数值较小,类型保持正常;线上处理极端批次数据时,偶然出现的大数会使数组类型瞬间突变,导致内存占用翻倍,甚至使后续对数据类型有严格断言的下游算子直接报错崩溃。
2. 单精度浮点被双精度“霸道劫持”
在计算机图形学、音视频处理和深度学习领域,float32(单精度浮点)是降低显存与算力开销的行业标准。然而在 NumPy 1.x 下,执行标量运算 np.float32(1.5) + 2.0 时,由于 Python 原生的字面量 2.0 在 CPython 中默认是 64 位双精度浮点,NumPy 1.x 会直接将单精度结果强制推升至 float64,使得工程师精心优化的单精度管线功亏一篑。
3. 扼杀现代 JIT 编译与异构加速
以 Numba、JAX、PyTorch 等为代表的现代高性能编译引擎,依赖静态分析构建计算图并生成 SIMD/GPU 汇编指令。如果一个算子的输出类型必须等读取到具体数值之后才能确认,静态类型推断就彻底失效了。为了统一现代数据科学跨框架生态,Python Array API 标准将“类型推导必须纯粹基于输入 Dtype,禁止检查数值”列为核心硬指标。
三、核心规则拆解:掌握 NEP 50 的三大推导法则
面试中深入阐述细节时,可以围绕 NEP 50 确立的三条核心推导法则展开:
法则一:纯类型推导(Type-Only Promotion)
运算结果的数据类型只取决于输入操作数的数据类型,与输入数据的具体数值完全脱敏。无论你输入的是 1、300 还是 100000,只要参与运算的是 uint8 数组与 Python 整数标量,输出类型的判定逻辑是静态且唯一的。
法则二:Python 原生标量的弱类型机制(Weakly-Typed Scalars)
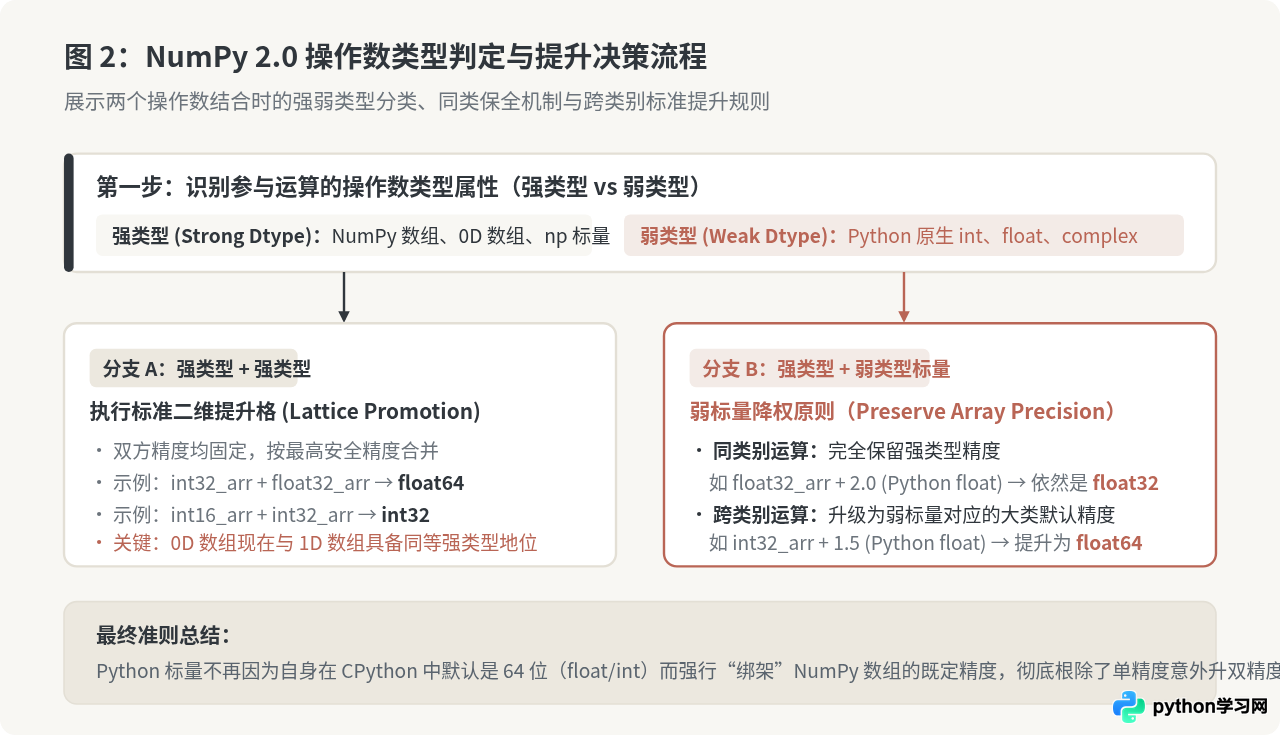
这是 NumPy 2.0 最精妙的设计:将 Python 原生的 int、float、complex 定义为弱类型(Weak Dtype),而 NumPy 自定义的数组、0 维数组及标量(如 np.uint8, np.float32)为强类型(Strong Dtype)。
- 同种类运算时,弱类型无条件服从强类型的精度:例如
float32数组加 Pythonfloat,弱标量自动降级为 32 位,运算结果严格保持为float32。 - 数值越界时尊重类型边界:当标量数值超出强类型数组边界时,NumPy 2.0 不再擅自升型,而是按照既定的整型溢出规则处理(如回绕并在特定配置下触发警告),从而确保类型的绝对稳定。
法则三:跨类别运算的标准提升(Cross-Kind Promotion)
当弱标量与不同种类的强类型数组结合时(例如整数数组与浮点弱标量相加),运算必然要升级到浮点种类。此时,NumPy 2.0 按照标准推导格,将其提升为该种类的默认标准精度(在 64 位系统下,整数升为浮点时提升为 float64)。
四、代码实证:4个经典场景的 1.x 与 2.0 行为对比
在面试中能够当场写出或准确说出几组简短精悍的对比代码,是技术扎实的有力证明。以下整理了 4 个具有代表性的典型场景:
场景 1:整型数组与超范围整型标量(数值越界不再隐式升型)
场景 2:单精度浮点与 Python 浮点标量(单精度不会被意外放大)
场景 3:整型数组与 Python 浮点标量(跨类别标准推导)
场景 4:0 维数组(0D Array)不再享有“特判特权”
五、现场作答攻略:面试官发问时的结构化四步表达
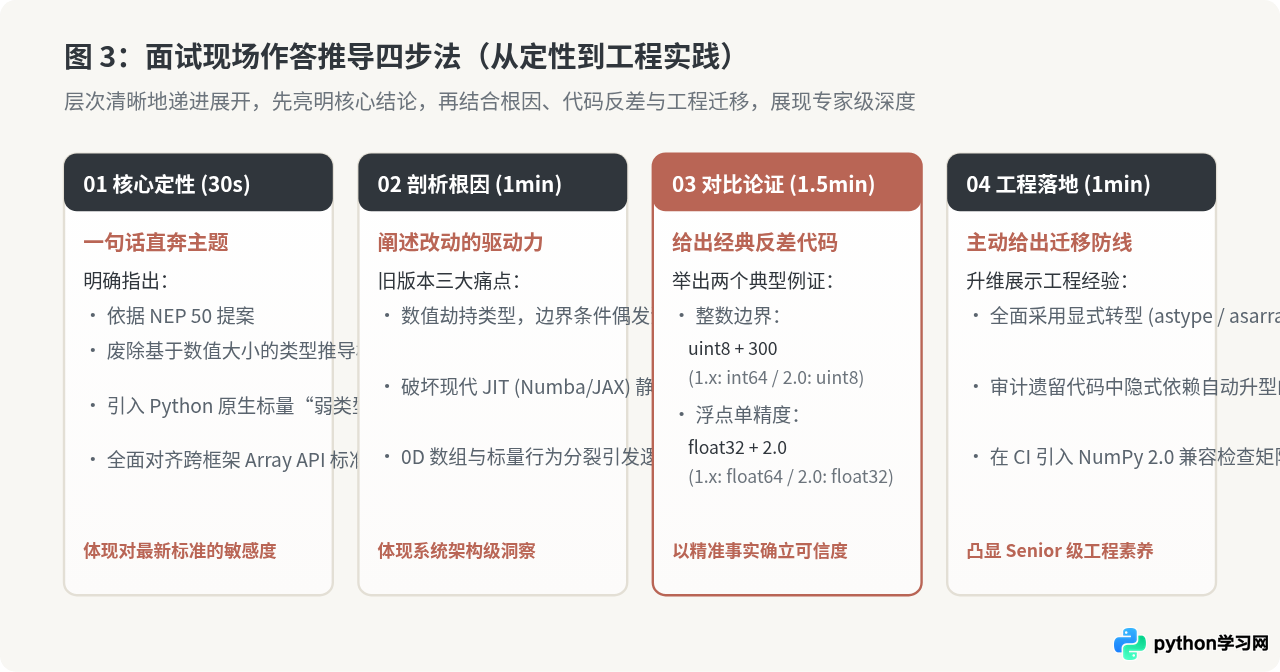
在面试中,面对考官的追问,切忌杂乱无章地想到哪说到哪。推荐采用以下结构化的四步答题模型:
-
第一步:核心定性(30秒结论)
开篇明确点出官方规范:NumPy 2.0 通过 NEP 50 废除了基于数值的类型提升,引入弱类型标量机制,与 Python Array API 对齐。用专业术语建立良好的第一印象。
-
第二步:剖析根因(1分钟痛点)
解释旧版机制三大痛点:动态检查数值导致小测试通过但大批量数据溢出类型漂移;单精度计算被 Python 标量双精度反向污染;动态机制阻碍 JIT 编译和 GPU 静态图推断。
-
第三步:对比论证(1.5分钟实操)
列举两个典型对比实例:
np.uint8(10) + 300在 1.x 升为 int64,在 2.0 保持 uint8;np.float32(1.5) + 2.0在 1.x 变 float64,在 2.0 保持 float32。用具体的数字和推导结论展现功底。 -
第四步:工程落地(1分钟迁移)
主动谈及如何在企业生产环境中应对改动:强调显式类型转换原则,排查遗留代码中依赖隐式升型的边界逻辑,体现高级工程师防患于未然的素养。
六、生产排查与平滑升级指南(面试加分项)
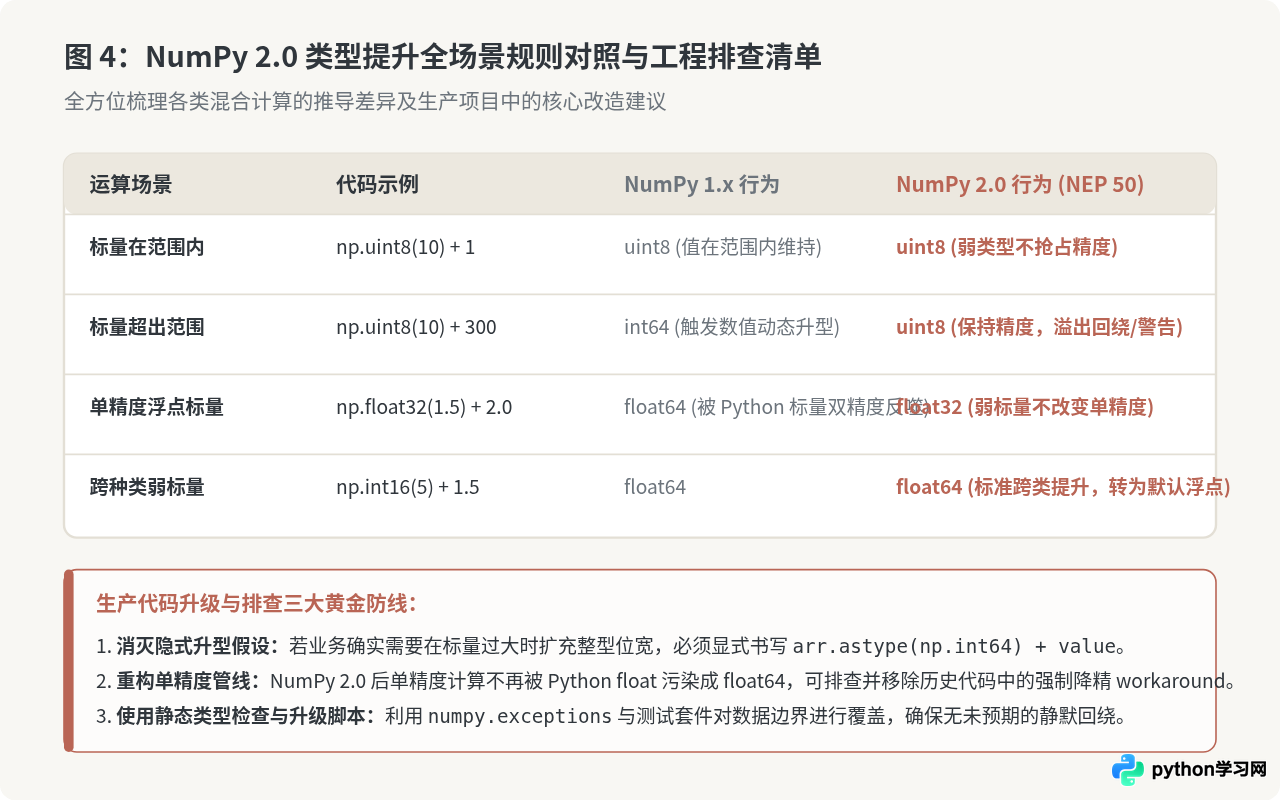
当候选人回答完理论和规则后,主动将话题引申到“项目如何从 NumPy 1.x 平滑迁移至 2.0”,往往能成为面试中的绝佳加分项。在工程落地层面,需要把握以下三项关键防线:
1. 奉行“显式优于隐式”的类型原则
在 NumPy 2.0 之前,部分开发者习惯依赖数组加上一个大整数来隐式完成类型扩展。在 2.0 下,此类代码必须重构为显式类型转换:
2. 审查单精度算子的冗余降精代码
过去为了防止单精度被 Python float 污染成 float64,很多算法管道中夹杂着大量的 .astype(np.float32) 修正语句。升级到 NumPy 2.0 后,这些语句可以逐步精简,且模型推理和图形运算的显存占用将天然保持最优。
3. 善用官方兼容工具与异常捕获
NumPy 官方提供了升级检查建议。在测试阶段,可通过配置 Python 警告过滤器或借助静态类型检查工具,检测潜在的整型溢出警告,防范静默回绕导致的业务逻辑偏差。
七、总结
在面试中回答 NumPy 2.0 类型提升规则的变化,本质上是在考察开发者对底层类型系统、规范一致性以及生产健壮性的综合理解。只要掌握了 NEP 50 废除数值依赖、弱类型标量保全精度、对齐 Array API 标准这三个关键维度,结合有说服力的正反代码对比,并在最后主动给出工程迁移策略,就能交出一份层次清晰、专业深刻的标准答卷。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









