

Python中%运算符的两种核心用法:取模与字符串格式化
深入解析Python中%运算符的两大核心功能:数值取模(求余)运算机制与经典printf风格字符串格式化,详解负数取模底层逻辑、常见陷阱与现代替代方案。
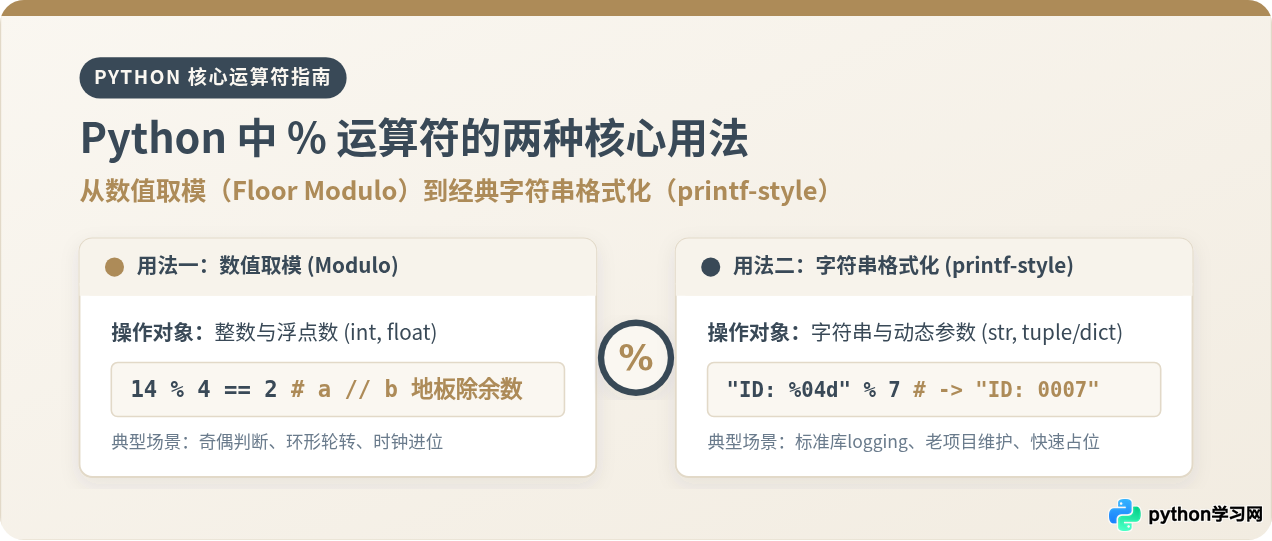
% 是一个具备鲜明“双重身份”的运算符:当两端为数值类型时,它是用于求两数相除余数的算术取模运算符;当左操作数为字符串时,它则化身为从 C 语言承袭而来的经典字符串格式化运算符。理解两者的底层运算准则、负数处理机制以及常见类型边界,是掌握 Python 基础与规避隐蔽 Bug 的必经环节。
一、操作符的分发机制与双重身份
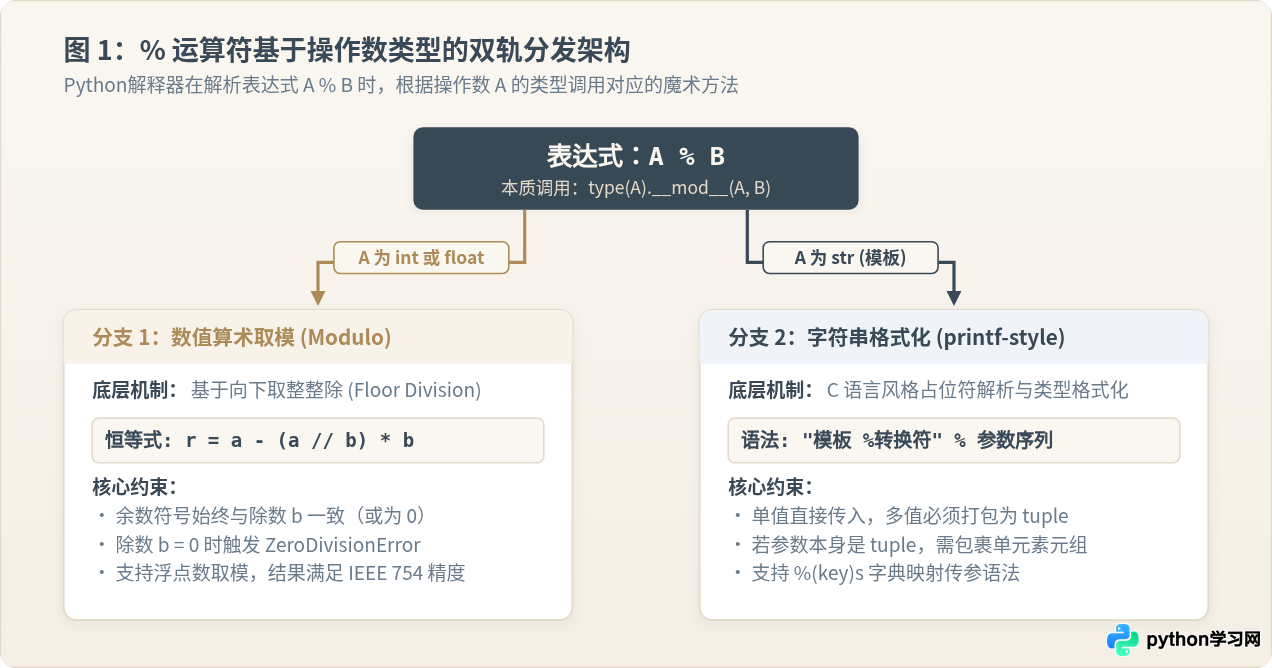
Python 是强类型动态语言,任何操作符的实际行为都由操作数所属对象的底层魔术方法决定。当解释器执行 A % B 时,本质上首先调用左操作数 A 的 __mod__(self, other) 方法;若 A 未实现该逻辑,则尝试调用右操作数 B 的反向魔术方法 __rmod__(self, other)。
这种面向对象的设计赋予了 % 在不同上下文下的明确分工:
- 数值上下文(int / float):触发整型或浮点型的算术求余,执行带向下取整约束的数学取模。
- 字符串上下文(str):触发字符串对象的格式化解析引擎,将右侧参数序列按指定类型占位符逐一填入并生成新字符串。
二、核心用法一:数值取模(求余)
取模运算在计算机算法、数值分析与日常业务开发中极为普遍。然而,许多从 C、C++ 或 Java 转向 Python 的开发者常在此处产生困惑,其根源在于负数取模的计算哲学存在差异。
1. 底层数学恒等式与地板除
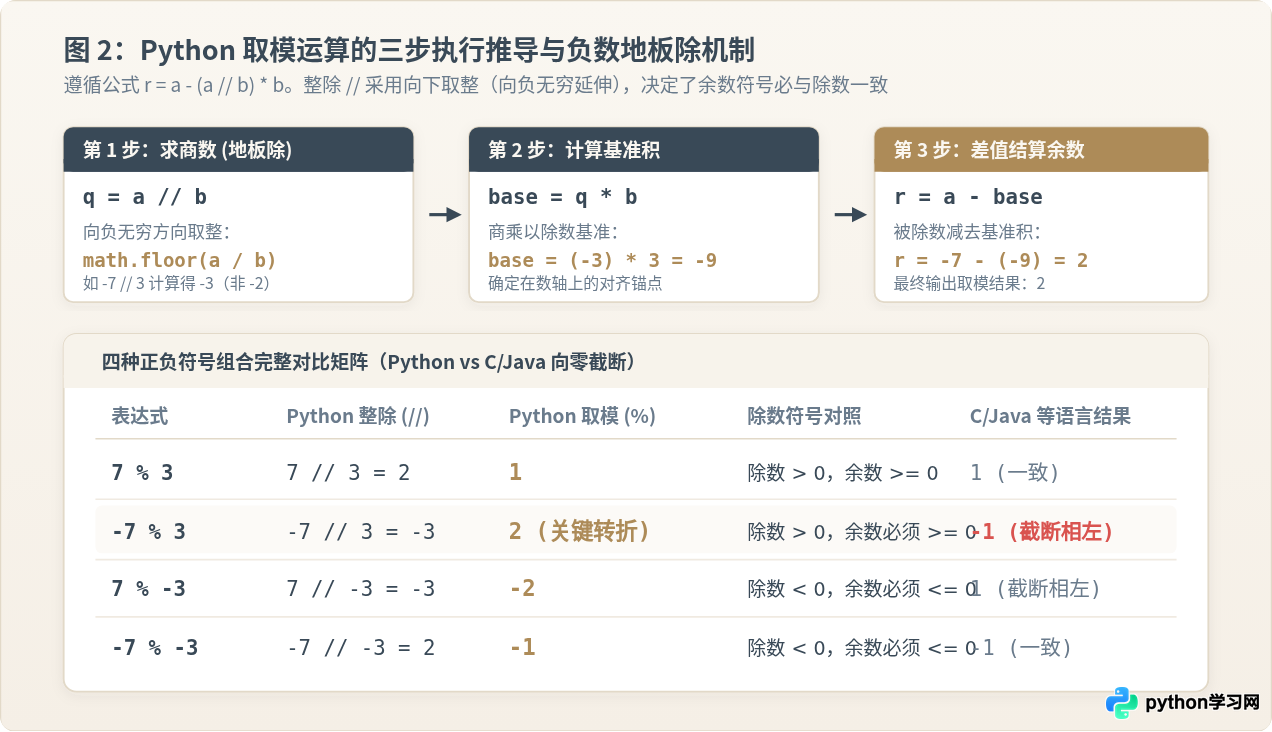
Python 官方规范对取模运算给出了严格且一致的数学定义。对于任意非零除数 b,表达式 r = a % b 的结果必须满足以下恒等式:
# 取模恒等式
r = a - (a // b) * b
其中 // 是 Python 的整除运算符。关键在于:Python 的整除采用向下取整(Floor Division,即 math.floor(a / b)),向负无穷方向取整;而 C、Java 默认采用向零截断(Truncating Division)。
由于整除始终向负无穷方向靠拢,由此推导出的取模余数 r 必然具有以下铁律:
- 余数符号严格跟随除数
b的符号(或者为 0)。 - 当除数
b > 0时,余数区间恒在[0, b)之内;当除数b < 0时,余数区间恒在(b, 0]之内。
2. 典型正负数计算推导
我们通过具体的正负组合展示推导步骤:
# 示例 1:正数与正数
print(7 % 3)    # 7 // 3 = 2 -> 7 - 2 * 3 = 1

# 示例 2:负被除数与正除数(核心差异点)
print(-7 % 3)   # -7 // 3 = -3 (向负无穷取整) -> -7 - (-3) * 3 = -7 - (-9) = 2

# 示例 3:正被除数与负除数
print(7 % -3)   # 7 // -3 = -3 -> 7 - (-3) * (-3) = 7 - 9 = -2

# 示例 4:负被除数与负除数
print(-7 % -3) # -7 // -3 = 2 -> -7 - 2 * (-3) = -7 - (-6) = -12
-2
-1
1. 除数为零错误:无论正数还是负数,当除数 b = 0 时,a % 0 会抛出 ZeroDivisionError: integer division or modulo by zero。在做动态除法计算前,务必对除数进行合法性校验。
2. 浮点数取模与精度:Python 允许对浮点数进行 % 运算(如 5.5 % 2 = 1.5),其规则同样服从地板除。但由于底层 IEEE 754 二进制浮点精度舍入,可能出现微小偏差(如 5.5 % 1.1 输出 1.0999999999999996 而非 0.0)。在需要精确几何或物理截断时,应结合 math.fmod(x, y)(该函数遵循 C 库标准向零截断)或 decimal.Decimal 使用。
3. 取模在工程中的高频实战场景
-
奇偶性校验:
通过
n % 2 == 0判断是否为偶数。 -
环形队列与周期性循环:
将线性增长的自增计数器映射到固定范围的数组索引或时钟周期内:
# 模拟时钟累加:当前8点,经过28小时后是几点? current_hour = 8 elapsed = 28 final_hour = (current_hour + elapsed) % 24 # (8 + 28) % 24 = 36 % 24 = 12 -
单位进位分解:
将总秒数精准换算为“时:分:秒”格式:
total_seconds = 3665
seconds = total_seconds % 60            # 5 秒
minutes = (total_seconds // 60) % 60    # 1 分
hours = total_seconds // 3600           # 1 时
三、核心用法二:字符串格式化(printf-style)
在 Python 2 时代以及早期 Python 3 中,使用 % 操作符进行字符串插值是标准且唯一的原生格式化方案。该机制与 C 语言标准库中的 printf() 函数家族一脉相承。
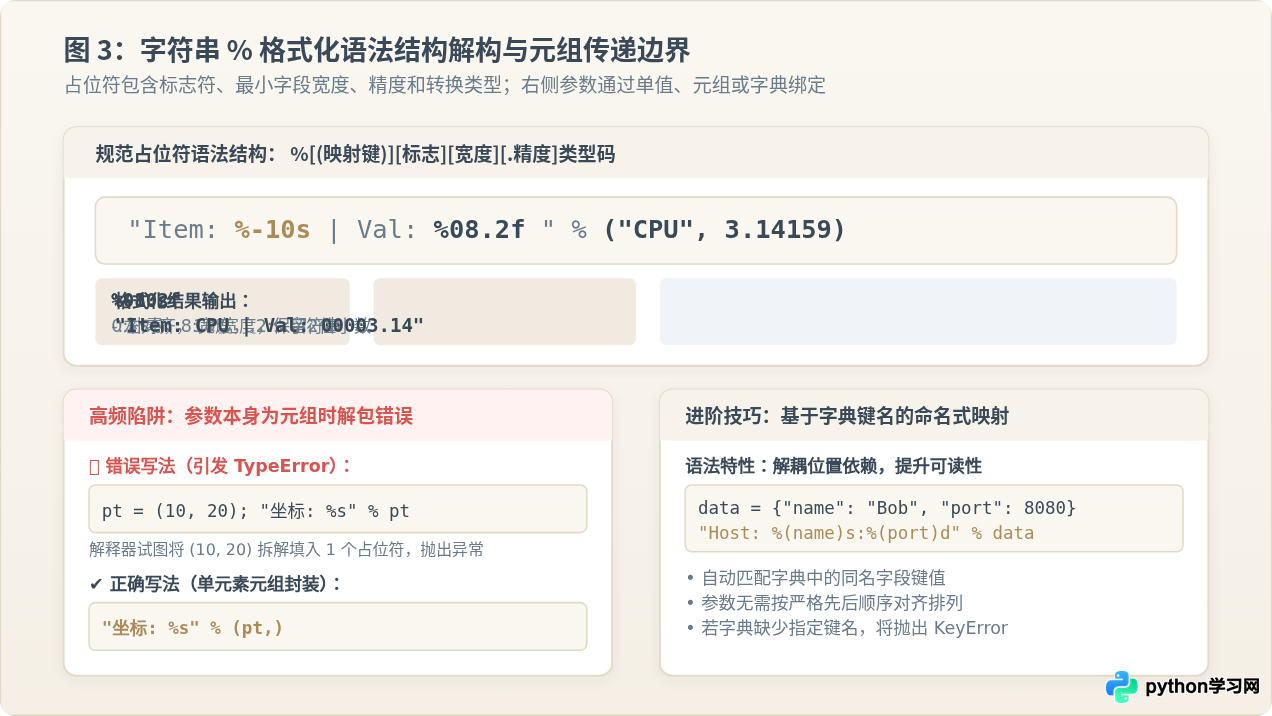
1. 占位符结构与常用类型转换码
格式化表达式的标准形式为:"模板字符串 %转换符" % (参数1, 参数2, ...)。占位符遵循以下规范组织:
%[(映射键)][标志位][最小宽度][.精度]类型码| 转换字符 | 对应类型说明 | 示例代码 | 格式化结果 |
|---|---|---|---|
%s |
字符串(自动调用对象的 str()) |
"User: %s" % "Alice" |
'User: Alice' |
%d / %i |
有符号十进制整数 | "Count: %d" % 42 |
'Count: 42' |
%f / %.2f |
十进制浮点数及小数点后保留位数 | "Price: $%.2f" % 19.9 |
'Price: $19.90' |
%04d |
前导补零的指定宽度整数 | "Index: %04d" % 7 |
'Index: 0007' |
%x / %X |
十六进制整数(小写/大写) | "Hex: 0x%02X" % 255 |
'Hex: 0xFF' |
%r |
原始字符串(自动调用对象的 repr()) |
"Raw: %r" % "hello" |
'Raw: 'hello'' |
%% |
转义字符,输出单个字面量 % |
"Discount: %d%%" % 20 |
'Discount: 20%' |
2. 多参数传递与单元素元组陷阱
当模板字符串中包含多个占位符时,右侧必须提供一个元素个数完全匹配的 tuple。如果参数数量不匹配,解释器将引发异常:
# 正常多参数传递
template = "Host: %s, Port: %d, Secure: %s"
result = template % ("127.0.0.1", 8080, True)
如果右侧参数本身是一个 tuple,且目标模板只有一个 %s 占位符,Python 会误将该元组当作“参数列表”进行解包,从而引发 TypeError: not all arguments converted during string formatting:
point = (120.15, 30.28)

# ❌ 错误示范:抛出 TypeError,Python 认为提供了 2 个参数,但模板只要 1 个
text = "当前坐标为: %s" % point

# ✔ 正确做法:外层再包裹一层单元素元组,消除歧义
text = "当前坐标为: %s" % (point,)
3. 基于字典的命名式占位符
为了解决位置绑定容易错位的问题,% 格式化支持使用 %(key)s 语法配合字典传参。该方式在配置解析与长文本组装中极其实用:
user_profile = {
    "username": "Kukukuwl",
    "role": "Admin",
    "login_count": 142
}

sql_sample = (
    "SELECT * FROM users "
    "WHERE name = '%(username)s' AND role = '%(role)s' AND score >= %(login_count)d;"
) % user_profile

print(sql_sample)四、对比与选型:现代 Python 的演进与最佳实践
随着 Python 语言的发展,官方先后引入了 str.format()(Python 2.6+)和 f-string(格式化字符串字面量,Python 3.6+)。面对三种格式化手段,开发者应当如何理性选型?
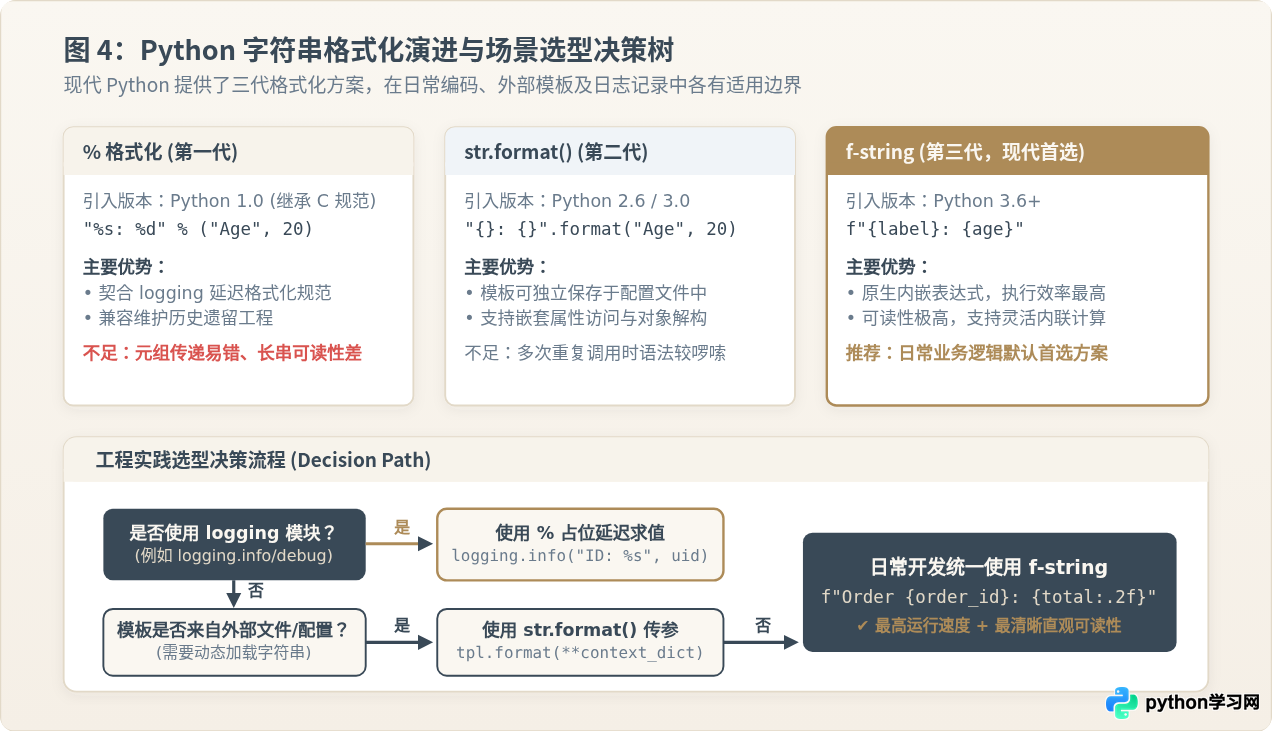
1. 三代格式化方案的横向比对
| 对比维度 | % 运算符 | str.format() | f-string (f"...") |
|---|---|---|---|
| 引入版本 | Python 1.0 (经典方案) | Python 2.6 / 3.0 | Python 3.6+ (现代推荐) |
| 语法直观度 | 较低(需对照占位符与后置参数) | 中等(花括号占位) | 极高(表达式直接内联写入) |
| 执行性能 | 中等 | 最慢(函数调用开销较大) | 最快(编译器层直接转构优化字节码) |
| 模板外部化 | 支持(可存为字符串变量) | 支持良好(适合存入配置文件) | 不支持(必须在代码定义处即时求值) |
| 典型最佳场景 | logging 日志系统、老代码维护 |
国际化 (i18n)、配置外部模板 | 日常业务开发、交互调试输出 |
2. 为什么 % 格式化在 logging 中依然是第一选择?
许多开发者会有疑问:既然 f-string 运行更快且更可读,为什么在 Python 官方的 logging 模块文档中,仍然极力推荐使用类似 % 的传参语法?
其核心原因在于延迟求值(Lazy Evaluation)以节约计算开销:
import logging

# 场景:当前日志等级为 WARNING,DEBUG 级别的日志不会被实际输出

# ❌ 使用 f-string:即使日志最终被忽略,字符串拼接与 heavy_computation() 仍会立即执行!
logging.debug(f"User details: {heavy_computation(user_id)}")

# ✔ 推荐写法:将模板与参数分别传入 logging
# 只有当 DEBUG 级别被激活时,内部才会调用 % 执行格式化渲染,避免不必要的 CPU 消耗
logging.debug("User details: %s", heavy_computation(user_id))
五、全篇总结
总结 Python 中 % 运算符的双重用法与核心要点:
-
在数值计算中:
%代表取模,严格遵循r = a - (a // b) * b的地板除规律,运算结果的符号始终与除数一致。特别注意-7 % 3 = 2这一关键数学特性,切忌盲目套用其他语言的截断经验。 -
在字符串处理中:
%是经典 printf 风格的格式化工具。掌握常用类型转换符(%s、%d、%f)、前导补零(%04d)及单元素元组消除歧义的技巧,有助于顺畅维护已有项目。 - 在架构选型中:业务代码日常编写优先采用 f-string 获取最佳可读性与运行性能;日志打印时遵循 logging 延迟格式化 规范;外部配置文件模板则交由 str.format() 处理。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









