

Python字符串与列表切片实战:去除首尾字符及每隔N个取值
深入讲解Python中字符串与列表切片的实战操作,重点解析使用[1:-1]去除首尾元素以及通过[::N]按步长每隔N个取值的底层原理、边界场景及代码范例。
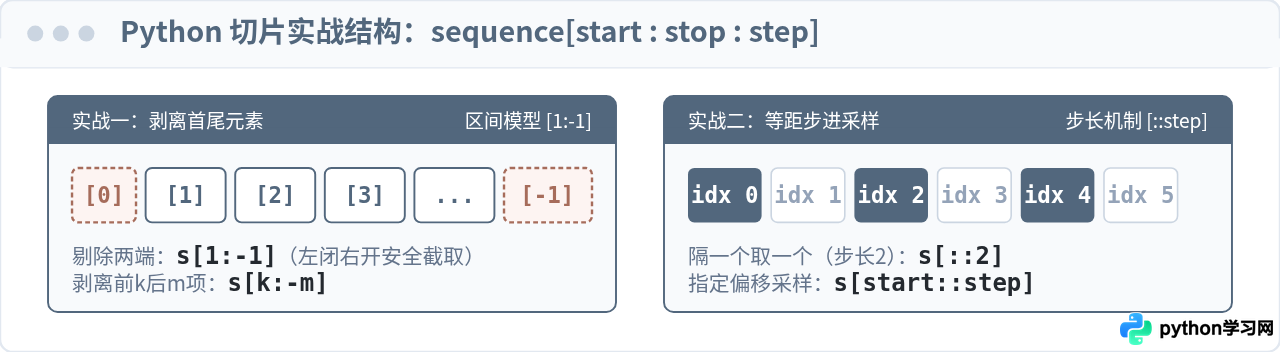
sequence[1:-1];而若需要对序列进行等距抽样,例如隔一个取一个或每隔 N 个取值,对应的通用模式为 sequence[::step]。本文将围绕这两个高频实战场景,详细拆解参数含义、索引计算模型、边界保护机制与组合应用方式。
一、切片基本模型与左闭右开区间
Python 所有的有序序列(包括字符串、列表和元组)均支持切片操作。切片的完整语法结构为 sequence[start:stop:step]。这三个参数均支持省略或填入负整数,但核心始终围绕一个数学定义:左闭右开区间 [start, stop)。
这意味着切片结果会包含索引为 start 的元素,但会在索引到达 stop 时立刻终止,绝不包含 stop 对应的元素。如果不写 step,其默认值恒为 1,即逐个连续截取。
二、去除首尾字符与元素的实战解析
在实际数据清洗中,经常遇到带有包裹符号的原始文本,比如被双引号包围的 JSON 键名、包含方括号的数组字符串,或是列表头部含有冗余标记、尾部含有校验符的情况。
1. 标准语法与底层原理:为什么是 s[1:-1]?
去除首尾单一字符的经典表达式为:
# 字符串去除首尾包裹的引号
raw_text = '"user_token_0982"'
clean_text = raw_text[1:-1]

print("原始字符串:", raw_text)
print("清洗后结果:", clean_text)
原始字符串: "user_token_0982"
清洗后结果: user_token_0982
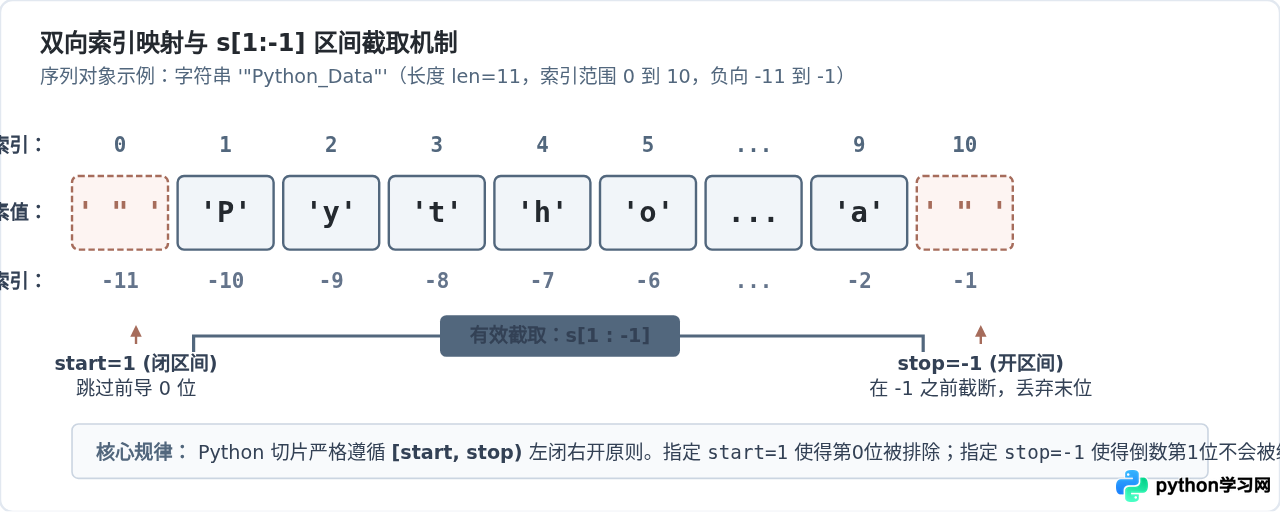
之所以 s[1:-1] 能够恰好去掉头尾,原因在于 Python 的双向索引机制:
- 起始位置 1:跳过了索引为 0 的第一个字符,从第 1 个索引处开始收集。
- 结束位置 -1:在 Python 中,负索引
-1准确指向序列的最末位元素。根据“右开区间不包含 stop 自身”的规则,切片在到达倒数第一位之前就已经停止,因此最末位元素被排除在外。
2. 在列表中的对应表现
切片对于列表的处理与字符串完全一致,同样作用于元素级位置:
# 模拟从报文中解析出的原始数据列表,首尾为标识帧
packet = ["<START>", 102, 105, 108, 114, "<END>"]
payload = packet[1:-1]

print("原始数据帧:", packet)
print("提取有效载荷:", payload)
原始数据帧: ['<START>', 102, 105, 108, 114, '<END>']
提取有效载荷: [102, 105, 108, 114]
s[1:-1] 必然生成并返回一个全新的字符串对象;而列表虽然可变,切片操作 lst[1:-1] 同样会返回一个包含子元素引用的全新列表对象(浅拷贝),不会修改原列表。若需要原地修改列表,需使用 del lst[0] 和 del lst[-1]。
3. 切片 vs strip() 的本质区别
很多初学者容易将 s[1:-1] 与字符串方法 s.strip() 混淆。两者的设计目的截然不同:
- 切片 s[1:-1] 是纯物理位置截取。无论首尾是什么字符(哪怕是字母、数字或空格),只要存在,均强制剥离一个位置。
- str.strip(chars) 是字符集合匹配剔除。它会从两端开始扫描,凡是在传入字符集内的连续字符都会被全部清除,直到遇到不匹配的字符为止。若两端没有指定字符,则什么也不做。
s1 = '"""Hello World"""'
print("strip 结果:", s1.strip('"'))  # 剥除所有外层连续双引号
print("切片 结果:", s1[1:-1])        # 仅仅去掉最外层的一对双引号

s2 = 'Data_2026'
print("无引号时 strip:", s2.strip('"')) # 内容不符,原样保留
print("无引号时 切片:", s2[1:-1])      # 强制剥除头部 'D' 和尾部 '6'
strip 结果: Hello World
切片 结果: ""Hello World""
无引号时 strip: Data_2026
无引号时 切片: ata_202
4. 边界安全性分析
在单元素索引访问时,如果索引超出范围,例如访问 s[5] 而序列长度仅为 3,Python 会直接抛出 IndexError: string index out of range。
但在切片操作中,Python 设计了内置的边界保护机制:切片永远不会因为范围超出而抛出 IndexError。当切片范围无法构成有效区间时,它会优雅地返回当前类型的空序列:
- 对空字符串执行
""[1:-1]得到"" - 对单字符执行
"A"[1:-1]得到""(因为 start=1 已经超过了 stop=0 对应的有效范围) - 对两字符执行
"AB"[1:-1]得到""
这一容错特性使切片在批处理未知长度的输入数据时格外健壮。
三、每隔 N 个取值的步长采样机制
当需要对时间序列、波形离散点或表格数据进行降采样、奇偶行抽取时,第三个参数 step(步长)发挥核心作用。
1. 步长 step 的物理含义与数值设定
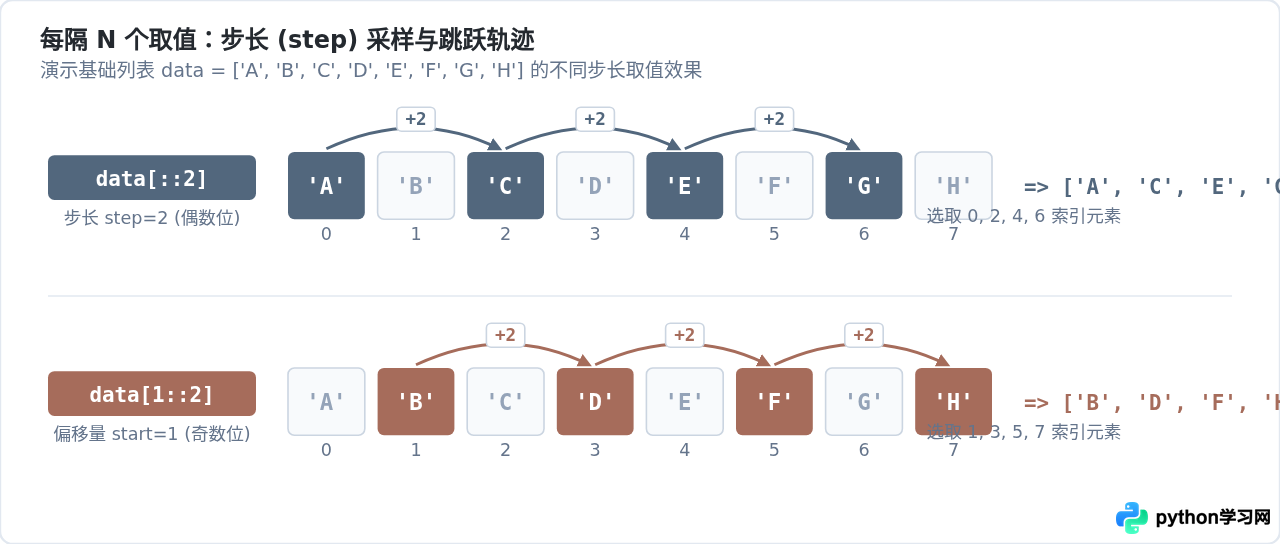
在中文日常表达中,“每隔 N 个取一个”常存在口语理解歧义:有人指“间隔 1 个元素选一个”,有人指“抽样间隔周期为 N”。在 Python 切片中,步长 step 具有精确的数学定义:每收集一个元素后,指针向前移动的偏移量。
- 隔一个取一个(偶数位采样):从索引 0 开始,每跳过 1 个元素取下一个,指针位移是 2,故
step=2。语法为sequence[::2]。 - 步长为 3 的采样:每前移 3 个单位取一个值,对应索引为 0, 3, 6, 9...,语法为
sequence[::3]。 - 一般形式:从索引
start开始,每前移 N 步采样一次,写作sequence[start::N]。
2. 奇数位与偶数位提取实战
结合省略参数规则,通过调节 start 可以轻松实现数据分流:
nums = [10, 21, 32, 43, 54, 65, 76, 87]

# 提取偶数索引位置 (索引 0, 2, 4, 6)
even_pos = nums[0::2]   # 也可简写为 nums[::2]

# 提取奇数索引位置 (索引 1, 3, 5, 7)
odd_pos = nums[1::2]

print("全部元素:", nums)
print("偶数位元素:", even_pos)
print("奇数位元素:", odd_pos)
全部元素: [10, 21, 32, 43, 54, 65, 76, 87]
偶数位元素: [10, 32, 54, 76]
奇数位元素: [21, 43, 65, 87]
3. 步长为负数:逆序与反向步进
当 step 为负数时,切片的方向由默认的“从左至右”反转为“从右至左”:
s[::-1]:最著名的列表与字符串就地反转切片技巧。s[::-2]:从末尾开始,向左每隔一个元素逆向提取一个值。
ValueError: slice step cannot be zero。
四、操作实施流程与决策模型
在实际编写代码时,为了确保切片不仅能够达成业务目标,还能稳妥应对不可控的外部入参,推荐遵循标准化的四步实施流程:
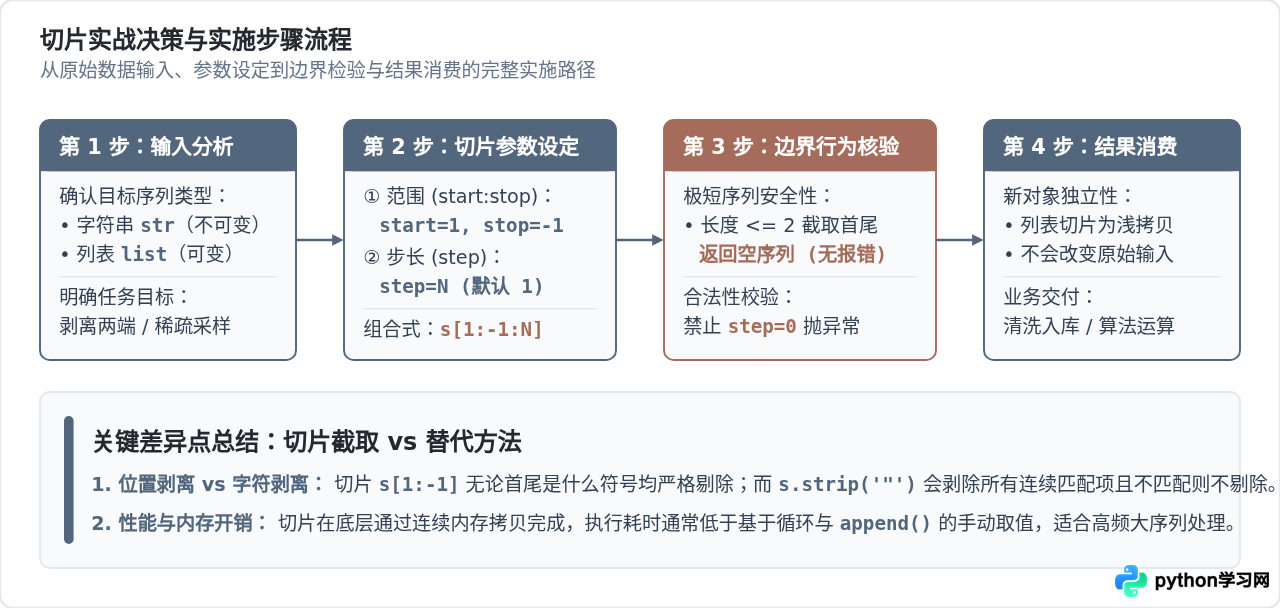
实施步骤拆解:
- 输入类型与语义判定:明确待处理对象是连续内存的文本字符串还是容器型列表。对于可变列表,需提前规划是否允许共享底层子对象引用。
- 配置截取与步长参数:若需要同时“去除首尾并每隔 N 个取值”,切勿嵌套书写两次切片产生多余内存开销,直接采用组合切片:
sequence[1:-1:N]即可单步完成。 - 边界有效性核验:确认极端情况下(如字符串长度不足 2 个、步长变量动态传入时可能为 0)代码的鲁棒性。对于外部输入的 step 变量,务必提前断言
assert step != 0。 - 结果消费与校验:明确切片产生的是全新副本,后续对新列表的增删操作完全独立于原始输入。
五、组合切片实战案例:去除首尾并稀疏采样
下面演示一个综合案例:读取传感器或外部 API 采集的带标记连续采样文本,先剥离报文开头与结尾的标记符,再对高频离散数值执行稀疏降采样。
def process_telemetry_stream(raw_packet: str, sample_step: int) -> list:
    """
    清洗传感器报文并降采样
    报文格式: [val1,val2,val3,...]
    要求:
      1. 去除首尾的方括号 '[' 与 ']'
      2. 按逗号拆分出数据项
      3. 每隔 sample_step 步提取一个样本
    """
    if len(raw_packet) < 2 or not (raw_packet.startswith('[') and raw_packet.endswith(']')):
        return []

    # 第一步:切片去除首尾中括号
    inner_data_str = raw_packet[1:-1]

    # 转换为数值列表
    raw_list = [int(x.strip()) for x in inner_data_str.split(',') if x.strip()]

    # 第二步:对列表执行步长切片提取关键点 (例如每隔 3 个点采样一次)
    sampled_data = raw_list[::sample_step]
    return sampled_data

# 模拟输入报文 (10个采样点)
packet_stream = "[12, 15, 18, 22, 29, 35, 41, 48, 55, 60]"
result = process_telemetry_stream(packet_stream, sample_step=3)

print("原始报文:", packet_stream)
print("降采样输出:", result)
原始报文: [12, 15, 18, 22, 29, 35, 41, 48, 55, 60]
降采样输出: [12, 22, 41, 60]
六、核心用法与边界行为速查总结
为方便在日常编码中快速查阅不同参数组合的意图与边界表现,下表及图示归纳了最高频使用的切片范式:
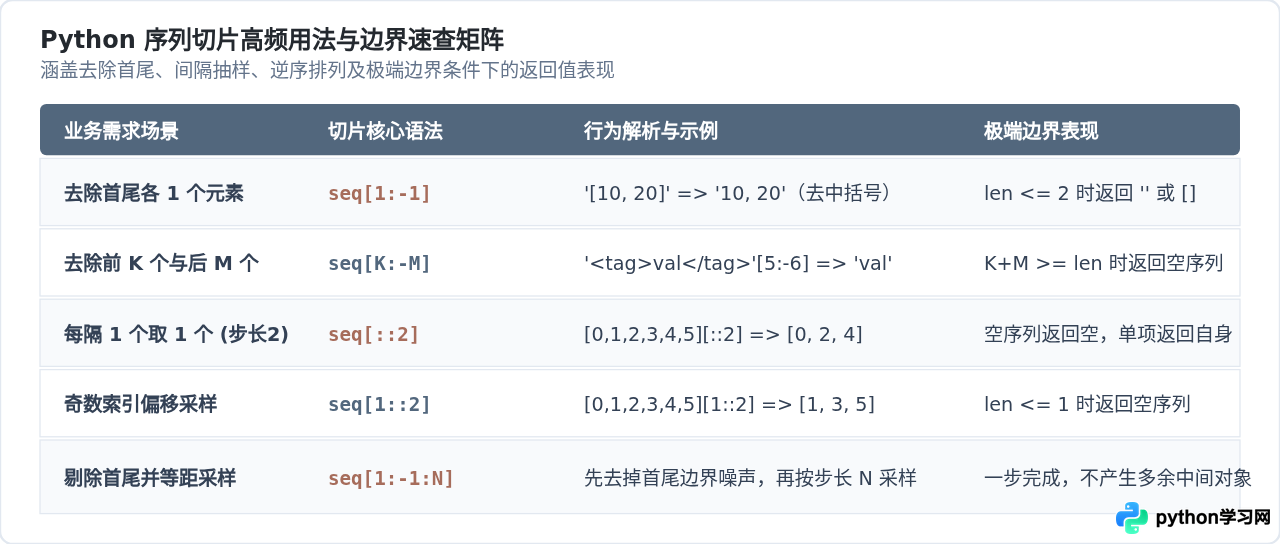
| 需求场景 | 标准切片语法 | 等效展开逻辑 | 极值与边界结果 |
|---|---|---|---|
| 去除首尾各 1 个字符/元素 | s[1:-1] |
从下标 1 截取至倒数第 2 项(跳过 0 和 -1) | 原序列长度 ≤ 2 时安全返回空字符串或空列表 |
| 去除前 K 个与后 M 个元素 | s[K:-M] |
首部跳过 K 项,尾部跳过 M 项 | K + M ≥ len 时返回空序列 |
| 等距步进采样(每隔 1 个取 1 个) | s[::2] |
从 0 开始,步长递增 2(取偶数索引位) | 单元素列表返回包含该单元素的列表 |
| 偏移等距采样(取奇数位) | s[1::2] |
从 1 开始,步长递增 2(取奇数索引位) | 原长度 ≤ 1 时返回空序列 |
| 去首尾并按步长采样 | s[1:-1:N] |
在 [1, -1) 子集内按步长 N 步进抽取 | 组合式一步求值,底层连续取值无多余开销 |
| 全序列逆序反转 | s[::-1] |
从尾部开始,向左逐个倒序提取 | 对回文检测、反向遍历极为高效 |
掌握 [1:-1] 与 [::step] 的内在索引逻辑后,日常的字符串清洗与列表抽样任务即可摆脱冗长的条件判断或循环拼接,写出简洁、优雅且符合 Pythonic 哲学的稳健代码。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









