

Python中%是取模还是格式化?怎么根据上下文区分
全面解析 Python 中 % 运算符的双重身份:何时代表算术取模,何时代表字符串格式化。提供四步上下文识别流程、特性对比矩阵、结合律与优先级陷阱剖析及现代工程选型建议。
% 既不是单纯的取模符号,也不是专属的字符串格式化标记,而是二者兼具。它的真实含义完全取决于左侧第一个操作数的类型:当左侧是数值时,执行的是算术取模(求余数);当左侧是字符串或字节序列时,执行的则是经典的 printf 风格字符串格式化。
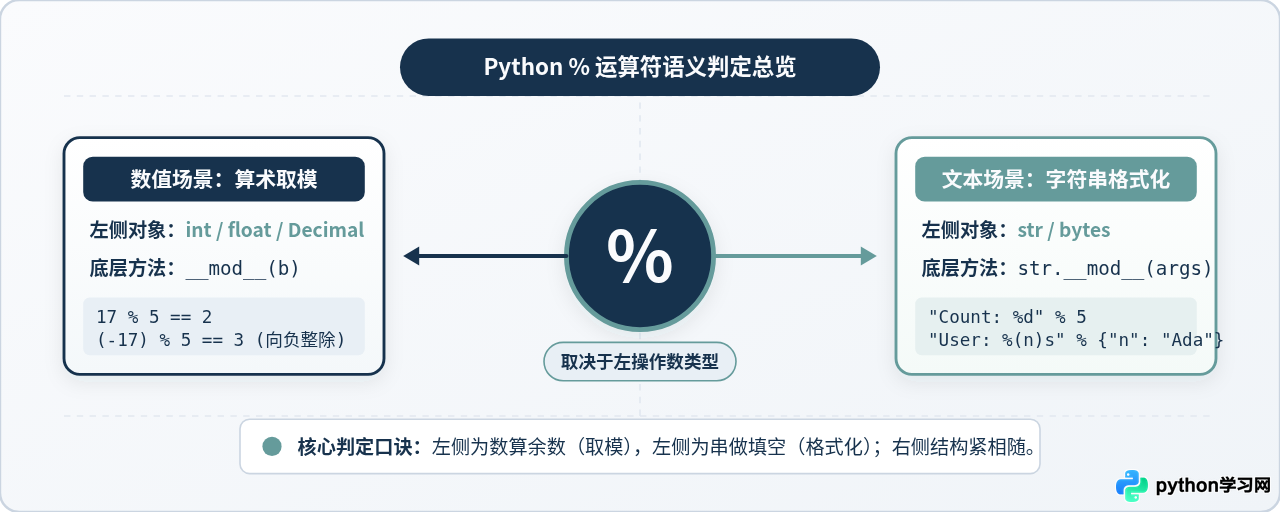
% 运算符的语义分支总览 —— 取模与格式化的双重身份,由左侧操作数在运行时分发。一、为什么同一个符号会有两种完全不同的用途?
很多初学 Python 的开发者在阅读项目源码或教程时,常常会感到困惑:刚才还在 for i in range(10): if i % 2 == 0 里用 % 计算奇偶数,怎么转眼又在 print("Name: %s" % user) 里把它当成了填充字符串的工具?
这种“一符多用”的机制在编程语言中被称为运算符重载(Operator Overloading)。Python 在底层并不为数学计算和文本插值维护两套完全隔绝的运算符解析器,而是把中缀符号 % 统一映射到对象的特殊魔术方法 __mod__() 上:
- 如果表达式写作
a % b,Python 解释器在运行时实际上会优先尝试调用a.__mod__(b)。 - 数值类型(如
int、float)在各自类定义中实现的__mod__是数学求余逻辑。 - 文本类型(如
str、bytes)在类定义中实现的__mod__则是模板解析与占位符填充逻辑。
因此,区分 % 的具体功能,不是靠死记硬背符号本身,而是根据表达式所在上下文中的操作数形态来准确研判。
二、数值上下文:% 作为算术取模运算符
当 % 处于数值计算环境中时,它扮演的是标准的求模(Remainder / Modulo)角色。其最基础的语法形式为:
# 数值取模基本结构
remainder = dividend % divisor
在日常开发中,数值取模最常见的应用场景包括:
- 奇偶性判断与周期循环:例如
n % 2 == 0判定偶数,或者让下标在固定数组长度内环形回绕index = (index + 1) % length。 - 时间与单位进位转换:例如将总秒数转换为分秒时,使用
total_seconds % 60获取当前分钟剩余的秒数。 - 分批与切片处理:例如处理大批量数据流时,利用
if i % 1000 == 0: save_checkpoint()每千条触发一次持久化。
Python 与 C、C++、Java 等语言在负数求模上的实现截然不同。在 C/Java 中,整数除法向零截断,余数符号始终与被除数一致;而在 Python 中,整数除法是向负无穷向下取整(Floor Division //)。其取模公式严格遵循:
r = a - (a // b) * b
这意味着在 Python 中,余数 r 的正负号永远与除数 b 保持同号。例如:
# 示例 1:Python 独特的负数取模行为
print(7 % 3)     # 输出: 1  (7 // 3 = 2, 7 - 2*3 = 1)
print(-7 % 3)    # 输出: 2  (-7 // 3 = -3, -7 - (-3)*3 = 2,余数与除数 3 同号)
print(7 % -3)    # 输出: -2 (7 // -3 = -3, 7 - (-3)*(-3) = -2,余数与除数 -3 同号)
print(-7 % -3)   # 输出: -1 (-7 // -3 = 2, -7 - 2*(-3) = -1)
三、文本上下文:% 作为字符串格式化运算符
当 % 左侧的操作数是一个字符串或字节串字面量(或返回文本类型的变量)时,% 立即切换为字符串插值运算符。这种语法借鉴自 C 语言中的 printf 系列函数。
它的典型结构是将左侧的“格式化模板字符串”与右侧的“数据参数”结合:
# 格式化基本结构
formatted_str = "模板包含占位符 %说明符" % 数据参数
常见的占位符说明符包括:
%s:转换为字符串(调用对象的str()方法)。%d或%i:转换为十进制有符号整数。%f或%.2f:转换为浮点数,可指定保留的小数位数。%x/%X:转换为无符号十六进制数。%%:如果需要在格式化模板中输出一个真正的百分号字符,必须使用连续两个%%转义。
# 示例 2:常见的三种右操作数形态

# 1. 右侧为单个标量值(不需要加括号)
title = "Chapter %d" % 1
print(title)  # 输出: Chapter 1

# 2. 右侧为多个实参:必须打包为元组 (tuple)
info = "Item: %s, Price: $%.2f" % ("Coffee", 18.5)
print(info)   # 输出: Item: Coffee, Price: $18.50

# 3. 基于键名字典映射传参:%(key)s 语法
template = "Server: %(host)s on Port: %(port)d"
config = {"host": "127.0.0.1", "port": 8080}
print(template % config)  # 输出: Server: 127.0.0.1 on Port: 8080
四、怎么根据上下文准确区分?四步识别法
面对一段包含 % 的复杂代码,我们可以按照以下四个步骤逐步研判,准确推导出其执行语义与潜在风险:
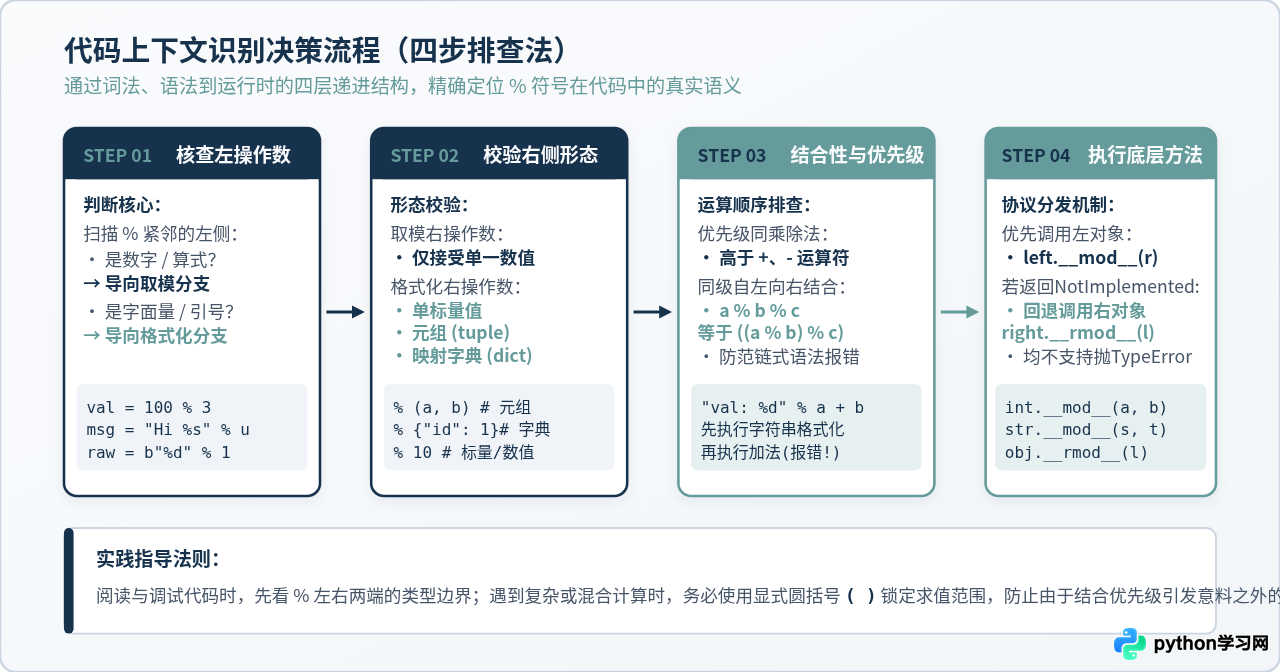
步骤 1:扫描 % 紧邻的左侧操作数(决定性因素)
左侧是判断的第一道闸门:
- 如果左侧是以单引号、双引号、三引号包裹的字面量(如
"Count: %d"),或者其求值结果明确为str或bytes,则语义一定是字符串格式化。 - 如果左侧是整型数、浮点数或纯数值算术表达式(如
(x + 10)),则语义是算术取模。
步骤 2:校验 % 右侧操作数的数据形态
右侧的结构反过来辅助佐证左侧意图:
- 如果右侧被圆括号包裹为多个逗号分隔的元素
%(a, b, c),或者是一个字典%{"key": val},它只可能是格式化传参。 - 如果右侧是不可被解包的单一非零数字,且左侧亦为数字,则是纯粹的取模。
步骤 3:分析运算符的优先级与结合性
在 Python 语法体系中,% 无论是取模还是格式化,其运算符优先级均与乘法 *、除法 /、整除 // 完全相同,并且严格高于加减法 +、-。当一行代码中存在多个同级操作符时,按照自左向右的规则结合。
步骤 4:确认底层魔术方法调用机制
当涉及自定义类或复杂第三方库(如 NumPy 数组、Pandas 数据列)时,Python 会先调用左操作数的 left.__mod__(right)。如果左侧对象未实现该协议或返回了 NotImplemented,解释器才会回退寻找右侧对象的反向方法 right.__rmod__(left)。若双方均不支持,则抛出 TypeError: unsupported operand type(s) for %。
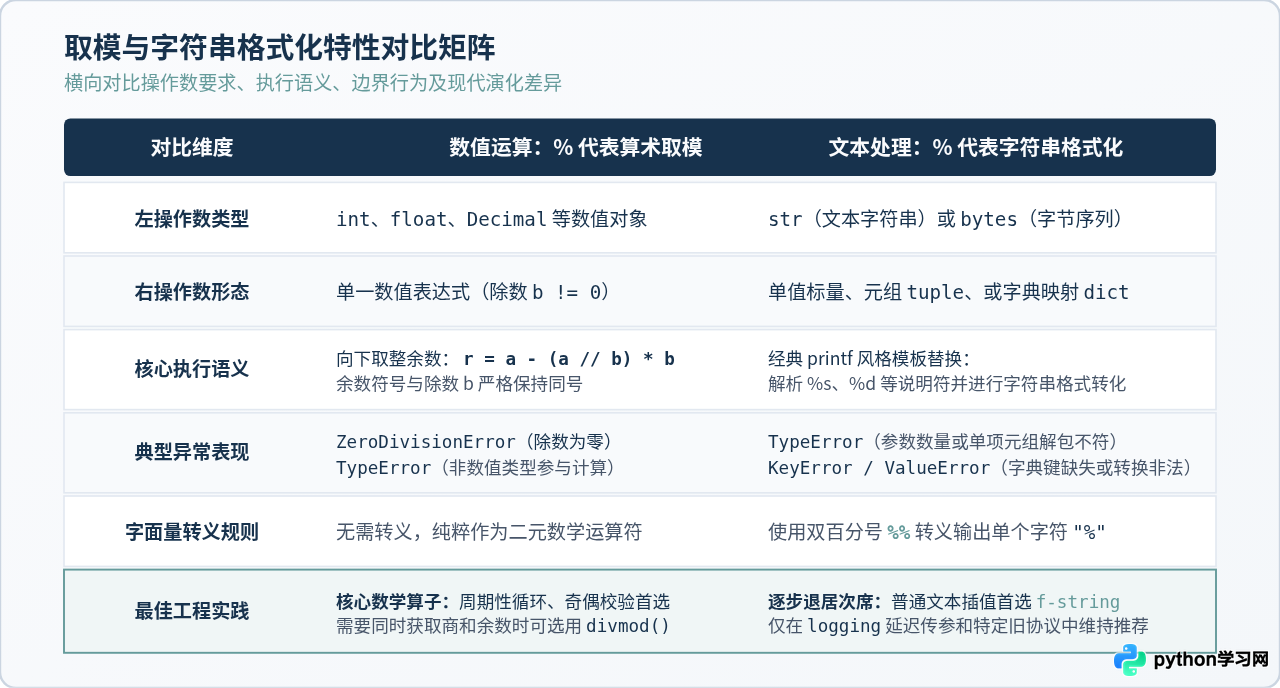
五、特性对比矩阵:取模与格式化深度对比
为了让两者的技术边界更为直观,下表系统整理了两者的核心技术指标:
六、极易踩坑的四大高混淆场景剖析
在实际编码中,很多开发者会遇到令人匪夷所思的语法报错,其根源往往是混淆了 % 的结合顺序或传参边界。以下剖析四种最经典的实战陷阱:
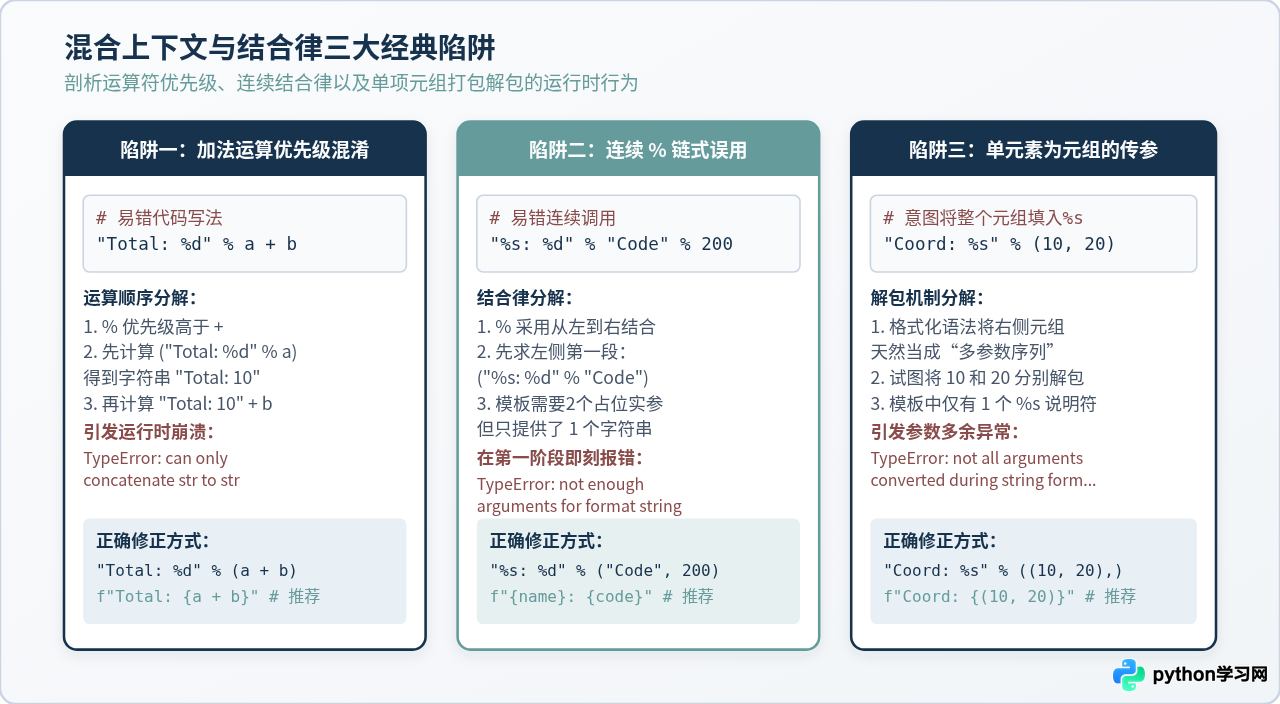
陷阱 1:格式化与加减法混用的优先级陷阱
# 错误写法:开发者本意是格式化 a + b 的总和
a, b = 10, 5
msg = "Result: %d" % a + b报错原因:由于 % 的优先级高于 +,Python 会优先计算 ("Result: %d" % a),生成了字符串 "Result: 10"。随后表达式退化为 "Result: 10" + 5,试图让字符串与整数相加,立刻抛出 TypeError: can only concatenate str (not "int") to str。
正确解决:用括号显式锁定加法表达式:"Result: %d" % (a + b),或者直接使用 f-string:f"Result: {a + b}"。
陷阱 2:连续链式调用 % 的结合律崩溃
# 错误写法:试图连续使用两次 % 填入两个参数
result = "Status: %s, Code: %d" % "OK" % 200报错原因:% 运算符自左向右结合。表达式被等价拆解为 (("Status: %s, Code: %d" % "OK") % 200)。在执行第一步计算时,模板中声明了两个占位符(%s 和 %d),但右侧只提供了一个字符串 "OK",在第一阶段便直接抛出 TypeError: not enough arguments for format string。
正确解决:必须把多个参数一次性置于同一个元组中:"Status: %s, Code: %d" % ("OK", 200)。
陷阱 3:单元素为元组时的解包传参陷阱
# 需求:将坐标元组作为一个整体打印出来
coord = (120, 30)
print("Location: %s" % coord)报错原因:在 % 格式化语法中,只要右侧操作数是一个 tuple,解释器就会无条件认定你在提供多参数序列,并尝试将其拆开分配给模板。这里 coord 有两个元素,但模板只有一个 %s,因此抛出 TypeError: not all arguments converted during string formatting。
正确解决:若要将一个元组作为单一值传入,必须在外部再嵌套一层单元素元组并带上尾逗号:"Location: %s" % (coord,);这也是为什么现代 Python 强烈推荐采用 f-string 的重要原因之一(f"Location: {coord}" 绝不会发生此类意外解包)。
陷阱 4:文本格式化中嵌套数值求模
# 场景:在生成提示字符串的同时计算余数
score = 87
print("剩余分值: %d" % score % 10)    # 报错!
print("剩余分值: %d" % (score % 10))  # 正确!输出: 剩余分值: 7
在未加括号时,前一段首先执行为 "剩余分值: 87",随后试图执行 "剩余分值: 87" % 10,此时左侧是没有任何占位符的普通字符串,再次引发 TypeError。显式包裹圆括号能够消除所有二义性。
七、现代演进与最佳实践建议
随着 Python 语言的发展,% 的分工在当今现代工程体系中已经变得极其清晰:
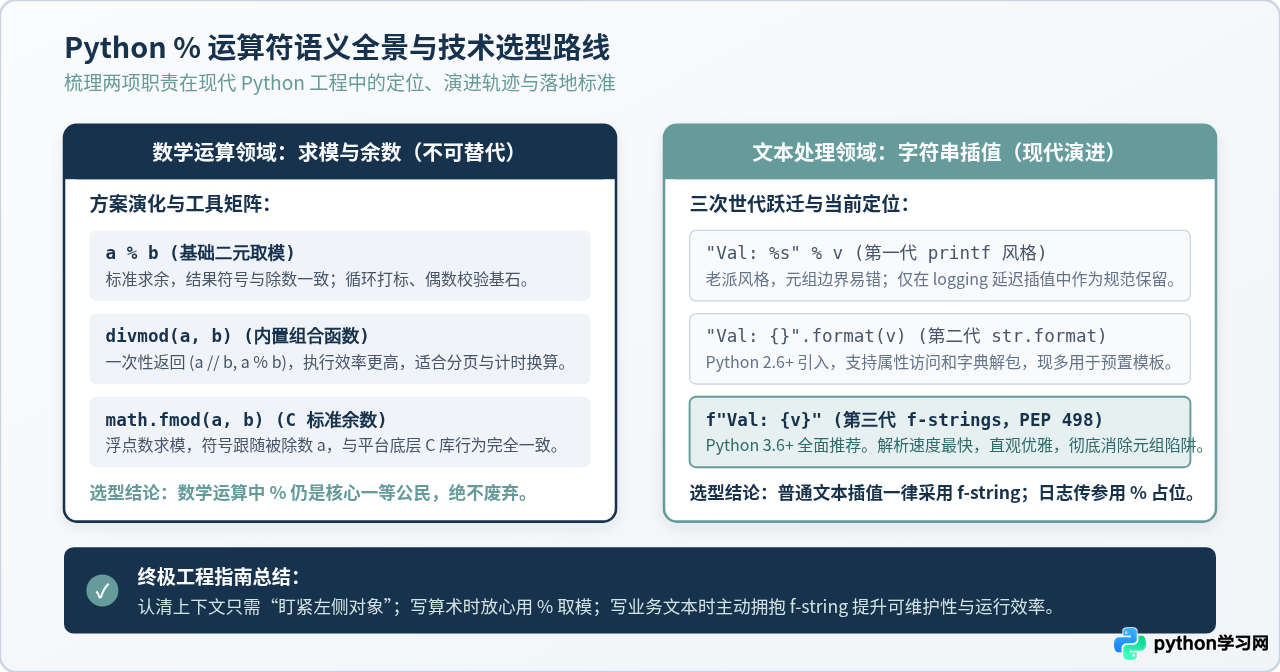
% 语义全景与演进决策树 —— 取模稳居基础数学核心,文本格式化全面拥抱 f-string。1. 数值领域:继续放心使用 %
在所有数值算法、求余运算、循环阵列以及奇偶性判断中,% 依然是唯一标准且最高效的内置语法。如果需要同时取得整数商与余数,还可以搭配内置的 divmod(a, b) 函数,例如:
# 同时获取商和余数
minutes, seconds = divmod(135, 60)
print(minutes, seconds)  # 输出: 2 15
2. 文本领域:全面优先采用 f-string(PEP 498)
在 Python 3.6 之后,传统的 % 字符串格式化已逐步成为历史兼容手段。在编写新代码时,应无保留地优先使用 f-string(格式化字符串字面量):
- 更清晰直观:变量名和表达式直接内嵌在
{}占位符中,无需在末尾核对参数位置与数量。 - 杜绝元组解包陷阱:无论变量是列表、元组还是字典,均会按预期转化为其字符串表现形式。
- 更高的运行时性能:f-string 由 Python 在编译期解析为快速的字节码操作,执行速度显著优于传统的
%运算和str.format()。
logging 模块中的 % 风格传参
在记录日志时,官方依然推荐采用类似 logging.info("User %s connected from %s", username, ip) 的语法。这并不是在调用 % 运算符,而是将字符串模板与参数作为独立实参传给日志记录器,只有当该日志级别满足输出阈值时,日志库内部才会执行实际的格式化操作,避免了在 DEBUG 等低级别日志被禁用时产生无谓的字符串插值开销。
核心要点速查小结
- 是取模还是格式化?看左操作数类型。左侧为
int/float等数值即为求模;左侧为str/bytes文本即为格式化。 - 运算优先级:与乘除法同级,高于加减法,自左至右结合。涉及算式混用时务必使用括号。
- 负数取模口诀:Python 遵循向负无穷整除,求出的余数正负符号始终与除数(右操作数)一致。
- 选型标准:做数学计算放心用
%;日常拼接文本一律选用 f-string,安全又清晰。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









