

Python深拷贝性能开销大吗?大数据量下的替代方案与优化
深入剖析Python标准库copy.deepcopy在大数据量下的性能瓶颈与开销根源,解释memo字典查重、动态类型分发与密集PyObject分配机制,并提供分层浅拷贝、C/Rust底层序列化、NumPy连续内存视图及写时复制(COW)等高吞吐替代方案与落地决策指南。
假设你正在处理一个包含 50 万条嵌套业务记录的字典列表,或者在机器学习特征工程中维护一个高维结构化数据集。为了防止下游函数在计算特征或清洗数据时修改原始结构,你很自然地调用了 data_copy = copy.deepcopy(data)。然而,程序耗时随即从几毫秒飙升到数十秒,内存占用瞬间增加两倍以上,在容器化或并发执行时甚至直接触发 OOM(内存溢出)异常退出。
核心结论先置:Python 标准库中的 copy.deepcopy 在大数据量下性能开销极其巨大。 这种开销不仅体现在翻倍的物理内存分配上,更根本的症结在于其内部为了处理任意复杂对象和防止循环引用所建立的递归漫游机制、memo 查重字典以及解释器层面的大量小对象动态创建。在生产级大数据管道中,盲目依赖深拷贝是常见的性能杀手。理解其瓶颈来源并采用针对性的分层浅拷贝、底层 C/Rust 序列化或零拷贝/写时复制(COW)方案,可以实现 10 倍到上千倍的吞吐提升。
一、深拷贝开销为什么这么大?底层运作机理剖析
要解决深拷贝的迟缓问题,首先需要了解 copy.deepcopy 在 Python 解释器内部究竟执行了哪些动作。标准库中的 deepcopy 并不是简单的内存块字节拷贝(memcpy),而是一套完备的图遍历引擎。
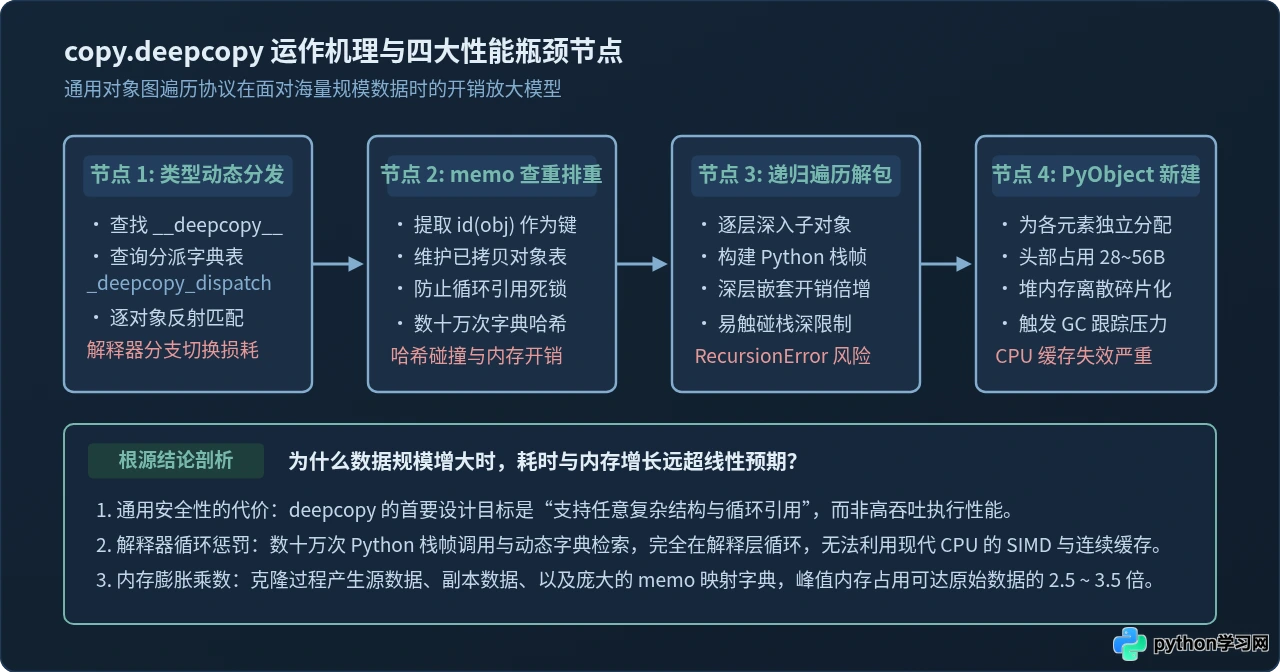
如上图所示,当对一个复合对象执行 deepcopy 时,引擎在每个子节点上都要承受四层固有开销:
- 动态分派与反射查找:引擎首先检查对象是否定义了
__deepcopy__方法,若无则查询内置的_deepcopy_dispatch分派表,以匹配字典、列表、元组等原生类型。每一次类型匹配都运行在 Python 解释器字节码层面,伴随大量的函数调用开销。 memo字典哈希记录与查重:为了避免循环引用导致无限递归(例如a = []; a.append(a)),deepcopy在每次访问对象时都会以id(obj)作为键,在私有的memo字典中进行检索与插入。当数据量达到数十万到数百万个节点时,memo字典本身就会膨胀为巨大的哈希表,引发频繁的哈希冲突、内存重新分配以及 CPU 缓存失效。- 深层调用栈与递归解包:对于深度嵌套的树状或图状结构,递归漫游需要频繁压栈和弹栈。如果嵌套层级过深,还会直接触发 Python 的
RecursionError: maximum recursion depth exceeded。 - 海量离散小对象分配:Python 的对象(
PyObject)包含引用计数(ob_refcnt)和类型指针(ob_type),最小的空对象也占用数十字节。深拷贝成千上万个标量或小容器会导致离散的堆内存申请,加剧内存碎片,并大幅增加垃圾回收(GC)分代跟踪的负荷。
基准性能验证:原生深拷贝的真实耗时表现
为了直观感受数据规模增长对耗时的影响,我们可以通过标准库 timeit 和 tracemalloc 进行一组可复现的基准测试:
import copy
import time
import tracemalloc

# 构建包含 100,000 条嵌套记录的模拟业务数据
def generate_dataset(n=100000):
    return [
        {"id": i, "status": "active", "metrics": [i * 0.1, i * 0.2, i * 0.3]}
        for i in range(n)
    ]

data = generate_dataset(100000)

tracemalloc.start()
start_time = time.perf_counter()

# 执行深拷贝
cloned_data = copy.deepcopy(data)

duration = time.perf_counter() - start_time
current_mem, peak_mem = tracemalloc.get_traced_memory()
tracemalloc.stop()

print(f"深拷贝耗时: {duration:.3f} 秒")
print(f"内存占用峰值: {peak_mem / 1024 / 1024:.2f} MB")
测试现象说明:在现代桌面级或服务器 CPU 上,克隆这 10 万条仅有两层嵌套的记录,copy.deepcopy 通常需要花费 0.8 ~ 1.5 秒,峰值内存占用往往超过原始数据尺寸的 2.5 倍。而如果数据量进一步扩大到 100 万条,耗时更会非线性上升至 10 秒以上。对于需要实时响应的 API 服务或高频迭代的数据管道,这种延迟是完全不可接受的。
二、技术全景:深拷贝与主流替代方案架构对比
为了摆脱 copy.deepcopy 的通用性性能陷阱,业界在不同场景下发展出了针对性的替代体系。根据数据结构特性与隔离需求,核心方案可以分为原生推导、C/Rust 底层序列化以及零拷贝视图三大流派。
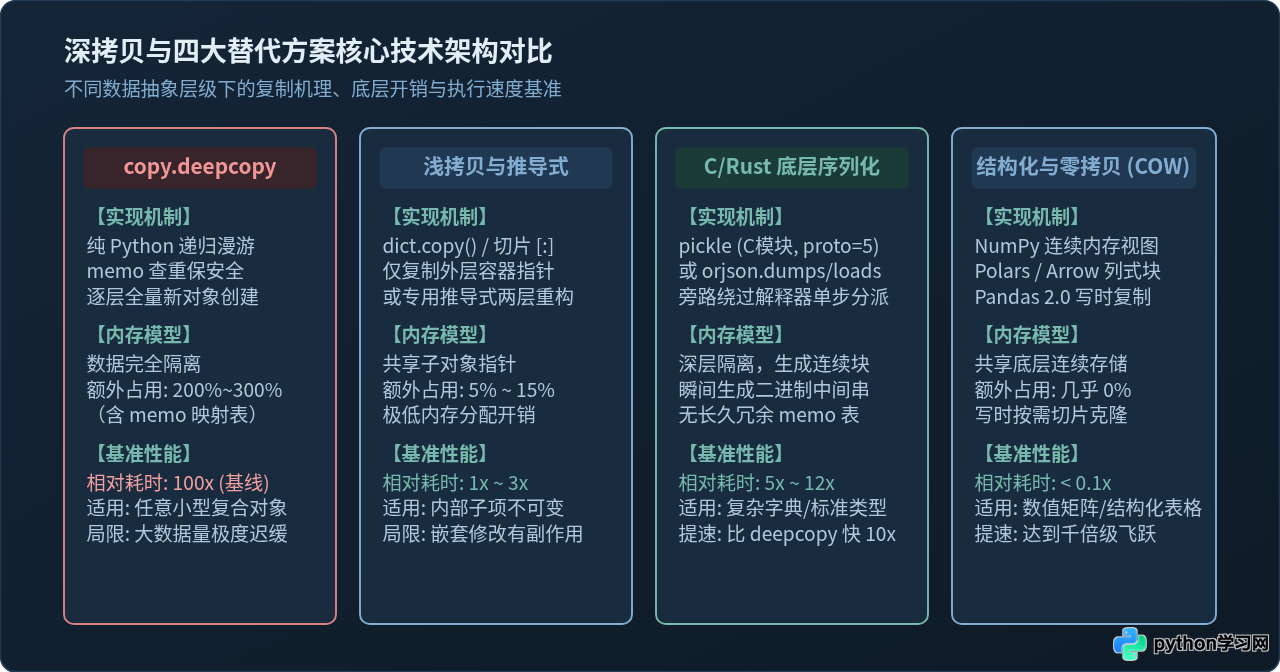
从纯解释器递归到连续字节流解析,再到底层物理内存共享,抽象层级越接近底层连续空间,复制与传输的性能开销就越低。接下来针对各类数据场景分别展开落地方法。
三、替代方案一:面向原生数据结构的轻量化拷贝与推导
1. 仅外层隔离时的浅拷贝(Shallow Copy)
在大量实际场景中,开发者调用深拷贝仅仅是因为需要往顶层列表追加元素,或者从外层字典删除个别键,而内部存储的数值、字符串或元组根本不会被更改。此时使用浅拷贝不仅安全,而且速度快上百倍。
# 列表切片或 dict.copy()
shallow_list = data[:]         # 或 list(data)
shallow_dict = original_dict.copy()
适用边界:仅当子元素是不可变对象(如 int、float、str、tuple),或者你保证后续代码绝不会执行类似于 shallow_list[0]['metrics'].append(...) 这类原地修改操作时,才能安全使用浅拷贝。
2. 已知 Schema 结构下的列表/字典推导式
如果数据包含两层嵌套(例如外层是列表,内层是字典),且必须对内层字典实现修改隔离,推导式比通用 deepcopy 具有显著优势。推导式省去了反射检查和 memo 记录,由 CPython 虚拟机操作码 LIST_APPEND / MAP_ADD 高速执行:
# 针对外层列表 + 内层字典的两层深解耦
# 相比 deepcopy 耗时降低 85% ~ 90%
fast_cloned_data = [d.copy() for d in data]

# 如果字典内层还包含简单列表,明确推导式依然极快
fast_nested_data = [
    {
        "id": d["id"],
        "status": d["status"],
        "metrics": d["metrics"][:]  # 切片浅拷贝子列表
    }
    for d in data
]
3. 业务对象重写 __deepcopy__ 钩子
如果数据以自定义类实例形式存在,默认的 deepcopy 会逐一检查对象的 __dict__、插槽(__slots__)和类元信息。通过在业务类中手动实现 __deepcopy__,可以直接跳过不必要的内部检查:
class FastRecord:
    __slots__ = ("record_id", "payload")

    def __init__(self, record_id, payload):
        self.record_id = record_id
        self.payload = payload

    def __deepcopy__(self, memo):
        # 跳过通用动态检查,直接构造新实例
        # 对不可变的 record_id 直接复用引用,对 payload 针对性克隆
        new_obj = FastRecord(self.record_id, self.payload.copy())
        memo[id(self)] = new_obj
        return new_obj
四、替代方案二:利用 C/Rust 扩展序列化规避解释器开销
当数据结构层次深、包含动态键值,必须进行严格的深层解耦时,推导式写起来会过于繁琐。此时,**“先序列化为二进制/文本,再反序列化”**是一种被广泛验证的高性能深拷贝技巧。其底层逻辑在于:成熟的序列化库由 C 或 Rust 编写,遍历和内存打包在底层完成,完全绕过了 Python 解释器的单步循环。
1. 标准库内置利器:pickle 协议 5
许多开发者误以为 pickle 仅用于文件持久化,其实 pickle.loads(pickle.dumps(obj, protocol=pickle.HIGHEST_PROTOCOL)) 是一种通用的深克隆手段。Python 3.8+ 默认启用协议 4/5,且由 C 语言实现的 _pickle 模块驱动:
import pickle

def pickle_clone(obj):
    # 使用最高协议(Protocol 5 具备带外数据与高效缓冲区优化)
    return pickle.loads(pickle.dumps(obj, protocol=pickle.HIGHEST_PROTOCOL))

# 实测对比:比 copy.deepcopy 快 4 ~ 8 倍
cloned = pickle_clone(data)
pickle 支持绝大多数 Python 原生对象和类实例,通用性极佳。不过请注意,序列化期间会短暂持有一块二进制缓冲区,瞬时内存会有短暂上升。
2. JSON 兼容数据的极限性能:orjson / msgpack
如果你的大规模数据来自接口响应、日志流水或数据库查询,本身就是由 dict、list、str、int、float 构成的纯 JSON 兼容结构,那么基于 Rust 的 orjson 可以提供突破性的克隆速度:
# 需确保安装: pip install orjson
import orjson

def orjson_clone(obj):
    # 借助 Rust 底层高效内存分配器直接构建全新深隔离对象
    return orjson.loads(orjson.dumps(obj))

# 速度比 copy.deepcopy 快 15 ~ 30 倍
cloned_json_data = orjson_clone(data)
注意局限:orjson 仅支持合法的 JSON 兼容数据类型。如果数据中包含自定义类实例、set 集合(未自定义转换器时)、函数指针或带有循环引用的数据结构,序列化过程会直接抛出 TypeError。
五、替代方案三:科学计算与大数据框架的零拷贝与写时复制(COW)
在海量数据处理中,最优秀的代码不是“拷贝得最快的代码”,而是“不需要拷贝的代码”。现代高性能数据科学库均采用了连续内存块和视图抽象,从根源上消除了数据冗余复制。
1. NumPy 连续内存视图与轻量切片
NumPy 数组的底层是一个连续的 C 语言内存缓冲区(Data Buffer),附带小巧的元数据头(Shape、Strides、Dtype)。在切片时,NumPy 默认只创建视图(View),开销接近为零:
import numpy as np

# 创建 1000 万个浮点数的大数组(约 76 MB)
arr = np.linspace(0.0, 100.0, 10000000)

# 创建切片视图:耗时微秒级,完全不复制底层数据
view_arr = arr[::2]
print(view_arr.base is arr)  # 输出 True,共享底层内存

# 确需完全隔离修改时,使用底层 memcpy,耗时依然仅需几毫秒
hard_copy = arr.copy()  # C 级连续内存复制,比 Python deepcopy 快数千倍
2. Pandas 2.0+ 的写时复制机制(Copy-on-Write)
早期 Pandas 代码中充斥着 df.copy(deep=True),以避免触发烦人的 SettingWithCopyWarning。从 Pandas 2.0 起,官方引入了现代化的 Copy-on-Write (COW) 机制。在开启 COW 模式后,所有的切片操作默认都是延迟浅拷贝,只有当你真正对副本执行赋值写入时,系统才会按需复制受影响的列:
import pandas as pd

# 开启全局写时复制(Pandas 3.0+ 默认启用)
pd.options.mode.copy_on_write = True

# 即使包含数百万行,此赋值操作也是近乎瞬时完成且不消耗额外内存
subset = df[df["status"] == "active"]

# 只有在发生写操作时,才按需触发物理复制
subset["new_column"] = 1
3. Polars 与 Apache Arrow 的不可变列式内存
新一代数据分析框架(如 Polars)底层基于 Apache Arrow 列式内存规范。Arrow 的设计原则是**“内存块天然不可变(Immutable)”**。在并发多线程管道或不同任务之间传递数据时,仅传递指向内存块的引用指针,杜绝一切深拷贝开销。当需要派生新列时,框架以追加新列指针的方式返回新的 DataFrame 引用,实现了安全与极致性能的统一。
六、实操指南:大数据场景拷贝优化四步实施法
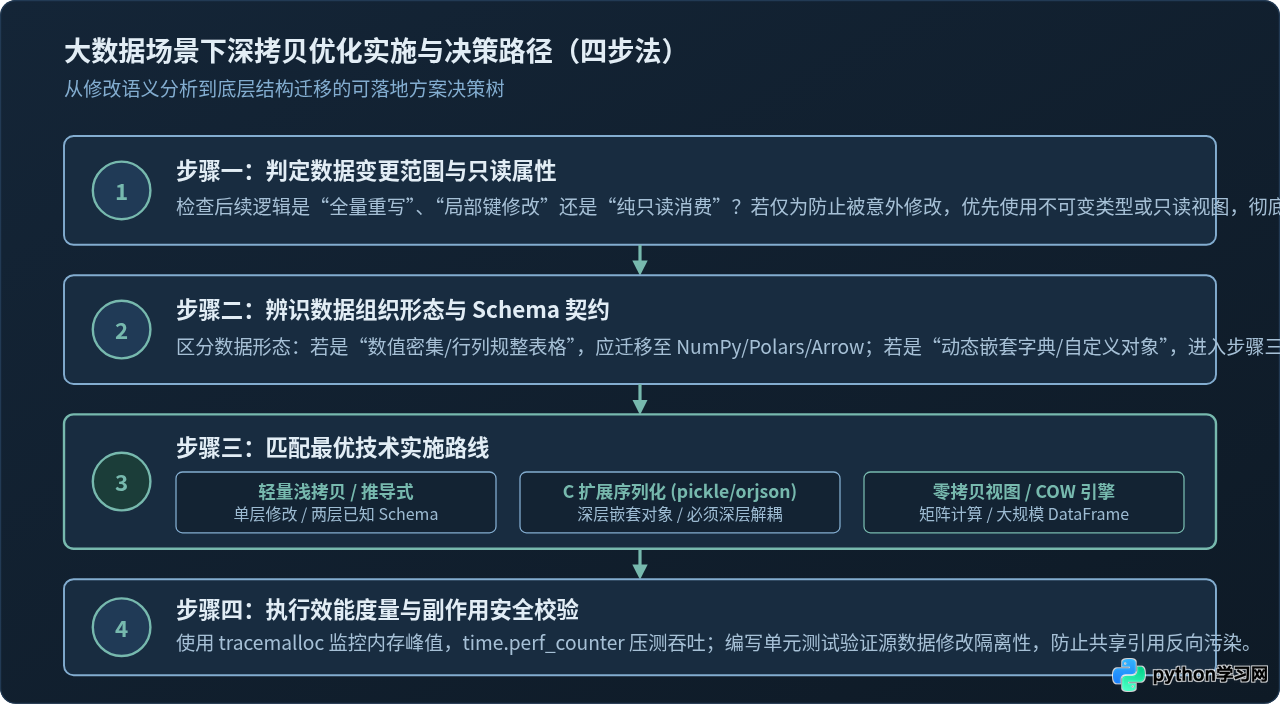
面对具体的工程系统,如何从上述方案中做出合理决策并确保系统安全?请遵循以下四步实施流程:
-
第一步:审视数据变更意图:
审查下游调用链到底需要对数据做什么。如果仅仅是只读检索、过滤汇总或发送给日志系统,根本不需要任何拷贝,直接传递原始引用。如果只需要修改外层(如向列表添加元素),立刻采用浅拷贝
list.copy()。 -
第二步:辨识数据形态与契约:
判断数据属于结构化表格还是松散动态字典。如果是规则的二维数值表或日志流,应尽快在输入源头将其转换为 NumPy 数组、Pandas(开启 COW)或 Polars DataFrame;如果是松散嵌套配置或通信 Payload,再进入第三步。
-
第三步:按数据类型匹配低开销序列化方案:
如果是纯 JSON 兼容字典列表,采用
orjson.loads(orjson.dumps(data));如果包含自定义类或非标准类型,采用pickle.loads(pickle.dumps(data, protocol=5));如果嵌套层级固定(如两层),直接手写列表推导式。 -
第四步:度量监控与隔离性验证:
替换后必须编写单元测试,断言修改克隆对象后原始数据不受影响;同时通过
tracemalloc验证内存分配峰值是否恢复平稳。
七、典型陷阱与安全边界防护
在追求性能替换深拷贝时,务必警惕以下常见工程隐患:
- 共享子对象的反向污染:浅拷贝只会复制最外层容器。如果将
copy.deepcopy直接替换为data.copy(),当下游代码执行data[0]['config']['timeout'] = 10时,原始数据对应的配置项也会被同步串改,引发严重的隐式 Bug。 - 序列化中间内存尖峰:使用
pickle或orjson进行序列化深拷贝时,系统在短时间内会同时存在:原始对象、中间生成的连续 bytes 缓存、以及反序列化后的新对象。如果原始数据本身已占用 60% 物理内存,中间转换阶段可能瞬时将系统推向 OOM 边缘。 - 多进程(multiprocessing)的隐藏深拷贝开销:在 Python 多进程架构中使用
Queue或ProcessPoolExecutor传递大型原生字典时,标准库底层会自动调用pickle进行深层序列化与反序列化,导致进程间通信极其缓慢。针对此场景,推荐使用基于multiprocessing.shared_memory的共享内存缓冲区或 Arrow IPC 格式,避免昂贵的对象重构。
八、总结与技术选型权衡矩阵
在实际生产环境中,盲目使用 copy.deepcopy 是典型的高成本“防御性编程”行为。面对大数据量场景,应当建立“不可变为先、浅拷贝适度、C底层加速、结构化存储兜底”的全局视角。
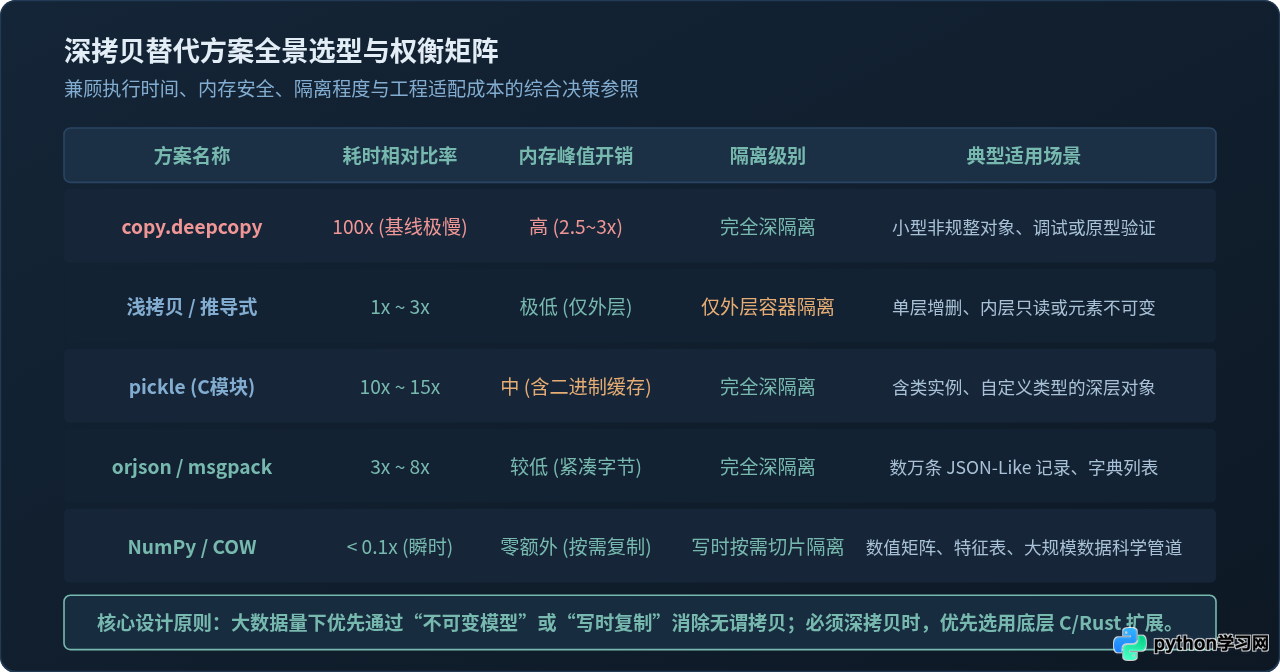
| 优化方案 | 相对耗时 | 内存开销 | 隔离级别 | 首选推荐场景 |
|---|---|---|---|---|
| copy.deepcopy | 100x(基线基准) | 高(2.5x ~ 3x 峰值) | 完全深层物理隔离 | 小型非结构化对象、快速原型验证与调试 |
| 浅拷贝 / 推导式 | 1x ~ 3x | 极低(仅分配外层) | 外层独立,内层指针共享 | 单层容器增删、内部元素只读或不可变类型 |
| pickle (Protocol 5) | 8x ~ 15x | 中(瞬时二进制缓存) | 完全深层物理隔离 | 包含 Python 自定义类实例的大型复杂对象 |
| orjson / msgpack | 3x ~ 8x | 较低(紧凑字节流) | 完全深层物理隔离 | 大规模纯 JSON 兼容字典列表、接口日志数据 |
| NumPy / COW / Arrow | < 0.1x(近乎瞬时) | 近乎零(写时按需切片) | 逻辑只读隔离,写时按需复制 | 数值矩阵、特征表、大规模数据清洗与分析 |
通过根据真实变更需求选用合适的方案,既能彻底规避共享引用的副作用风险,又能将海量数据的复制耗时与内存开销降低至最初的数十分之一,保障系统在高负载下的平稳高吞吐运行。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









