

数据科学用哪个Python软件好?Jupyter与Spyder对比
深入对比数据科学领域两大核心工具Jupyter与Spyder。从界面交互、变量追踪、代码调试、工程化管理到实际选型决策树,为不同阶段的数据科学从业者提供明确的选择依据与协同方案。
一、核心架构差异:文档流与四窗格工作台
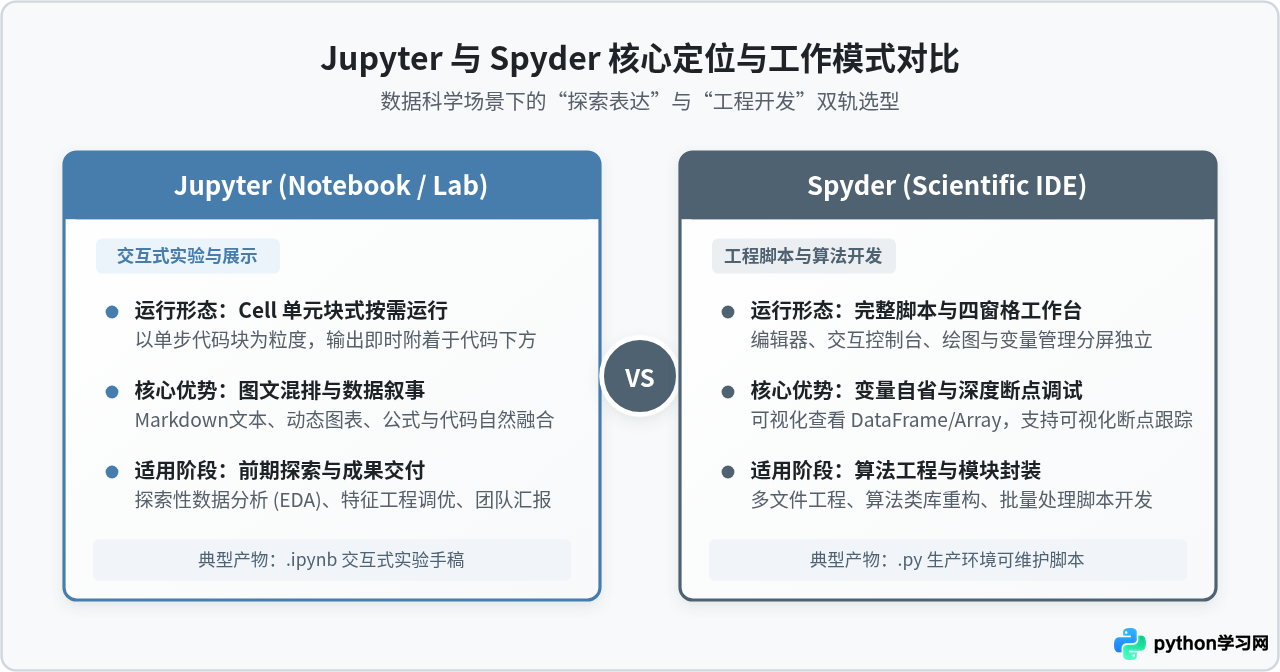
评估一款数据科学软件是否好用,首要标准是它的交互架构是否符合你大脑处理数据的习惯。Jupyter 与 Spyder 代表了两种截然不同的交互哲学:
1. Jupyter:单元驱动的垂直文档流
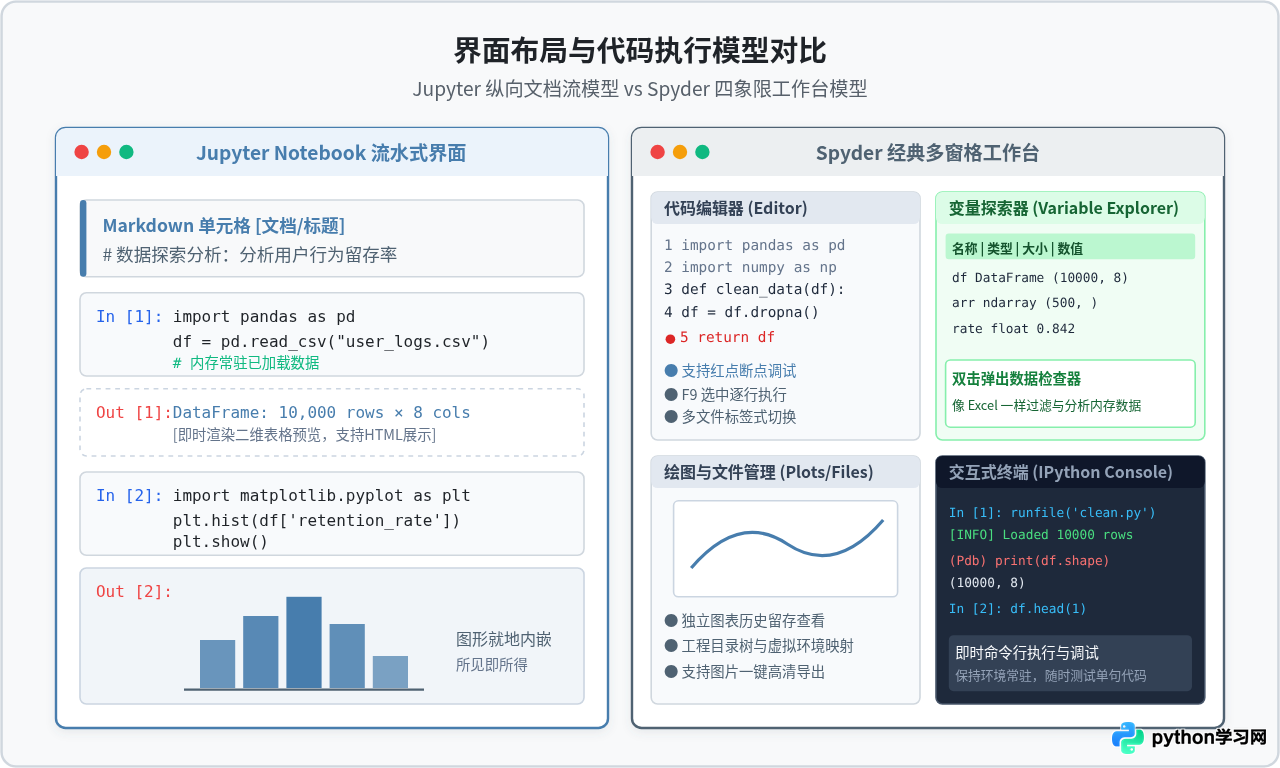
Jupyter 采用基于 Web 浏览器的交互式笔记本架构,其核心单元是“Cell”(单元格)。在同一个笔记本文件中,Markdown 说明文本、Python 代码块、表格数据输出和 Matplotlib/Seaborn 渲染的高清图表按自上而下的流式排布。
这种形态将“计算代码”与“输出结果”紧密缝合在一起。当你执行某一个单元格时,结果立即呈现在该代码块下方。数据分析师无需在编辑器和终端之间来回切换视线,非常适合记录“提出假设 → 加载清洗 → 可视化检验 → 记录业务结论”的完整心智推导过程。
2. Spyder:严谨集中的经典科学 IDE
Spyder(Scientific Python Development Environment)是专为科学家、工程师和数据分析人员设计的桌面集成开发环境。它的界面布局与 MATLAB、RStudio 极为相似,天然采用“四象限工作台”模型:
- 多标签代码编辑器(Editor):编写规范的
.py脚本,具备代码自动补全、实时语法纠错(基于 pyflakes/flake8)以及函数定义跳转; - 变量探索器(Variable Explorer):常驻于右上角,以表格形式实时展示当前内存中所有变量的名称、类型、维度大小与内容;
- 独立绘图与文件窗格(Plots & Files):历史绘制的图表在此集中陈列,不会污染代码编辑区,支持矢量图与位图一键导出;
- 交互式 IPython 控制台(IPython Console):位于右下角,用户既可以单步执行脚本片段,也可以在终端中自由敲入测试语句验证逻辑。
二、核心工作流实测对比:从数据清洗到可视化
为了具体说明两者在实际操作中的体验差异,我们以一个典型的数据分析场景为例:读取包含万行记录的用户留存数据集,过滤缺失值并绘制留存率分布直方图。
import pandas as pd
import matplotlib.pyplot as plt

# 1. 加载并清洗数据
df = pd.read_csv("user_retention.csv")
clean_df = df.dropna(subset=["retention_rate", "active_days"])

# 2. 核心统计指标快速查看
mean_rate = clean_df["retention_rate"].mean()

# 3. 绘制指标分布
plt.figure(figsize=(8, 4))
plt.hist(clean_df["retention_rate"], bins=30, color="#477DAD", edgecolor="#FFFFFF")
plt.title("Distribution of User Retention Rate")
plt.xlabel("Retention Rate")
plt.ylabel("User Count")
plt.tight_layout()
plt.show()
1. 在 Jupyter 中的操作步骤与反馈机制
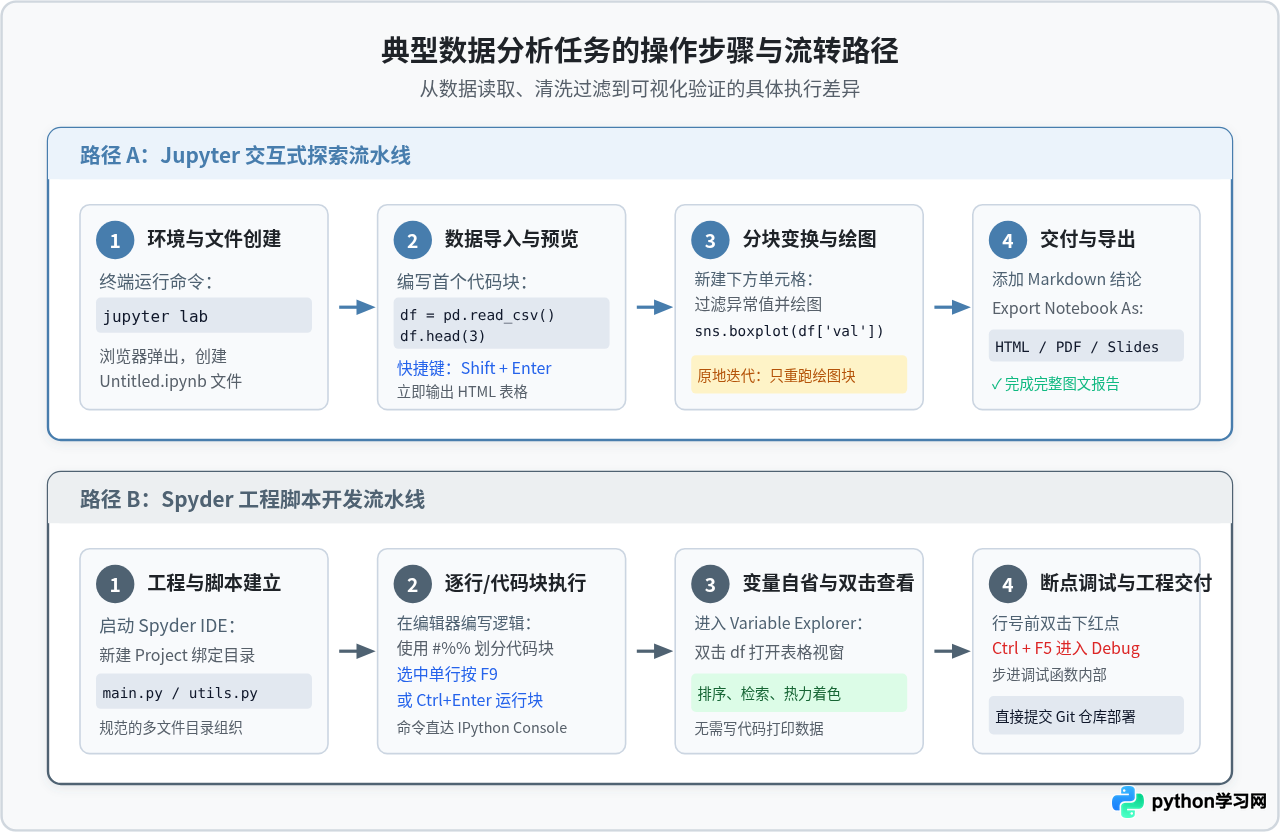
- 启动与创建:在终端执行
jupyter lab(或使用 Anaconda Navigator 打开),浏览器新建.ipynb文件; - 分块编写与执行:将数据导入写在第一个 Cell,按下快捷键
Shift + Enter执行,当前单元格立即执行且环境常驻,终端显示状态变为In [1]; - 原地迭代绘图:在下方新建 Cell 编写可视化代码,按下
Shift + Enter,图表直接内嵌于页面中;如果需要调整柱状图颜色或分箱数(bins),仅需在绘图 Cell 中修改数值并重新运行,完全不需要重新读取 CSV 文件; - 成果交付:点击菜单 File → Save and Export Notebook As → HTML / PDF,一份包含背景说明、精美图表和最终结论的完整业务分析报告便已生成。
2. 在 Spyder 中的操作步骤与反馈机制
- 创建工程与脚本:打开 Spyder,新建项目并创建
data_analysis.py脚本; - 块级运行(Code Cells):Spyder 支持在纯文本脚本中使用
#%%划分逻辑块。将光标置于数据加载块内,按下快捷键Ctrl + Enter,右下角 IPython 控制台显示执行指令; - 直观查看变量状态:执行完毕后,右上角的 Variable Explorer 立即出现
df和clean_df条目。双击clean_df,会弹出一个独立的仿 Excel 电子表格窗口,你可以直接点击列头进行降序排序、条件过滤,快速排查是否存在异常极值; - 图形与输出管理:执行到绘图代码时,图表呈现在右侧的 Plots 面板中。你可以使用箭头翻看上一幅绘制的散点图与当前的直方图,对比调整前后的视觉差异,并点击保存为指定分辨率的 PNG/SVG。
三、变量自省与调试排错能力深度剖析
当数据分析从简单的脚本走向复杂的算法建模时,代码调试和内存自省的效率将直接决定开发进度。这是 Jupyter 与 Spyder 区分度最高的技术维度。
1. 变量自省:代码打印 vs 图形化表格探索
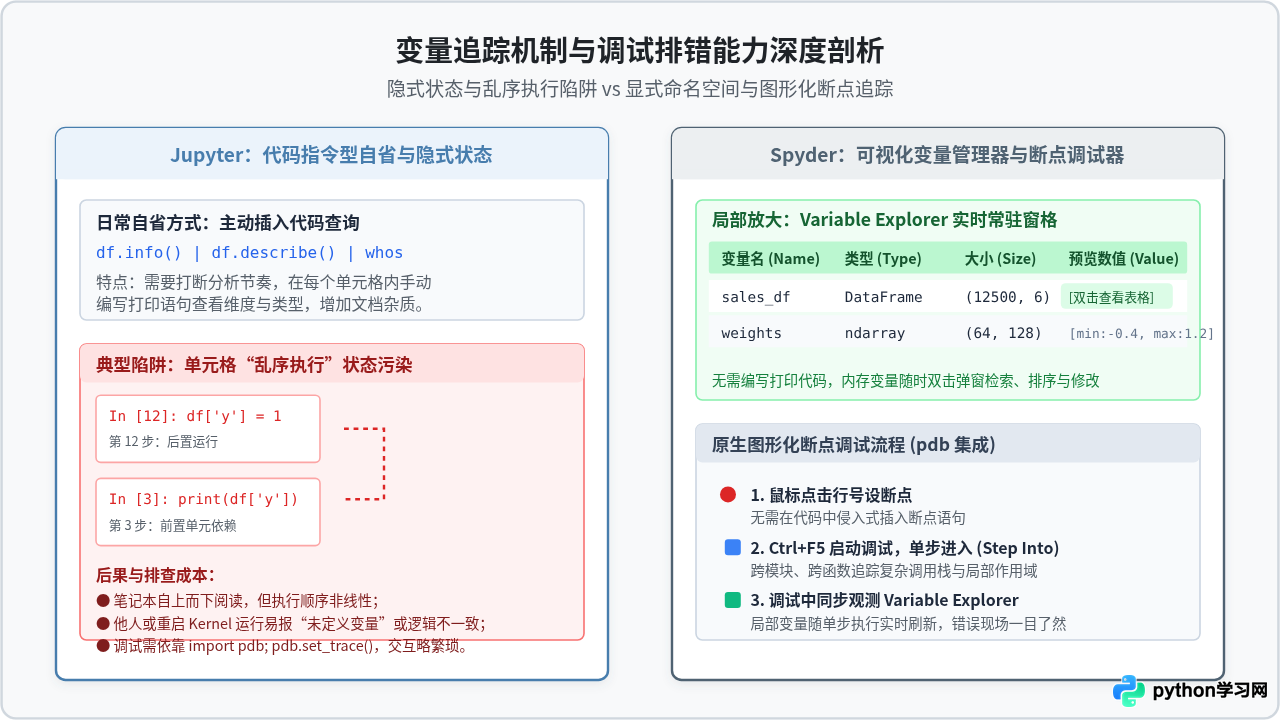
在 Jupyter 中,要想知道某个中间变量的结构,你必须编写代码。例如执行 clean_df.info()、clean_df.head() 或通过 IPython 魔法命令 %whos 列出变量。这种方式对于轻量级分析足够快捷,但当分析包含数十个字典、嵌套列表或多维 NumPy 张量时,页面中会被大量的打印输出填满,查找某个字段极不方便。
Spyder 的 Variable Explorer 则是开箱即用的常驻面板。它对 Python 科学计算栈做了深度优化:不仅支持查看常规的字符串和数值,还对 Pandas DataFrame、Series、NumPy ndarray、以及 Matplotlib 图形对象提供专用查看器。在查看器中,你可以直接查阅百万级矩阵的特定切片、查看数据分布的热力色阶,甚至可以直接在表格中手动修改某个单元格的数值来模拟极端边界条件。
Jupyter 笔记本允许用户跳跃式运行单元格。例如先运行第 1 单元,修改第 5 单元重新运行,再回过头运行第 3 单元。这种非线性执行会在内存中形成难以追踪的“隐式状态”。很多初学者经常遇到“代码在本地能跑,发给同事却报错未定义变量”的问题。而在 Spyder 中,虽然也支持逐行执行,但其核心载体是顺序固定的
.py 脚本,从根本上降低了状态混乱的概率。
2. 断点调试:pdb 命令行 vs 原生 GUI 调试器
在 Jupyter Notebook 中调试复杂函数,传统做法是在代码中插入 import pdb; pdb.set_trace() 或使用 %debug 魔法命令。程序会中断并在单元格下方开启一个文本交互输入框。虽然 JupyterLab 近期版本引入了 Xeus 内核调试器,但需要额外安装插件与配置内核,体验并不如桌面 IDE 顺畅。
Spyder 提供了与大型 IDE(如 PyCharm/VS Code)完全一致的可视化断点体验:
- 在代码编辑区左侧的行号旁双击,即可放置醒目的红色圆点断点;
- 按下
Ctrl + F5启动调试模式,脚本执行到断点处自动暂停; - 控制台切换为
(Pdb)提示符,此时你可以点击工具栏按钮进行单步执行(Step Over)、单步进入函数内部(Step Into)或跳出循环(Step Return); - 在单步执行过程中,Variable Explorer 中的所有局部变量和调用栈会同步动态变化,异常逻辑在几秒钟内即可准确定位。
四、工程化、版本控制与团队协作
当数据分析项目需要上线、部署或接入 Git 仓库多人协同维护时,文件格式与工程规范的差异至关重要。
# 场景:仅仅修改了一行代码 y = x * 2 为 y = x * 3

# .py 文件在 Git 中的简洁 diff:
- y = x * 2
+ y = x * 3

# .ipynb 文件在 Git 中的臃肿 diff(由于包含执行序号、JSON元数据与base64图表):
@@ -14,7 +14,7 @@
   "cells": [
    {
     "cell_type": "code",
-    "execution_count": 5,
+    "execution_count": 6,
     "metadata": {},
     "outputs": [
-     "data": {"image/png": "iVBORw0KGgoAAAANSUhEUgAA...base64超长字符串..."}
+     "data": {"image/png": "iVBORw0KGgoAAAANSUhEUgAA...完全变动的一大段新base64..."}
     ],
     "source": [
-     "y = x * 2\n"
+     "y = x * 3\n"
     ]
从上面的差异对比可以看出,Jupyter Notebook 本质上是一个大型的 JSON 文件,里面同时存储了代码、执行序号、输出结果甚至 base64 编码的图片。这导致在团队进行 Git 代码审查(Code Review)或分支合并时,极易产生庞大且难以解决的合并冲突(Merge Conflict)。
而 Spyder 保存的完全是纯粹的 .py 文本文件,与标准的软件工程工具链(如 Git、CI/CD 自动化流水线、Docker 容器化)天然无缝集成。代码的每一次修改都清晰明了,且易于拆分为 config.py、models.py、pipeline.py 等多文件工程模块。
五、横向对比清单与选型决策指南
为了帮助你迅速做出决策,我们将 Jupyter 与 Spyder 的核心维度梳理为如下对比表:
| 评估维度 | Jupyter (Notebook / Lab) | Spyder (Scientific IDE) |
|---|---|---|
| 界面与载体 | Web 浏览器,纵向单流富文本笔记本 | 独立桌面程序,四象限工作台(编辑器/变量/终端/绘图) |
| 原生存储格式 | .ipynb(内含 JSON 格式的代码与输出) |
.py(纯 Python 源代码脚本) |
| 数据探索(EDA) | 极高。即时出图,所见即所得,试错成本低 | 较高。支持块运行,需在专门的绘图窗格查看图表 |
| 变量管理机制 | 依赖编写代码打印(.info(), %whos) |
原生 GUI 变量探索器,支持双击弹出类 Excel 查看 |
| 代码调试(Debug) | 偏弱。依赖命令行 pdb 或专用扩展插件 | 极强。原生集成可视化红点断点、单步跟踪与调用栈 |
| 多文件与工程化 | 较弱。难以跨 notebook 引用,易陷入巨型单文件 | 优秀。自带工程管理器,标准 Python 模块化跳转 |
| 版本控制(Git) | 繁琐。输出结果与元数据易导致巨大的 Git 冲突 | 纯文本 diff,完全兼容标准软件工程规范 |
| 报告与分享 | 极致。可直接导出 HTML、PDF 或通过 Nbviewer 共享 | 需手动整理代码与图表,不具备图文交织的叙事功能 |
六、明确的选型与使用建议
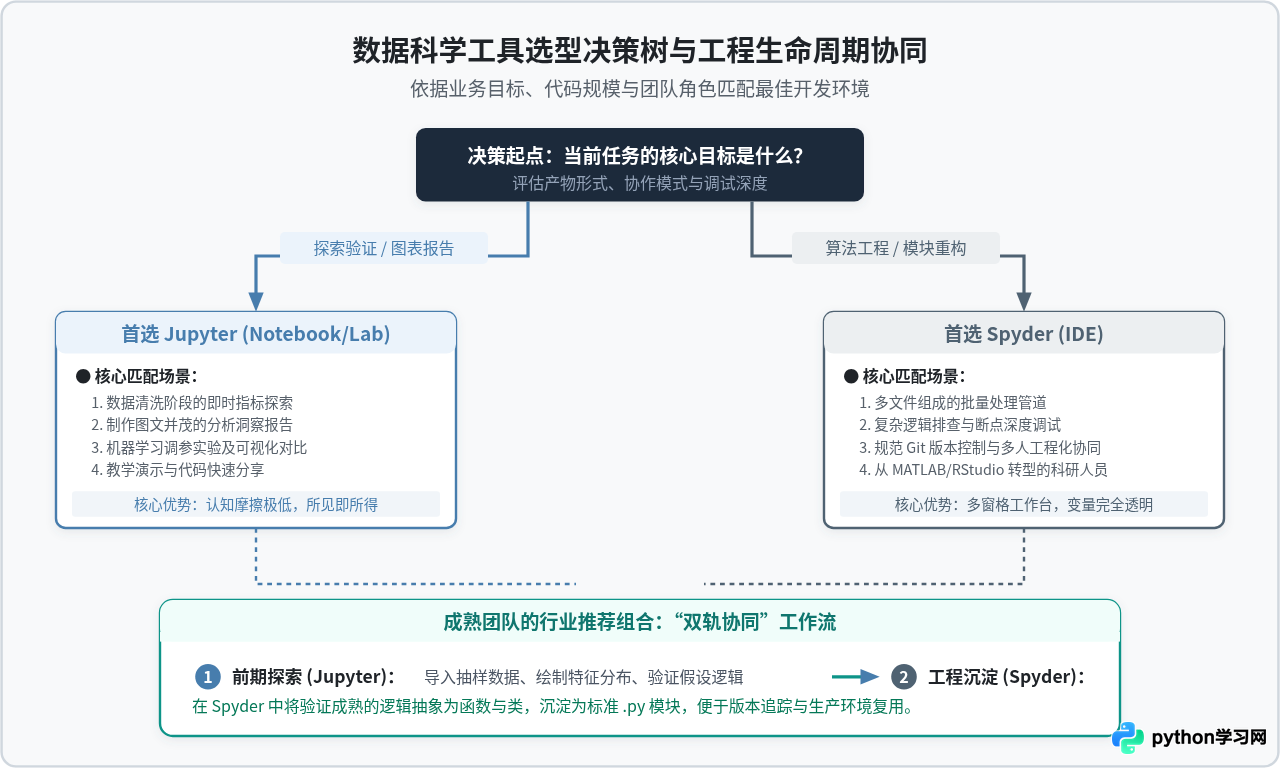
针对不同角色和任务阶段,具体的选型建议如下:
1. 优先选择 Jupyter 的场景
- 初学者与教学演示:如果你刚开始学习 Python 数据分析语法,Jupyter 能提供即时正反馈,极大地降低入门的认知负荷;
- 探索性数据分析(EDA)与业务洞察:需要频繁尝试不同维度、快速绘制散点图与箱线图,并且需要将分析结论提交给产品经理、业务总监或科研导师;
- 模型调优与实验记录:记录超参数调整前后的指标对比(例如准确率、召回率折线图),形成清晰的实验推演手稿。
2. 优先选择 Spyder 的场景
- 从 MATLAB 或 RStudio 转型的从业者:Spyder 的窗口布局、快捷键逻辑(如 F9 逐行执行)与变量浏览器与 MATLAB 几乎一模一样,学习迁移成本趋近于零;
- 复杂数据管道与批处理工程:需要处理包含多级目录、数十个辅助函数和复杂类定义的数据清洗项目;
- 遇到疑难 Bug 需要逐行排查:算法逻辑复杂,必须在循环内部单步检查局部变量取值与维度变化。
3. 成熟数据科学团队的最佳实践:“双轨协同”
真正的效率高手通常不会将自己局限在单一软件中。在业界成熟的数据项目中,通行的黄金流程是:
第一阶段:在 Jupyter 中进行假设验证与探索。快速加载数据样本,尝试不同的特征组合与清洗逻辑,验证业务可行性,输出初版可视化原型;
第二阶段:在 Spyder(或 VS Code/PyCharm)中进行代码重构与工程落地。将 Jupyter 中验证有效的零散代码提取为独立的函数与模块(如 cleaner.py、feature_engineer.py),利用 Spyder 的断点调试功能确保在全局完整数据集上的稳定性,最终提交至 Git 仓库部署上线。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









