

Python传参二维数组报错IndexError或TypeError怎么解决
在Python中将二维数组传递给函数时频繁遇到IndexError或TypeError?本文深入拆解原生嵌套列表与NumPy矩阵的索引差异,详析一维误传、空列表边界、锯齿行宽、元组索引误用及解包陷阱,并提供排查四步法与防御式编码模板。
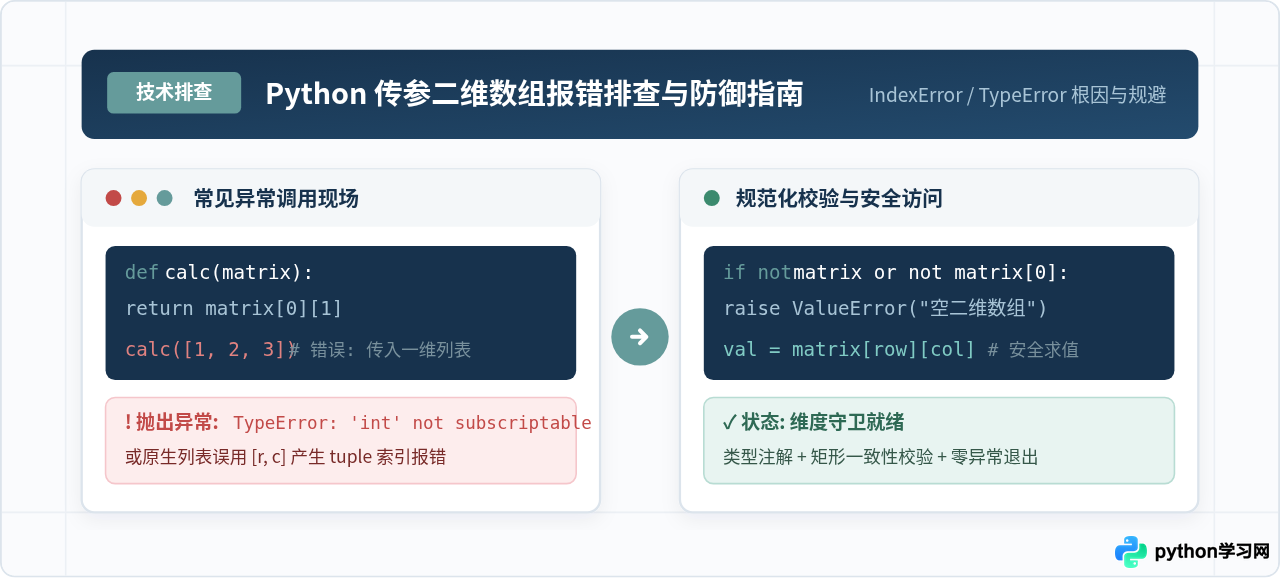
IndexError 或 TypeError,核心原因通常是传递的实参实际结构与函数内部期望的维度或索引方式不匹配。这既包含传入了一维列表导致对标量进行二次取值、在原生列表上混用 NumPy 的逗号元组索引,也包含空列表未做拦截、各子列表长短不齐(锯齿数组),或者调用时滥用了 *args 解包。解决该问题的标准流程是:先通过探针打印入参真实类型与长度定位形态,再对症修改索引写法或补齐防御性校验。
一、报错表现与第一现场快速诊断
当代码在执行到类似 matrix[i][j] 或 matrix[i, j] 时发生崩溃,第一步应优先观察控制台输出的完整回溯栈(Traceback)。在二维数组场景下,报错主要分为两大家族:
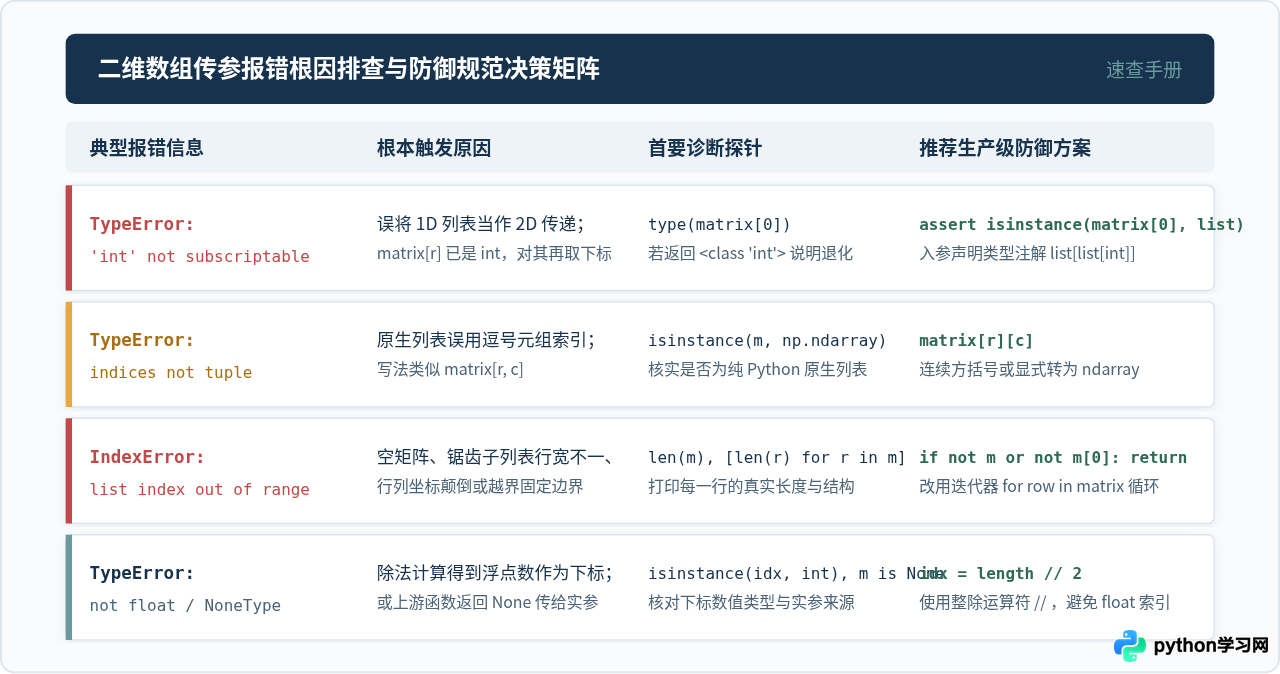
1. TypeError 的两类高发信息
-
TypeError: 'int' object is not subscriptable(或 float/NoneType): 说明执行表达式matrix[i][j]时,第一级matrix[i]提取出来的不是一个子列表,而是一个整数。尝试对整数再执行下标运算[j]便会直接触发此异常。这通常意味着调用方传进来的实际上是一个一维列表,或者函数内部参数被意外解包打散。 -
TypeError: list indices must be integers or slices, not tuple: 说明在 Python 原生嵌套列表(list[list])上错误使用了类似matrix[0, 1]的逗号取值语法。在 Python 原生语法中,0, 1会被打包成一个tuple,而内置的list只接收单个整数或切片作为索引,只有科学计算库 NumPy 的ndarray才支持元组多维索引。
2. IndexError 的典型表现
-
IndexError: list index out of range: 表明指定的索引数值超出了列表的有效索引边界[-len, len-1]。在二维数组中,既可能是外层行索引i >= len(matrix),也可能是内层列索引j >= len(matrix[i])。最容易被忽视的场景是传入空矩阵[]、含有空行的矩阵[[]],或者各行长短不一的“锯齿形”列表。
在尝试猜测代码哪里写错之前,推荐在函数的第一行注入一段轻量探针代码,直接打印实参在运行时的真实结构:
def process_matrix(matrix):
    # 现场诊断探针:打印容器类型、外层长度、首行类型与前两行样本
    print(f"[诊断] 容器类型: {type(matrix)}, 长度: {len(matrix) if hasattr(matrix, '__len__') else '无len'}")
    if isinstance(matrix, list) and len(matrix) > 0:
        print(f"[诊断] 首元素类型: {type(matrix[0])}, 内容: {matrix[:2]}")

    # 原有处理逻辑...
    return matrix[0][1]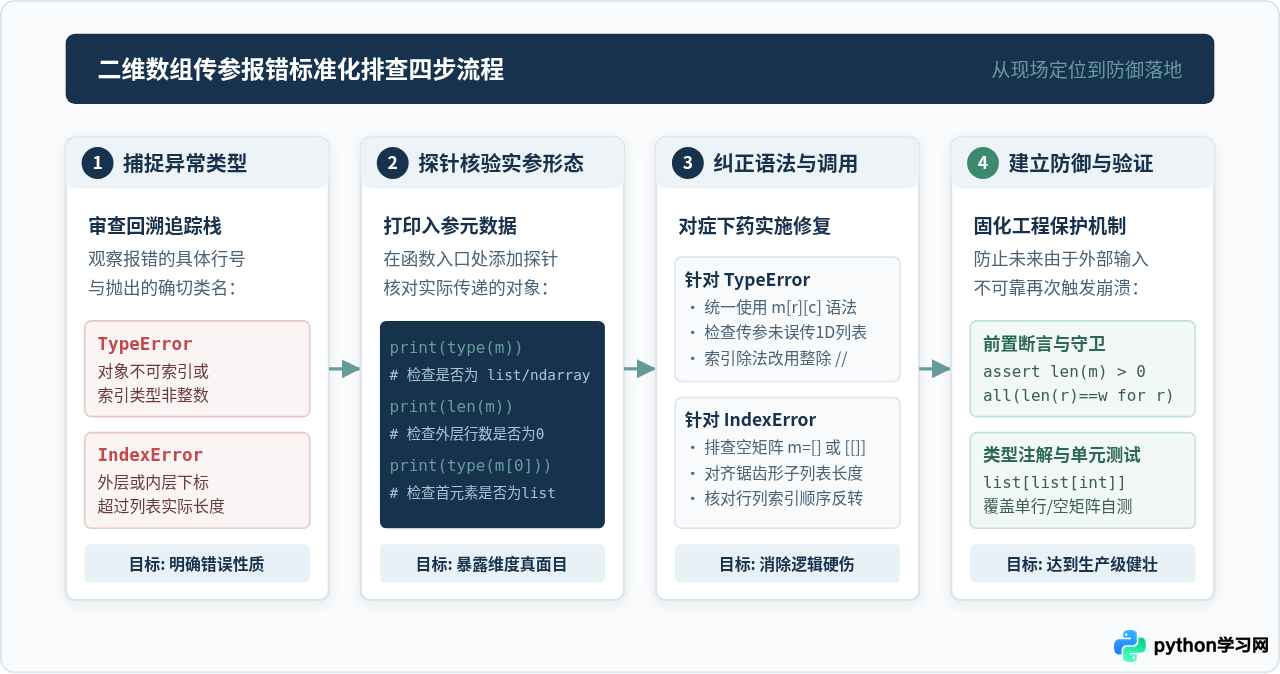
二、TypeError 的根因剖析与针对性修复
1. 误将一维列表当作二维列表传入
很多初学者在写矩阵求值函数时,默认实参必然是 [[1, 2], [3, 4]]。但如果调用方误传了 [1, 2, 3, 4],第一级索引 matrix[0] 得到的是整数 1。紧接着的 (1)[1] 就会瞬间崩溃。
# 错误重现示例
def get_first_row_second_col(data):
    return data[0][1]

numbers = [10, 20, 30]
# 此时 numbers[0] 是 10,10[1] 触发:
# TypeError: 'int' object is not subscriptable
# get_first_row_second_col(numbers)

# 正确修复方案:增加维度与类型检查
def safe_get_element(data):
    if not isinstance(data, list) or not data:
        raise ValueError("入参必须是非空列表")
    if not isinstance(data[0], list):
        raise TypeError(f"期望二维嵌套列表,但检测到一维元素: {type(data[0]).__name__}")
    return data[0][1]
2. 原生列表误用 NumPy 的逗号元组索引
刚从 MATLAB、R 语言或熟悉 NumPy 的开发者,经常习惯写 matrix[r, c]。如果传进来的参数是纯 Python 原生列表,解释器就会把 r, c 视作元组传给 list.__getitem__,从而抛出异常。
# 错误语法(原生列表)
raw_grid = [[1, 2, 3], [4, 5, 6]]
# val = raw_grid[0, 1]  # 报错: TypeError: list indices must be integers or slices, not tuple

# 正确做法有两种:
# 方案 A: 严格使用连续双括号(纯原生方式)
val_native = raw_grid[0][1]

# 方案 B: 若确实需要高维切片与逗号索引,入口处转换为 numpy.ndarray
import numpy as np

def process_as_array(matrix_like):
    arr = np.asarray(matrix_like)
    return arr[0, 1]  # 合法,输出 2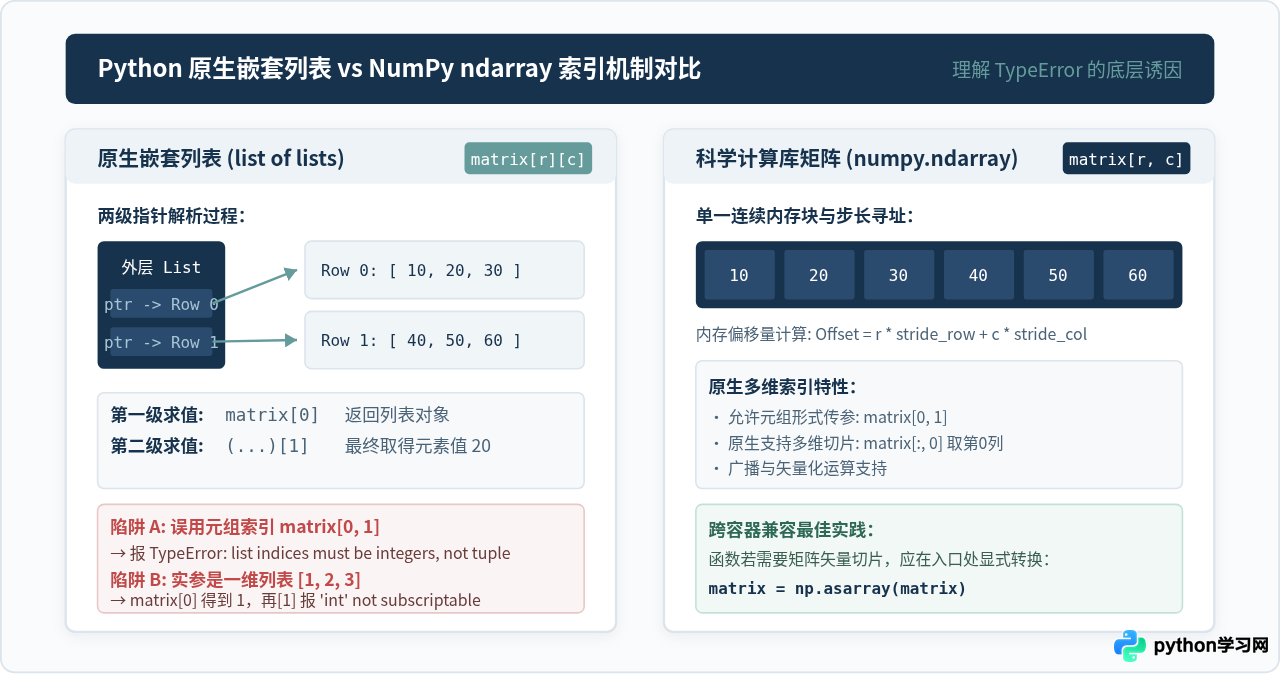
3. 索引计算产生浮点数
在计算矩阵中心位置或二分索引时,若使用单斜杠除法 r / 2,在 Python 3 中结果会自动转为 float(例如 4 / 2 = 2.0)。直接用于列表下标会导致 TypeError: list indices must be integers or slices, not float。
# 错误: mid = len(matrix) / 2  # 得到 float
# 正确: 使用双斜杠整除运算符 //
mid_row = len(matrix) // 2
mid_col = len(matrix[0]) // 2
center_value = matrix[mid_row][mid_col]
三、IndexError 的根因剖析与针对性修复
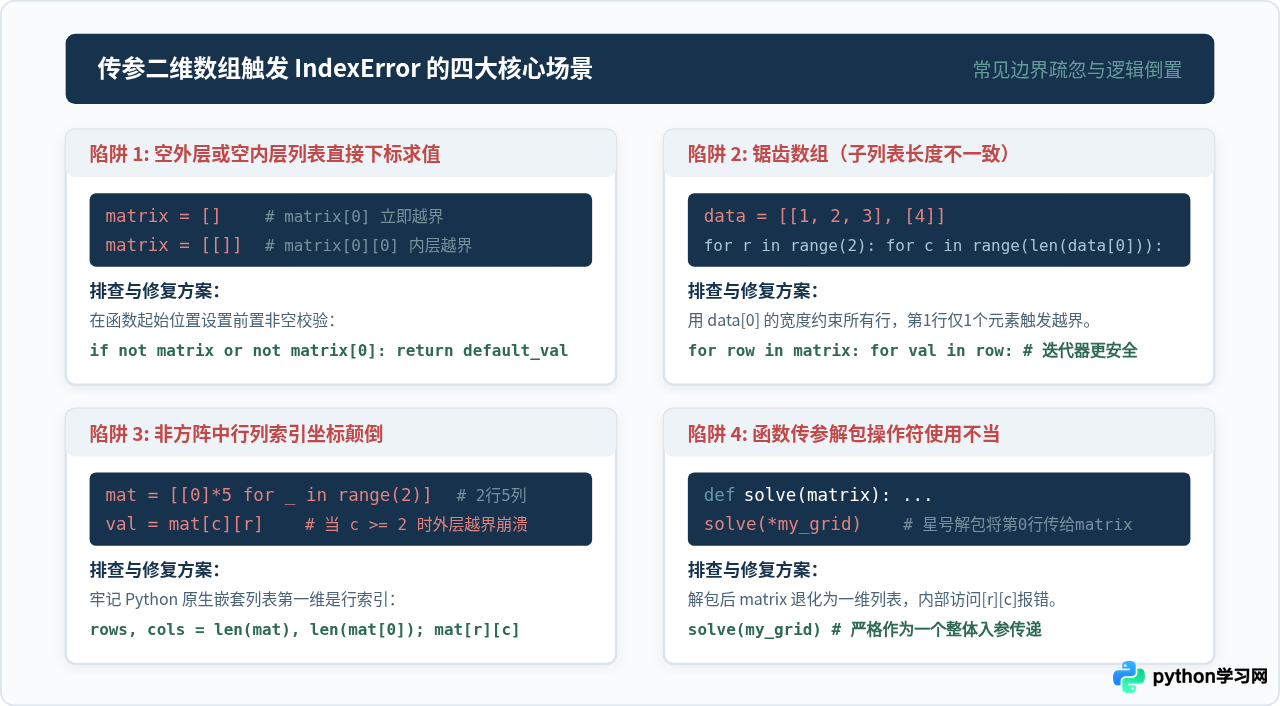
IndexError 本质上是边界访问失控。对于二维数组,有四个最容易踩中的隐蔽边界场景。
1. 空列表与空内层直接索引
若函数上游查询无结果并返回了 [](空外层)或 [[]](外层有一个空子列表),直接执行 matrix[0][0]:
- 对
[]执行matrix[0]时,外层就抛出IndexError: list index out of range。 - 对
[[]]执行matrix[0]能拿到[],但接着对其执行[0]就会在内层抛出IndexError。
修复该问题的标准防线是**双重真值守卫**:
def process_safely(matrix):
    # 同时校验外层与首行内层是否为空
    if not matrix or not matrix[0]:
        return []  # 或返回默认安全值

    rows, cols = len(matrix), len(matrix[0])
    return matrix[0][0]
2. 锯齿数组(Jagged List)导致固定行宽循环越界
Python 原生列表不要求每个子列表长度相同。很多代码习惯提取 cols = len(matrix[0]),然后用这个固定的列宽遍历每一行。如果某一行较短(例如第 0 行有 4 个元素,第 1 行只有 2 个元素),遍历到第 1 行第 3 个位置时就会发生 IndexError。
jagged_data = [
    [10, 20, 30, 40],
    [50, 60]          # 短行
]

# 危险写法:假设所有行宽度与首行相等
# for r in range(len(jagged_data)):
#     for c in range(len(jagged_data[0])):  # 当 r=1, c=2 时立即 IndexError
#         print(jagged_data[r][c])

# 稳健写法 A: 优先使用迭代器遍历,彻底摆脱数字下标越界风险
for row in jagged_data:
    for val in row:
        print(val)

# 稳健写法 B: 强制进行矩形一致性断言
def assert_rectangular(matrix):
    first_len = len(matrix[0])
    if not all(len(row) == first_len for row in matrix):
        raise ValueError("检测到不规则锯齿数组,子列表长度必须完全一致")
3. 行列坐标反转(非方阵矩阵)
数学几何中习惯以 (x, y) 描述坐标,但在计算机的二维行优先存储中,第一个索引是行号(对应纵坐标 y),第二个索引才是列号(对应横坐标 x)。
在一个 2 行 5 列 的矩阵中,行范围是 0~1,列范围是 0~4。如果错误写成 matrix[col][row],当 col >= 2 时,外层列表直接越界。
4. 函数传参滥用星号解包
当调用者这样传参时:
def render_grid(matrix):
    return matrix[0][0]

my_table = [[1, 2], [3, 4]]
# 错误调用:误加了星号 *
# render_grid(*my_table)
*my_table 会将 my_table 的两个子列表作为两个独立的位置参数传递。函数 render_grid 只声明了一个形参 matrix,但由于 Python 实参匹配规则,它接收到的仅仅是第一行 [1, 2]!接着进入函数内部执行 matrix[0][0],也就是 [1, 2][0][0],先拿到数字 1,再执行 (1)[0],最终报出 TypeError。如果函数有多个形参,这种解包还可能导致错位赋值从而在后续行号触发 IndexError。
四、工程级解决方案:防御式传参规范
在生产环境中,处理外部输入或跨模块传递的二维数组时,应当遵循一套通用的工程规范,将异常阻断在数据入口处。以下是一个高复用性的防御式处理模板:
from typing import Sequence, TypeVar, List

T = TypeVar("T")

def validate_and_normalize_2d(
    matrix: Sequence[Sequence[T]],
    require_rectangular: bool = True
) -> List[List[T]]:
    """
    二维数组通用防御与规范化工具
    :param matrix: 待校验的二维序列
    :param require_rectangular: 是否要求矩形(各行长必须相等)
    :return: 校验合规的原生嵌套列表
    """
    # 1. 拦截 None 与非容器类型
    if matrix is None:
        raise TypeError("入参 matrix 不能为 None")
    if not hasattr(matrix, "__len__"):
        raise TypeError(f"入参必须是序列容器,当前类型为: {type(matrix).__name__}")

    # 2. 拦截空外层
    if len(matrix) == 0:
        return []

    # 3. 拦截一维列表(确保每一个元素都是子容器)
    normalized: List[List[T]] = []
    first_row_len = None

    for r_idx, row in enumerate(matrix):
        if not hasattr(row, "__len__") or isinstance(row, (str, bytes)):
            raise TypeError(
                f"行索引 [{r_idx}] 期望为序列容器,实际检测到标量类型: {type(row).__name__}"
            )

        row_len = len(row)
        if first_row_len is None:
            first_row_len = row_len
        elif require_rectangular and row_len != first_row_len:
            raise ValueError(
                f"矩阵不规则:第0行长为 {first_row_len},但第 {r_idx} 行长为 {row_len}"
            )

        normalized.append(list(row))

return normalizedfor row in matrix: for val in row:,天然免疫任何 IndexError。2. 数字下标做边界求模或守卫:若必须按坐标随机访问,进入前使用
0 <= r < len(matrix) and 0 <= c < len(matrix[r]) 进行短路保护。3. 数学切片尽早转换:需要执行整列提取(如
[:, 0])或矩阵相乘时,进入函数立即执行 np.asarray(matrix)。
五、自测验证清单
完成修复后,可通过以下 4 组具有代表性的边界用例进行快速验证:
| 测试场景 | 测试用例数据 | 预期结果 | 未通过时的风险排查 |
|---|---|---|---|
| 标准方阵与非方阵 | [[1, 2], [3, 4]] 与 [[1, 2, 3], [4, 5, 6]] |
正常输出,无任何异常 | 若报错,重点检查行列循环索引是否颠倒 |
| 极端空边界 | [] 以及 [[]] |
安全返回默认值或抛出友好的 ValueError |
若报 IndexError,说明缺少非空入口守卫 |
| 一维误传攻击 | [1, 2, 3] |
触发明确的提示性校验异常 | 若抛出 'int' not subscriptable,说明未做首行类型检查 |
| 不规则行宽 | [[1, 2], [3]] |
按需正常遍历或明确报错拒收 | 若在第 1 行报 IndexError,说明硬编码了列宽 |
遵循以上检查与防御机制,不仅能彻底解决运行时的 IndexError 与 TypeError,更能让代码在面对各类不规范输入时保持高度健壮。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









