

Python tuple基础:创建、索引与切片操作详解
深入解析Python元组(tuple)的核心机制与实操技巧,系统阐述字面量与构造函数创建方式、单元素逗号语法陷阱、正负双向索引寻址与越界防范、切片步长机制及底层不可变性。
(x, y) 或服务监听地址 ("127.0.0.1", 8080) 时,我们通常要求这些数据在传递过程中保持稳定,杜绝意外修改。Python 的 tuple(元组)正是为此设计的一种有序且不可变(Immutable)的序列类型。本文直接围绕元组最核心的基础能力展开:如何规范创建元组并避开单元素逗号陷阱、如何利用正负双向索引精准寻址,以及如何通过切片步长规则高效提取子序列。
一、元组的创建:语法规则与关键陷阱
创建元组主要有三种常见方式:使用圆括号包裹元素、仅使用逗号进行元组打包(Tuple Packing),以及通过内置函数 tuple() 进行类型转换。
1. 空元组与常规字面量创建
最直观的方式是使用一对空的圆括号 (),或者用圆括号包裹多个以逗号隔开的元素:
# 1. 创建空元组
empty_tuple = ()

# 2. 包含多个同构或异构元素的元组
server_config = ("192.168.1.10", 8080, True)
colors = ("red", "green", "blue")2. 单元素元组的“逗号陷阱”
这是所有初学者最容易踩坑的语法细节:决定元组类型的核心符号是逗号(,),而不是圆括号。如果圆括号内只有一个元素且末尾没有逗号,Python 解释器会将其解析为数学上的优先级运算符,而不是元组。
# 错误示范:未添加逗号
not_a_tuple = (42)
print(type(not_a_tuple))

# 正确示范:单元素必须附带尾随逗号
real_tuple = (42,)
print(type(real_tuple))<class 'int'>
<class 'tuple'>
(item,)。缺少逗号会导致类型变成原始数据类型(如 int、str),进而在后续操作中引发 TypeError。
3. 省略圆括号的元组打包
在不引起语法歧义的上下文中,圆括号可以完全省略,只需元素之间有逗号分隔,Python 就会自动将其“打包”为元组:
# 省略括号的元组声明
point = 10, 20
single_item = 100,  # 尾随逗号同样生效

print(type(point))       # 输出: <class 'tuple'>
print(type(single_item)) # 输出: <class 'tuple'>
4. 使用 tuple() 构造函数转换
内置的 tuple() 构造器接收任何可迭代对象(如 list、str、range、字典的键等),将其浅拷贝为一个不可变元组:
list_data = [1, 2, 3]
t_from_list = tuple(list_data)     # 转换为: (1, 2, 3)

str_data = "Python"
t_from_str = tuple(str_data)       # 转换为: ('P', 'y', 't', 'h', 'o', 'n')

range_data = range(3)
t_from_range = tuple(range_data)   # 转换为: (0, 1, 2)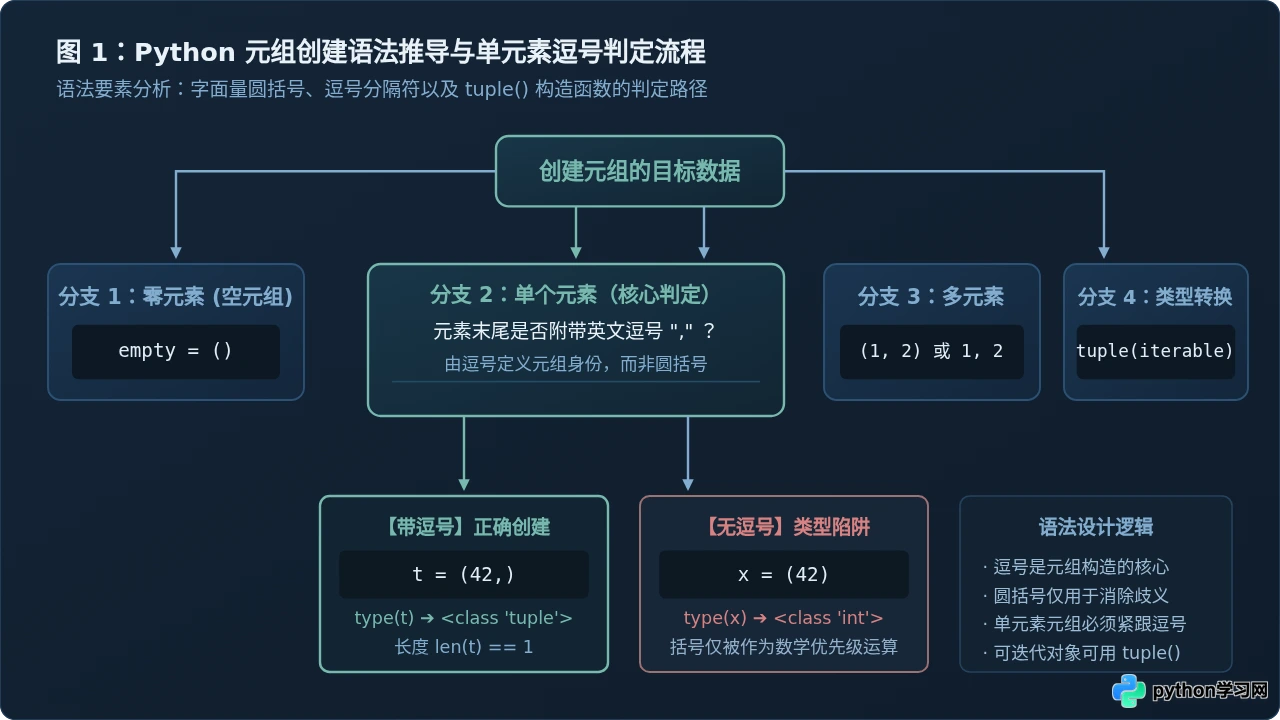
二、元组的索引:正负双向寻址与不可变约束
元组作为有序序列,其内部元素在内存中以连续指针数组形式排列。我们可以通过中括号下标语法 tuple[index] 精确访问任意指定位置的元素。
1. 正向索引与反向索引规则
Python 为序列提供了对称的双向索引支持:
- 正向索引:从
0开始递增,首位元素下标为0,第k个元素下标为k - 1,末尾元素为len - 1。 - 反向(负向)索引:从
-1开始递减,末位元素下标为-1,倒数第二位为-2,首位元素为-len。
tech_stack = ("Linux", "Python", "Docker", "PostgreSQL", "Redis")

# 正向访问
first_item = tech_stack[0]   # "Linux"
third_item = tech_stack[2]   # "Docker"

# 负向访问
last_item = tech_stack[-1]    # "Redis"
prev_item = tech_stack[-2]    # "PostgreSQL"
2. 越界异常:IndexError
当所提供的索引超出合法范围时(即正向大于等于长度,或负向小于负长度),Python 解释器会立即中断执行并抛出 IndexError:
data = (10, 20, 30)
# print(data[3])   # 抛出 IndexError: tuple index out of range
# print(data[-4])  # 抛出 IndexError: tuple index out of range
3. 核心限制:不可就地修改与 TypeError
与列表(list)不同,元组的底层指针数组在初始化后即被锁定,不允许对其中的任何索引槽位执行重新赋值操作:
config = ("production", 443)
# 尝试修改端口号
# config[1] = 8443
# 运行结果直接报错:
# TypeError: 'tuple' object does not support item assignment
4. 特殊场景:元组内部包含可变对象
需要特别理清的是:元组的“不可变”指的是元组本身存储的引用地址(指针)不可改变。如果元组中的某个元素本身是可变容器(如列表 list),则该列表内部的数据依然可以就地修改:
mixed_tuple = ("admin", [192, 168, 1, 1], 80)

# 合法操作:修改索引 1 处的列表内部元素
mixed_tuple[1][3] = 100
print(mixed_tuple)  # 输出: ('admin', [192, 168, 1, 100], 80)

# 非法操作:尝试替换整个列表引用
# mixed_tuple[1] = [10, 0, 0, 1]  # 触发 TypeError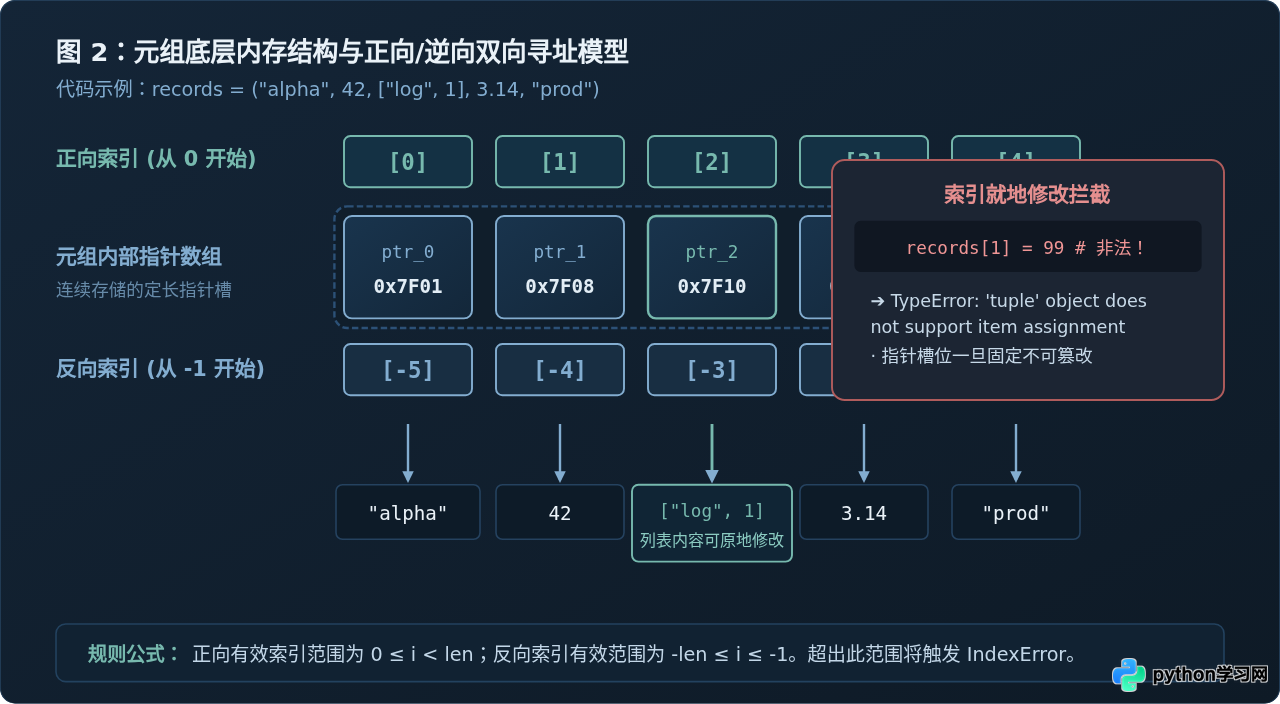
三、元组的切片操作:区间提取与步长规则
切片(Slicing)允许我们从现有元组中截取指定范围的子序列。其完整通用语法为:
tuple[start:stop:step]
1. 左闭右开区间与默认缺省值
切片的核心准则是左闭右开 [start, stop):包含起始索引 start 对应的元素,但不包含结束索引 stop 对应的元素。
- 若省略
start,默认从序列最开头(索引0)开始; - 若省略
stop,默认截取至序列最末尾(包含最后一个元素); - 若省略
step,默认步长为1。
alphabets = ("a", "b", "c", "d", "e", "f", "g")

sub1 = alphabets[1:4]   # 索引 1, 2, 3 -> ('b', 'c', 'd')
sub2 = alphabets[:3]    # 起点至索引 2 -> ('a', 'b', 'c')
sub3 = alphabets[4:]    # 索引 4 至末尾 -> ('e', 'f', 'g')
sub4 = alphabets[:]     # 完整浅拷贝 -> 等同于原元组
2. 步长(step)机制:间隔与跳跃提取
当指定 step > 1 时,切片将按照指定间隔跳跃式拾取元素:
numbers = (0, 1, 2, 3, 4, 5, 6, 7, 8, 9)

even_numbers = numbers[::2]    # 从 0 开始每隔 2 个取一个 -> (0, 2, 4, 6, 8)
odd_numbers = numbers[1::2]   # 从 1 开始每隔 2 个取一个 -> (1, 3, 5, 7, 9)
window = numbers[2:8:3]       # 索引 [2, 8) 内步长为 3 -> (2, 5)
3. 负步长:反向切片与全序列翻转
当 step 为负整数时,寻址方向从正向变为反向(从右向左)。此时 start 的位置应当在 stop 的右侧:
raw = (1, 2, 3, 4, 5)

# 最常用的全序列快速逆序技巧
reversed_tuple = raw[::-1]    # 得到: (5, 4, 3, 2, 1)

# 反向区间截取:从索引 4 逆向走至索引 1(不含 1)
rev_sub = raw[4:1:-1]         # 得到: (5, 4, 3)
4. 切片的边界容错特性
与单元素索引越界会触发 IndexError 截然不同,Python 切片对超出范围的边界具有宽容性。当 stop 或 start 超出元组实际长度时,解释器会自动截断到有效边界而绝不报错:
data = (10, 20, 30)

# 索引超出长度,自动截断至末尾
safe_slice = data[1:1000]     # 返回: (20, 30)

# 起点远超范围,直接返回空元组
empty_slice = data[10:20]     # 返回: ()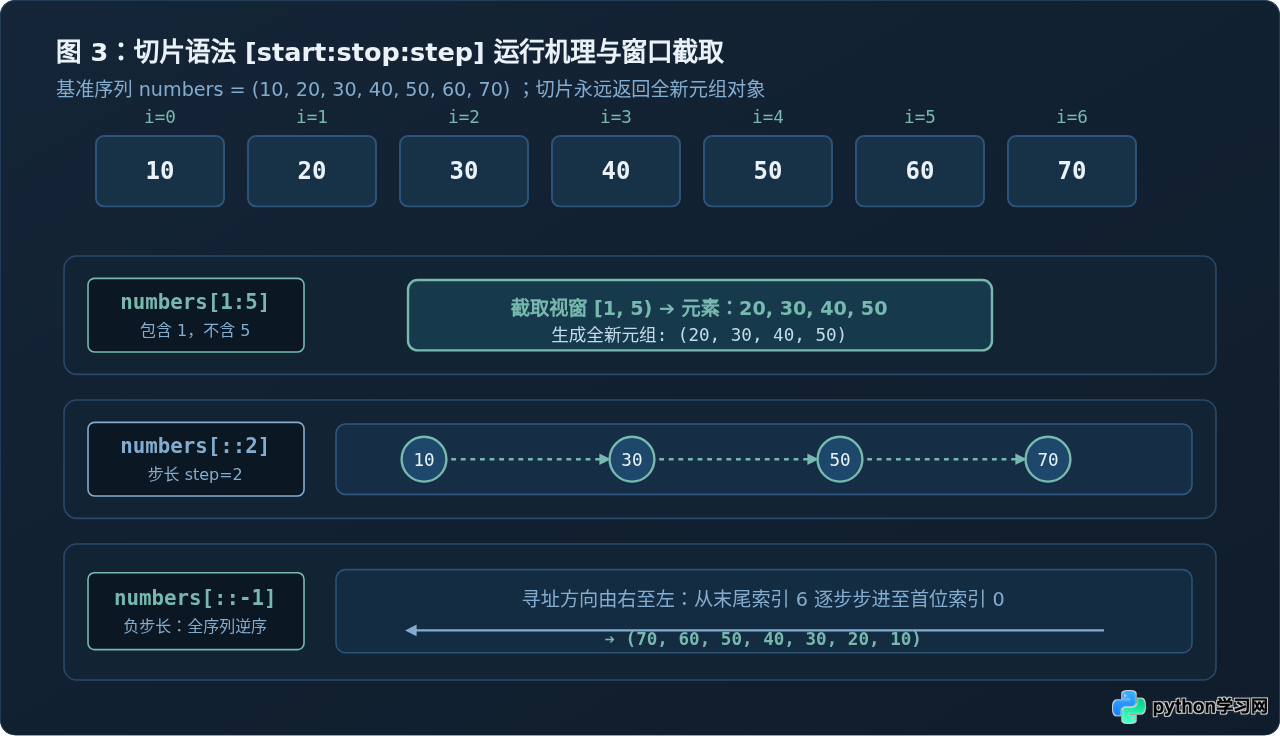
四、选型对比、元组解包与最佳实践
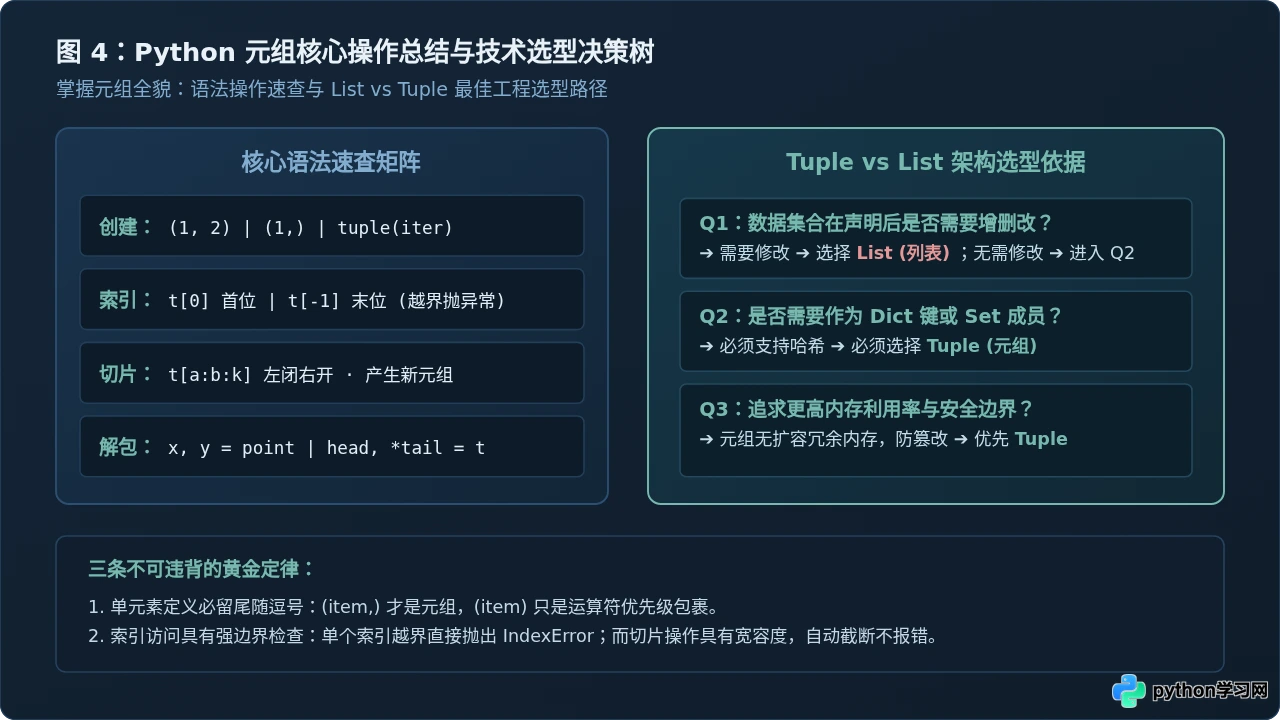
1. 元组解包(Unpacking):直观的数据分配
元组天然适合作为多值返回或固定记录容器。通过解包机制,我们可以一行代码将元组内的元素分别赋给多个独立变量:
# 基础解包:变量数与元组长度严格相等
coordinate = (120.15, 30.28)
longitude, latitude = coordinate

# 带星号(*)的扩展解包:收集剩余元素
record = ("2026-10-31", 200, 404, 500, "OK")
date, *error_codes, status = record

print(date)         # '2026-10-31'
print(error_codes)  # [200, 404, 500] (列表形式承接)
print(status)       # 'OK'
2. Tuple 与 List 的核心选型对比
初学者常有疑问:既然 list 功能更全面、支持动态增删改,为何还要在代码中使用 tuple?下表清晰列举了两者的技术边界与工程权衡:
| 特性维度 | 元组 (tuple) | 列表 (list) | 工程建议与选型考量 |
|---|---|---|---|
| 可变性 | 不可变 (Immutable) | 可变 (Mutable) | 需要防御意外修改、保障多线程只读时用 tuple |
| 内存占用 | 紧凑(定长分配,无冗余扩容槽) | 较大(预分配冗余空间以备 append) | 高并发或海量只读数据时 tuple 显著节省内存 |
| 哈希性 (Hash) | 可哈希(元素均可哈希时) | 不可哈希 (unhashable) | 作为字典的键(Key)或放入集合(Set)必须用 tuple |
| 语义意图 | 表达“异构记录”(如字段固定的行数据) | 表达“同构集合”(如动态变化的数据项队列) | 通过数据类型直接向阅读者传达架构设计意图 |
五、常见问题排查与速查总结
- 问题 1:为什么写了
t = (1)之后调用t[0]报错TypeError: 'int' object is not subscriptable?
原因正是遗漏了末尾逗号。(1)计算后为整数1,并非元组;应规范写为(1,)。 - 问题 2:什么时候切片会返回空元组?
当步长为正且start >= stop(如t[4:2]),或步长为负且start <= stop(如t[1:4:-1]),以及起始边界越界时,均会静默返回空元组()。 - 问题 3:元组拼接与重复会改变原数据吗?
使用t1 + t2或t * 3均是生成全新元组对象,原变量引用的元组内容保持不变。
免责声明:本文内容仅供参考,不代表本站观点。转载或引用请注明出处。









